《BERT》:双向上下文如何变成统一的语言理解接口
从左向右语言模型的信息缺口出发,拆解 BERT 的掩码语言模型、下一句预测、统一输入接口与微调方法,并用 GLUE、SQuAD、SWAG 和消融实验读懂它的贡献与边界。

2018 年,预训练语言模型已经能把大量无标注文本变成可迁移的表示,但一个结构性限制仍然存在:语言模型通常从左向右读,当前位置只能使用左侧上下文。这个限制对生成任务很自然,对问答和自然语言推断却不够。回答问题时,答案词的含义往往同时取决于问题、答案左侧和答案右侧的文字。
Jacob Devlin、Ming-Wei Chang、Kenton Lee 与 Kristina Toutanova 的《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》把这个限制改写成了一个训练目标:随机遮住输入中的一部分词元,只在被遮住的位置预测原词。模型因此可以在每一层同时聚合左右上下文,又不能直接读取预测答案。1
BERT 的关键贡献由两次交换组成。第一次,模型用只预测 15% 位置的 masked language model(MLM,掩码语言模型),换取深层双向表示。第二次,模型用同一套编码器处理单句、句对、序列标注和问答,只在顶部替换很小的任务输出层。实验数字说明这套交换有效;消融实验则帮助我们分辨,收益究竟来自双向上下文、句间任务,还是模型规模。
左向语言模型卡在哪里
在 BERT 之前,预训练表示大致沿两条路线迁移。ELMo 从独立训练的左到右和右到左语言模型中提取上下文特征,再把这些特征交给任务专用架构;ELMo 的摘要明确把重点放在词义随上下文变化,以及把深层内部状态暴露给下游模型。2
OpenAI GPT 代表另一条路线:使用左到右 Transformer,并把预训练参数直接微调到下游任务。BERT 原论文把 BERT 与 GPT 设计成接近的模型规模,用来隔离注意力方向的差异:BERT 的每个位置可以看左右两侧,GPT 的每个位置只能看左侧。3
问题出在“同时看左右”这句话本身。假设模型要预测句子里的词
bank。如果目标词还留在输入中,多层自注意力可以让 bank 的表示间接读到 bank 自己,模型得到的是复制线索,而不是从上下文恢复词义。BERT 原论文把这种信息泄露称为普通双向条件语言模型无法直接训练的原因。4所以 BERT 没有把“预测下一个词”简单改成“预测左右两边的词”。BERT 先把目标词从输入路径中拿走,再要求模型根据剩下的文字恢复它。目标函数可以写成:
其中,
x_i 是原始序列在第 i 个位置的词元,M 是被选中的位置集合,\tilde{x} 是被替换后的序列。这个式子只在 M 中的位置计算损失;没有被选中的位置参与上下文,却不直接贡献 MLM 的预测损失。4这就是 BERT 的第一笔架构交换:训练信号从“每个位置都预测”变成“只预测被选位置”,计算效率下降一些;作为交换,每个被预测位置的表示都能在 Transformer 编码器中融合左右上下文。
一次 MLM 到底做了什么
给定一段已经切成 WordPiece 的文本,BERT 按下面的顺序处理:
- 从全部 WordPiece 位置中随机选出 15%。WordPiece 是一种子词切分方法,一个不常见的完整单词可以被拆成多个更常见的片段。
- 对每个被选位置进行替换:80% 的概率换成
[MASK],10% 的概率换成随机词元,10% 的概率保持原词元不变。 - 把替换后的整段序列送入双向 Transformer 编码器。
- 只读取被选位置的隐藏向量,在整个词表上做 softmax,预测每个位置原来的词元。
- 用预测分布和原词元之间的交叉熵更新模型参数。
例如,原句
my dog is hairy 选中了 hairy,训练样本可能变成 my dog is [MASK],也可能变成 my dog is apple,或者仍然是 my dog is hairy。三种输入对应同一个预测目标:原词 hairy。随机词和原词保留的比例,主要用于减轻下游微调阶段从未出现 [MASK] 所造成的训练—微调不匹配。5BERT 采用的 Transformer 编码器来自 Vaswani 等人的《Attention Is All You Need》。那篇论文用完全基于注意力的架构替代循环和卷积,并强调并行训练优势。BERT 的新处不在于重新发明自注意力,而在于把这种编码器放进能训练深层双向表示的 MLM 目标里。6
输入表示把单句和句对装进同一序列
BERT 的输入接口把一条或两条文本都表示成一个词元序列:
这个式子在算三件事的相加:词元 embedding 告诉模型当前位置是什么片段,句段 embedding 告诉模型当前位置属于句子 A 还是句子 B,位置 embedding 告诉模型词元在序列中的位置。三个向量位于同一个隐藏空间,所以模型可以把词义、句子归属和顺序一起交给编码器。7
每条序列开头放一个特殊词元
[CLS]。它经过所有 Transformer 层后的隐藏向量记为 C,分类任务把 C 接到一个线性分类层。两段文本之间放 [SEP],句段 embedding 再标出两段文字的边界。词元级任务则保留每个位置的隐藏向量 T_i,例如命名实体识别给每个 T_i 预测一个标签。这个设计把下游任务的差别压缩到输出端:句子分类读
[CLS],序列标注读全部词元向量,句对任务把 A、B 拼接后交给同一套自注意力。读者看到“只加一个输出层”时,应该想到的是这个输入—输出接口,而不是一个对所有任务完全相同的预测头。NSP 给句子关系补上一种训练信号
MLM 能训练词元与局部上下文的关系,却没有直接要求模型判断两段文字是否相邻。问答和自然语言推断都需要句间关系,因此 BERT 又加入 next sentence prediction(NSP,下一句预测)。
构造一个预训练样本时,句子 A 和句子 B 有两种来源:50% 的样本中,B 是语料里紧跟 A 的真实下一段;另外 50% 的样本中,B 是从语料中随机取出的段落。模型读取
[CLS] 向量,用二分类头预测 IsNext 或 NotNext。联合训练的直觉可以写成:前一项要求模型在词元位置恢复被遮住的内容,后一项要求
[CLS] 汇总句对关系。两项任务使用同一套编码器,但监督落在不同的输出位置。4NSP 的作用要用消融来读,而不是只看它的名称。论文在相同的 BERTBASE 架构、预训练数据和微调方案下比较了完整模型、去掉 NSP 的模型,以及改成左到右语言模型并去掉 NSP 的模型。开发集结果如下:
| 预训练设置 | MNLI-m | QNLI | MRPC | SST-2 | SQuAD 1.1 F1 |
|---|---|---|---|---|---|
| BERTBASE 8 | 84.4 | 88.4 | 86.7 | 92.7 | 88.5 |
| MLM,无 NSP 8 | 83.9 | 84.9 | 86.5 | 92.6 | 87.9 |
| 左到右 LM,无 NSP 8 | 82.1 | 84.3 | 77.5 | 92.1 | 77.8 |
第一行和第二行的差距给出论文设定下 NSP 的增益,第二行和第三行的差距则更直接地显示双向 MLM 的价值。左到右模型在 MRPC 和 SQuAD 上下降尤其明显,因为这两类任务需要理解句对关系,或需要让词元表示同时使用答案位置两侧的上下文。论文还给左到右模型顶部加了一个随机初始化的 BiLSTM;它能改善 SQuAD,却仍明显落后于预训练的双向模型,并且损害 GLUE 任务表现。9
从同一编码器到不同任务
预训练完成后,BERT 用预训练参数初始化一个下游模型,并微调整个模型。任务需要改变的部分主要在输入和输出:
- 单句分类把文本作为 A 句,把
[CLS]向量C接到分类层。 - 句对分类把前提和假设作为 A、B 两段,仍然读取
C。 - 序列标注读取每个词元向量
T_i,为每个位置输出一个标签。 - 问答把问题和段落拼成 A、B 两段,为每个位置预测答案起点和终点。
问答公式最能体现 BERT 的接口思路。设
S 是起点向量,E 是终点向量,T_i 是段落中第 i 个词元的最终表示。起点概率为:分子计算起点向量与第
i 个词元表示的相似程度,分母把所有候选位置的指数分数加起来,于是得到一个在段落位置上的概率分布。终点概率用 E 做同样的计算。候选答案跨度 i 到 j 的分数是:模型选择分数最高且终点不早于起点的跨度。BERT 只新增起点向量和终点向量,段落中真正回答问题的表示由预训练编码器产生。10
与预训练相比,微调成本很低。论文报告,文中的结果从同一个预训练模型出发,单个 Cloud TPU 最多约 1 小时即可复现;SQuAD 模型在单个 Cloud TPU 上约 30 分钟就能达到开发集 F1 91.0%。这个对比把 BERT 的计算分工说清楚了:大规模无标注语料承担通用表示的学习,具体任务只承担最后的适配。11
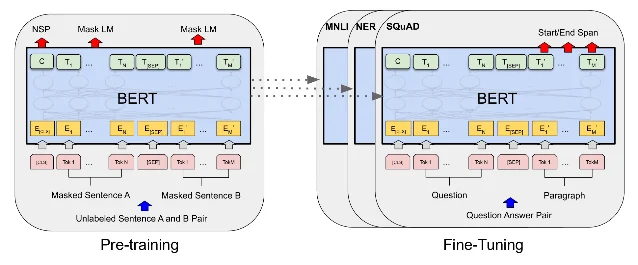
[CLS] 或词元表示接到 MNLI、NER、SQuAD 的输出层。图中虚线表示同一套预训练参数被复制到不同下游任务。12实验数字应该怎样读
BERT 的实验覆盖句对分类、问答、常识推断和命名实体识别。先看 GLUE,因为它让模型规模、基线和指标口径比较集中。BERTBASE 的表内平均分为 79.6,BERTLARGE 为 82.1;这张表排除了 WNLI,因此这个平均值与官方 GLUE 分数不同。论文写作时的官方排行榜上,BERTLARGE 得分为 80.5,OpenAI GPT 为 72.8。表内逐任务比较也显示,BERTLARGE 在 MNLI-m 上为 86.7,OpenAI GPT 为 82.1,绝对提升 4.6 个百分点。13
SQuAD 1.1 的数字需要区分系统组合方式。BERTLARGE 单模型在开发集上的 F1 为 90.9;加入 TriviaQA 微调数据后,BERTLARGE 集成在测试集上的 F1 为 93.2。这个 93.2 是 7 个不同预训练检查点和微调随机种子组成的集成,并且使用了额外的 TriviaQA 微调数据。SQuAD 2.0 允许段落没有答案,BERTLARGE 单模型测试集 F1 为 83.1。把这些数字写成“一个 BERT 模型达到 93.2”会抹掉集成和额外数据的作用。14
SWAG 更适合观察句对表示的迁移。任务给出一句话和四个可能的后续,模型选择最合理的续写。BERTLARGE 测试集准确率为 86.3,OpenAI GPT 为 78.0,ESIM+ELMo 为 59.2;论文同时报告五名标注者的一致结果为 88.0。这个实验支持 BERT 对句间关系的处理能力,但它仍然是一个特定数据集上的选择题,不能单独证明模型获得了普遍的常识推理能力。15
模型变大为什么能帮助小数据任务
BERTBASE 有 12 层、768 维隐藏状态、12 个注意力头和约 1.1 亿参数;BERTLARGE 有 24 层、1024 维隐藏状态、16 个注意力头和约 3.4 亿参数。两者的预训练语料包括 BooksCorpus 的 8 亿词和英文 Wikipedia 的 25 亿词,论文还强调需要文档级文本来构造连续长序列。7
规模消融保持预训练和微调流程不变。3 层、768 维、12 个头的模型在 MNLI-m、MRPC、SST-2 开发集上分别为 77.9、79.8、88.4;12 层、768 维、12 个头的模型为 84.4、86.7、92.9;24 层、1024 维、16 个头的模型为 86.6、87.8、93.7。MRPC 只有约 3600 个标注训练样本,规模增加仍然带来提升。16
这个结果的合理读法是:充分预训练后,较大的表示空间能给小数据下游任务提供更多可微调的特征。这个读法仍然依赖论文的训练语料、模型结构和超参数;规模本身没有脱离预训练条件独立地产生能力。
局限与后续问题
BERT 的 MLM 有一个明确的效率代价:每条序列只对 15% 的位置计算预测,论文附录报告它比每个位置都预测的左到右语言模型收敛略慢。训练和微调之间还存在
[MASK] 只出现在预训练阶段的问题,80/10/10 的混合替换是为减轻这个错位而设计的。17模型规模也带来微调不稳定性。BERT 原论文指出,BERTLARGE 在小数据集上有时需要多次随机重启,再从开发集选择结果。论文的证据来自英语语料、最长 512 个词元的输入和 2018 年的任务设置;这些条件决定了实验结论的范围。BERT 的结果证明了一套具体预训练配方的迁移能力,不能自动延伸成所有语言、所有长度和所有任务上的结论。
直接后续工作 RoBERTa 把问题推进到预训练配方本身。Yinhan Liu 等人的摘要称,他们重新复现并优化 BERT 预训练,发现 BERT 存在训练不足,数据量和超参数对结果有显著影响。这个关系很具体:RoBERTa 保留 BERT 式编码器和迁移框架,把更多注意力放到训练量、数据和超参数,而不是另造一个完全不同的下游接口。18
因此,读 BERT 时最值得带走的判断不是“预训练很重要”这句共识,而是下面这条可检查的计算链:
- 左到右语言模型让每层表示缺少右侧上下文,词元级任务尤其吃亏。
- 直接做双向语言模型会让目标词泄露给自己。
- MLM 随机移除目标词,只在被选位置预测原词,于是每个目标位置可以融合左右上下文。
[CLS]、[SEP]、句段 embedding 和词元隐藏状态,把句子级、句对级、词元级任务接到同一编码器上。- NSP 给句对关系增加训练信号,但它的收益必须通过同条件消融来判断。
- BERT 的实验收益同时受双向目标、预训练语料、模型规模、微调方式和集成设置影响。
以后读一篇新的预训练论文,可以先问四个问题:它遮住或预测的对象是什么?训练阶段和下游阶段的输入是否一致?模型把哪一个向量交给任务头?实验是否把数据量、训练步数、模型规模和集成结果拆开报告?这四个问题比记住一个新模型的缩写更能帮助你判断它究竟改了哪一笔交换。
References
- 1BERT 原论文摘要页
arxiv.org
- 2ELMo 原论文摘要页
arxiv.org
- 3BERT 原论文第 1、3 节
ar5iv.labs.arxiv.org
- 4BERT 原论文第 3.1 节
ar5iv.labs.arxiv.org
- 5BERT 原论文附录 A.1
ar5iv.labs.arxiv.org
- 6Transformer 原论文摘要页
arxiv.org
- 7BERT 原论文第 3 节与 Figure 2
ar5iv.labs.arxiv.org
- 8BERT 原论文 Table 5
ar5iv.labs.arxiv.org
- 9BERT 原论文 Table 5 与第 5.1 节
ar5iv.labs.arxiv.org
- 10BERT 原论文 SQuAD 1.1
ar5iv.labs.arxiv.org
- 11BERT 原论文第 3.2 节
ar5iv.labs.arxiv.org
- 12BERT 原论文 Figure 1
ar5iv.labs.arxiv.org
- 13BERT 原论文 Table 1 与 GLUE 结果
ar5iv.labs.arxiv.org
- 14BERT 原论文 Table 2、Table 3
ar5iv.labs.arxiv.org
- 15BERT 原论文 Table 4
ar5iv.labs.arxiv.org
- 16BERT 原论文 Table 6 与第 5.2 节
ar5iv.labs.arxiv.org
- 17BERT 原论文附录 A.1 与 C.1
ar5iv.labs.arxiv.org
- 18RoBERTa 原论文摘要页
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.