《DDPM》:把图像生成拆成一千步去噪,损失函数为什么只剩预测噪声
从一步生成的难题出发,拆解 DDPM 的前向加噪链、反向去噪链与变分下界,讲清训练目标为什么能简化成一行预测噪声的均方误差,并用 CIFAR-10、LSUN 的表格与率失真实验读懂它的样本质量、采样代价与能力边界。
2020 年 6 月,Jonathan Ho、Ajay Jain 与 Pieter Abbeel 把一篇论文挂上 arXiv,标题是《Denoising Diffusion Probabilistic Models》,编号 arXiv:2006.11239,同年 12 月发表在 NeurIPS 2020,三个人当时都在加州大学伯克利分校。12
这篇论文要回答的问题,可以从一次具体的操作说起。取一张 32×32 的彩色图像,往里加一点高斯噪声,把结果当作新的输入再加一点噪声,重复一千次,最后得到的几乎就是一张标准正态噪声图。这个方向完全确定:每一步注入多少噪声由一个事先定好的方差序列给出,甚至不必逐步模拟,可以一步算出任意第 步的加噪结果。
反方向就麻烦了。给你一团纯噪声,让你一次退回原图,你手里没有任何依据;但如果只让你退极小的一步,需要决定的只有"刚才这一步大概混进了什么噪声"。DDPM 做的全部事情,就是把后面这种极小的一步重复一千遍,并证明这一千遍值得被当作一个生成模型来训练。论文给出的结果同样具体:无条件 CIFAR-10 上 Inception Score 9.46、FID 3.17,256×256 的 LSUN 上样本质量与 ProgressiveGAN 接近。3
2020 年的生成模型,卡在哪一步
在扩散模型之前,深度生成模型有四条成熟路线,各自的一步到位都带着代价。3
生成对抗网络(GAN)让生成器与判别器对抗,一次前向就出图。它的问题在训练本身:两个网络的博弈没有稳定的目标函数,判别器过强会让生成器拿不到有效梯度,而且生成分布容易丢掉数据里的若干模式。
自回归模型(如 PixelCNN、Sparse Transformer)把联合分布拆成逐坐标的条件概率。它必须事先选定一个坐标顺序,而图像没有天然的先后;采样要按这个顺序一格一格走,无法并行。
流模型(flow)要求变换可逆,还要计算雅可比行列式,架构设计因此处处受限。
变分自编码器(VAE)优化的是对数似然的变分下界,训练稳定,但近似后验与解码器的表达能力会成为上限。
2015 年,Sohl-Dickstein、Weiss、Maheswaranathan 与 Ganguli 提出过一条不同的路:先用一个前向过程逐步破坏数据结构,再学一个反向过程把结构恢复回来,框架来自非平衡热力学。4 这个框架在当时只是定义清楚、训练高效,DDPM 的作者在引言里写得很直白:据他们所知,此前还没有证据表明扩散模型能生成高质量的样本。3
DDPM 因此有两个声明。一是扩散模型确实能生成高质量样本,样本质量在 CIFAR-10 这一档上超过当时多数模型;二是把反向过程的均值换成预测噪声之后,训练目标与"多噪声尺度下的去噪分数匹配"(denoising score matching)在形式上重合,采样过程与退火 Langevin 动力学重合,而论文最好的样本质量恰恰来自这个参数化。作者把这条等价关系视为主要贡献之一。
前向链:把结构破坏掉,而且要破坏得刚刚好
前向过程是一个固定的马尔可夫链,它不含任何要学的参数,只按一个方差序列 往数据里注入高斯噪声。3
这个式子每一步在算什么,拆开看只有两个动作。先把上一步的图像乘上 ,让它略微缩小;再加上一份方差为 的高斯噪声。乘积因子不是装饰:如果不缩小原有信号,每加一次噪声、总方差都会变大,走上一千步数值就会漂到无法处理的范围。
前向过程还有一个好性质:它可以跳过中间步骤。记 ,,则第 步的加噪结果服从
写成采样形式就是 ,其中 。训练时不需要模拟整条链:随手取一个时刻 、取一份随机噪声,就能直接造出该时刻的含噪样本。这一步是后面算法能写得那么短的原因。
论文把方差序列固定成常数,从 线性增加到 ,时间步总数 ,没有做扫描。3 这两个数字之间有约束关系。 必须相对数据尺度足够小,正向与反向过程才有近似相同的函数形式,逆过程才可以用条件高斯来近似;同时整条链走完,信号要被破坏得足够彻底,使 与标准正态先验几乎重合。论文测量到这一步的 KL 散度大约是 bits/dim,也就是可以放心地把 直接当作先验来采样。
反向链:每一步只做一件小事
反向过程是一条学习的马尔可夫链,从标准正态噪声出发,每一步给出一个条件高斯分布。3
这里的 ,网络在时刻 要看的是含噪图像 和时间步 ,输出的是"上一步的图像应该服从哪个高斯分布"。论文把协方差直接固定成与时间有关的常数 ,只让网络学均值 ,因为让网络同时学方差会带来训练不稳定,4.2 节的消融会把这件事摊开。
采样时每一步的计算只有三项。按论文式 (11) 代入后的形式,
第一项把网络预测的噪声 按系数 从 里减掉,再除以 把缩放还原。做完这两步,得到的其实是当前对"干净图像"的估计。最后一项加回一份缩小过的随机噪声 , 时这一项取零。保留这份噪声,是为了让每一步的分布仍然是一个完整的高斯,而不是塌成一个点。
把上式里的减噪部分单独拿出来,就得到论文式 (15):
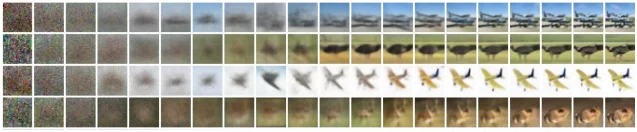
它在整条链的任何时刻都成立。这意味着采样走到一半时,可以把当前对最终图像的猜测画出来看。论文在 CIFAR-10 上做了这件事,效果就是下面这张图。
目标函数:从变分下界到一行均方误差
训练扩散模型就是最大化数据对数似然 ,而 的似然要对所有可能的噪声轨迹积分,积不出来。标准做法是优化它的变分下界,也就是通常说的 ELBO。3
这个式子在算什么,可以这样理解:真实的噪声轨迹不可观测,于是拿前向过程 当作近似后验,在所有可能的轨迹上取期望。因为 完全由 决定、没有任何可学参数,这个期望可以用采样估计,梯度也是可算的。
把对数里的比值展开,逐项整理, 可以写成三个部分之和(论文式 5):
三项各管一段。 比较"'加噪到第 步之后的分布"与"先验", 固定之后它与网络参数无关,训练时直接忽略。中间的 要求网络给出的每步后验贴住真实后验,这是训练的主体。 是最后一步从 还原出像素的对数似然,它后面会决定"无损码长"的说法能不能成立。
要让 可算,需要知道真实后验 。它在给定干净图像 时有闭式解:
是 与 的一个加权组合:。它说明"这一步该退回哪里"完全由"干净图"和"当前含噪图"共同决定。因为式 (5) 里每一个 KL 都是两个高斯之间的比较,这些项都能用闭式表达,不需要高方差的蒙特卡洛估计。
有了这一层, 可以改写成均值的平方误差:
与网络参数无关。到这里最自然的做法是让网络直接预测 。DDPM 的转折点发生在这里:把 代入, 里含有 的部分就换成了一张由 和噪声 表达的式子,式 (8) 随之变成
形式变了,但要学的对象也换了:网络不再输出一串"均值图像",而是输出"这一步被注入的那份噪声"。两者只差一个确定的仿射变换, 本身又是网络的输入,所以这个换法不损失任何表达能力。收益从式 (12) 的系数项直接看出来——预测噪声的目标与 的尺度脱钩,网络只需判断"噪声长什么样"。论文指出,这个目标与多噪声尺度下的去噪分数匹配形式相同,采样过程则与退火 Langevin 动力学形式相同。3
论文最后把式 (12) 前面的权重一整块丢掉,得到训练实际使用的目标:
在 到 之间均匀取。丢掉权重之后,各个时刻的重要性就由 的计划本身决定: 小的时候噪声很小、去噪任务容易,这些项被相对压低; 大的时候噪声重、任务难,这些项被相对抬高。论文据此把计算注意力从"清理轻微噪点"挪到"重噪声下恢复结构",4.2 节的消融显示这样训练的样本质量更好。这一段也解释了训练目标为什么可以写成一行的均方误差:简化之后的 仍然是一个加权过的变分下界,只是权重由作者选定。3
两个算法,逐行读
训练循环只有五行。3
- 从数据里取一张 (实践中是一个 batch)。
- 均匀随机取一个时间步 。
- 采样一份标准正态噪声 。
- 用式 (4) 直接构造 ,把 一并交给网络。
- 沿 做一步梯度下降。
整个过程里没有对抗训练,没有重要性采样,也不用模拟整条链。每个 batch 只随机命中一个时刻,所以训练是并行友好的。
采样循环同样短,但它有另一层代价。3
- 从 取 。
- 对 依次执行:
- 若 取 ,否则 。
- 按式 (11) 算出 。
- 循环结束后返回 。
第 4 步要跑一千次网络前向,而且必须顺序执行: 依赖 和该时刻的网络输出,没有任何可以并行展开的维度。论文附录 B 给出实测:CIFAR-10 模型在 TPU v3-8 上采样 256 张图需要 17 秒,256×256 的模型采样 128 张需要 300 秒。3 训练侧的账本则是:CIFAR-10 模型以 batch 128 跑到 800k 步约 10.6 小时,模型规模 3570 万参数,256×256 的模型 1.14 亿参数,更大的 LSUN Bedroom 变体约 2.56 亿参数。
式 (11) 的形状还解释了这份工作后来为什么被叫作"朗之万式采样"。 可以读成学到的数据密度的梯度方向,每一步沿它挪一小段、再加回一点噪声,与退火 Langevin 采样的写法一致。论文在 3.2 节把这条对应写成了它的主要贡献之一。
数据缩放与最后一小步的离散解码
图像数据是 0 到 255 的整数。论文把它们线性缩放到 ,让逆过程的输入尺度与标准正态先验一致。3 最后一小步则要单独处理:采样结束时直接输出 是可以的,但要得到一个可以写成"码长"的似然, 必须定义在离散像素上。论文把每个像素的似然定义成对高斯概率密度在区间 上的积分,端点做截断处理。
这样做的好处很直接:变分下界随之成为一个真正的无损码长(bits/dim),既不需要往数据里加噪声,也不需要把缩放的雅可比写进对数似然。代价是似然与样本质量是两件不同的事,一个模型完全可以样本好看、码长难看——这篇论文正是这样,Table 1 会把这个反差摆在明面上。
实验怎么读:三张表各回答一个问题
论文在 CIFAR-10、CelebA-HQ 256×256 与 LSUN 256×256 上训练模型。骨干网络沿用 PixelCNN++ 的思路:一个基于 Wide ResNet 的 U-Net,把权重归一化换成组归一化,时间步 通过 Transformer 的正弦位置嵌入加到每个残差块里,在 16×16 特征图分辨率上用自注意力。优化器用 Adam,CIFAR-10 学习率 ,256×256 图像降到 ,用了衰减因子 0.9999 的参数 EMA,CIFAR-10 上开了 0.1 的 dropout 和随机水平翻转。3
读实验之前先分清三个指标在测什么。Inception Score(IS)与 FID 都借助一个在 ImageNet 上预训练的分类器来给生成样本打分,IS 越高越好,FID 越低越好,两者都衡量样本的分布质量与多样性;bits/dim 则是负对数似然换算出的无损码长,越低越好。三者测的是不同的东西,不能互相替代。
Table 1 回答"这套方法在样本质量上处在什么位置",下面是其中几行。3
| 模型 | 条件设置 | IS | FID | NLL(bits/dim) |
|---|---|---|---|---|
| BigGAN | 类条件 | 9.22 | 14.73 | — |
| StyleGAN2 + ADA (v1) | 无条件 | 9.74 ± 0.05 | 3.26 | — |
| NCSN | 无条件 | 8.87 ± 0.12 | 25.32 | — |
| SNGAN-DDLS | 无条件 | 9.09 ± 0.10 | 15.42 | — |
| Gated PixelCNN | 无条件 | 4.60 | 65.93 | 3.03(2.90) |
| Sparse Transformer | 无条件 | 2.80 | — | 2.80 |
| Ours(LL,固定各向同性 ) | 无条件 | 7.67 ± 0.13 | 13.51 | ≤3.70(3.69) |
| Ours() | 无条件 | 9.46 ± 0.11 | 3.17 | ≤3.75(3.72) |
这张表里有四处需要留意的地方。第一,FID 的比较要在同一条赛道上:本文的无条件模型 FID 3.17 低于 StyleGAN2 + ADA 的无条件结果 3.26,IS 9.46 则低于对方的 9.74,两边各有胜负;BigGAN 那一行的 14.73 是类条件模型,标签本身就是额外信息,不能直接放在无条件一栏比较。第二,本文报告的 FID 是对训练集计算的,论文自己也在 4.1 节给出对测试集的结果 5.24。第三,NLL 一栏才是本文的短板:它的 ≤3.75(括号里是训练集上的值)明显不如 Gated PixelCNN 的 3.03(2.90),更不如 Sparse Transformer 的 2.80,论文对此的描述是自家的对数似然无法与其它似然类模型相比。第四,同一行里 IS、FID 与 NLL 的最佳值落在不同的模型上,这说明"样本好看"和"概率准"在当时的水平下是两件事。
Table 2 回答"为什么这个参数化被选中",它是本文最该被逐格读的一张表。3
| 预测目标 | 训练目标 | IS | FID |
|---|---|---|---|
| (基线) | 变分下界,学习对角 | 7.28 ± 0.10 | 23.69 |
| (基线) | 变分下界,固定各向同性 | 8.06 ± 0.09 | 13.22 |
| (基线) | 空白 | 空白 | |
| (本文) | 变分下界,学习对角 | 空白 | 空白 |
| (本文) | 变分下界,固定各向同性 | 7.67 ± 0.13 | 13.51 |
| (本文) | () | 9.46 ± 0.11 | 3.17 |
表里的空白不是遗漏,论文注明这些组合训练不稳定、样本分数越界,因此无法报告。三个结论可以依次读出:预测 只有在用完整变分下界训练时才站得住,换成无权均方误差就崩;让网络学习对角协方差 会带来不稳定和更差的样本质量,所以本文选择固定协方差;预测 配合固定协方差时,与预测 的结果接近(13.51 对 13.22),只有配上简化目标 才把 FID 压到 3.17。也就是说,这篇论文的两个改动——换参数化、换训练目标——是一起才成立的。
Table 3 回答"这套方法在更大分辨率上还能不能领先",答案比 CIFAR-10 上保守。3
| 模型 | LSUN Bedroom | LSUN Church | LSUN Cat |
|---|---|---|---|
| ProgressiveGAN | 8.34 | 6.42 | 37.52 |
| StyleGAN | 2.65 | 4.21* | 8.53* |
| StyleGAN2 | — | 3.86 | 6.93 |
| Ours() | 6.36 | 7.89 | 19.75 |
| Ours(,大模型) | 4.90 | — | — |
带星号的分数由 StyleGAN2 的报告给出,其余由各论文作者报告。本文在 Bedroom 与 Church 上优于 ProgressiveGAN,大模型把 Bedroom 的 FID 压到 4.90;但在 Church 与 Cat 上明显不如 StyleGAN 与 StyleGAN2。摘要里那句"在 256×256 LSUN 上得到与 ProgressiveGAN 相似的样本质量",正是对这张表的如实概括。
论文最后一个实验回答的是"这条链还能被当成别的什么来读"。把 当作码率、把 当作失真,本文样本质量最高的 CIFAR-10 模型是 1.78 bits/dim 的码率配 1.97 bits/dim 的失真,后者折合在 0 到 255 尺度上的均方根误差 0.95。论文由此指出,超过一半的无损码长被用来描述肉眼看不出的细节。3 前面那张 Figure 6 就是这段论证的生成侧证据:接收方每多拿到一段信息, 就清晰一档。论文也在附录里给这套压缩解释划了边界:发送与接收算法依赖 minimal random coding 一类过程,对高维数据并不可行,它只是变分下界的一种压缩解读,不是一个可部署的压缩系统。
局限:哪些结论不能从这里推出来
第一处代价在采样。反向链要跑 次网络前向,顺序依赖,不能并行;论文自己的实测是 256×256 模型采样 128 张需要 300 秒。这个成本与一步生成的方法相比高出几个数量级,也是后续工作最先动手的地方。
第二处代价在似然。本文 CIFAR-10 模型的 NLL 在 3.69 到 3.75 之间,落后于 Gated PixelCNN 与 Sparse Transformer,论文没有把这一项写成优势。
第三处边界在数据。三个数据集都是固定分辨率的图像,CIFAR-10 只有 32×32;256×256 的 CelebA-HQ 与 LSUN 之外,论文没有验证更高分辨率或其它模态。
第四处是稳定性。让网络学习反向过程的方差在本文设置下不稳定,Table 2 里对应的组合只能留空,这一格后来由后续工作补上。
第五处是超参选择。 没有做扫描,方差序列从常数、线性、二次三种计划里挑了线性一种,条件是让 ;样本分数取训练过程中的最小 FID。这些选择说明结果对超参的稳健性在本文里只做了有限验证。
最后是那套压缩解释的边界:论文在附录里写明它是 proof of concept,变量与算法都依赖不可行的编码过程。
影响与延伸阅读:四个被改写的接口
DDPM 留下的东西可以用"接口"来说:一个固定的前向过程、一个与采样顺序解耦的训练目标、一个必须走很多步的采样器、一个只在像素空间工作的骨干。之后的工作几乎各自认领了一个接口。
DDIM 改的是采样器。它构造一类非马尔可夫的前向过程,训练目标与 DDPM 相同,但反向过程可以少走很多步,论文报告在墙钟时间上比 DDPM 快 10 到 50 倍,并且可以直接在潜空间里做有语义意义的插值。5
Improved DDPM 改的是方差参数化。它学习反向过程的方差,让模型在保住样本质量的同时拿到有竞争力的对数似然,并报告用少一个数量级的前向次数就能完成采样;它还用 precision 与 recall 比较扩散模型与 GAN 对目标分布的覆盖情况。6
Classifier-Free Guidance 改的是条件。它同时训练一个条件模型和一个无条件模型,把两者的分数估计组合起来,于是不需要额外训练一个分类器,就能在样本保真度与多样性之间做调节。7
Latent Diffusion 改的是工作空间。它把扩散过程搬到预训练自编码器的潜空间里做,并在架构中引入 cross-attention 来接受文本或边框等条件,显著降低了计算需求,也让高分辨率与条件生成变得可行。8
往回看,这套框架的起点是 2015 年那篇用非平衡热力学定义前向与反向过程的论文。4 DDPM 站在它上面,做的是把损失函数写短、把参数化选对,并把样本质量推到当时的前列。这两篇放在一起读,能看清一个框架从"定义完整"走到"结果可用"之间隔着什么。
读完论文留下四个思考维度
第一,把困难的一步拆成很多容易的小步。从噪声直接生成图像是一个很难的条件分布,DDPM 把它换成一千个"只减一点噪声"的小分布,每个都近似高斯。读论文时值得留意作者是在哪一步做的这种拆分,以及拆分后用了什么近似。
第二,参数化决定优化难度。同一个变分下界,让网络输出均值还是输出噪声,改动的只是一个仿射变换,但 Table 2 里的结果差了整整一个量级。看到论文强调"我们采用了某种参数化"时,应该去表里找它对训练稳定性的影响。
第三,丢掉权重不等于丢掉信息。把式 (12) 的系数丢成式 (14),实际效果是重新分配各时刻的权重。判断这类简化值不值得,要问的是权重被挪到了哪一类样本上。
第四,指标口径与代价必须一起读。样本质量、似然、采样步数、墙钟时间、数据覆盖,测的是五件事;这篇论文在样本质量上给出 3.17 的 FID,在似然上落后,在采样上要跑一千步。把这三句话放在一起,才算读完了它的结论。
References
- 1arXiv 摘要页给出的作者、机构与提交日期
arxiv.org
- 2NeurIPS 2020 会议论文页面
proceedings.neurips.cc
- 3原论文摘要与 Table 1
ar5iv.labs.arxiv.org
- 4
- 5
- 6
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.