《反向传播》:误差如何教会隐藏层学习表征
从隐藏层没有目标值这个具体难题出发,逐步读懂反向传播如何用链式法则分配误差、更新权重,并判断它在对称性与家谱实验中真正证明了什么。
1986 年,David E. Rumelhart、Geoffrey E. Hinton 与 Ronald J. Williams 面对一个至今仍会出现在每个深度学习模型里的问题:网络输出错了,隐藏层里的单元究竟该改多少?隐藏单元既不是输入,也没有人工给出的目标值。只盯着输出层更新权重,网络就很难学出中间特征。论文《Learning representations by back-propagating errors》给出的答案,是把输出误差沿着连接反向传回隐藏层,再用每条路径上的局部导数计算权重应该怎样改变。1
这篇论文发表于 Nature 323(6088):533–536,作者来自加州大学圣迭戈分校认知科学研究所和卡内基梅隆大学计算机科学系。2 论文的贡献可以沿一条计算链读完:前向计算得到输出,损失函数衡量错误,链式法则把错误对参数的影响逐层拆开,梯度下降据此更新权重。真正值得带走的判断,是反向传播把“隐藏层该为最终错误负责多少”变成了可计算的问题。
隐藏层为什么缺少训练信号
先看一个只有输入层和输出层的网络。每个输入单元都把自己的活动值乘上连接权重,再汇总到输出单元。训练数据直接告诉网络:这个输出应该更大,那个输出应该更小。于是,输出层的权重有明确的改动方向。
加入隐藏层后,情况发生了变化。隐藏单元的活动值是网络自己算出来的,训练样本只给出最终输出的目标。一个隐藏单元可能同时影响多个输出;某条连接的作用还会经过后续多层权重和非线性函数。网络需要回答的具体问题是:这条连接稍微变化一点,最终误差会变化多少?
这也是单层感知机式规则面对的边界。镜像对称性就是一个小而清楚的例子:输入是一串二进制数,输出要判断整串数是否关于中心对称。单个输入位置只能告诉网络这一位是 0 还是 1,整串输入的全局关系需要中间层把多个位组合起来。原论文用这个任务展示了隐藏层的必要性。3
先做一次前向计算
论文把网络写成按层排列的单元。对来自下层的连接,单元
j 的总输入是:y_i 是下层单元 i 的输出,w_{ji} 是从 i 到 j 的连接权重。这个式子只做一件事:把每个输入按连接强度缩放,再把缩放后的数加起来。偏置可以看成一个恒等于 1 的额外输入,它也通过一个权重进入总输入。总输入经过非线性函数后,得到单元输出:
原论文使用的是 sigmoid 函数。函数把任意实数压到 0 和 1 之间,而且在工作区间内有导数。这个可导性是反向传播能够逐层计算的前提。3
从输入到输出的过程叫前向计算。网络先固定输入单元的状态,再从底层开始逐层计算,直到得到输出单元的状态。此时网络已经给出答案,但还没有告诉隐藏层该怎样修改。
误差先落在输出层
假设训练样本有一个输入向量和一个目标输出向量。对所有样本、所有输出单元,论文定义平方误差:
先对输出单元
j 求偏导:这一步只回答输出层的局部问题:实际输出比目标大多少。实际输出偏大,导数为正;实际输出偏小,导数为负。这个误差信号还没有穿过 sigmoid,也没有穿过任何连接权重。
链式法则把误差送回上一层
输出单元的总输入是
x_j,输出是 y_j=f(x_j)。如果要知道总输入改变一点会怎样影响误差,就沿着这条局部计算链相乘:式子右边的第一项表示输出误差,第二项表示 sigmoid 在当前位置对输入有多敏感。两项相乘后,网络得到“总输入向这个方向移动一点,误差会怎样变化”的数值。3
现在看一条从下层单元
i 到当前单元 j 的连接。总输入里有一项 y_i w_{ji},所以对权重求导得到:这一步的含义很具体:当前单元对误差有多敏感,再乘以下层单元实际提供了多大输入,就得到这条权重对误差的责任。输入单元活动越大,连接权重的改变对当前总输入影响越大。
隐藏单元的误差信号则来自它对所有上层单元的影响。对隐藏单元
i,论文写成:隐藏单元可能连接到多个上层单元,因此它收到的是各条后续路径贡献的总和。得到这个量后,网络再乘上隐藏单元自己的局部导数,把误差信号继续向更早的层传递。3
这里的“反向”指的是求导方向:前向计算从输入走向输出,反向计算从输出误差走回输入方向。每一层都复用下一层已经算出的误差信号,因而不需要为每个参数重新展开整条网络。
一次完整的权重更新
把上面的计算排成算法,顺序如下:
- 输入样本。 把输入向量放到输入层。
- 前向计算。 按层计算
x_j和y_j,直到得到网络输出。 - 计算误差。 用实际输出和目标输出计算
E。 - 输出层反向求导。 先得到
∂E/∂y_j,再得到∂E/∂x_j。 - 逐层传回。 对每条连接计算权重梯度,并把误差信号传给更早一层。
- 累积梯度。 论文的实验先对一组输入—输出样本累积
∂E/∂w。 - 更新权重。 用梯度下降改变每条连接的权重。
最简单的更新式是:
∂E/∂w 指向误差上升最快的方向,所以加上它的相反方向,误差就有机会下降。ε 是步长,决定每次更新迈多远。步长过大,权重可能在低误差区域来回跳动;步长过小,训练会变慢。原论文还加入了一个动量式加速项:
上一轮的权重变化会保留一部分。如果连续几轮梯度方向相近,更新会积累速度;如果方向来回改变,历史项会部分抵消。这里的
α 是原论文的指数衰减因子,读者可以把它理解成“上一轮步子的保留比例”。3Figure 1:隐藏单元怎样学出对称性
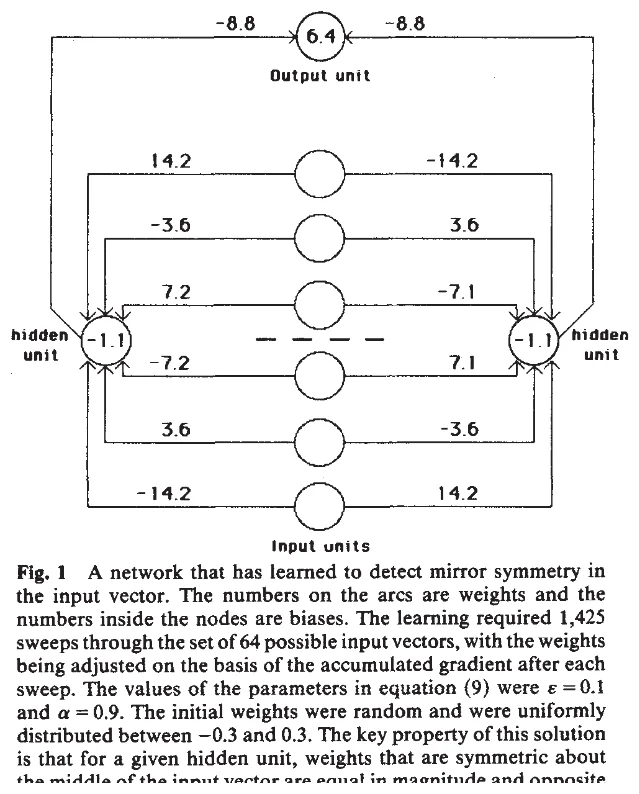
这张图值得慢慢读。对于一组镜像对称的输入,左右两边对隐藏单元的贡献会互相抵消,两个隐藏单元都保持关闭,输出单元被激活。对于非对称输入,抵消关系被打破,两个隐藏单元中至少有一个会被激活,并抑制输出。
网络一开始并不知道“左边”和“右边”应该怎样比较。训练过程只看到每个输入向量对应的对称或非对称标签。反向传播把最终判断的误差分解到每条连接,权重逐轮改变,最后形成了这种可解释的对称结构。隐藏层学到的关系并没有直接写在输入编码里,也没有作为中间标签提供给网络。
论文报告,这个网络在 64 个可能输入向量上训练了 1,425 个 sweep;初始权重在
-0.3 到 0.3 之间随机取值,训练使用 ε=0.1 与 α=0.9。这些数字描述的是一个小型机制演示,作用在于展示隐藏层如何形成结构,不能拿来估计现代深度网络的训练效率。3第二个实验:分布式表征能否帮助泛化
论文的第二个任务是两棵同构家谱。第一棵家谱使用英国名字,第二棵家谱使用意大利名字;两棵树的关系结构相同。训练样本写成三元组:
(人物 1,关系,人物 2)。网络读取前两个元素,输出第三个元素,例如根据某个人和“有姑妈”这个关系找出对应人物。3输入和输出端为每个人分别设置了单独的单元。隐藏层却可以用一组分布式活动表示更抽象的特征。原论文展示的权重表明,一个隐藏单元主要区分英国人与意大利人,另一些隐藏单元更接近人物所属代际或家族分支。这样,网络可以利用两棵家谱之间的同构结构,把一棵树中学到的关系迁移到另一棵树。
论文在 104 个可能三元组中训练了 100 个,并报告网络正确泛化到没有参加训练的 4 个三元组。3 这个结果支持一个窄而重要的判断:隐藏单元可以学习输入和输出编码中没有明确写出的中间特征,并用这些特征完成未见过的组合。
实验规模很小,家谱结构也由研究者预先构造。这个实验展示的是机制:分布式隐藏表征如何压缩任务中的规律,并帮助网络泛化到缺失组合。它没有给出自然图像、语音或语言任务上的性能保证。
论文把什么讲清楚了,什么仍然困难
反向传播解决的是梯度如何到达隐藏层。它把一条多层计算路径拆成局部导数的乘积,并在不同参数之间复用中间结果。这个方法让网络可以直接从最终输出误差调整内部连接,也让隐藏层有机会形成任务相关的表示。
它同时留下了几个边界。
第一,论文承认误差面可能包含局部极小值,梯度下降没有找到全局最小值的保证。作者的经验观察是,在连接数略有富余时,网络很少卡在明显差于全局最优的局部极小值;这个观察来自论文讨论的任务和实验范围。3
第二,当前形式缺少生物学合理性。论文最后明确写道,这套学习过程还不是对大脑学习的可信模型;论文的贡献是证明梯度下降可以构造有趣的内部表征,并提示研究者继续寻找更符合生物机制的实现。3
第三,小任务中的成功不能直接代替大规模实验。对称性检测和人工家谱把输入结构控制得很干净,便于观察隐藏单元学到了什么。真实任务还会加入数据规模、网络深度、初始化、激活函数、正则化和计算资源等因素。
影响:同一条梯度链如何进入卷积网络
反向传播的影响可以从一个具体延伸看:Yann LeCun、Léon Bottou、Yoshua Bengio 与 Patrick Haffner 在 1998 年的《Gradient-based learning applied to document recognition》中,把梯度学习用于文档识别,并系统讨论了卷积网络、局部连接、共享权重和逐层训练流程。论文发表于 Proceedings of the IEEE 86(11):2278–2324,DOI 为
10.1109/5.726791。4卷积网络改变了连接方式:每个单元只看局部区域,同一组权重在不同位置重复使用。反向传播仍然负责计算损失对这些共享参数的梯度,只是多个位置产生的贡献需要汇总到同一组卷积核上。换句话说,架构可以改变连接的范围和复用方式,梯度链仍然承担信用分配。
沿着这个角度回看今天的 Transformer、扩散模型和大语言模型,读者首先应检查的仍然是同一个问题:最终损失通过哪些可微步骤影响每个参数?模型名称和模块数量会变化,参数责任的计算仍然落在前向值、局部导数和链式乘积上。这句话是从反向传播机制得到的阅读框架,不是说现代模型只包含 1986 年论文里的网络结构。
读完论文留下四个检查问题
- 目标值落在哪一层? 输出层通常有明确监督;隐藏层的更新信号需要沿计算图反向推导。
- 每个局部导数在算什么? 先看误差对当前输出的影响,再看当前输出对总输入的敏感度,最后看总输入对连接权重或下层活动的影响。
- 实验展示的是性能,还是机制? 原论文的两个任务规模很小,主要用于展示隐藏表征、结构共享和泛化过程。
- 后续工作改了哪一笔? 卷积网络改了连接的局部性与参数共享方式;读后续论文时,应继续追踪梯度如何穿过新的计算结构。
反向传播最重要的地方,落在一个很具体的计算动作上:网络先向前产生结果,再从结果的错误出发,沿每一层的局部导数把责任分配回去。这个责任分配让隐藏单元能够从最终任务中学习中间结构,也让多层网络从一组需要手工指定的特征处理器,变成可以共同调整的参数系统。
References
- 1原论文 Nature 页面
nature.com
- 2论文 DOI 书目元数据
doi.org
- 3原论文 Figure 1 与对称性实验
cs.toronto.edu
- 4LeCun 等人的原始论文书目信息
doi.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.