《LeNet-5》:局部连接与权重共享如何把图像识别变成可微系统
从全连接网络的参数膨胀、缺乏平移等变性与忽略空间拓扑三大缺陷出发,拆解 LeNet-5 的卷积核、非完全连接、子采样与欧氏 RBF 结构,并用 MNIST 历史数据与多模型开销读懂经典 CNN 的能力与边界。

1998 年,Yann LeCun、Léon Bottou、Yoshua Bengio 与 Patrick Haffner 在《Proceedings of the IEEE》发表了长达 47 页的经典论文《Gradient-Based Learning Applied to Document Recognition》。1 当时的主流文档识别系统普遍采用两阶段流水线:工程师先凭人工经验设计复杂的特征提取算法,再把提取出的特征向量输入分类器;或者直接把图像展平,塞进全连接神经网络。这篇论文提出了以 LeNet-5 为代表的卷积神经网络,证明用局部感受野、权重共享和空间子采样构成的多层网络,可以直接从原始像素学习特征提取与模式分类,并用基于梯度的反向传播算法完成全局联合优化。2
这篇论文发表于 Proceedings of the IEEE 86(11):2278–2324,出版日期为 1998 年 11 月 30 日,DOI 为
10.1109/5.726791。1 论文的核心贡献可以概括为一条清晰的技术主线:针对二维图像的几何拓扑特性,通过在网络架构中内生性地引入局部连接与权重共享,把以往需要手工调优的图像特征工程,彻底改造成端到端可微分的优化系统。全连接网络面对图像时的三处结构缺陷
在深入卷积之前,读者需要先理解:为什么我们不能直接把图像拉平成一维向量,交给普通的多层感知机(MLP)训练?论文在第二节开篇就指出了全连接网络在图像处理任务上的三处致命缺陷。2
第一处缺陷是参数量随输入分辨率剧烈膨胀。假设输入是一张标准的 32×32 像素图像,输入向量的维度就是 1,024。如果在第一个隐藏层设置 1,000 个神经元,仅这一层就需要超过 100 万个权重参数。巨大的参数量使得模型容量(capacity)严重过大,在有限的训练样本下极易发生严重的过拟合;同时,存储这些权重和计算前向传播都需要巨大的硬件资源,这在 1990 年代的计算条件下几乎无法部署到实际工业系统。
第二处缺陷是完全缺乏对几何平移与形变的鲁棒性。在现实手写数字中,字符的笔画常常发生整体平移、旋转、缩放或者局部挤压。全连接网络中每一个输入位置与隐藏单元的连接都是独立的。如果一个原本出现在图像左上角的数字“3”被平移到右下角,输入向量中激活的数值坐标就会完全改变。全连接网络没有任何内置的机制能够识别出这依然是同一个特征,它必须在图像的每一个可能位置重新把整套特征权重学一遍。
第三处缺陷是彻底忽视了二维空间的拓扑邻近关系。全连接网络将输入图像看作一组无序的数值列表。如果研究者把图像中所有像素的排列顺序按照某种固定规则打乱(例如把原本相邻的像素隔开摆放),全连接网络在打乱后的数据上训练收敛的过程和识别结果不会发生任何变化。然而在真实的自然图像与笔画中,空间上相邻的像素之间存在极强的局部关联性,正是这些相邻像素共同构成了边缘、端点、拐角等基础视觉基元。全连接网络在输入阶段就把这种强烈的几何拓扑先验丢弃了。
卷积神经网络的三大支柱
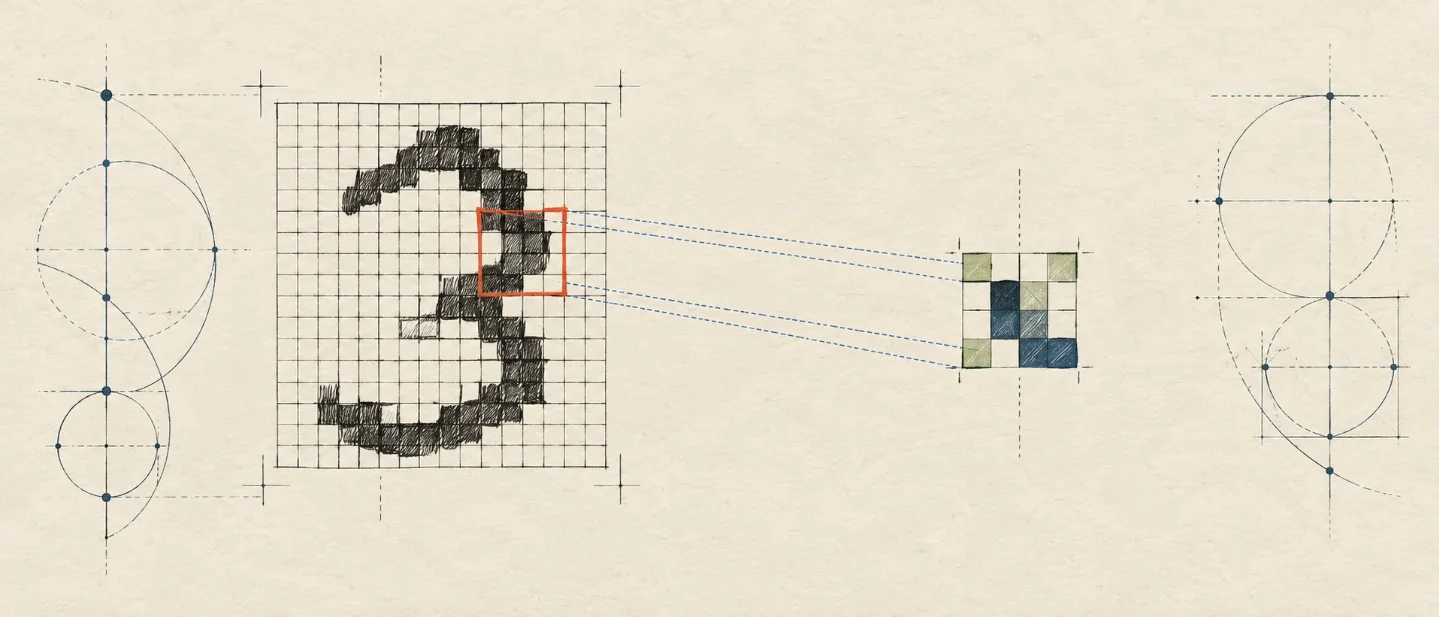
为了解决上述问题,论文总结了卷积神经网络的三项核心设计思想:局部感受野(Local Receptive Fields)、权重共享(Shared Weights,或称 Weight Replication)以及空间子采样(Spatial Sub-sampling)。2
- 局部感受野:隐藏层神经元不再连接全部输入像素,而是只与输入图像的一个局部小窗口(例如 5×5 区域)相连。神经元通过这个局部窗口提取基础的初级视觉特征,比如某特定方向的线段、端点或拐角。这种设计借鉴了 Hubel 和 Wiesel 关于猫视觉皮层感受野的生理学发现。
- 权重共享:这是卷积网络大幅削减自由参数的关键。在同一个特征图(feature map)上,位于不同空间位置的所有神经元强制使用完全相同的一组权重和偏置。这就相当于拿一个固定的 5×5 滤波核(kernel)在整个输入图像上滑动扫描。同一张特征图检测的是整幅图像在各个位置是否出现了某种相同的局部形态,天然具备了平移等变性(translation equivariance)。
- 空间子采样:特征图生成后,网络紧接着通过子采样层降低其空间分辨率。论文指出,一旦网络检测到了某个特定特征的存在(例如字符顶部的水平横线),该特征的精确像素坐标对于最终的字符分类已经不再关键,更重要的是这个特征相对于其他笔画的相对空间位置。降低特征图分辨率可以容忍字符书写时的细微笔画变形、大小伸缩与位置偏移。
这种“卷积提取特征 → 子采样压缩分辨率”的交替堆叠结构,构成了从低级边缘到高级复杂形态的特征金字塔。这套思想最早由 Fukushima 在 1980 年的神经认知机(Neocognitron)中实现,但 Fukushima 当时缺乏端到端的全局监督学习算法;LeCun 等人的突破,是将整套金字塔结构纳入了基于梯度的反向传播体系。3
LeNet-5 的七层架构与逐层计算步骤
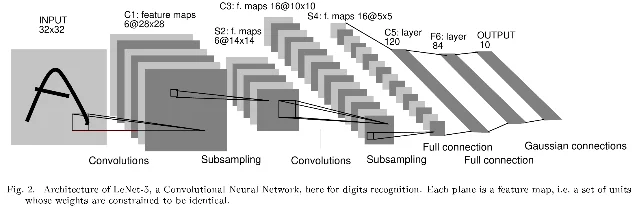
论文第二节 B 小节详细给出了 LeNet-5 的完整架构配置。整个网络共有 7 层(不含输入层),输入图像为 32×32 像素的灰度图。作者解释,MNIST 字符的最大尺寸通常在 20×20 像素以内并居中放置在 28×28 区域中,选择 32×32 是为了让笔画端点、拐角等边缘特征能够落在高层特征检测器感受野的正中心。输入像素经过归一化,白色背景对应
-0.1,黑色笔画前景对应 1.175,这使得输入数据的均值约为 0、方差约为 1,能显著加快梯度优化的收敛速度。2下面我们逐层拆解 LeNet-5 每一步在算什么:
1. 输入层至卷积层 C1
- 特征图数量与尺寸:C1 包含 6 个特征图,每个特征图尺寸为 28×28。
- 计算过程:每个特征图的单元与输入图像中 5×5 的局部邻域连接。滑动步长为 1,无填充(valid padding),因此输出尺寸为 。对于特征图 上位于 的单元,其净输入计算公式为:
式中 为输入图像, 为第 个 5×5 卷积核, 为偏置。计算出的净输入随后送入激活函数。
- 参数量与连接数:每个特征图包含 个权重和 1 个偏置,共 26 个可训练参数。6 个特征图总计 个可训练参数。连接总数为 条。
2. 卷积层 C1 至子采样层 S2
- 特征图数量与尺寸:S2 包含 6 个特征图,每个特征图尺寸为 14×14。
- 计算过程:S2 中的每个单元对应 C1 中同索引特征图的 2×2 不重叠区域。单元把该 2×2 区域内的 4 个输入值求和,乘以一个可训练标量系数 ,再加上一个可训练偏置 ,最后经过放大双曲正切激活函数:
原论文选取的常数为 且 。当标量系数 较小时,单元近似在线性区间工作,起到模糊平滑的作用;当 较大时,配合偏置 可以起到类似于“带噪声的或门”或“带噪声的与门”的作用。
- 参数量与连接数:每个特征图只有 1 个系数和 1 个偏置,共 2 个参数。6 个特征图总计 个可训练参数。连接总数为 条。
3. 子采样层 S2 至卷积层 C3
- 特征图数量与尺寸:C3 包含 16 个特征图,每个特征图尺寸为 10×10,卷积核尺寸为 5×5。
- 非完全连接机制:S2 到 C3 并没有采用现代常见的全通道密集连接,而是采用了论文 Table I 所列的稀疏连接方案:
- 前 6 个特征图(图 0 至 5):每个特征图分别连接 S2 中连续的 3 个特征图(例如图 0 连接 S2 的图 0, 1, 2;图 1 连接图 1, 2, 3,依此类推并首尾相连循环)。
- 接下来的 6 个特征图(图 6 至 11):每个特征图连接 S2 中连续的 4 个特征图。
- 接下来的 3 个特征图(图 12 至 14):每个特征图连接 S2 中不连续的 4 个特征图组合(例如图 12 连接 0, 1, 3, 4)。
- 最后的第 15 个特征图:连接 S2 的全部 6 个特征图。
- 为什么不把 S2 和 C3 全部连起来? 论文明确给出了两点工程考量:第一,非完全连接将连接数和权重数限制在合理范围内;第二,也是更关键的,强制打破网络的对称性。不同的特征图接收到完全不同的输入子集,这迫使它们学习不同且互补的高阶特征组合。
- 参数量与连接数:
- 连接 3 个输入的特征图:每个拥有 个参数,6 个特征图共 个参数;
- 连接 4 个输入的特征图:每个拥有 个参数,9 个特征图共 个参数;
- 连接 6 个输入的特征图:拥有 个参数;
- C3 层参数总数为 个。连接总数为 条。
4. 卷积层 C3 至子采样层 S4
- 特征图数量与尺寸:S4 包含 16 个特征图,每个特征图尺寸为 5×5。
- 计算过程:与 S2 完全相同,每个单元对应 C3 中 2×2 的不重叠窗口,执行求和、缩放加偏置与激活操作。
- 参数量与连接数:每个特征图 2 个参数,16 个特征图共 个可训练参数。连接总数为 条。
5. 子采样层 S4 至卷积层 C5
- 特征图数量与尺寸:C5 包含 120 个特征图,每个特征图尺寸为 1×1。
- 计算过程:卷积核尺寸依然是 5×5,与 S4 的全部 16 个特征图全连接。因为 S4 的特征图大小恰好也是 5×5,5×5 的卷积核在上面只能放置在唯一的中心位置,因而输出尺寸变成 1×1。论文特别注明,这里之所以标记为卷积层 C5 而不是全连接层,是因为如果输入图像分辨率增大,C5 的输出空间尺寸就会大于 1×1,它本质上依然执行二维空间卷积。
- 参数量与连接数:每个特征图包含 个参数。120 个特征图总计 个可训练参数,连接数同样为 48,120 条。
6. 卷积层 C5 至全连接层 F6
- 神经元数量:F6 包含 84 个神经元。
- 计算过程:F6 与 C5 的 120 个输出完全连接。第 个单元计算加权和 ,再经过放大双曲正切函数 输出状态值。
- 为什么正好是 84 个单元? 这个数字直接来自于输出层的设计。84 恰好对应一个标准 7×12 的 ASCII 字符点阵点数。
- 参数量与连接数:参数总数为 个,连接数也是 10,164 条。
7. 全连接层 F6 至输出层 Output
- 单元数量:包含 10 个欧氏径向基函数(RBF)单元,分别对应数字 0 到 9。
- 计算过程:每个 RBF 单元接收 F6 的 84 维状态向量作为输入,计算它与该类别固定参数向量 之间的欧氏距离平方:
参数向量 是人工设定的、在训练中保持固定的 7×12 字符点阵模板,分量取值为
+1(笔画前景)或 -1(背景)。点阵中的 +1 与 -1 恰好落在 F6 双曲正切函数的最大曲率区间,能避免神经元进入饱和区。当输入数字与某个类别的标准点阵越接近,对应的输出 就越接近 0。整个 LeNet-5 网络总计包含 340,908 条连接,但因为权重共享机制,全网的可训练自由参数只有约 60,000 个。
权重共享时梯度怎么算,损失函数如何防止坍缩
有了前向传播的完整计算链,模型接下来需要通过反向传播更新所有参数。读者在自学卷积时最容易产生的一个疑问是:同一个卷积核在特征图的几十个不同位置同时发生前向运算,反向传播时这个核该怎么更新?
论文在第二节 C 小节中给出了极其简明而优雅的算法描述:2
- 按独立连接求偏导:在反向传播计算时,网络先暂时假定各个空间位置上的连接权重是互不相干的独立参数,像普通无权重共享的多层网络一样,依照链式法则分别算出损失关于每个空间位置连接的偏导数 。
- 同名权重局部梯度累加:根据多元微积分的链式法则,如果一个参数在计算图中通过多条路径同时影响最终结果,总导数就等于各路径偏导数之和。因此,网络只需把所有共享该参数的空间位置上的偏导数直接相加,就得到该卷积核权重最终的总梯度:
这意味着特征图越大、滑动感受野越多,反向传播时累积的梯度样本信号就越充分,优化过程也越平稳。
损失函数设计:为什么简单 MSE 会走向崩溃
在输出层,最直观的损失函数是针对正确类别的均方误差(MSE):
式中 是第 个样本, 是该样本的真实类别标签, 是正确类别 RBF 单元输出的欧氏距离。
论文深入分析指出,简单的 MSE 存在两个严重问题。首先,如果允许 RBF 单元的中心向量参与训练,MSE 会导向一种完全无用的坍缩解(collapsing effect):网络会把所有类别的中心向量学成一模一样的常数,同时把 F6 的输出也维持在这个常数上。此时所有输出单元的距离恒等于 0,损失降到最低,但网络彻底无视了输入内容。其次,MSE 只一味压低正确类别的输出距离,缺乏类别之间的竞争机制。
为了引入判别性竞争,论文提出了最大后验(MAP)准则损失函数:
这个公式的物理意义非常明确:
- 第一项是正确类别的惩罚,目标是让网络对正确类别的欧氏距离尽可能小;
- 第二项是对数和项(Log-Sum-Exp),带有负号地充当竞争惩罚。由于 出现在指数上的负号里,要让第二项变小,网络必须拉高所有错误类别的输出距离 ;
- 常数 是一个正数,代表背景或垃圾类别(rubbish class)。它的作用是设一道门槛,防止那些惩罚已经非常大的错误类别被过度放大,避免梯度被极少数极端样本绑架。
在优化算法上,论文采用了对角 Levenberg-Marquardt 二阶随机梯度下降法,利用高斯-牛顿对角近似动态调整每个参数的独立学习率,使得深层卷积网络在 1990 年代的计算机上依然能够以极高效率完成训练收敛。2
实验怎么读:MNIST 数据集的由来与横向模型对比
论文第三节在 MNIST 数据集上对多种主流机器学习方法进行了全面评测。很多现代读者知道 MNIST,但往往不知道这个基准数据集本身正是这篇论文清洗和重构出来的产物。2
MNIST 的构建背景
美国国家标准与技术研究院(NIST)最初发布了特别数据库 3(SD-3)和特别数据库 1(SD-1)。NIST 原本建议用 SD-3 做训练集、SD-1 做测试集。但 LeCun 等人敏锐地发现:SD-3 的样本采集自美国人口普查局的成年雇员,笔迹工整规整;而 SD-1 的样本采集自高中生,笔画随意潦草。 如果直接按照官方建议划分,测试集比训练集难得多,导致很多模型训练与测试分布严重脱节。
为了保证实验结论不依赖于书写者样本的偶然偏差,论文作者解开了 SD-1 中 500 位作者的身份标签,将 250 位高中生的样本划入新的训练集,另外 250 位高中生的样本划入新的测试集。随后,作者用 SD-3 的样本补齐,最终构建出包含 60,000 个训练样本和 10,000 个测试样本的标准 MNIST 数据库,奠定了现代计算机视觉最经典的基准测试集。
横向性能对比与测试集错误率
论文在统一的 10,000 个测试样本上评测了一系列具有代表性的模型,并在 Figure 9 中给出了系统性的错误率对比(不确定度约为 0.1%):2
| 模型类别 | 具体配置与方法 | 测试集错误率 | 核心特征与限制 |
|---|---|---|---|
| 线性分类器 | 单层感知机(常规数据) | 12.0% | 参数量 7,850;无法处理复杂非线性决策边界 |
| 线性分类器 | 成对线性分类器(Pairwise) | 7.6% | 45 个二分类器组合投票 |
| 近邻方法 | 欧氏距离 K-NN() | 5.0% | 无需训练,但需占用 24MB 内存存储全部 6 万张图像 |
| 近邻方法 | 切空间距离(Tangent Distance) | 1.1% | 引入仿射形变流形距离,对微小形变鲁棒,但单图计算量极大 |
| 单隐藏层 MLP | 28×28-300-10(常规数据) | 4.7% | 300 个隐藏单元,参数量约 24 万 |
| 单隐藏层 MLP | 28×28-1000-10(常规数据) | 4.5% | 1,000 个隐藏单元,参数量近 80 万,过拟合风险高 |
| 双隐藏层 MLP | 28×28-300-100-10 | 3.05% | 引入两层表征后错误率明显优于单层网络 |
| 双隐藏层 MLP | 28×28-1000-150-10(常规数据) | 2.95% | 参数量超过 93 万,提升幅度极其有限 |
| 支持向量机 | 4 次多项式核 SVM | 1.1% | 依赖高维支持向量,具有优秀的泛化界 |
| 支持向量机 | 虚拟支持向量机(V-SVM,9 次多项式) | 0.8% | 结合人工数据增强,但推理与存储开销极度高昂 |
| 卷积网络 | LeNet-1(16×16 输入) | 1.7% | 仅 2,600 个参数,计算量约 10 万次乘加 |
| 卷积网络 | LeNet-4 | 1.1% | 约 1.7 万个参数,26 万条连接 |
| 卷积网络 | LeNet-5(无畸变数据增强) | 0.95% | 约 6 万参数,34 万条连接,仅 82 个测试样本分类错误 |
| 卷积网络 | LeNet-5(仿射与弹性形变增强) | 0.8% | 数据增强有效模拟了真实手写笔画的多样性 |
| 集成学习 | Boosted LeNet-4 | 0.7% | 结合 Boosting 策略,为论文中达到的最高准确率 |
计算量与内存存储的现实权衡
论文在第三节特别强调:评估一个算法不能只看测试集错误率,必须结合前向推理的计算量(乘加操作次数)和参数存储占用综合判断。2
- K-NN 分类器:虽然取得了 5.0% 的错误率,但它需要在内存中常驻全部 60,000 张 20×20 像素的图像(约 24MB),每识别一个新字符都要对这 6 万个高维向量计算一次欧氏距离,计算耗时和内存消耗随样本量线性增长,完全无法用于实时系统。
- 支持向量机(SVM):4 次多项式 SVM 达到了 1.1% 的优异错误率,V-SVM 甚至达到了 0.8%。但 SVM 需要保存海量的支持向量,单次推理需要与大量支持向量计算核函数,计算延迟远高于神经网络。
- LeNet-5:整个模型只有约 6 万个参数,只需要几十 KB 的内存存储权重;单张图像前向推理仅需约 34 万次乘加运算。这种极其轻量且恒定的推理开销,使得 LeNet-5 能够直接集成进当时的商用支票读取系统,实现每天实时处理数百万张银行支票。2
现代深度学习改掉了什么,留下了什么
回看 1998 年的这篇奠基之作,现代深度学习在工程实现上已经对 LeNet-5 的许多局部设计做出了演进与替换:
- 子采样层演进:LeNet-5 在 S2 和 S4 中使用带有可训练标量乘子与偏置的平均池化,配合双曲正切函数;现代网络普遍改用不带参数的最大池化(Max Pooling),或者直接使用带步长的卷积(Strided Convolution)完成降采样。
- 输出层与损失函数演进:LeNet-5 采用 84 维的固定字符点阵与欧氏 RBF 单元;现代分类网络几乎全部采用Softmax 分类头配合交叉熵损失函数(Cross-Entropy Loss)。Softmax 输出严格对应类别后验概率分布,计算简单且便于向成千上万个类别扩展。
- 通道连接方式演进:LeNet-5 在 S2 到 C3 之间精心设计了稀疏非完全连接表来打破对称性并节省算力;在拥有大规模 GPU 并行算力的今天,现代卷积网络普遍采用完全密集的全通道三维卷积(Dense Channel Convolutions),因为规整的矩阵乘法在硬件张量核心上的执行吞吐量远高于零散的稀疏索引。
- 激活函数演进:LeNet-5 全网采用双曲正切激活函数;在深层网络中,tanh 的饱和区极易引发梯度消失。2012 年以后的 AlexNet、VGG 和 ResNet 全面转向了ReLU 及其变体(Leaky ReLU、GeLU),在正半区保持恒定的导数,支持数百层的深层网络稳定训练。4
尽管具体模块被替换,但论文确立的核心思想不仅没有过时,反而构成了现代计算机视觉的基石:
- 局部感受野与空间参数共享:无论是 2012 年掀起深度学习浪潮的 AlexNet,还是 2015 年突破百层深度的 ResNet,抑或是近年的 ConvNeXt,其本质依然是利用滑动卷积核提取局部多尺度模式的先验。
- 多尺度金字塔与端到端全局训练:从像素到最终标签的端到端梯度优化,彻底结束了计算机视觉对手工设计特征(如 SIFT、HOG)的绝对依赖;论文后半部分提出的图变换网络(GTN)关于免切分连续文档识别的讨论,更是现代序列识别、CTC 损失与端到端大模型统一建模的先行探索。
读完论文留下四个思考维度
- 先验结构如何进入网络? 全连接网络没有做任何结构假设,代价是巨大的参数量和对图像平移的迟钝;卷积网络通过局部连接与权重共享,把“物理世界的局部相关性与平移不变性”硬编码进了网络计算图中。
- 参数共享对梯度的本质影响是什么? 空间中每个位置计算出的局部导数在反向传播时直接累加,使得共享参数接收到的梯度相当于多个空间样本的集体投票。
- 实验表格是否考虑了工程部署成本? 在阅读经典论文时,不能只看测试集错误率的一维指标,必须像 LeCun 在文中一样,把计算量、内存占用与推理延迟放在同一个表格里对比。
- 手工稀疏连接与硬件算力的辩证关系。 1998 年稀疏连接是为了在低算力硬件下运行而做出的精巧取舍;当现代 GPU 的密集矩阵乘法算力爆发后,看似冗余的密集全连接反而在执行效率上胜出。理解这一转变,有助于读者看清算法设计与底层硬件支持之间的长期互动关系。
References
- 1原论文 IEEE Xplore 出版页面
doi.org
- 2作者托管原论文全文 PDF
vision.stanford.edu
- 3Fukushima 1980 原论文
doi.org
- 4AlexNet 论文对 ReLU 与现代 CNN 的继承
papers.nips.cc
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.