《U-Net》:编码器—解码器如何同时保留上下文与像素定位
从滑动窗口的速度与上下文矛盾出发,拆解 U-Net 的跳跃连接、加权损失、重叠分块与数据增强,并用原论文实验和 3D U-Net、nnU-Net 读懂它的边界。
2015 年,Olaf Ronneberger、Philipp Fischer 与 Thomas Brox 面对一个很具体的医学图像问题:模型要给每个像素分配类别,但训练图像往往只有几十张。分类网络输出一个标签还不够,滑动窗口网络虽然能逐像素预测,却要为重叠 patch 重复运行,速度和上下文范围也互相牵制。1
U-Net 的关键交换发生在数据流里:网络先逐层缩小特征图,换取更大的上下文;随后逐层放大特征图,并把收缩阶段的高分辨率特征接回来。这样,扩张路径得到的每个像素既带着“这是什么”的语义,也保留了“边界在哪里”的位置线索。原论文的实验证明,这个结构配合无填充卷积、重叠分块、边界加权损失和强数据增强,可以在少量标注下完成快速分割。1
像素级分割的两个约束
滑动窗口方法把一个像素周围的局部 patch 交给网络,再让网络预测中心像素的类别。这个办法把一张图变成许多训练样本,也保留了像素位置。代价是相邻 patch 共享大量像素,推理时会反复计算同一片区域。2
更大的 patch 能让模型看到更广的上下文,却需要更多次池化。池化降低空间分辨率,模型对细边界的定位就会变粗;较小的 patch 保留定位,却只提供局部线索。U-Net 要解决的工程问题因此可以写成一句话:让一次整图计算同时承担上下文理解和像素定位。2
U 形网络怎样接回定位信息
U-Net 的左侧是收缩路径(contracting path)。每一级重复两次
3×3 无填充卷积,每次卷积后接 ReLU;随后用步长为 2 的 2×2 最大池化降低分辨率。每次下采样,特征通道数加倍。分辨率下降后,一个特征位置对应原图更大的区域,网络可以用更少的位置承载更宽的上下文。3右侧是扩张路径(expansive path)。每一级先上采样,再用
2×2 上卷积把通道数减半,然后把左侧同一分辨率的特征图裁切后拼接进来,最后再做两次 3×3 卷积和 ReLU。拼接承担了一个明确的分工:深层特征告诉网络当前位置属于哪种结构,浅层特征把细胞边缘、膜和局部纹理送回高分辨率输出。3最后一层是
1×1 卷积。它把每个像素位置的 64 维特征向量映射到目标类别数。换句话说,网络先为每个位置准备一组融合了上下文和细节的特征,再在同一个位置上完成分类。原始 U-Net 总共有 23 个卷积层,而且整条路径没有全连接层。3这个结构与滑动窗口的差别,主要在计算组织方式。滑动窗口把每个 patch 当成一次独立输入;U-Net 让整张 tile 共享一次前向计算,再为一片输出区域同时给出像素预测。跳跃连接补回下采样阶段损失的空间细节,整图计算则减少了重叠 patch 的重复工作。
训练目标如何处理边界与小样本
结构解决了信息流,训练目标还要处理两个数据问题:接触的细胞需要分开,标注图像又很少。U-Net 用像素级 softmax 先把每个位置的类别分数变成概率:
这里的
a_k(\mathbf{x}) 是位置 \mathbf{x} 对类别 k 的输出分数,K 是类别总数,p_k(\mathbf{x}) 是该位置属于类别 k 的概率。真实标签记为 \ell(\mathbf{x}) 后,论文用权重图 w(\mathbf{x}) 累加交叉熵:实际优化时通常最小化它的相反数。读这个式子时,顺序是:网络先为每个像素给出类别分布,再取真实类别的概率,最后让权重图决定哪些像素对更新贡献更大。4
细胞互相接触时,两个细胞之间的分隔线很窄,普通像素计数会让大面积细胞内部淹没这条边界。论文用形态学操作得到最近两个细胞边界的距离
d_1(\mathbf{x}) 和 d_2(\mathbf{x}),再把边界权重写成: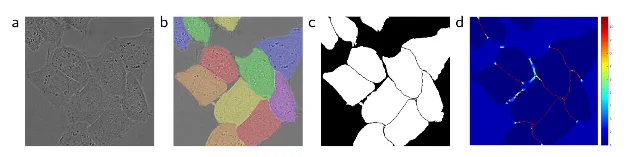
少量标注依靠数据增强扩展变化范围。论文把随机位移放在粗糙的
3×3 网格上,从高斯分布采样位移,再用双三次插值得到每个像素的平滑弹性形变;训练还加入平移、旋转和灰度变化。对显微图像来说,这些变换分别帮助模型适应位置、方向、组织形变和亮度变化。6论文的训练设置也说明了显存如何影响算法:作者偏好大输入 tile,把 batch size 设为 1,再用 0.99 的高 momentum 让过去看到的样本持续影响当前更新。原论文报告,训练约需 10 小时,硬件是 6 GB 显存的 NVIDIA Titan GPU。训练数据包括 30 张带完整标注的 EM 图像、35 张部分标注的 PhC-U373 相差显微镜图像,以及 20 张部分标注的 DIC-HeLa 图像。4
为什么输出图比输入图小
无填充卷积会消耗特征图边缘的像素,因此每次卷积后,输出尺寸都会缩小。扩张路径与收缩路径拼接时,左侧特征图需要先裁切到相同尺寸;最终输出只覆盖输入中拥有完整上下文的区域。这个尺寸损失换来了边界处更一致的上下文条件。2
大图通过 overlap-tile 策略处理。模型把大图切成相互重叠的输入 tile,每个 tile 只保留中间那片预测区域;边缘缺少的上下文用输入图像的镜像外推补齐。这样,GPU 只需要处理有限大小的 tile,多个 tile 的中心区域再拼成整张分割图。这个步骤是 U-Net 从网络结构走向可运行系统的关键。7
实验数字应该怎样读
第一组实验是 ISBI EM segmentation challenge 的神经结构分割。训练集包含果蝇一龄幼虫腹神经索连续切片的 30 张
512×512 透射电镜图像;评价使用 warping error、Rand error 和 pixel error 三个指标。U-Net 对输入图像的 7 个旋转版本分别预测后取平均,表中记录的 warping error 为 0.000353,Rand error 为 0.0382,pixel error 为 0.0611。论文表格把它列为 2015 年 3 月 6 日的第一名。8与滑动窗口网络的比较要保留指标口径:Ciresan 等人的结果是 warping error
0.000420、Rand error 0.0504、pixel error 0.0613。这些数字支持 U-Net 在该挑战和该评价设置下取得更好的综合结果;它们表达的是三个误差指标的比较,不应改写成一个笼统的“准确率提升”。8第二组实验来自 ISBI cell tracking challenge 2015 的两类透射光显微镜数据。PhC-U373 有 35 张部分标注训练图像,U-Net 的平均 IOU 为
0.9203,表中第二名为 0.83;DIC-HeLa 有 20 张部分标注训练图像,U-Net 的平均 IOU 为 0.7756,表中第二名为 0.46。两个结果共同支持边界定位和少样本训练策略的作用,但它们仍然属于两个具体数据集。9速度数字也要单独读取。论文报告,
512×512 图像在较新的 GPU 上完成分割所需时间少于 1 秒;这个数字描述推理速度,不能和约 10 小时的训练成本混成同一个“速度”结论。1后续工作把 U-Net 推到哪里
3D U-Net 直接沿着体数据方向扩展这条主线。Çiçek、Abdulkadir、Lienkamp、Brox 与 Ronneberger 将 2D 卷积、池化和上卷积替换为 3D 操作,用稀疏的正交切片标注学习稠密体积分割。论文中的网络使用四个分辨率层级,输入块为
132×132×116 体素,输出为 44×44×28 体素,总参数约 19,069,955。103D U-Net 在 Xenopus 肾脏共聚焦体数据上做了两种设置。半自动设置的三折交叉验证平均 IOU 为
0.863,纯 2D 基线为 0.796;全自动设置中,用两个体积训练、第三个体积测试,带 BN 的 3D U-Net 平均 IOU 为 0.704,不带 BN 为 0.723,2D 基线为 0.547。这些结果说明 3D 操作能利用体积上下文,也说明归一化与数据划分会改变结果。10nnU-Net 推进的是另一条线:它保留简单的 2D/3D U-Net 变体,把大量设计工作放到预处理、patch 大小、批大小、训练、重叠推理、测试时增强和后处理。Isensee 等人在 Medical Segmentation Decathlon 的 7 个数据集上评估这套自配置框架,并报告在线排行榜中除 BrainTumour 的一个类别外,所有任务所有类别取得最高平均 Dice。11
这两个后续工作的共同点很具体:U-Net 的 U 形数据流提供了可复用骨架,但最终效果还取决于输入维度、标注方式、预处理、训练和推理配置。原论文的 2D 小样本结果建立了这条主线;后续工作把它扩展到体数据,并把“网络之外的系统设置”推到实验中心。
读 U-Net 时应留下的判断
U-Net 的贡献可以沿一条计算链复述:
- 滑动窗口逐 patch 预测像素,带来重复计算以及上下文—定位的取舍。
- 收缩路径用池化扩大上下文,扩张路径逐层恢复分辨率。
- 跳跃连接把高分辨率特征送回对应层级,帮助输出重新定位细胞、膜和边界。
- 无填充卷积与 overlap-tile 把完整上下文、有限显存和大图分割接到同一个推理流程里。
- 加权损失把接触细胞之间的窄边界变成更强的监督信号,弹性形变则扩大少量标注的有效变化范围。
- 实验结果需要按任务、指标、对照、旋转平均和训练/推理成本分别读取。
以后读一篇像素级预测论文,可以先问四个问题:模型在哪里保存了高分辨率定位信息?一次前向计算覆盖了多少输出像素?损失函数是否给真正困难的边界或小类别足够权重?实验数字属于单模型、旋转平均、集成,还是某个特定数据划分?这四个问题能把“网络图看起来很漂亮”推进到对计算过程和证据口径的判断。
References
- 1U-Net 原论文
ar5iv.labs.arxiv.org
- 2U-Net 原论文第 1 节
ar5iv.labs.arxiv.org
- 3U-Net 原论文第 2 节
ar5iv.labs.arxiv.org
- 4U-Net 原论文第 3 节公式 1
ar5iv.labs.arxiv.org
- 5U-Net 原论文 Figure 3
ar5iv.labs.arxiv.org
- 6U-Net 原论文第 3.1 节
ar5iv.labs.arxiv.org
- 7U-Net 原论文 Figure 2 与第 1 节
ar5iv.labs.arxiv.org
- 8U-Net 原论文第 4 节 Table 1
ar5iv.labs.arxiv.org
- 9U-Net 原论文第 4 节 Table 2
ar5iv.labs.arxiv.org
- 103D U-Net 原论文
ar5iv.labs.arxiv.org
- 11nnU-Net 原论文
ar5iv.labs.arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.