《Batch Normalization》:一个 mini-batch 如何改变深度网络的训练
从 mini-batch 统计量、反向传播与训练/推理切换出发,读懂 Batch Normalization 如何加速训练,并准确拆开原论文的 14 倍步数与 ImageNet 4.9% 结果。

2015 年,深度网络已经能把模型做得很深,训练却仍然被一个反复出现的问题牵制:前面的参数一更新,后面的层看到的输入分布就跟着变。后面的层一边学习自己的任务,一边还要持续适应新的输入尺度。Ioffe 和 Szegedy 的《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》把归一化放进网络内部,并让梯度穿过归一化所用的统计量。1
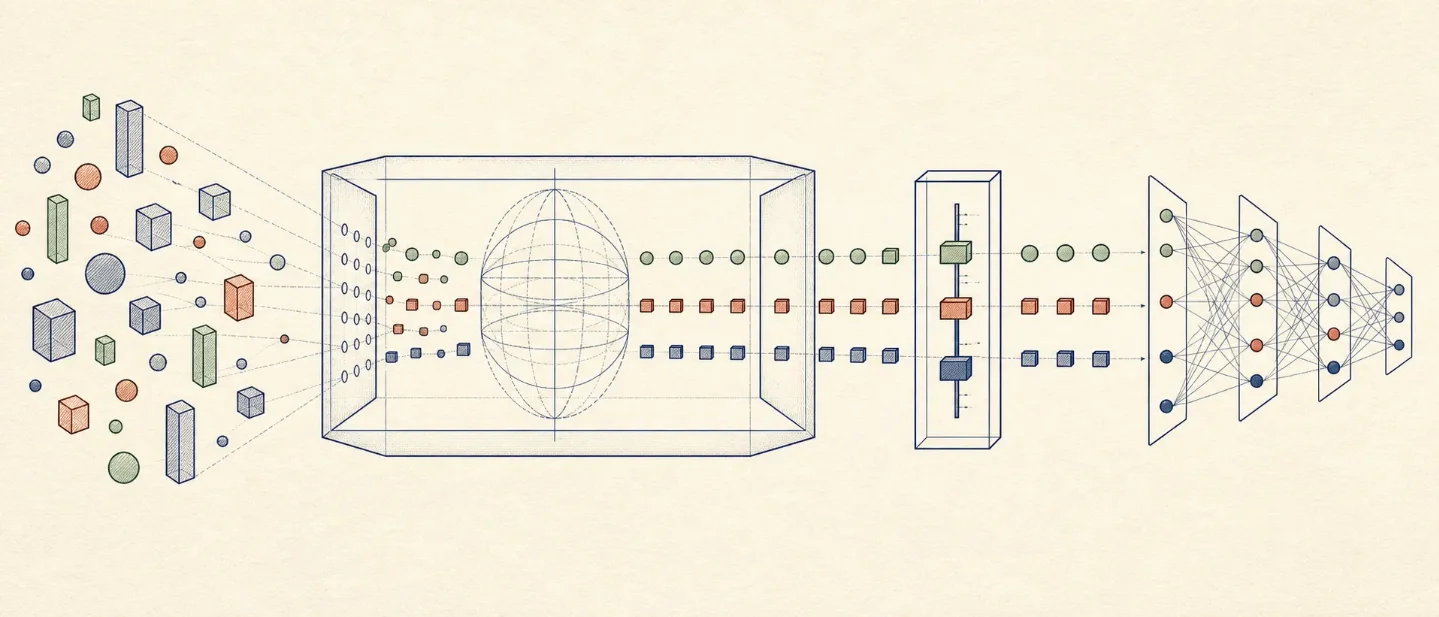
这项方法后来简称 Batch Normalization,也常写作 BatchNorm 或 BN。它做的关键交换是:训练时让一个样本和同一 mini-batch 里的其他样本共同决定中间激活的中心与尺度,换来更稳定的数值范围、更大的可用学习率和额外的随机正则化;推理时再把这些 batch 统计量换成固定的总体统计量,让同一个输入每次得到确定的输出。
读懂这篇论文,先抓住一个问题:BN 究竟改变了哪一段数据流? 公式、算法和实验都围绕这个问题展开。
后层为什么总在追赶前层
把一个深度网络拆成两段,可以写成:
其中, 产生中间表示, 接收这个表示并继续计算。训练 时, 好像在处理输入 。只要前一段的参数 更新, 的均值、方差和整体形状就可能变化,后一段便需要重新适应。原论文把训练期间内部节点激活分布随参数变化而改变的现象称为 internal covariate shift,即内部协变量偏移。2
这个问题在 sigmoid 这类饱和非线性上尤其直观。sigmoid 的导数在输入绝对值很大时趋近于 0。若某层的输入逐渐被推到很大的正值或负值,梯度就会变小,后面的参数更新也会变慢。网络越深,前面参数对后面激活的影响链越长,学习率、初始化和激活函数之间的牵制越明显。2
理想的全白化可以同时把每个特征变成零均值、单位方差,并消除特征之间的相关性。这样的处理需要计算协方差矩阵、逆平方根及其梯度;在每次参数更新后对完整训练集重新分析,代价很高。BatchNorm 做了两步简化:每个标量特征独立归一化,只计算均值和方差;统计量由当前 mini-batch 估计,而不是每一步遍历整个训练集。2
一个 BN 变换逐步算什么
设某个特征在一个 mini-batch 中有 个值:
BN 对这 个值做四步计算。
第一步:算当前 batch 的均值
这一步得到当前 mini-batch 的中心。每个样本的后续结果都会用到同一个 。
第二步:算当前 batch 的方差
方差描述这一批值围绕均值分散得有多开。 是为数值稳定性加入的常数。
第三步:标准化
减去均值把中心移到 0,除以标准差把尺度调整到相近范围。忽略 时,这一批标准化后的值均值为 0,方差为 1。
第四步:学习缩放和平移
可以用一组小数值把这个过程读一遍。若一个 batch 的激活是 ,均值是 ,方差是 。标准化后,三个值以 0 为中心,间距由方差决定;随后 决定新的尺度, 决定新的中心。重要的地方在于,模型处理第一个样本时,同时使用了另外两个样本的信息。BN 作用在一组样本上,而不是把每个样本完全独立地处理。
归一化发生在计算图内部,所以均值和方差的计算也在反向传播路径上。若把归一化当成图外的预处理,参数改变后重新计算统计量可能抵消原本的更新。原论文给出一个例子:如果更新偏置时忽略均值对偏置的依赖,偏置可以不断变大,归一化后的输出却保持不变。让梯度穿过均值和方差,优化器才能看到完整的依赖关系。4
BN 放进卷积网络后,统计量从哪里取
对全连接层,某个特征可以直接在 batch 维度上统计。卷积层还多了空间位置。一个 feature map 的大小若为 ,mini-batch 大小为 ,论文把同一个 feature map 在所有样本和所有空间位置上的激活放到一起,等效统计样本数为:
在常见的层结构中,论文把 BN 放在仿射变换与非线性之间。原来的一段计算可以写成:
加入 BN 后,写成:
训练和推理是两套计算
BN 最容易被漏读的一步,是训练阶段和推理阶段使用不同的统计量。
训练时,当前 mini-batch 提供 和 。这些统计量参与 forward,也参与 backward。不同 batch 的组成会给同一个样本带来略有不同的中间值,这种随机性可以帮助泛化。
推理时,模型希望同一个输入每次都得到同一个输出。此时不能继续让输出依赖于推理时碰巧放在旁边的样本,所以要用训练期间多个 mini-batch 的均值和方差估计总体统计量:
原论文给出无偏方差估计:
固定总体统计量后,BN 与缩放平移可以合并成一次线性变换:
这意味着训练时的 BN 是一个依赖 batch 的可微变换,部署时则可以折叠成固定的仿射层。实现中常见的 running mean 和 running variance,就是为了保存这组推理统计量。6
为什么 BN 让更大学习率变得可用
原论文给出的解释有三条。把它们拆开后,读者可以区分作者的实验支持、数学性质和仍然带有推测性质的部分。
参数尺度改变后,归一化结果仍较稳定
对一个标量 ,BN 具有下面的尺度不变性:
把权重整体放大, 的均值和标准差也会按相应尺度变化,标准化后得到的结果保持相同。原论文进一步指出,关于输入 的层 Jacobian 不随这个整体尺度改变,而关于权重的梯度会按 缩放。权重变大时,梯度反而变小,这为参数增长提供了一定的自稳定性。7
这条性质解释了 BN 为什么能承受更大的学习率:参数尺度变化对后续激活的放大作用被归一化削弱了。它描述的是一个有条件的计算性质,实际训练速度仍然取决于网络、数据和其余优化设置。
饱和区更难长期困住网络
sigmoid 的输入若长期处于很大的正值或负值,导数会变小。BN 把进入非线性的激活拉回较稳定的中心和尺度,再由 与 学习适合当前任务的变换。这样,训练过程更容易在有梯度的区域继续调整。
mini-batch 随机性带来正则化
同一个样本和不同样本一起组成 batch 时,均值与方差会略有变化。模型因此看到的中间激活带有额外扰动。原论文在实验中观察到,BN 网络可以减少或去掉一部分 Dropout,同时保持泛化效果。这个结果说明 batch 统计量提供了正则化作用,但它也让训练结果与 batch 的构成有关。8
原论文还提出一个更强的推测:在理想化的高斯、独立和局部线性假设下,BN 可能让层 Jacobian 的奇异值接近 1,从而让梯度幅度更容易保持。论文同时明确指出,真实网络并不完全满足这些假设,BN 对梯度传播的精确影响仍需进一步研究。7
Figure 1:分布稳定与训练速度同时出现
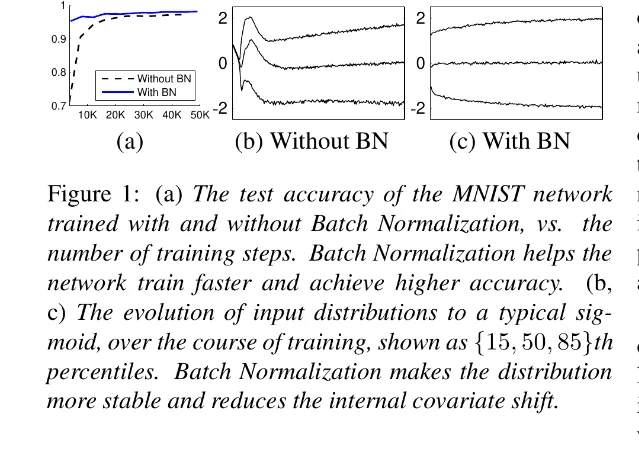
左图显示,带 BN 的网络在这组 MNIST 设置下更快达到较高测试准确率。中图的三条曲线随训练明显移动,均值和尺度都在变化;右图的三条曲线保持得更稳定。9
实验使用 28×28 二值图像、三个各含 100 个激活的全连接隐藏层、sigmoid 非线性和 60 个样本的 mini-batch,训练 50,000 步。这个实验的任务是比较训练行为,模型本身并非为追求 MNIST 当时的最高准确率而设计。10
Figure 1 支持的判断很具体:在这个网络和训练设置下,BN 同时带来了更快的训练、更高的测试准确率和更稳定的典型 sigmoid 输入分布。图像本身无法单独证明稳定分布就是全部因果机制;这需要结合后续对优化过程的研究。
ImageNet 实验:14 倍到底来自什么
论文把 BN 应用到 Inception 的一个变体上。该模型有 13.6 百万个参数,除最后的 softmax 层外没有全连接层,训练使用 32 的 mini-batch 和带 momentum 的 SGD。验证时使用单 crop,并报告 1000 类分类准确率。11
论文比较了几种条件。表中的「达到 72.2% 所需步数」给出了共同目标,便于比较训练速度;「最高准确率」则告诉我们模型最终还能走到哪里。
| 模型 | 达到 72.2% 的步数 | 最高准确率 | 读法 |
|---|---|---|---|
| Inception | 31.0M | 72.2% | 原始基线,在这组设置下作为速度和准确率参照。12 |
| BN-Baseline | 13.3M | 72.7% | 只在原模型各非线性之前加入 BN,训练步数已少于基线的一半。12 |
| BN-x5 | 2.1M | 73.0% | 在 BN 基础上把初始学习率提高 5 倍,并采用论文列出的训练配方调整。13 |
| BN-x30 | 2.7M | 74.8% | 在 BN-x5 条件上把初始学习率提高到原始 Inception 的 30 倍,最终准确率更高。13 |
| BN-x5-Sigmoid | — | 69.8% | 在 BN-x5 条件下把 ReLU 换成 sigmoid,用来观察饱和非线性的可训练性。13 |
「14 倍更少训练步数」来自 Inception 与 BN-x5 的比较:31.0M 步对 2.1M 步。BN-x5 同时使用了 BN、5 倍初始学习率、移除 Dropout、降低 L2 正则强度、加快学习率衰减、更充分地打乱训练样本和减少光度失真等改动。13
因此,实验支持两层结论。第一,只加入 BN 的 BN-Baseline 已经从 31.0M 步降到 13.3M 步,说明 BN 本身带来明显的训练加速。第二,14 倍这个醒目的数字属于「BN 加整套训练配方」的结果,不能全部归给单独插入的 BN 层。
sigmoid 对照也值得单独读。BN-x5-Sigmoid 达到 69.8% 的验证准确率;原始 Inception 换成 sigmoid 后,准确率停留在约 1/1000 的随机水平。这个对照说明,在论文的 ImageNet 模型与训练条件下,BN 让饱和非线性重新进入可训练范围。13
4.9% 的 ImageNet 结果要连同成本一起读
论文还报告了 BN-Inception 的集成结果:6 个网络、144 个 crop,并对各模型的类别概率取算术平均。在 50,000 张验证图上,top-5 error 为 4.9%;测试服务器对 100,000 张测试图报告的 top-5 error 为 4.82%。单网络单 crop 的 top-5 error 是 7.82%,单网络多 crop 是 5.82%。14
这组数字要分成三种收益来读:网络结构与训练配方带来模型能力,144 个 crop 带来测试时的多次视角平均,6 个网络的集成进一步降低预测波动。4.9% 是论文完整竞赛系统的结果,单次前向传播的 BN-Inception 能力由 7.82% 这个单 crop 数字更直接地表示。
原论文的解释后来怎样被修正
2018 年,Santurkar、Tsipras、Ilyas 和 Madry 的《How Does Batch Normalization Help Optimization?》重新研究了 BN 的作用。他们在摘要中提出,层输入分布的稳定性与 BN 的成功关系较小;更基本的影响是 BN 让优化景观更平滑,使梯度更可预测、更稳定,从而加快训练。15
这项后续工作改变的是机制解释的重心。原论文观察到加入 BN 后 sigmoid 输入分布更稳定,并据此把减少内部协变量偏移作为主要工作假设;后续研究把「优化景观平滑、梯度稳定」放到更靠近机制答案的位置。两者可以同时帮助读者理解一件事:BN 确实改变了中间激活的统计行为,但训练收益的充分解释还要看梯度和损失面的几何性质。
BN 的边界:统计范围必须匹配任务
BatchNorm 的统计量依赖 mini-batch,这个设计带来训练收益,也带来应用边界。
Layer Normalization 的作者指出,BN 的效果依赖 mini-batch 大小,而且直接用于循环神经网络并不自然。LayerNorm 把统计范围换成单个样本在某一层的所有神经元,并在每个时间步分别计算统计量;训练和测试使用同一种计算,因此更适合循环网络。16
Group Normalization 则针对小 batch 的视觉训练。它把通道分成若干组,在组内计算均值和方差,统计量与 batch size 脱钩。原论文报告,在 ImageNet 的 ResNet-50、batch size 为 2 时,GroupNorm 比对应 BatchNorm 的错误率低 10.6%;在常见 batch size 下,两者效果相近。这个结果说明显存限制会改变归一化方法的合适统计范围。17
LayerNorm 和 GroupNorm 的出现,延伸了 BN 的核心问题:归一化应该沿哪些样本、哪些位置、哪些通道计算? BatchNorm 的答案适合许多大 batch 的卷积网络;序列模型和小 batch 视觉任务需要重新选择统计轴。
读完这篇论文,留下四个检查问题
- 它插入了哪一步? BN 处理的是进入非线性之前的激活,读论文时要先在数据流中标出 、归一化和 的相对位置。
- 统计量由谁共同决定? 全连接层主要跨 batch 统计;卷积层还要跨空间位置统计。统计范围决定了样本之间如何相互影响。
- 训练和推理是否同一套计算? BN 训练时用 mini-batch 统计量,推理时用总体统计量;漏掉这一步,就会把论文算法读成一个错误的部署流程。
- 实验把哪些改动放在了一起? 31.0M 对 13.3M 说明只加 BN 已有加速;31.0M 对 2.1M 还包含学习率、Dropout、L2、衰减和数据处理的共同变化。读任何优化技巧论文,都要先把这些条件拆开。
BatchNorm 的核心贡献可以压缩成一条可复查的计算链:训练时,mini-batch 统计量把每层激活的中心和尺度纳入计算图; 与 保留表示能力;梯度穿过均值和方差回到前面的参数;batch 统计带来的随机性提供额外正则化;推理时,总体统计量把这套随机的训练变换折叠成固定线性层。
这条链解释了 BN 为什么成为深度学习训练中的经典组件,也提醒我们把「方法有效」和「方法为什么有效」分开读。原论文的实验证明了一套具体网络与训练配方的速度和准确率收益;后续研究继续追问优化几何,LayerNorm 与 GroupNorm 则把统计范围带到序列和小 batch 场景。读下一篇论文时,先找它的统计量、计算图和实验条件,往往比先背住方法名称更有用。
References
- 1Batch Normalization 原论文摘要页
arxiv.org
- 2原论文第 1—2 节:内部激活分布的变化
ar5iv.labs.arxiv.org
- 3原论文第 3 节与 Algorithm 1:Batch Normalizing Transform
ar5iv.labs.arxiv.org
- 4原论文第 2 节:归一化必须参与反向传播
ar5iv.labs.arxiv.org
- 5原论文第 3.2 节:卷积网络中的 BatchNorm
ar5iv.labs.arxiv.org
- 6原论文第 3.1 节与 Algorithm 2:训练/推理切换
ar5iv.labs.arxiv.org
- 7原论文第 3.3 节:参数尺度与梯度传播
ar5iv.labs.arxiv.org
- 8原论文第 3.4 节:BatchNorm 的正则化作用
ar5iv.labs.arxiv.org
- 9原论文第 4.1 节与 Figure 1:MNIST 分布演化
ar5iv.labs.arxiv.org
- 10原论文第 4.1 节:MNIST 实验设置
ar5iv.labs.arxiv.org
- 11原论文第 4.2 节:ImageNet 模型与评测设置
ar5iv.labs.arxiv.org
- 12原论文 Figure 2—3
ar5iv.labs.arxiv.org
- 13原论文第 4.2.1—4.2.2 节
ar5iv.labs.arxiv.org
- 14原论文 Figure 4:BN-Inception 的单模型、多 crop 与集成结果
ar5iv.labs.arxiv.org
- 15
- 16Layer Normalization
arxiv.org
- 17Group Normalization
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.