「Long Short-Term Memory」:LSTM 如何把长期依赖变成可训练的记忆单元
从 CEC、输入门与输出门出发,读懂 LSTM 如何保住长期梯度,再用 1000 步人工任务、forget gate 与 seq2seq 结果判断它解决了什么、付出了什么代价。
如果一个序列在第 1 步出现关键信息,直到第 1000 步才需要用它,普通循环神经网络(Recurrent Neural Network,RNN)需要把误差信号穿过近千次递归计算。每一步都乘上一点小于 1 的因子,信号就会越来越弱;每一步都乘上一点大于 1 的因子,训练又可能发散。
Hochreiter 与 Schmidhuber 在 1997 年的《Long Short-Term Memory》没有把问题改写成「让网络记更多东西」,而是设计了一条更容易训练的内部通路:用一个近似线性的记忆状态保存信息,用输入门控制写入,用输出门控制读出。这样,长期信息的存储、访问和梯度传递不再挤在同一条普通递归边上。原论文书目与摘要 原论文 PDF
这篇论文最值得精读的地方,不是今天常见的 LSTM 代码长什么样,而是它把「长期依赖为什么难」拆成了一个可以逐步检查的机制问题:梯度走哪条路?什么时候写入?什么时候暴露?实验又是否真的测到了这些能力?
先把困难钉在梯度上
普通 RNN 可以抽象成:
其中 是当前隐藏状态, 是输入, 是输出。为了让第 步的误差影响更早的状态,反向传播要反复经过递归项。简化地看,跨越 个时间步的梯度包含类似这样的乘积:
这不是说每个 RNN 都必然失败,而是说明了困难的来源:当乘积的典型大小小于 1,梯度随 指数衰减;大于 1,则可能爆炸。长时间间隔越长,网络越难同时做到两件事:记住早期信号,并在中间的干扰之后仍把它用于当前预测。
论文把这类问题称为 long time lag,也就是「长时间延迟」。它回顾了 Hochreiter 1991 年关于误差信号衰减的分析,并把解决目标说得很具体:让误差能沿着一条不会衰减的路径流过记忆单元。原论文,第 2—3 节
一条近似恒定的误差通路
CEC 在算什么
先暂时不考虑门。设一个记忆单元的内部状态为 ,让它通过权重为 1 的自循环连接更新:
状态本身是线性累加的,因此沿这条自循环边的局部导数为 1。反向传播时,误差信号不会因为每一步都乘上一个小于 1 的激活函数导数而自动消失。论文把这个结构称为 constant error carousel,简称 CEC,即「恒定误差环」。
这个名称容易让人误解成「梯度永远不会变」。更准确的说法是:在记忆单元内部,论文刻意保留了一条局部、近似恒定的误差路径;当误差通过输入门、输出门或外部连接离开这条路径时,仍然会受到门控和非线性函数的影响。LSTM 不是取消了梯度学习,而是把最需要长期保真的那一段单独保护起来。
为什么还需要两个门
只有 CEC 还不够。一个永远累加的状态会遇到两个冲突:
- 写入冲突:新输入什么时候应该覆盖或增加旧信息?如果每个输入都直接写入,旧记忆会被污染;如果完全不写,又学不到新模式。
- 读出冲突:记忆什么时候应该影响输出?如果每一时刻都把状态暴露给网络,长期记忆可能干扰当前的短期判断。
原论文因此加入两个乘法门。输入门 控制当前候选信息写入多少;输出门 控制内部状态暴露多少。门通常由带参数的非线性单元产生,门值接近 0 时相当于关闭,接近 1 时相当于打开。
一步 LSTM 到底做什么
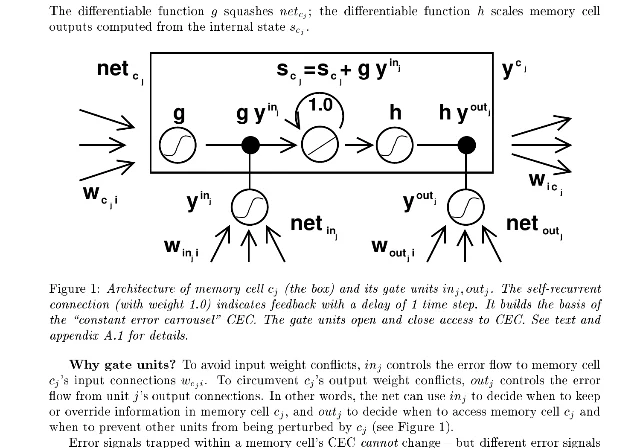
原论文的单个记忆单元可以用两条式子抓住主线。这里的 和 是可微的压缩函数, 是候选内容的加权输入:
把它读成算法,而不是把它当成需要背诵的符号:
- 计算候选内容。 当前输入和网络中其他单元先生成 ,再经 得到「这一步想写进记忆的内容」。
- 决定写入多少。 输入门输出 ,把候选内容缩放后加到旧状态上。门关着时,候选内容几乎写不进去;门开着时,状态才会改变。
- 保留旧状态。 如果输入门关闭, 近似等于 。这正是长期信息可以跨过干扰步骤的地方。
- 决定读出多少。 输出门输出 ,再把经过 的状态缩放成当前可见输出 。状态可以继续保存,但不必在每个时刻都影响外部网络。
- 沿内部状态回传误差。 论文的学习算法让误差在记忆单元内部继续回传,但在离开记忆单元、进入门和外部连接的地方进行截断。于是长期通路保持简单,门的参数仍能通过局部误差更新。
这里有一个重要的历史细节:1997 年原始 LSTM 没有今天常写的 forget gate。 它的状态更新主要是「旧状态加上门控的新内容」,不是「先用 forget gate 乘旧状态,再写入新内容」。因此,不能把现代四门公式倒灌回这篇论文。forget gate 是后来针对连续输入流提出的修补,后文会回到这个边界。
把论文算法读成一张数据流图
若把一个时间步压缩成数据流,原始 LSTM 的重点不是层数,而是访问顺序:
其中只有中间的 走固定权重的自循环。输入门和输出门不是「额外的注意力」,它们是写权限和读权限:一个决定状态何时被改写,一个决定状态何时对外可见。
这也解释了论文所说的效率。原论文报告,LSTM 每个时间步、每个权重的更新复杂度为 ,并且在空间和时间上是 local 的:不必像完整的 BPTT 那样为潜在的无限长序列保存所有中间激活。原论文,第 4 节
但这里的 不是「训练总成本恒定」,而是单步更新相对于权重数量的局部复杂度。门增加了单元和连接,模型本身比普通 RNN 更重;而且越难的长延迟任务,往往仍然需要更多训练序列。复杂度优势和样本效率不是同一个指标。
实验:它到底证明了什么
原论文没有用今天的大型真实数据集,而是构造了六组人工序列任务,覆盖局部与分布式表示、实值输入、噪声干扰和长时间延迟。比较对象包括 RTRL、BPTT、recurrent cascade correlation、Elman 网络和 neural sequence chunking。这个实验选择很有针对性:如果问题是长期依赖,就先把「有没有学会记住」从数据规模和工程技巧中剥离出来。
阅读这些实验时,至少要同时看三列:成功率或错误数、模型比较、训练成本。只看「LSTM 成功」会漏掉它为成功付出的时间。
1. 长延迟任务:先看成功率
在任务 2a 的设置中,关键输入和监督信号之间隔着 个时间步。论文报告的成功率是:
| 方法 | 成功率 | 该数字说明什么 |
|---|---|---|
| RTRL | 0% | 逐步递归学习仍未解决该长延迟设置 |
| BPTT | 0% | 直接把误差穿过长序列也没有奏效 |
| Neural sequence chunking | 33% | 有部分成功,但不稳定 |
| LSTM | 100% | 在该人工任务与配置下,门控记忆通路确实学到了长延迟关系 |
LSTM 平均约用 5,040 条训练序列达到成功条件;这不是「一次前向计算就记住」,而是训练出何时打开输入门、何时保持状态的参数。原论文,Table 2
这张表最值得注意的不是 LSTM 的 100%,而是比较对象共享了同一个问题设定。它把论文的机制主张变成了可检验的对照:如果只是把一个普通 RNN 训练得更久,BPTT 不应当在同一设置下仍为 0%。
2. 1000 步加法:再看错误数和训练量
任务 5a 要求网络在一段至少 1000 个离散时间步的序列中,把两个被噪声隔开的实值输入相加。LSTM 在 2,560 条测试序列上错 1 条,但达到停止条件平均需要约 853,000 条训练序列。原论文,Table 7
这是一组很适合课堂上「读两遍」的数字:第一遍说明它确实能保留跨越 1000 步的数值信息;第二遍提醒我们,能解决不等于训练便宜。这里的 1/2560 是测试错误,853,000 是训练过程中的序列数,两者回答的是不同问题,不能拼成一个「准确率很高所以代价很小」的结论。
3. 时间顺序:看任务是否真的改变
任务 6a 和 6b 不只是把延迟拉长,而是要求网络判断远距离输入的先后顺序。论文报告两项设置分别在 2,560 条测试序列中错 1 条和 2 条,但平均训练序列数约为 31,390 和 571,100。原论文,Table 9
这组结果说明,LSTM 学到的不是一个固定的「延迟 1000 步」按钮:它可以把信息存下来,再根据后来的输入判断顺序。不过,6b 的训练成本明显高于 6a,说明任务结构、噪声和需要保持的关系都会影响优化难度。
4. 消融与配置:门不是装饰
原论文还讨论了门的作用边界。对于局部输出编码的任务,输出门有时不是理论上必需的;但在分布式输出和长短期记忆同时存在时,输出门可以阻止长期记忆去扰动容易学习的短期表示。换句话说,门的价值不在于让每个任务都更复杂,而在于隔离不同时间尺度上的信息。
这不是现代论文里那种统一、系统的 ablation suite,不能把它解读成「每个门在所有数据上都不可删除」。更稳妥的读法是:作者通过不同任务和门配置展示了写入冲突、读出冲突分别会在哪里出现。原论文,第 3—5 节
原始方案的边界
它不是无限记忆
CEC 让误差在细胞内部更容易保持,但不等于网络可以无成本地记住所有历史。原论文自己指出,截断版本不容易解决强延迟 XOR:如果网络先保存某个输入,之后的步骤没有办法逐渐降低最终误差,学习信号仍然会受限。论文也讨论了精确区分 99 步与 100 步这类计数问题,它需要额外的计数或相似机制。原论文,第 5 节
状态会被滥用,也会累积
原始记忆单元可能被网络当作偏置单元或重复存储同一信息,导致释放记忆的学习变慢。更关键的是,它的状态更新没有一个单独的「主动清空」开关。对于预先切好边界的序列,这未必是致命问题;对于连续不断的输入流,旧状态可能一直积累。
2000 年的《Learning to Forget: Continual Prediction with LSTM》把这个边界说得很清楚:如果输入流没有显式的子序列结束标记,内部状态可能持续增长,最终让网络失效。作者加入了自适应 forget gate,让 LSTM 学会在合适的时刻重置自己、释放内部资源;在连续版本的基准问题上,带 forget gate 的 LSTM 能解决标准 LSTM 解决不了的任务。PubMed 结构化摘要 论文 DOI
因此,forget gate 不是 1997 年方案的「漏写公式」,而是对另一种输入条件的后续回应:当序列边界未知时,记忆不仅要会写、会读,还要会忘。
人工任务不能替代真实应用证据
原论文的实验优点是把长延迟机制单独拿出来测,缺点也同样明显:任务是人工构造的,网络规模、初始化和停止条件都与这些任务绑定。它证明的是「这套结构在这些精心设计的长延迟问题上可训练」,不是「在任何真实序列上都优于其他网络」。读论文时要把机制证据、任务证据和应用证据分开。
从记忆单元到序列到序列
LSTM 的影响最好用一条具体的后续路线来理解,而不是用「后来 NLP 都用了它」一句带过。
2014 年,Sutskever、Vinyals 与 Le 用一个 LSTM 读取输入序列,再用另一个深层 LSTM 生成目标序列,把这种记忆单元放进了 sequence-to-sequence 的机器翻译框架。它不要求输入和输出长度相同,因此把原论文中的「跨越长延迟保留信息」推进到了变长序列映射。论文在 WMT'14 英法翻译上报告:直接翻译模型 BLEU 为 34.8,短语机器翻译基线为 33.3;用 LSTM 对 1,000-best 候选重排时达到 36.5。论文摘要与正文 HTML 版本
这个例子并不说明「LSTM 解决了序列建模的一切问题」。它说明的是一个更具体的迁移:1997 年为人工长延迟任务设计的可控状态通路,后来成为编码变长输入、再生成变长输出的一种基础组件;而 forget gate 等后续改动,则不断修正状态管理的边界。
把这篇论文读懂后,留下三道检查题
- 梯度走哪条路? 不要只看网络图上有多少层;找出长期误差是否有一条不必反复穿过饱和非线性的路径。
- 状态何时写入、何时读出、何时清空? 三个问题分别对应输入控制、输出控制和后来的遗忘控制。只说「有记忆」还不够。
- 实验到底测到了什么? 把成功率、测试错误、训练序列数、任务类型和比较基线放在一起看;人工任务的强证据不能直接升级成真实应用的普遍结论。
回头看,LSTM 最持久的贡献不是「让 RNN 记住更长的上下文」这句口号,而是一次结构上的拆分:把长期信息的存储、可见性和梯度传递分开管理。CEC 解决了梯度通路的问题,输入门和输出门解决了读写冲突;forget gate 随后补上了连续流中的清空问题。沿着这条因果链读,公式、实验数字和后续影响才会落到同一个判断上:它究竟解决了什么,又把什么问题留给了下一篇论文。
延伸阅读
- Long Short-Term Memory(Hochreiter & Schmidhuber,1997):原始方案、CEC、输入/输出门和人工长延迟实验。
- Learning to Forget: Continual Prediction with LSTM(Gers、Schmidhuber & Cummins,2000):连续输入流、forget gate 与状态重置。
- Sequence to Sequence Learning with Neural Networks(Sutskever、Vinyals & Le,2014):LSTM 编码器—解码器如何处理变长序列映射。
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.