《Auto-Encoding Variational Bayes》:VAE 如何把不可解的后验变成可训练的随机梯度
从 ELBO、重参数化技巧与 AEVB 算法出发,读懂 VAE 如何把不可解的连续潜变量后验变成可用小批量随机梯度训练的问题,并用原论文实验与 IWAE、β-VAE 分清它的能力边界。
如果一张图片经过编码器后只留下一个确定的向量,模型很容易学会「怎么把像素抄回去」,却未必学会数据背后的变化规律。VAE 的编码器输出的是一个分布:同一张图可以对应一团可能的隐变量,解码器从这团分布里取样,再尝试把图像还原出来。1
这一步把自编码器改成了生成模型。给定一个潜变量 ,解码器定义 ;给定一张观测 ,编码器用 近似真正的后验 。难点在于,真正的后验通常需要对所有可能的 积分,神经网络一复杂,这个积分就算不动。Kingma 和 Welling 在 2013 年的论文中提出 AEVB(Auto-Encoding Variational Bayes):用一个可学习的近似后验、一个可计算的下界,再加上重参数化技巧,把这件事变成可以用小批量随机梯度训练的问题。论文还说明,当 recognition model 使用神经网络时,这个版本就是 variational auto-encoder。1
先看清这笔交换
传统的变分推断或 MCMC 要为每个数据点反复估计后验。数据量增大时,这个步骤会成为训练瓶颈。AEVB 把计算换成下面这条流水线:
x  ->  q_phi(z|x)  ->  z  ->  p_theta(x|z)  ->  x 的概率
       输出 mu,sigma     采样          解码
编码器输出均值 和标准差 ,它们定义一团高斯分布,而不是一个唯一编码。模型从这团分布中取一个 ,让解码器判断原数据在该潜变量下有多可能。训练过程同时调整两组参数: 让近似后验更有用, 让生成模型更能解释数据。
这笔交换的代价也很明确:模型用神经网络快速产生近似分布,换掉了逐个样本精确求后验的计算。公式和实验要检查的,正是这笔交换能否带来可扩展的训练。
ELBO:把算不动的边际似然拆开
对一条观测 ,生成模型真正想最大化的是边际似然:
积分里的 是没有观察到的变量。我们引入近似后验 ,可以得到论文的分解:
KL 散度衡量两个分布有多不一样,而且一定非负。因此:
这个 就是 ELBO(evidence lower bound,证据下界)。它把一个难以直接计算的目标,换成了一个可以估计和优化的下界。2
把 ELBO 再改写一步,训练目标就更直观:
右边第一项是重构项。它要求从 出发的解码器给原数据 较高概率;二值图像使用 Bernoulli likelihood,连续数据使用 Gaussian likelihood。第二项是 KL 正则项,它把编码器输出的分布拉向先验 。原论文选用标准高斯先验 。2
读这条式子时,可以把它当成两个要求的拉扯: 必须保留足够信息来还原 ,同时又不能变成每张图各自占据一块、彼此没有规律的编码空间。KL 项把潜空间的形状约束到一个统一的先验附近;重构项则防止模型把所有输入都压成没有信息的噪声。
真正的难点:如何对随机样本反向传播
ELBO 里有一个期望:模型需要从 采样,再计算解码概率。对 求梯度比较直接;对 求梯度却麻烦,因为 同时决定了采样分布本身。
一种朴素做法叫 score-function estimator:把函数值乘上 。论文指出,这种估计器的方差很高,在这里不实用。2
重参数化技巧把「随机性来自哪里」换了一种写法。模型先从一个与 无关的标准噪声分布采样:
再用编码器输出的均值和标准差构造隐变量:
一个一维例子足够说明它的含义。若 ,就写成:
训练时,噪声样本可以换,梯度路径却始终经过明确的加法和乘法。模型保留了概率采样,也获得了普通神经网络一样的反向传播路径。重参数化不是把随机变量变成一个固定点,而是把随机变量拆成「固定分布噪声 + 可学习变换」。
一次小批量更新到底算什么
对于一批 个样本,AEVB 的计算可以按五步读:
- 编码。 对每个 ,编码器输出 和 ,定义 。
- 取噪声。 从 取一个或多个 。
- 构造隐变量。 计算 。
- 算目标。 计算解码器的 ,再减去 与先验 的 KL 散度。
- 反向传播。 对这批样本的下界估计求 、 的梯度,用 SGD 或 Adagrad 更新两组参数。
如果用小批量代替完整数据集,论文用 乘上小批量目标,使它成为完整数据集下界的估计:
在 VAE 的对角高斯设定下,KL 项可以直接算出来:
这条公式的每一项都有清楚的作用。 惩罚均值离开 0, 惩罚方差偏离 1, 来自高斯分布的熵。重构项仍需要对采样到的 求平均。原论文在实验中使用小批量 ,每个数据点只取 个隐变量样本;这种设置把一次更新的随机采样成本压得很低。2
实验:它证明了哪一层能力
论文在 MNIST 和 Frey Face 数据集上训练生成模型,并把 AEVB 与 wake-sleep 比较。MNIST 的 encoder 和 decoder 各使用 500 个隐藏单元,Frey Face 各使用 200 个隐藏单元;参数用随机小值初始化,优化使用 Adagrad,训练采用 、。2
Figure 2:下界优化速度
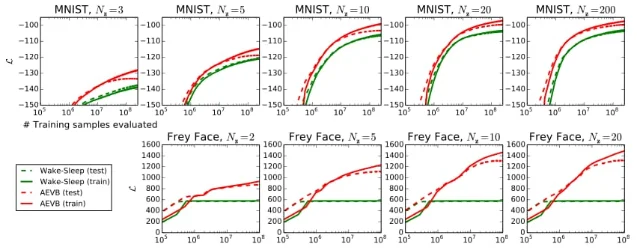
图 2 回答的是「在相同实验框架下,哪种方法更快把这个下界优化好」。它支持 AEVB 在这些设置下的训练效率和目标一致性:AEVB 直接优化一个与边际似然下界对应的目标,而论文指出 wake-sleep 的两个目标合在一起并不对应某个边际似然下界。图中的纵轴是下界,读者不能据此判断人类可解释性或所有场景下的样本质量。2
Figure 3:边际似然估计的边界
论文还在 MNIST 的低维潜空间设置中,用 3 个 latent variables 比较 AEVB、wake-sleep 和 Monte Carlo EM(MCEM)的边际似然估计。MCEM 不是在线算法,面对完整 MNIST 数据集时也无法像 AEVB 和 wake-sleep 那样高效使用。论文同时提醒,更高维潜空间会让这个边际似然估计变得不可靠。2
实验结论可以收窄到三句话:AEVB 在作者的 MNIST/Frey Face 配置上更快优化下界;它把识别模型和生成模型放进同一个变分目标;低维设置中的边际似然比较展示了可行性,但没有覆盖高维潜空间的生成质量。原论文还报告,Figure 2 的计算在 Intel Xeon、有效 40 GFLOPS 的环境下,每百万训练样本约需 20—40 分钟;这个数字属于当时的硬件和实现。2
两个后续问题:下界够紧吗,潜变量可解释吗
AEVB 把「如何让后验推断可训练」这件事解决后,后续工作沿着两条不同方向继续追问。
IWAE 追问下界的松紧。 Burda、Grosse 和 Salakhutdinov 的 Importance Weighted Autoencoders 保留 VAE 的 top-down generative network 与 bottom-up recognition network,但用多个样本做 importance weighting,得到更紧的 log-likelihood 下界。论文摘要还报告,IWAE 在密度估计基准上学到比 VAE 更丰富的潜空间表示,并获得更好的测试 log-likelihood。它改变了估计目标的松紧和样本数量,重参数化技巧仍然可以沿用。3
β-VAE 追问表示结构。 Higgins 等人的 β-VAE 工作把 KL 项的权重改成 ,研究潜变量是否会与数据生成因素更好地对齐。后续的 Understanding disentangling in β-VAE 从 rate-distortion 角度讨论了训练过程中表示解耦的条件,并提出逐步增加潜代码信息容量的训练方式;它明确把重构准确率和解耦表示放在同一个权衡里。4
这两条后续路线没有改掉 VAE 的核心计算链。IWAE 增加样本来收紧下界,β-VAE 调整 KL 项的权重来改变潜空间约束。读者因此可以把后续论文的贡献定位得更准确:它们分别改变「目标估计有多紧」和「表示结构偏向什么」,而 AEVB 的原始贡献是让连续潜变量的近似后验能够进入标准随机梯度训练。
这篇论文留下的判断
VAE 最容易被记成「编码器输出均值和方差,解码器重构图片」。这个记法遗漏了论文真正解决的计算瓶颈。
AEVB 做了三件相互咬合的事:用 把不可解的真实后验变成可学习近似,用 ELBO 把边际似然改写成重构项减 KL 项,再用 把随机采样写成可微路径。三件事缺一不可:没有近似后验,计算仍然落回原来的积分;没有下界,训练目标没有可计算的替代物;没有重参数化,编码器参数的梯度会被高方差估计器拖住。
它换来的能力是可扩展的近似推断与生成模型训练。它没有凭这套机制保证真实后验已经被精确恢复,也没有保证潜变量自动对应人类命名的因素。读下一篇 VAE 论文时,可以先问三个问题:作者优化的是哪个下界?随机样本如何把梯度传回 encoder?实验测的是下界、边际似然、重构误差,还是表示结构?这三个问题能把「模型看起来会生成」和「论文确实解决了什么」分开。
References
- 1Auto-Encoding Variational Bayes
arxiv.org
- 2
- 3Importance Weighted Autoencoders
arxiv.org
- 4Understanding disentangling in β-VAE
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 《BERT》:双向上下文如何变成统一的语言理解接口
- 《Dropout》:随机丢掉单元,如何把过拟合变成可训练的模型平均
- 《Batch Normalization》:一个 mini-batch 如何改变深度网络的训练
- 《ImageNet Classification with Deep Convolutional Neural Networks》:AlexNet 如何把大规模图像分类变成可训练系统
- 《Adam: A Method for Stochastic Optimization》:自适应步长如何把方向与尺度分开
- 「Long Short-Term Memory」:LSTM 如何把长期依赖变成可训练的记忆单元
- 《Distributed Representations of Words and Phrases and their Compositionality》:Word2Vec 如何把上下文变成词向量
- 《Playing Atari with Deep Reinforcement Learning》:DQN 如何把像素变成可训练的 Q 值