《Playing Atari with Deep Reinforcement Learning》:DQN 如何把像素变成可训练的 Q 值
从 Bellman 目标、经验回放和四帧状态出发,读懂 DQN 为什么能在 Atari 像素输入上稳定训练,并学会检查深度强化学习论文的目标偏差、样本相关性与实验对齐。
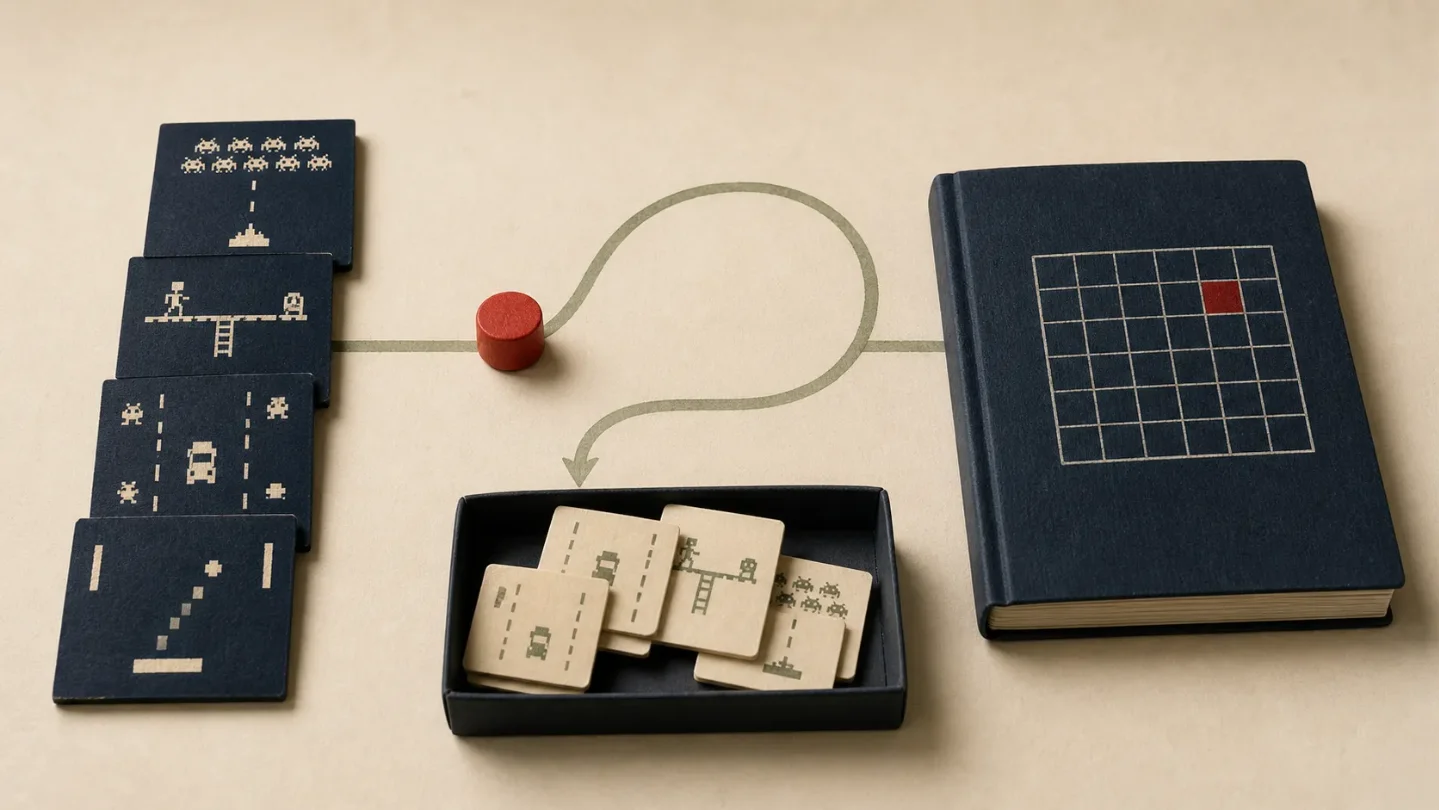
如果一个神经网络一边看屏幕,一边根据自己的动作决定下一步训练数据,它很容易被自己的经验带偏:连续画面高度相关,奖励可能隔很久才出现,网络刚改变策略,接下来看到的数据也跟着变。2013 年的 Playing Atari with Deep Reinforcement Learning 让一个卷积网络直接从 Atari 像素学习 Q 值,靠的不是某个单独的网络层,而是把 Q-learning、经验回放和固定长度的画面状态接成了一套可训练的系统。1
这篇论文真正值得精读的问题是:Q-learning 的目标本身依赖网络,为什么训练没有立刻发散?答案要从数据怎么进入网络开始看,而不是先背「CNN 加强化学习」这个标签。
像素输入为什么让 Q-learning 变难
在表格型 Q-learning 里,状态和动作都可以直接查表。视觉控制把这个前提拿走了:同一个游戏状态不再是一个离散编号,而是一串图像、动作和奖励组成的历史。论文把观测写成
x_t,把截至当前时刻的历史写成 s_t = {x_1, a_1, x_2, ..., a_{t-1}, x_t}。只看一帧画面可能无法判断球是向左还是向右,所以网络至少要看到最近几帧。2强化学习的数据还有三个特点,恰好撞上了深度网络最不喜欢的训练条件:
- 奖励稀疏而且延迟。 一个动作的后果可能经过很长时间才在分数上出现。
- 相邻样本强相关。 连续视频帧几乎没有独立性,直接按时间顺序训练会让一小段轨迹反复主导梯度。
- 数据分布会移动。 网络学会新策略后,下一批状态就由这套新策略产生;参数和数据互相改变,容易形成反馈回路。
论文还指出,非线性函数逼近器与 off-policy Q-learning 结合时可能出现发散。也就是说,难点不是让卷积层认出屏幕上的物体,而是让一个会自举的目标在不断变化的数据上保持可控。3
Bellman 目标:网络到底在逼近什么
Q 值
Q(s,a) 表示:在状态 s 采取动作 a 后,未来能获得多少折扣回报。最优 Q 值满足 Bellman 方程:Q*(s,a) = E[r + γ max_{a'} Q*(s',a') | s,a]右边只有两部分:眼前拿到的奖励
r,以及下一状态 s' 中最有希望的动作价值 max_{a'} Q*(s',a')。γ 是折扣因子,用来降低远期奖励的权重。这个方程的含义不是「网络预测下一个动作」,而是让当前动作的价值估计与「即时奖励加上下一步最优价值」对齐。4DQN 用神经网络
Q(s,a;θ) 近似 Q*,对一批经验最小化平方误差:L_i(θ_i) = E[(y_i - Q(s,a;θ_i))²]其中目标
y_i 来自上一轮参数:y_i = E[r + γ max_{a'} Q(s',a';θ_{i-1}) | s,a]把一条经验代入这个式子,会得到更容易执行的版本。对
(ϕ_j, a_j, r_j, ϕ_{j+1}):- 如果
ϕ_{j+1}是终止状态,目标就是y_j = r_j,因为游戏已经没有未来回报。 - 如果还没有结束,目标是
y_j = r_j + γ max_{a'} Q(ϕ_{j+1}, a';θ)。 - 梯度只把当前采取的动作
Q(ϕ_j,a_j;θ)推向y_j;网络一次前向计算会同时给出所有动作的 Q 值,但损失只选中这次实际动作对应的输出。
这里埋着一个后来会暴露的问题:同一个网络既负责比较下一状态的动作,又负责给被选中的动作估值。
max 会偏向噪声中较大的估计,Double DQN 后来正是从这个薄弱点切入。6经验回放:先把训练数据改造好
DQN 不把刚刚发生的 transition 立刻当成唯一训练材料,而是把每一步经验存入 replay memory:
e_t = (s_t, a_t, r_t, s_{t+1})训练时从记忆中随机抽取一个 mini-batch,再做 Q-learning 更新。这个动作同时改变了三件事:
- 打散相关性。 连续帧被随机抽到不同批次里,网络不再连续追着同一段视频更新。
- 重复利用经验。 同一条 transition 可以被抽中多次,提高每条交互数据的使用效率。
- 平均过去的行为。 训练样本来自许多过去的策略,而不是只来自当前参数刚刚走过的路径,参数改变与数据分布改变之间的反馈被削弱。
这也是为什么经验回放不是普通的数据缓存。它改变了优化问题看到的样本分布。代价是,样本产生时使用的网络参数可能已经过时,所以训练天然是 off-policy:行为策略负责探索,Q-learning 学的是更贪心的策略。原论文把这三个作用放在同一段中讨论,并明确指出经验回放与 off-policy 学习之间的关系。7
论文的 Algorithm 1 可以按一轮循环读:
- 初始化 replay memory 和随机参数的 Q 网络。
- 用
ε-greedy 策略选动作:以概率ε随机探索,否则选择当前 Q 值最大的动作。 - 在模拟器中执行动作,得到奖励和下一帧。
- 把当前状态、动作、奖励和下一状态存入记忆。
- 随机抽取一批历史 transition,计算每条 transition 的 Bellman 目标。
- 对
(y_j - Q(ϕ_j,a_j;θ))²做一次梯度下降。
顺序很重要:网络先与环境互动,经验才进入池子;训练又不只看最新经验,而是从池子里随机取样。论文提出的稳定性来自这个循环的整体,而不是来自「CNN 天生适合强化学习」。8
四帧画面和一次前向传播
论文把原始 Atari 帧转成灰度图,下采样并裁剪为
84×84,再把最近 4 帧堆叠成输入。四帧让网络能从画面变化中获得一部分速度和方向信息,同时把任意长度的历史压缩成固定大小的张量。9网络结构很朴素:输入是
84×84×4,先经过两层卷积和 ReLU,再经过一个含 256 个 ReLU 单元的全连接层。输出层为每个合法动作设置一个单元。假设某个游戏有 6 个动作,一次前向传播直接返回 6 个数:[Q(s,left), Q(s,right), Q(s,fire), ...]这比「状态和动作一起输入、每个动作单独跑一次网络」更省计算。动作数量一多,后者需要重复特征提取;DQN 则只提取一次当前画面的特征,再在输出端比较动作。原论文在所有七款游戏中使用同一套网络结构,合法动作数只随游戏而变化。9
所以,DQN 的数据流可以压缩成一句话:四帧像素先变成共享的视觉表示,输出层把这份表示映射成所有动作的未来回报估计,经验回放再用随机历史样本修正其中一个动作的估计。
实验表应该怎样读
原论文在 Beam Rider、Breakout、Enduro、Pong、Q*bert、Seaquest 和 Space Invaders 七款 Atari 游戏上使用相同架构、算法和超参数。训练时把所有正奖励裁成
+1、负奖励裁成 -1,以便不同游戏共用学习率;这会让网络失去区分不同正奖励大小的能力,是实验设置的一部分,不应从结果中删掉。10下表是论文 Table 1 的平均总回报。DQN、Sarsa 和 Contingency 的前三行使用同一类
ε=0.05 评估策略;DQN Best 是单次最高表现,不能与平均分混为一谈。11| 游戏 | Sarsa | Contingency | DQN 平均 | DQN Best | 人类基线 |
|---|---|---|---|---|---|
| Beam Rider | 996 | 1743 | 4092 | 5184 | 7456 |
| Breakout | 5.2 | 6 | 168 | 225 | 31 |
| Enduro | 129 | 159 | 470 | 661 | 368 |
| Pong | -19 | -17 | 20 | 21 | -3 |
| Q*bert | 614 | 960 | 1952 | 4500 | 18900 |
| Seaquest | 665 | 723 | 1705 | 1740 | 28010 |
| Space Invaders | 271 | 268 | 581 | 1075 | 3690 |
这张表至少支持三层结论。
第一,DQN 的平均分在七款游戏上都高于表中的 Sarsa 和 Contingency。比较的关键不只是分数,还包括输入:旧方法使用了 Atari 专用的视觉特征,而 DQN 从原始 RGB 屏幕学习对象和动作相关表示。12
第二,超过人类基线的范围有限。按论文给出的平均分,DQN 在 Breakout、Enduro 和 Pong 上超过人类基线;Beam Rider 接近但仍低于该基线,Q*bert、Seaquest 和 Space Invaders 仍有明显差距。原论文把后三款游戏的困难归因于需要跨更长时间尺度规划,而不是把所有游戏都说成已经解决。12
第三,训练曲线不能只看游戏得分。论文指出,平均 episode reward 很噪,因为参数的微小变化可能让策略访问一套完全不同的状态;在固定状态集合上观察的平均最大预测 Q 值更平滑。原论文在这组实验中没有观察到发散,但同时承认方法缺少一般性的收敛保证。13
后来发表在 Nature 的扩展版本把评估扩大到 49 款 Atari 游戏,摘要报告同一算法、网络架构和超参数下,DQN 的表现超过此前算法,并在这组游戏上达到接近专业人类测试员的水平。这个结果说明方法的迁移范围比 2013 年的七款游戏更大,但它仍然发生在 Atari 模拟器这一封闭基准中,不能直接等同于现实环境中的通用控制能力。14
DQN 把哪些问题留给了后续工作
DQN 的组合解决了「如何让深度 Q-learning 在像素输入上跑起来」,却没有消除自举估计的偏差。把后续论文放回同一条机制链,能看出它们追问的是不同薄弱点。
Double DQN:max 会不会高估价值
DQN 用
max_{a'} Q(s',a') 同时完成动作选择和价值评估。只要 Q 值带有噪声,最大值就有机会专门挑中偏高的那个估计。Deep Reinforcement Learning with Double Q-learning 把表格型 Double Q-learning 的思路推广到深度函数逼近,报告 DQN 在部分 Atari 游戏中存在明显过估计,并称修正过估计后多个游戏的性能得到改善。6阅读这篇后续工作时,可以把问题写成一个检查式:谁负责选动作,谁负责评估这个动作?如果两件事都由同一组带噪声的估计完成,
max 就不只是一个数学符号,而是误差进入目标值的通道。Rainbow:六个补丁是否真的互补
Rainbow: Combining Improvements in Deep Reinforcement Learning 没有把 DQN 视为一个不可拆的黑箱,而是选取六项独立扩展,研究它们如何组合,并用消融实验检查每个组件对整体性能的贡献。摘要报告,组合模型在 Atari 基准上同时改善了数据效率和最终表现。15
它和 DQN 的关系也因此很清楚:DQN 先建立一个能工作的稳定性组合,Double DQN 检查其中的估计偏差,Rainbow 再把经验回放、目标估计、分布建模等方向的改进拆开比较。后续结果不能倒过来证明原论文的每个组件都被单独验证过;2013 年的实验没有提供这种消融证据。
读深度强化学习论文时,先查这四个位置
- 目标是否移动。 当前网络在拟合什么目标?目标由哪一组参数生成?终止状态有没有错误地加上未来回报?
- 样本是否相关。 训练数据来自连续轨迹、随机回放,还是某种优先级采样?一次经验被使用几次?
- 策略是否改变数据分布。 网络更新后,下一批样本会不会立刻改变?方法用什么机制削弱这个反馈?
- 实验比较是否对齐。 输入特征、训练预算、评估策略、平均分与最高分、奖励裁剪是否一致?失败任务要求多长时间尺度的信用分配?
DQN 的核心贡献可以这样复述:它没有证明深度 Q-learning 在一般条件下稳定,而是用经验回放打散相关样本,用固定长度的帧堆叠提供状态近似,再用卷积网络把像素映射为所有动作的 Q 值。三者共同把一个容易自我强化的在线学习过程,改造成可以用随机梯度下降推进的训练循环。它在七款 Atari 游戏上的统一实验给出了可行性和竞争力;Double DQN 与 Rainbow 则提醒我们,目标估计的偏差和组件之间的作用仍需单独检查。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 《Auto-Encoding Variational Bayes》:VAE 如何把不可解的后验变成可训练的随机梯度
- 《Adam: A Method for Stochastic Optimization》:自适应步长如何把方向与尺度分开
- 「Long Short-Term Memory」:LSTM 如何把长期依赖变成可训练的记忆单元
- 《Distributed Representations of Words and Phrases and their Compositionality》:Word2Vec 如何把上下文变成词向量
- 《Generative Adversarial Nets》:GAN 如何用判别器把生成分布推向真实分布
- 《Deep Residual Learning for Image Recognition》:ResNet 如何让更深的网络重新变得可训练
- 《Attention Is All You Need》:为什么去掉循环,Transformer 仍能处理顺序