《Attention Is All You Need》:为什么去掉循环,Transformer 仍能处理顺序
从 Q/K/V、位置编码、decoder mask 到 BLEU 表格,读懂 Transformer 用全局注意力换取并行训练时付出的计算代价。

翻译一句话时,句首的名词可能要等到句尾的动词或代词出现,模型才知道两者是什么关系。RNN 的做法是按位置一步步传递状态;卷积能并行,但远处的两个位置要经过多层卷积才能互相影响。Transformer 把这条计算路径改成了一次全局检索:每个位置都可以直接给整句中的其他位置分配权重,再把有用的信息加回来。
这就是 Vaswani 等八位作者在 2017 年 6 月 12 日提交的论文 Attention Is All You Need 的核心问题与答案。论文提出的 Transformer 完全去掉序列对齐的循环层和卷积层,仍用 encoder-decoder 结构完成机器翻译。1
读这篇论文,最值得抓住的不是「注意力很强」这句口号,而是它做了一笔明确的交换:用全局、可并行的内容路由换掉循环计算的串行约束,同时用显式的位置表示补回顺序信息;代价是每层要计算位置两两之间的关系。
旧问题:序列模型为什么难以并行
在 RNN 中,第
t 个隐藏状态依赖第 t-1 个隐藏状态。训练一个样本时,即使整句话已经放进显存,位置之间的计算仍被串成一条链;序列越长,这条链越长。卷积把同一层的多个位置并行算出来,但一个小卷积核只能看局部邻域,远距离信息必须沿多层网络传递。论文用三个字段比较这些层:每层复杂度、必须串行执行的最少操作数、任意两个位置之间的最长路径。2| 层类型 | 每层复杂度 | 最少串行操作 | 最长路径 |
|---|---|---|---|
| RNN | O(n·d²) | O(n) | O(n) |
| 卷积 | O(k·n·d²) | O(1) | O(log_k n)(扩张卷积) |
| 全局自注意力 | O(n²·d) | O(1) | O(1) |
这里的
n 是序列长度,d 是表示维度,k 是卷积核宽度。表格不表示自注意力在任何长度上都更便宜:当 n 小于 d 时,论文认为它在句子级表示上可能比 RNN 更快;当 n 变得很大,n² 反而会成为主要负担。自注意力真正消掉的是串行路径,而不是所有计算成本。2一次全局检索:Q、K、V 分别在算什么
把每个 token 的向量记作一个位置的表示。对同一组输入做三次不同的线性投影,就得到
Q、K、V:Q(query,查询)表示「我现在想找什么」;K(key,键)表示「我能被什么样的查询找到」;V(value,值)表示「找到我之后,真正取走什么信息」。
对一个查询
q,模型把它与每个键 k_j 做点积。点积越大,说明两者在当前表示空间里越匹配。把所有匹配分数送进 softmax,就得到一组和为 1 的权重;最后用这组权重对所有 v_j 加权求和:Attention(Q, K, V) = softmax(QKᵀ / √d_k)V这行公式可以按四个动作读:
QKᵀ:计算每个位置对所有位置的匹配分数,得到一个位置到位置的矩阵;/ √d_k:把分数缩小到合适的尺度;softmax:把分数变成注意力权重;...V:按权重混合信息,生成新的位置表示。
为什么要除以
√d_k?如果 q 和 k 的各个分量独立、均值为 0、方差为 1,那么它们的点积方差会随 d_k 增长。分数过大时,softmax 容易挤到接近 one-hot 的区域,梯度变得很小;缩放是在训练稳定性和匹配分辨率之间做的数值处理。2在 self-attention 里,
Q、K、V 都来自同一个序列。于是每个词都能直接读取同一序列中其他位置的信息。比如某个位置需要判断一个代词指向谁,它不必等待一个隐藏状态从句首传过来,而是可以在这一层直接给候选位置分配权重。不过,一次注意力并不会自动懂得顺序。把同一批向量任意重排,只要相似度关系也随之重排,单独的 self-attention 没有内置的「第几个位置」概念。Transformer 在输入 embedding 上加上与其同维度的位置向量。论文采用不同频率的正弦和余弦:
PE(pos, 2i) = sin(pos / 10000^(2i / d_model))PE(pos, 2i+1) = cos(pos / 10000^(2i / d_model))作者选择固定的正弦形式,是因为他们假设固定偏移后的编码可以由原编码的线性变换表达,从而方便模型利用相对位置。论文也用学习式位置嵌入做了对照,在英德开发集上的结果几乎相同;因此,正弦编码是一个可行设计,不是 Transformer 成功的唯一原因。2
为什么要多头,而不是只做一次注意力
如果只在完整的
d_model 维空间里做一次注意力,不同关系会被迫共用同一套匹配与混合方式。多头注意力先把 Q、K、V 分别投影到多个较小的子空间,在每个子空间独立计算注意力,再把结果拼接并投影回原维度:MultiHead(Q, K, V) = Concat(head₁, ..., head_h)Wᴼhead_i = Attention(QWᵢQ, KWᵢK, VWᵢV)原论文的 base 模型使用
h = 8 个 head,d_model = 512,每个 head 的 d_k = d_v = 64。多个 head 不是把同一张注意力图复制八遍,而是允许不同投影空间学习不同的关系;论文的消融实验也显示,单头设置比最佳多头设置低 0.9 BLEU,但 head 过多同样会让质量下降。2把一个 Transformer 层走一遍
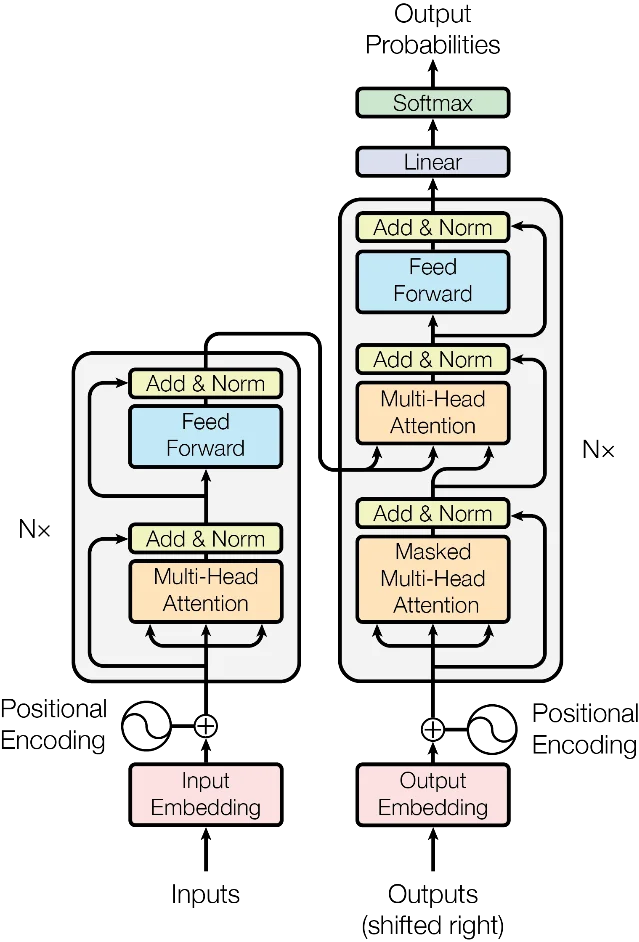
先只看 encoder 的一层。输入 embedding 加上位置编码后,依次经过:
- 多头 self-attention:每个位置读取上一层所有位置的信息,得到同长度的新表示;
- 残差连接与 LayerNorm:把子层输入加回子层输出,再做层归一化,帮助深层堆叠保持稳定;
- 逐位置前馈网络:对每个位置独立应用同一个两层网络
FFN(x) = max(0, xW₁ + b₁)W₂ + b₂; - 再次残差连接与 LayerNorm:得到这一层的输出。
这解释了一个容易被忽略的事实:Transformer 不是只有 attention。attention 负责位置之间的信息交换,FFN 负责在每个位置上做非线性变换。原论文的 encoder 和 decoder 都各堆叠 6 层;
d_model 为 512,FFN 的中间维度为 2048。2decoder 多两件事。第一,它的 self-attention 要遮住未来位置:在 softmax 之前,把不允许连接的分数设为负无穷,当前位置就不会读取尚未生成的目标词。第二,它有一层 encoder-decoder attention:查询来自 decoder 当前层,键和值来自 encoder 输出,所以生成目标词时可以检索整句输入。输出 embedding 右移一位,配合这个 mask,训练时第
i 个预测只能依赖已知的目标前缀。2生成阶段仍然是自回归的:模型先预测第一个目标词,再把它放回输入,继续预测下一个词。于是「训练时可以对整条序列并行做 attention」与「推理时目标词要一个个生成」同时成立。论文解决的是训练中的序列依赖,尚未把生成过程本身改成完全并行。2
实验表怎么读:质量、成本、组件不能混为一谈
论文主要在 WMT 2014 英德和英法翻译上测试 Transformer。英德数据约有 450 万句对,英法数据约有 3600 万句;模型在 8 块 NVIDIA P100 GPU 上训练。base 模型训练 100,000 步、约 12 小时,big 模型训练 300,000 步、约 3.5 天。2
先看主结果。BLEU 是把模型译文与参考译文进行 n-gram 层面的重合比较,表中的数值适合用来比较同一测试集上的系统,不应被直接当作完整的语言质量。论文表 2 给出的 Transformer big 结果是:
| 任务 | Transformer big 的 BLEU | 读法 |
|---|---|---|
| WMT 2014 英译德 | 28.4 | 论文称其超过此前包括集成模型在内的最佳结果 2 BLEU 以上。 |
| WMT 2014 英译法 | 41.8 | 摘要和表 2 把它列为单模型结果;论文同一小节的叙述段落另写成 41.0,阅读原文时应保留这个版本内部不一致。 |
这些数字支持一个有限但有分量的判断:在论文选定的两个翻译基准上,Transformer 同时取得了更高的 BLEU 和更强的并行训练特性。它们不能单独证明 Transformer 在所有序列任务、所有长度和所有硬件上都更优。2
再看消融实验,因为主结果只能告诉我们「整套设计有效」,不能告诉我们「哪一个零件有效」。表 3 的信息可以按问题来读:
- head 数量:单头比最佳设置低 0.9 BLEU,head 太多也会下降,说明多头不是越多越好;
- 键的维度
d_k:减小它会伤害质量,说明匹配本身需要足够的表示维度; - 模型规模:更大的模型在这组开发集上通常更好,但也需要更多训练资源;
- dropout:去掉 dropout 后开发集质量下降,论文据此认为它有助于避免过拟合;
- 位置编码:学习式位置嵌入和正弦编码结果近似,说明位置注入是必要接口,但具体采用哪一种并未在这组实验中拉开明显差距。
最后看迁移到别的任务。作者用 4 层 Transformer 做英语成分句法分析:只用 WSJ 训练集时 F1 为 91.3,半监督设置下为 92.7。这个结果不是语言理解能力的总证明,却说明这套层结构不只服务于机器翻译。2
局限:短路径换来了平方成本
全局 self-attention 的关键代价写在表 1 里:序列长度为
n 时,每层要形成一个 n × n 的位置关系矩阵,复杂度是 O(n²·d)。序列越长,显存和计算增长越快。论文已经提出把 attention 限制在局部邻域,以降低长输入的成本,但把它作为未来工作,并没有在这篇论文里解决全局 attention 的长序列瓶颈。2还要区分两种「并行」。训练时,已知的目标序列可以整体送进 masked decoder,矩阵运算能并行;生成时,下一个 token 依赖上一个 token,decoder 仍按步运行。Transformer 把瓶颈从「每层读取上一个位置」移到了「每步生成下一个词」和「每层处理所有位置对」。这不是缺陷被隐藏了,而是计算瓶颈换了地方。
论文附录展示了若干 attention head 似乎在跟踪动词与远处成分、代词指代等关系。这些图能帮助我们观察模型可能使用了哪些线索,但一张注意力图只显示权重分布,不能单独证明某个 head 是产生预测的因果原因。把可视化当作诊断线索,比把它当作完整解释更稳妥。2
影响:同一接口如何离开机器翻译
Transformer 的可迁移之处,不是「所有数据都像文本」,而是它提供了一个清楚的接口:把对象表示成一组向量,给它们注入位置或结构信息,再让各位置通过 attention 交换信息。
BERT 取用了 Transformer 的 encoder,把无标注文本中的左、右上下文一起用于预训练,再用一个额外输出层适配问答、语言推理等任务。它把 Transformer 从 encoder-decoder 翻译模型改造成了通用语言表示模型。3
Vision Transformer(ViT)则把图像切成固定大小的 patch 序列,把 patch 当作类似 token 的输入,再直接用 Transformer 做图像分类。这样,attention 的输入对象从词片段换成了图像块;论文报告它在大规模数据预训练后能迁移到多个图像识别基准。4
这两个例子支持的结论很具体:Transformer 的模块边界足够通用,能把不同对象都组织成「可交互的序列」。它们不支持另一个更强的结论:只要把数据切成序列,Transformer 就必然优于带有局部结构先验的模型。
读完后,怎样自己检查一篇 Transformer 论文
遇到一个新模型,可以按下面五个问题检查,而不是先背它新增了多少模块:
- 输入对象是什么,顺序或空间结构通过什么方式进入表示?
Q、K、V分别来自哪里,attention 允许哪些位置互相读取?- 计算是否为所有位置构造
n × n关系矩阵,长序列时成本如何变化? - 训练并行和推理并行分别成立到哪一步,decoder 是否仍然自回归?
- 实验是否同时报告任务指标、模型规模、训练成本和关键消融,结果能否支持作者声称的那一层结论?
把这五个问题带回原论文,Transformer 就不再是一张模块方框图。它是一种可检查的计算安排:用
QKᵀ 决定信息从哪里来,用位置编码告诉模型这些信息处在什么顺序,用 FFN 在每个位置加工结果,再用残差与归一化把这套操作堆叠起来。This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.