《Generative Adversarial Nets》:GAN 如何用判别器把生成分布推向真实分布
从生成器与判别器的 minimax 博弈出发,读懂 GAN 的最优判别器、JS 散度、训练算法、实验数字,以及它用采样便利性换来的训练稳定性代价。
如果让生成模型直接写出一个能计算的概率密度,训练往往会先撞上概率计算本身的难题:有些模型需要估计难以处理的归一化常数,有些模型要靠马尔可夫链反复采样。Goodfellow 等人在 2014 年提出的 Generative Adversarial Nets(GAN),换了一条路:生成器只负责造样本,判别器负责指出样本哪里不像真的,生成器再利用这份反馈修改自己。1
这条路的核心收益和代价必须一起看。GAN 避开了显式密度和生成阶段的马尔可夫链,却把训练变成两个网络之间的博弈:判别器不能太弱,生成器也不能在判别器还没学好时一路独自更新。读这篇论文时,最值得抓住的不是「生成器制造假样本」这句直觉,而是一个更具体的问题:为什么判别器提供的分类反馈,能够等价地推动生成分布接近真实分布?
生成模型为什么需要一个对手
论文讨论的对象是生成模型:给定训练数据,学习一个分布,使从中采样得到的结果像训练数据。传统路线通常需要写出或近似计算数据的概率;原论文指出,深层生成模型在最大似然训练中会遇到难以处理的概率计算,而玻尔兹曼机一类方法还依赖马尔可夫链蒙特卡洛,采样混合本身就可能成为瓶颈。2
GAN 把任务拆给两个角色:
- 生成器
G(z; θg):从噪声先验p_z(z)中取一个随机向量z,把它映射为数据空间中的样本G(z)。 - 判别器
D(x; θd):输入一个样本,输出它来自真实数据而不是生成器的概率估计。
论文在引言里用了一个很贴切的比喻:生成器像伪造钞票的一方,判别器像检查钞票的警察。这个比喻有一个容易被忽略的技术含义:判别器不是训练完成后要部署的分类器,它的价值在于为生成器提供一个随当前样本分布变化的反馈信号。3
Minimax 目标:两项交叉熵在推动什么
原论文把两个网络写成一个双人极小极大博弈:
min_G max_D V(D,G) = E_{x~p_data}[log D(x)] + E_{z~p_z}[log(1 - D(G(z)))]逐项读这个式子:
- 从真实分布
p_data采样x,判别器希望D(x)接近 1,于是最大化log D(x)。 - 从噪声分布
p_z采样z,生成器得到G(z)。判别器希望把它判为假,让D(G(z))接近 0,于是最大化log(1-D(G(z)))。 - 生成器最小化整个价值函数,所以它会调整参数,让生成样本更容易被判别器当成真实样本。
这里的
min_G max_D 不是一句修辞,而是训练方向:D 在自己的参数上做最大化,G 在自己的参数上做最小化。判别器的训练信号来自真实样本与生成样本的差异;生成器的训练信号则沿着 D 的梯度反向传回 G。4不过,论文的理论目标和实践中的生成器更新并不完全一样。训练早期,生成器很差,判别器很容易以高置信度拒绝生成样本。这时
log(1-D(G(z))) 可能饱和,传给生成器的梯度反而不够强。论文因此建议实际训练生成器时最大化 log D(G(z))。这个替代目标与原 minimax 目标具有相同的固定点,却能在训练初期提供更强的梯度。4固定生成器后,判别器究竟学到什么
理解 GAN 的理论保证,先不要急着说「判别器越来越聪明」。固定一个生成器
G,它诱导出一个生成分布 p_g。在某个数据点 x 附近,真实分布提供的密度是 p_data(x),生成分布提供的密度是 p_g(x)。判别器在该点的最优值是:D*_G(x) = p_data(x) / (p_data(x) + p_g(x))这个结果很有解释力。若
x 附近几乎只出现真实样本,分子占比大,D*_G(x) 就接近 1;若真实和生成样本在那里出现得一样多,判别器只能给出 1/2。判别器的输出不是样本「真实程度」的脱离分布的绝对分数,而是两种分布在同一位置上的相对密度比。原论文将这一结果写为 Proposition 1。5把这个最优判别器代回价值函数,论文得到:
C(G) = -log(4) + 2 · JSD(p_data || p_g)JSD 是 Jensen–Shannon divergence,用来衡量两个分布的差异。它非负,并且只有在 p_g = p_data 时为 0。因此,在无限容量、能够讨论分布本身的理想条件下,生成器的全局最优解就是恢复真实数据分布;此时最优判别器在各处输出 1/2。这给出了「为什么对抗反馈能逼近真实分布」的机制级答案:判别器先把当前两种分布的局部密度差异编码进自己的输出,生成器再沿着这个反馈减少由该差异定义的 JS 散度。 5但这不是「实际训练必然收敛」的定理。论文的证明在非参数设置下讨论分布空间,并假设判别器在每次生成器更新前都能达到最优;实际模型是有限容量的多层感知机,训练的是
θg 和 θd,参数空间可能存在多个临界点。原论文也明确把实际表现描述为经验上的有效性,而不是有限网络优化的完整保证。6Algorithm 1:一轮更新到底做了什么
论文的迷你批次算法取判别器更新步数
k=1。可以把一轮训练压缩成下面的动作链:7- 从噪声先验采样
m个噪声向量,从真实数据分布采样m个真实样本。 - 固定生成器,用真实样本和
G(z)组成一批真假样本,沿着判别器目标的梯度上升,增加真样本得分、降低假样本得分。 - 再采样
m个噪声向量,生成一批新样本。 - 固定判别器,沿着生成器目标的梯度下降,让这些新样本得到更高的
D(G(z))。 - 重复以上过程,让判别器追踪当前生成分布,生成器追踪判别器暴露出的差异。
第 2 步和第 4 步之间的「固定谁、更新谁」不能省略。若把两个梯度混成一个普通的单网络训练过程,就无法解释 GAN 的反馈为何来自对手,也无法解释为什么判别器的状态会影响生成器下一步往哪里移动。
论文 Figure 1 用一维分布演示了这个数据流:噪声经过
G 映射到数据空间,生成分布 p_g 在高密度区域收缩、在低密度区域展开;判别器先逼近区分 p_data 与 p_g 的最优边界,生成器再根据判别器梯度把样本推向更像真实数据的区域。这个图表达的是训练机制,不是一个真实图像生成器的网络结构图。8实验表:可行性、竞争力和评估误差要分开读
原论文在 MNIST、Toronto Face Database(TFD)和 CIFAR-10 上评估生成样本。定量评估不是直接计算
p_g(x),而是先从生成器采样,再用 Gaussian Parzen window 拟合一个近似密度,报告测试集上的 log-likelihood。论文特别提醒,这种估计在高维空间中表现不好,而且方差较高;因此表中的数字既是结果,也是评估方法的限制。9| 模型 | MNIST log-likelihood | TFD log-likelihood |
|---|---|---|
| DBN | 138 ± 2 10 | 1909 ± 66 10 |
| Stacked CAE | 121 ± 1.6 10 | 2110 ± 50 10 |
| Deep GSN | 214 ± 1.1 10 | 1890 ± 29 10 |
| Adversarial nets | 225 ± 2 10 | 2057 ± 26 10 |
这里的 log-likelihood 数值越高越好。GAN 在 MNIST 上高于表中其他模型;在 TFD 上则低于 Stacked CAE 的 2110 ± 50,也低于 DBN 和 Deep GSN 的报告值。更稳妥的读法是:这组结果支持对抗框架具有可行性和一定竞争力,但并不支持「在所有数据集上全面优胜」。原论文自己也说,生成样本至少与当时较好的生成模型具有竞争性,并没有声称样本一定优于已有方法。9
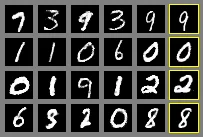
定性结果回答的是另一个问题:模型是否真的在直接采样,而不是把训练样本复制出来。Figure 2 的每个数据集样本网格中,最右列给出相邻生成样本的最近训练样本;论文还说明,图中的样本是随机抽取而非挑选,生成过程不依赖马尔可夫链混合,因此样本之间不相关。图像可以支持「生成器能产生与训练样本不同、但具有相似结构的样本」这一观察,却不能单凭视觉质量证明分布已经完全恢复。11
GAN 的代价:没有显式密度,还要维持训练平衡
GAN 的第一个代价是
p_g(x) 没有显式表示。生成器定义的是「噪声经过 G 后得到什么样本」的隐式分布;模型可以采样,却不能像显式密度模型那样直接代入一个公式计算样本似然。原论文因此使用 Parzen density estimation 做近似评估,同时承认这种方法在高维数据上并不理想。9第二个代价是 G 和 D 的同步。判别器若没有跟上,生成器得到的反馈就不可靠;生成器若在判别器没有充分更新时被训练过多,可能把许多不同的噪声向量映射到同一个输出,以迎合当前判别器,结果是样本多样性下降。原论文把这种现象称为「Helvetica scenario」;后续 GAN 文献普遍用 mode collapse 描述这一类问题。1213
这也解释了 GAN 论文中一个容易被忽略的交换:它用「生成时简单」换来了「训练时需要协调」。采样阶段只需把噪声前向通过生成器,不需要运行马尔可夫链;训练阶段却要让两个优化过程彼此提供有效反馈。这个交换没有消灭生成建模的难度,而是把难度从显式概率计算移到了对抗优化和评估上。2
影响:后续工作分别追问哪一个薄弱点
原论文在结尾提出了条件生成、学习近似推断、半监督学习和改进 G/D 协调等方向。后来出现的工作,可以按它们追问的具体薄弱点来读,而不是把所有后续模型都当成同一种改进。14
- Wasserstein GAN 把注意力放在分布距离与训练信号上。作者将它作为传统 GAN 训练的替代方案,主张提升稳定性、缓解 mode collapse,并提供更有调试价值的学习曲线。读它时可以追问:如果 JS 散度在实际训练中不能提供稳定反馈,换一种分布距离会怎样改变优化?这些是 WGAN 的主张,不是原始 GAN 已经证明的结论。13
- Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks 把注意力放在网络架构。DCGAN 提出一组卷积 GAN 的架构约束,并报告生成器和判别器学到层级化表征,判别器特征还可用于新任务。读它时可以追问:对抗目标之外,卷积结构、归一化和激活顺序分别怎样影响训练与表征?15
这两条后续路线共同说明,原始 GAN 的贡献不是一个「只要互相对抗就会自动生成好样本」的配方。它提供了一个新的训练接口:让可学习的判别器把分布差异转成生成器能使用的梯度。后续研究必须继续回答两个工程和理论问题:这个梯度是否稳定,以及网络是否有能力把它转化成有多样性的样本。
读 GAN 类论文时,先检查四个地方
- 目标函数的角色是否清楚。 判别器最大化什么,生成器最小化什么?实践中的生成器目标有没有因梯度饱和而改变?
- 理论假设是否被保留。 结论是在无限容量、最优判别器和分布空间中成立,还是在有限网络和实际训练预算中得到的?
- 评估指标测的是什么。 是显式似然、近似似然、样本质量,还是多样性?每个指标的估计误差和适用范围是什么?
- 真假之外有没有多样性。 生成样本像真实数据,不等于覆盖了真实分布;要看最近邻、不同随机种子的样本,以及是否出现大量噪声向量对应同一输出的现象。
GAN 的关键结果可以浓缩成一条可复查的链条:固定生成器时,最优判别器是两种密度的比值;把它代回 minimax 目标后,生成器面对的是 JS 散度;理想全局最优点要求
p_g=p_data。实验则只在有限数据集、有限网络和有缺陷的 Parzen 评估下展示了可行性与竞争力。把这两层证据分开,才能既看见 GAN 改写生成模型训练方式的地方,也不把理论最优点误读成实际训练的保证。References
- 1
- 2Generative Adversarial Nets(第 1、2 节)
ar5iv.labs.arxiv.org
- 3Generative Adversarial Nets(第 1 节)
ar5iv.labs.arxiv.org
- 4Generative Adversarial Nets(式(1)与第 3 节)
ar5iv.labs.arxiv.org
- 5Generative Adversarial Nets(Proposition 1 与式(2))
ar5iv.labs.arxiv.org
- 6Generative Adversarial Nets(第 4 节)
ar5iv.labs.arxiv.org
- 7Generative Adversarial Nets(Algorithm 1)
ar5iv.labs.arxiv.org
- 8Generative Adversarial Nets(Figure 1 图注)
ar5iv.labs.arxiv.org
- 9Generative Adversarial Nets(第 5 节)
ar5iv.labs.arxiv.org
- 10原论文 Table 1
ar5iv.labs.arxiv.org
- 11Generative Adversarial Nets(Figure 2 图注)
ar5iv.labs.arxiv.org
- 12Generative Adversarial Nets(第 6 节)
ar5iv.labs.arxiv.org
- 13Wasserstein GAN(arXiv 摘要页)
arxiv.org
- 14Generative Adversarial Nets(第 7 节)
ar5iv.labs.arxiv.org
- 15
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.