《Distributed Representations of Words and Phrases and their Compositionality》:Word2Vec 如何把上下文变成词向量
从 Skip-gram 的局部预测出发,读懂负采样、子采样和短语 token 如何把词的共现关系变成可计算的向量结构,并学会把训练速度、类比准确率与方法边界放在一起判断。

一个词的含义,能不能不靠词典定义,而是从它经常和谁一起出现中学出来?如果模型总在「France」附近看到「Paris」,总在「quick」附近看到「quickly」,那么它是否会把这些关系压进一组可以计算的数字里?
2013 年的 Distributed Representations of Words and Phrases and their Compositionality 给出的答案,不是先给每个词标注语义,而是让一个中心词去预测窗口里的上下文词。预测得越准,词向量就越需要保留这个词在语料中留下的分布痕迹。论文在此前 Skip-gram 的基础上加入高频词子采样和
Negative Sampling,又把训练单位扩展到短语。1这篇论文最值得带走的问题是:一个看似很弱的局部预测任务,为什么能形成可做语义和句法类比的向量空间?答案要沿着训练目标、计算近似和实验设置一起读。只看
word2vec 这个名字,会错过它真正做的三次取舍。词向量先学会预测邻居
论文的训练单位不是「词的定义」,而是一段文本里的中心词和邻近词。设句子中的词序列为
w₁, w₂, ..., w_T,以 w_t 为中心、窗口半径为 c,Skip-gram 要最大化:(1/T) Σ_t Σ_{-c≤j≤c, j≠0} log p(w_{t+j} | w_t)这行公式在算什么?对每个中心词,模型把窗口中的每个上下文词都当成一个预测目标。例如窗口半径为 2 时,中心词
w_t 要分别预测 w_{t-2}、w_{t-1}、w_{t+1} 和 w_{t+2}。一个中心词因此产生多个训练约束,而不是只产生一个标签。2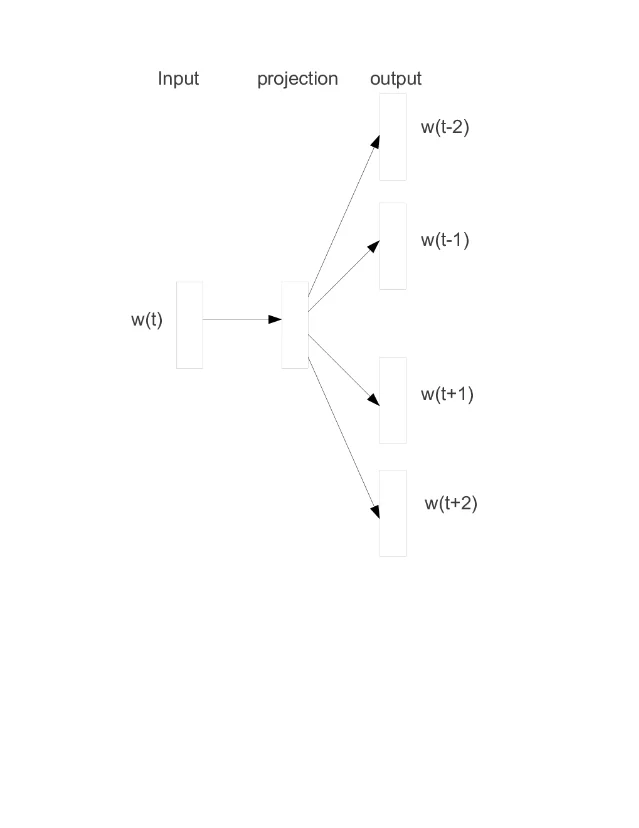
w(t) 经过 projection 后,分别预测 w(t-2)、w(t-1)、w(t+1) 和 w(t+2)。图中展示的是训练目标的数据流,不是模型在推理时生成一句话。3每个词有一个输入向量
v_w,也有一个输出向量 v'_w。给定中心词 w_I 和目标上下文词 w_O,标准 softmax 用两个向量的点积计算分数,再对整个词表归一化:p(w_O | w_I) = exp(v'_{w_O}ᵀ v_{w_I}) / Σ_{w=1}^W exp(v'_wᵀ v_{w_I})点积越大,模型就越倾向于认为这两个词应该一起出现。训练许多句子之后,经常出现在相似上下文中的词会收到相似的更新,向量也就可能靠近。这个「靠近」不是人为写入的词义,而是预测相似邻居带来的结果。论文用
vec(Madrid) - vec(Spain) + vec(France) 找到接近 vec(Paris) 的向量,说明某些关系可以表现为向量空间中的方向。4全词表 softmax 太贵,负采样改了什么
论文先介绍了层次 softmax(Hierarchical Softmax)。它把词放在二叉树的叶子上,预测一个目标词时,只需沿着根节点到该词的路径做若干次二分类。使用 Huffman 树后,常见词拥有较短路径,单个目标词的计算量从遍历
W 个输出节点降到大约 log₂(W) 个节点。5Negative Sampling 采取的是另一种近似。它不再试图给整个词表分配一组严格归一化的概率,而是把一个真实上下文词和 k 个随机抽来的噪声词放在一起做二分类:真实词的点积要高,噪声词的点积要低。论文的目标函数是:
log σ(v'_{w_O}ᵀ v_{w_I}) + Σ_{i=1}^k E_{w_i∼P_n(w)}[log σ(-v'_{w_i}ᵀ v_{w_I})]逐项读这条式子:
log σ(v'_{w_O}ᵀ v_{w_I})奖励真实中心词—上下文词对。两个向量点积越大,第一项越接近 0,损失越小。log σ(-v'_{w_i}ᵀ v_{w_I})惩罚噪声词得到过高分。噪声词的点积越小,负号后的值越大,第二项越容易优化。k决定每个正例要配多少个负例。论文在小数据集上观察到k=5—20有用,在大数据集上则可以小到2—5。这不是免费的精度:k越大,每个训练样本的计算也越多。6
这里有一个必须保留的边界:负采样的目标不再是完整 softmax 的严格概率目标。论文明确把它当作学习高质量词向量的简化方法,而不是完整语言模型概率的等价计算。它之所以有用,是因为表示学习需要的是足够多、足够有区分度的更新,不一定需要每一步都对整个词表归一化。
噪声怎么抽也会影响结果。论文把词频分布
U(w) 提升到 3/4 次幂:P_n(w) = U(w)^{3/4} / Z这个分布仍然让常见词更可能成为负例,但会相对提高低频词被抽到的机会。论文报告,这个选择在尝试过的任务上优于原始词频分布和均匀分布。6
因此,负采样真正换掉的是计算方式:从「每个正例都和整个词表比较」改成「每个正例只和少量噪声词比较」。它保留了区分真实共现与随机共现的训练压力,却把单个样本的成本压到了与
k 有关的规模。子采样不是清洗,而是改造训练数据
新闻语料里,
the、in、a 这样的高频词会出现数亿次。它们当然有语法作用,但对很多词对来说,France 和 the 的共现信息远不如 France 和 Paris 有区分度。若把每次出现都保留下来,高频词会消耗大量训练时间,并反复提供低信息约束。7论文以词频
f(w_i) 和阈值 t 定义丢弃概率:P(w_i) = 1 - √(t / f(w_i))当一个词的频率高于阈值很多时,它更容易被丢弃;低频词则大多保留。论文通常把
t 设在 10⁻⁵ 左右。这个操作同时改变两件事:训练样本减少,训练速度提高;高频词被删掉后,稀有词在有效窗口里遇到的上下文也发生变化,向量质量可能随之提高。所以子采样不能被理解成训练前的无害去噪。它决定模型究竟看见哪些共现关系,是训练分布的一部分。负采样改变了每个正例要和谁比较,子采样改变了哪些正例有机会出现;两者都在动训练目标的实际计算形态。
Table 1 的数字应该怎样读
论文用约 10 亿词的新闻数据训练 Skip-gram,删除出现次数少于 5 次的词后,词表有 692K 个词。评测任务是语义和句法类比:例如计算
vec(Berlin) - vec(Germany) + vec(France),再用余弦距离寻找最近的词。这个任务测的是向量关系能否支持一类固定的几何操作,不是对所有语言理解能力的总测验。8Table 1 的关键数字如下。训练时间单位是分钟,准确率分为句法、语义和总准确率;后半部分使用
10⁻⁵ 子采样。9| 方法 | 子采样 | 训练时间(分钟) | 句法准确率 | 语义准确率 | 总准确率 |
|---|---|---|---|---|---|
| NEG-5 | 无 | 38 | 63% | 54% | 59% 9 |
| HS-Huffman | 无 | 41 | 53% | 40% | 47% 9 |
| NEG-5 | 10⁻⁵ | 14 | 61% | 58% | 60% 9 |
| NEG-15 | 10⁻⁵ | 36 | 61% | 61% | 61% 9 |
| HS-Huffman | 10⁻⁵ | 21 | 52% | 59% | 55% 9 |
从这张表可以读出三件事。
第一,子采样把 NEG-5 的训练时间从 38 分钟降到 14 分钟,总准确率从 59% 变成 60%。NEG-15 也从无子采样时的 97 分钟降到 36 分钟,总准确率从 61% 变成 61%。论文因此把子采样的主要效果概括为提速,同时在这组任务上保持或提升表示质量。
第二,
NEG-15 和 HS-Huffman 的相对表现会随数据处理方式变化。使用子采样后,NEG-15 的总准确率是 61%,HS-Huffman 是 55%;但这不是所有任务和数据规模下的普遍排序。论文自己也指出,训练算法和超参数需要按任务选择。第三,训练时间和准确率必须一起看。只报 61% 会掩盖
k=15 比 k=5 多付出的计算;只报 14 分钟又看不出它的总准确率只比没有子采样的 NEG-5 高 1 个百分点。论文的贡献在于把大规模训练的速度、数据处理和表示效果放进同一组实验里比较。8为什么还要把短语变成一个 token
单词向量有一个结构性缺口:有些短语的含义不是组成它们的单词含义简单相加。「Boston Globe」是报纸名称,「Air Canada」是航空公司名称;只把
Boston 和 Globe、Air 和 Canada 的向量分别学好,并不能保证模型自动得到整个短语的含义。4论文的处理办法很直接:先用数据驱动的方法找经常一起出现、在其他上下文中又不常一起出现的词组,把它们替换成独立 token。例如
New York Times 和 Toronto Maple Leafs 会作为整体进入训练;普通的 this is 则保持不变。短语检测分数为:score(w_i, w_j) = [count(w_i w_j) - δ] / [count(w_i) × count(w_j)]δ 是折扣项,用来避免大量低频词偶然组成短语。经过 2—4 轮扫描,模型可以先找到二元短语,再把更长的短语组合出来。10短语实验说明,表现来自多项设置的合力。Table 2 的短语类比测试集包含 3218 个例子,最佳模型达到 72% 准确率;但在约 10 亿词、300 维的设置下,Table 3 中的结果会随负例数量、层次 softmax 和子采样发生明显变化。NEG-15 使用子采样时为 42%,HS-Huffman 使用子采样时为 47%,而未使用子采样时分别只有 27% 和 19%。1112
论文随后把数据扩大到约 330 亿词,把向量维度提高到 1000,并使用整句作为上下文,短语类比准确率达到 72%;把训练数据缩小到 60 亿词后,准确率降到 66%。这组数字不能单独证明「数据越多就一定越好」,但它清楚说明:短语表示的结果受训练数据量、向量维度、上下文范围和训练算法共同影响。13
向量加法为什么偶尔像在做组合
论文还报告了一个容易被过度解读的现象:某些词向量可以直接相加,得到有意义的近邻。例如
vec(Russia) + vec(river) 接近 vec(Volga River)。为什么加法可能有效?论文给出的解释是,词向量在训练中记录了上下文分布;输出层的点积与概率的对数相关,因此两个向量相加,近似对应把两组上下文约束叠加起来。只有同时得到两边高分的词,才更容易在组合后留下来。14这个解释也说明了加法的边界。它依赖训练语料中确实存在稳定的共同上下文,依赖向量空间把某种关系近似成方向,还依赖测试方式正好用余弦距离寻找最近邻。类比成功说明模型在这类评测上学到了可用结构,不等于向量包含了完整、上下文无关的词义。
这篇论文真正解决了什么,又留下了什么
把前面的实验和公式放在一起,论文的推进顺序很清楚:
- 原始 Skip-gram 用局部预测目标,把词的分布信息压进向量。
- 层次 softmax 用树结构绕开完整词表遍历;
Negative Sampling则用少量噪声二分类换取更低的单样本成本。 - 子采样减少低信息高频共现,同时改变稀有词训练时看到的上下文。
- 短语 token 把单词组合无法表达的 idiomatic phrase 纳入同一个训练框架。
这些机制共同解释了为什么模型能在大语料上训练出有用的向量。它们没有证明词向量理解了人的词典定义,也没有给出对所有语言任务都成立的语义表示。论文的实验主要围绕新闻语料、类比任务和训练效率展开;类比准确率、语料规模和分钟数必须一起看,不能把其中一个数字抽出来代表全部贡献。
读这类表示学习论文时,可以固定检查三个位置:目标函数要求表示保留什么信息;计算近似删掉了什么;实验指标究竟覆盖了哪些能力。在 Word2Vec 里,第一问的答案是局部共现,第二问的答案是完整 softmax 的词表归一化,第三问的答案是特定语料上的句法和语义类比。这样读,便不会把「向量能做类比」误写成「模型已经获得一般语言理解」。
后续影响:中心词—上下文框架可以离开文本
Word2Vec 的一个可迁移想法,是把「预测邻居」看成学习表示的通用训练方式。2015 年的 Comprehend DeepWalk as Matrix Factorization 摘要明确指出,DeepWalk 把 Skip-gram 引入社交网络的节点表示学习,并把它解释为对一个由随机游走共现概率构成的矩阵进行分解。文本里的邻近词被换成图上的邻近节点,中心—上下文预测的形式仍然保留。15
这说明 Word2Vec 的影响不只在于产生了一套词向量文件,还在于它把表示学习的问题改写成了一个可扩展的预测问题:只要能定义「中心对象」和「上下文对象」,就可以尝试让向量编码它们的共现结构。这个判断适用于文本与图的连接,但不能进一步外推成所有 embedding 方法都等价于 Word2Vec。
2013 年之前的 Efficient Estimation of Word Representations in Vector Space 已经提出 CBOW 和 Skip-gram 两种架构,并报告在 16 亿词数据上不到一天训练高质量词向量;当前论文承接其中的 Skip-gram,把训练速度、负采样、子采样和短语表示推进到同一套大规模实验里。16
References
- 1
- 2
- 3原论文 Figure 1
ar5iv.labs.arxiv.org
- 4Distributed Representations of Words and Phrases and their Compositionality(引言)
ar5iv.labs.arxiv.org
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.