《Deep Residual Learning for Image Recognition》:ResNet 如何让更深的网络重新变得可训练
从 degradation problem、残差公式与 shortcut 数据流出发,读懂 ResNet 为什么先修复深层网络的可优化性,再让深度带来准确率收益。
更深的网络为什么会先变差?ResNet 把学习目标改成了什么
「把层数加上去」看起来应该只会增加表达能力:如果一个 18 层网络已经学会了某个函数,34 层网络至少可以让新增层做恒等映射,复制出同样的结果。2015 年,何恺明、张祥雨、任少卿和孙剑在《Deep Residual Learning for Image Recognition》中展示了一个反常现象:在相同训练设置下,34 层的普通卷积网络(plain network)训练误差反而高于 18 层网络。论文提出的 ResNet,不是简单地再加几层,而是让新增层学习输入的「改变量」,把原输入沿着 shortcut 直接传到后面。1
这篇论文最值得带走的判断是:ResNet 首先修复的是深层网络的可优化性,深度带来的表示收益是在这个条件被修复后才显现。 它没有让卷积变得免费,也没有证明层数越多越好;它重新安排了「什么由权重层学习、什么由网络直接保留」这件事。
先看反常结果:更深的 plain 网络为什么更差
论文把问题称为 degradation problem。这里的「退化」不是测试集过拟合:在 CIFAR-10 的 20 层和 56 层 plain 网络对照中,更深模型的训练误差和测试误差都更高;在 ImageNet 的 18/34 层对照中,34 层 plain 网络的训练误差也始终更高。训练集上的表现已经变差,说明当前的优化过程没有找到更深模型中本来应该存在的好解。2
这一区分很重要。若只是过拟合,训练误差通常会继续下降,而测试误差变差;这里却连训练误差都升高。作者还指出,Batch Normalization 已经让前向信号和反向梯度保持了健康的尺度,把训练迭代增加到三倍也没有消除这个现象。因此,论文没有把原因简单归结为梯度消失,而是把它表述为当前求解器难以优化某些深层 plain 参数化。这个机制解释在论文中仍是推测,不是一个已经完成的收敛定理。3
把学习目标从 H(x) 改成 F(x)+x
设几层网络想拟合的目标映射是
H(x),输入是 x。普通堆叠层直接学习 H(x);ResNet 把它改写成:F(x) = H(x) - x所以最终输出仍然是:
H(x) = F(x) + xF(x) 叫 residual mapping,即「相对于输入还差多少」。这里的改变不是把目标函数换成了另一个任务,模型最后仍要得到 H(x);改变的是参数化方式。若理想映射接近恒等映射,那么让多层非线性网络直接学会「原样传递」并不容易,而让残差分支把自己的输出压到接近 0,通常是更直接的路径。论文把这看作一种 preconditioning:先给优化器一个恒等的基准,再学习对它的修正。4最基本的残差块写成:
y = F(x, {W_i}) + x其中
F 由若干带权重的层组成,{W_i} 是这些层的参数。以论文的两层示例为例,主分支可以读成 F(x) = W₂ σ(W₁x);shortcut 分支直接把 x 传到相加节点。恒等 shortcut 不引入新参数,也只增加几乎可以忽略的逐元素相加,因此可以把 plain 和 residual 网络放在相同深度、宽度、参数量与计算量下比较。5从这个式子还能看出一条更短的梯度路径。若损失为
L,对输入求导得到:∂L/∂x = ∂L/∂y · (I + ∂F/∂x)这里的
I 来自 shortcut。它不意味着梯度永远不会变小,也不意味着残差分支没有梯度;它只说明,反向信号有一条不必穿过全部非线性层的直接项。论文的实验支持这条路径有助于优化,但没有声称单凭这条式子就能预测所有网络的训练行为。一个残差块每一步在算什么
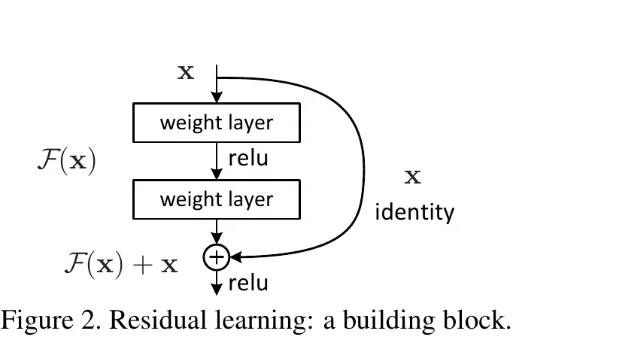
F(x),shortcut 直接传递 x,两者逐元素相加后再经过 ReLU。6把图和公式对应起来,可以按四步读:
- 主分支计算残差。 输入
x经过两层带权重的卷积或全连接变换,中间使用 ReLU,得到F(x)。它不必独自承担「从零构造完整表示」的任务,而只需表示相对于输入的新信息。 - shortcut 复制输入。 identity shortcut 不做学习,只把
x传到相加节点。它是恒等函数,不是一个额外的预测器。 - 逐元素相加。 两个同形状的特征图相加,得到
F(x)+x。如果某个残差分支暂时接近 0,块的输出就接近输入,深层网络因此可以从一串近似恒等变换开始。 - 施加第二个非线性。 论文的基本块在相加后再做一次 ReLU,得到
y。这一步属于块的激活顺序,不能把 shortcut 图误读成「输入绕过整个网络后直接成为最终分类结果」。
这里有一个工程上不能跳过的条件:只有
x 和 F(x) 的通道数、空间尺寸一致,才能直接相加。改变特征图尺寸时,论文使用带参数的 projection shortcut:y = F(x, {W_i}) + W_s xW_s 的作用是把 shortcut 的形状投影到主分支的形状。论文比较了三种做法:只在升维处使用投影、升维时用零填充,以及所有 shortcut 都使用投影。三者都比 plain 网络好;差距不大,说明 projection 不是解决 degradation 的必要条件。ResNet-50/101/152 的 bottleneck 结构仍主要使用恒等 shortcut,只有需要改变维度时才投影。7实验表怎么读:先看公平对照,再看深度收益
论文在 ImageNet 2012 上使用 1000 个类别、约 128 万张训练图像和 5 万张验证图像;比较研究采用 10-crop testing。下面的错误率来自验证集,数值越低越好。18/34 层的第一组对照尤其关键,因为 plain 与 ResNet 的深度、参数量和计算量保持一致。8
| 模型 | top-1 error | top-5 error | 读法 |
|---|---|---|---|
| plain-18 | 27.94% 9 | 未在 Table 2 报告 | 18 层 plain 基线 |
| ResNet-18 | 27.88% 9 | 未在 Table 2 报告 | 与 plain-18 接近,但收敛更快 |
| plain-34 | 28.54% 9 | 10.02% 10 | 比 plain-18 的 top-1 更差 |
| ResNet-34 | 25.03% 9 | 7.76% 10 | 同样 34 层,却比 plain-34 低 3.51 个 top-1 百分点 |
这个表回答了两个不同问题。plain-34 比 plain-18 差,说明「增加深度」本身没有自动带来更好的训练解;ResNet-34 比 ResNet-18 好 2.85 个 top-1 百分点,说明在残差参数化下,深度带来的表示能力重新变得可用。ResNet-34 与 plain-34 的差距又出现在训练误差上,因此主要证据指向优化改善,而不是只在验证集上偶然占优。9
再看更深的单模型,能看到收益与成本同时上升:
| 模型 | top-1 error | top-5 error | 计算量 |
|---|---|---|---|
| ResNet-50 | 22.85% 10 | 6.71% 10 | 3.8B FLOPs 11 |
| ResNet-101 | 21.75% 10 | 6.05% 10 | 7.6B FLOPs 11 |
| ResNet-152 | 21.43% 10 | 5.71% 10 | 11.3B FLOPs 11 |
ResNet-152 的 11.3B FLOPs 低于论文列出的 VGG-16/19 的 15.3B/19.6B FLOPs,但这不是「更深却更便宜」的普遍规律:这里同时改变了网络设计,尤其是 bottleneck block。1×1 卷积先压低通道数,3×3 卷积在较窄的表示上工作,再用 1×1 卷积恢复维度;identity shortcut 让这条高维路径不必再复制一套投影参数。12
CIFAR-10 的结果则提醒我们不要把「越深越好」写成结论。ResNet-110 的测试错误率为 6.43%,五次运行的均值为 6.61% ± 0.16%;1202 层模型训练误差低于 0.1%,但测试错误率反而为 7.93%。论文把后一个现象归因于小数据集上的过拟合:模型可以把训练集拟合得很彻底,却没有获得同等的泛化收益。13
从分类到检测:影响要看表示是否真的能迁移
ResNet 论文没有只报告 ImageNet 分类。作者把 Faster R-CNN 中的 VGG-16 backbone 换成 ResNet-101,保持检测方法不变;在 COCO 验证集上,
mAP@[.5,.95] 从 21.2% 提高到 27.2%,增加 6.0 个百分点,论文把它表述为相对提升 28%。这个对照把收益归到更好的视觉表示,而不是更换检测器。它仍只说明在这组数据和设置下的迁移,不能推出残差网络在所有视觉任务上都领先。14论文在 ILSVRC 2015 分类赛的最终集成结果是 top-5 error 3.57%,并获得该任务第一名;这是一个有历史意义的竞赛结果,但集成模型的成绩不能直接拿来代表单个 ResNet-152,也不能代替前面那组 plain/ResNet 公平对照。1
残差学习后来沿着几条不同路线展开。读后续论文时,可以把问题改写成「shortcut 究竟保证了什么」:
- Identity Mappings in Deep Residual Networks 进一步分析 identity shortcut 和相加后的激活顺序,并用消融实验支持 identity mapping 的作用;摘要报告了 CIFAR-10 上 1001 层 ResNet 的 4.62% error。它适合用来追问:shortcut 的位置和激活顺序是否同样重要。15
- Highway Networks 使用带参数、由数据决定的信息门控来调节跨层流动;它与 ResNet 的无参数 identity shortcut 处在相近的问题背景中,但机制不同。适合用来比较「无条件保留」与「学习何时通过」。16
- Densely Connected Convolutional Networks 把连接方式进一步改成每层接收所有前面层的特征图,使用拼接而不是 ResNet 基本块中的逐元素相加。它适合用来检查:更短的连接、特征复用和参数效率之间如何重新取舍。17
读新模型时,先检查这四个问题
看到一个声称使用 residual learning 的新模型,可以按下面的顺序读:
- 残差分支到底学习什么? 是
H(x)-x,还是把「残差」只当作一个名字?公式中是否真的存在一个稳定的基准路径? - shortcut 是否保持可比性? 同深度的 plain baseline 是否使用了相同的参数量、宽度、训练数据和训练预算?没有公平基线,就很难把收益归因给 shortcut。
- 维度变化在哪里发生? 需要 projection shortcut 时,新增了多少参数和计算?论文有没有把 projection 的收益与额外容量分开?
- 训练误差和测试误差是否一起报告? 训练误差下降而测试误差上升,回答的是泛化问题;训练误差本身就更高,才是优化困难的直接信号。
ResNet 的公式很短,但它改变了深度网络的读法:不要只问「堆了多少层」,还要问每个块保留了什么基准、权重层只需学习多大的修正,以及实验是否证明了这条修正路径真的让优化变容易。对这篇论文来说,最硬的证据不是 152 层或竞赛第一名,而是同等成本的 34 层对照:plain 网络没有找到浅层解,ResNet 则让深度重新带来更低的训练误差和验证误差。
References
- 1
- 2Deep Residual Learning for Image Recognition(第 1 节与 Figure 1)
ar5iv.labs.arxiv.org
- 3Deep Residual Learning for Image Recognition(ImageNet Classification)
ar5iv.labs.arxiv.org
- 4Deep Residual Learning for Image Recognition(第 3.1 节)
ar5iv.labs.arxiv.org
- 5Deep Residual Learning for Image Recognition(式(1)与第 3.2 节)
ar5iv.labs.arxiv.org
- 6Deep Residual Learning for Image Recognition(Figure 2)
ar5iv.labs.arxiv.org
- 7Deep Residual Learning for Image Recognition(式(2)、Table 3 与 Figure 5)
ar5iv.labs.arxiv.org
- 8Deep Residual Learning for Image Recognition(第 3.4 节与第 4.1 节)
ar5iv.labs.arxiv.org
- 9原论文 Table 2
ar5iv.labs.arxiv.org
- 10原论文 Table 3
ar5iv.labs.arxiv.org
- 11原论文 Table 1
ar5iv.labs.arxiv.org
- 12Deep Residual Learning for Image Recognition(Figure 5、Table 1 与 bottleneck 讨论)
ar5iv.labs.arxiv.org
- 13Deep Residual Learning for Image Recognition(CIFAR-10 Table 6 与第 4.2 节)
ar5iv.labs.arxiv.org
- 14Deep Residual Learning for Image Recognition(Table 8)
ar5iv.labs.arxiv.org
- 15
- 16Highway Networks(arXiv 摘要页)
arxiv.org
- 17
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.