《Adam: A Method for Stochastic Optimization》:自适应步长如何把方向与尺度分开
从一阶动量、二阶矩估计与偏差修正出发,读懂 Adam 如何逐坐标调节步长,并用原论文实验、AMSGrad 反例和 AdamW 分清它的能力与边界。
如果同一个网络里有两个参数:一个最近总收到很大的梯度,另一个只偶尔收到很小的梯度,那么它们应该走一样大的步子吗?固定学习率会让前者容易震荡,让后者学得太慢;只把学习率调小,又可能两边都不满意。
Adam 处理的不是「把学习率设成一个更好的常数」,而是让每个参数根据自己的梯度历史得到一个步长。它把三件事放进同一条更新规则:用一阶矩估计平滑方向,用二阶原始矩估计尺度,再用偏差修正抵消零初始化造成的早期低估。1
这篇论文最值得精读的地方,是它把「自适应」拆成了可以逐项核对的计算。读者不必先把 Adam 当成一个黑箱;只要沿着一批梯度走一遍,就能看见它为什么会改变每个坐标的有效步长,也能看见这套设计没有承诺什么。
先把更新式摊开
设模型参数是 ,第 次更新时从当前小批量得到随机梯度 。Adam 的核心步骤可以写成:
不要把这组式子读成「先算一个平均梯度,再除以一个常数」。每个坐标都有自己的 、、有效方向和有效步长。下面按计算顺序看它们各自承担什么工作。
四个量分别在算什么
1. :当前这批数据希望参数往哪边走
是当前小批量对损失函数的梯度。它包含最新的信息,但也包含抽样噪声:同一个参数在相邻小批量上收到的梯度,可能方向相近,也可能因为样本不同而摆动。
如果只用它更新,算法会对每一批数据的偶然性过于敏感。Adam 没有丢掉当前梯度,而是把它放进两个不同的历史统计量里:一个看带符号的方向,一个看平方后的大小。
2. :给方向装上惯性
是梯度的一阶指数移动平均。展开几步可以看到:
最近的梯度权重大,较早的梯度权重按指数衰减。若一个坐标连续朝同一方向, 会保留这条趋势;若梯度方向来回改变,正负项会部分抵消。
所以 不是「真正梯度」的直接替代,而是一个更平滑的方向信号。它和带动量的 SGD 有亲缘关系,但 Adam 还会用另一个统计量逐坐标改步长。
3. :记录这个坐标最近有多容易收到大梯度
使用平方梯度的指数移动平均:
平方会去掉正负号,因此 不负责判断方向。它主要记录每个坐标近期梯度的尺度。
在最终更新式里, 出现在分母。某个坐标的历史梯度幅度较大,分母就较大,更新会被压小;某个坐标的梯度较小或较稀疏,分母相对较小,它获得的有效步长就相对大一些。
这就是「自适应」的具体含义:不是模型理解了哪个参数更重要,而是每个参数按照自己的梯度尺度被重新缩放。 论文把这一点与 AdaGrad 的稀疏梯度优势、RMSProp 的指数移动平均联系起来,同时强调 Adam 只需保存与参数同规模的统计量。2
4. 和 :把零初始化的缺口补回来
和 都初始化为 0。假设梯度统计已经稳定, 的期望仍会被乘上一个因子 , 的期望则会被乘上 。在训练开始时,这两个因子都小于 1,原始移动平均会系统性偏小。
因此 Adam 不直接使用 和 ,而是做:
一步更新可以怎样直觉化
把一个参数的更新拆成两部分:
分子回答「综合最近历史后,往哪边走」;分母回答「这个坐标的梯度通常有多大」。二者结合后,Adam 不是把所有坐标都同步放大或缩小,而是给每个坐标一个不同的缩放比例。
这也解释了论文讨论的尺度性质。若所有梯度同时乘上常数 ,一阶矩大致乘上 ,二阶矩的平方根也大致乘上 ,二者的比例会部分抵消。于是,更新对梯度整体尺度不像普通固定学习率方法那样敏感。这里的「不敏感」是更新式层面的性质,不是说不同损失函数、不同网络和不同超参数下的训练结果一定相同。2
还有一个容易被忽略的代价: 与 都是参数规模的额外状态。Adam 的内存需求并不是零,只是相对于保存完整历史梯度要小得多;它用两个与参数同维度的数组,换来了方向平滑和逐坐标缩放。
偏差修正为什么值得单独做实验
原论文没有只把偏差修正写在公式旁边就结束,而是在变分自编码器(VAE)上比较了有、无修正的训练曲线。图中每一列改变 ,每一行改变 ;红线是带偏差修正的 Adam,绿线是不带修正的版本。2
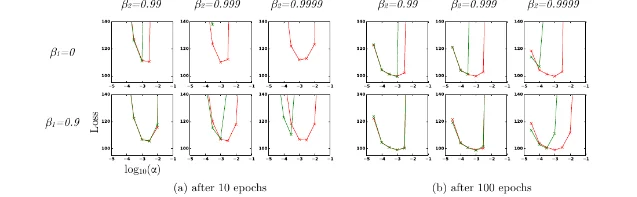
读图时要看两个条件。第一, 越接近 1,二阶矩的有效记忆越长,零初始化带来的低估持续得越久。第二,移除修正后,某些设置下的损失曲线会出现明显不稳定。论文据此支持的是一个机制判断:偏差修正能让早期的矩估计更接近目标统计量;它没有证明偏差修正会在所有任务中带来同样大的最终指标提升。
实验:不要只问谁的曲线最低
Adam 原论文的实验覆盖从凸模型到非凸神经网络的几类任务。读这些实验,最好每次都问四件事:任务是什么,比较对象如何调参,曲线反映收敛速度还是最终质量,训练成本有没有被一起报告。
稀疏特征:先看它是否保留了 AdaGrad 的优点
论文先在 MNIST 图像上的多分类逻辑回归中比较 SGD、带动量的 SGD、AdaGrad 和 Adam。Adam 与带动量的 SGD 收敛速度相近,二者都快于 AdaGrad;随后在 IMDB 影评的词袋特征上测试稀疏输入,Adam 与 AdaGrad 都能利用稀疏性,收敛速度优于普通的带动量 SGD。2
这组实验回答的是一个窄问题:在不同特征尺度、尤其是高度稀疏的词袋输入下,逐坐标的历史尺度是否有帮助。它没有回答「Adam 是否永远优于 SGD」,因为模型、数据、学习率和训练轮数都固定在作者的实验设计里。
多层网络与卷积网络:看早期速度和长期结果是否一致
在 MNIST 多层网络上,论文比较 Adam、AdaGrad、RMSProp、带动量的 SGD 和普通 SGD。Adam 在训练初期表现出较快的下降。对于 CIFAR-10 卷积网络,论文用一个由三层卷积和全连接层组成的架构,报告 Adam 与带动量的 SGD 都明显快于 AdaGrad;在完整训练过程中,Adam 的收敛表现优于其余比较对象。2
这里不能把「初期下降快」和「最终泛化最好」混成一个结论。优化器曲线的纵轴通常是训练损失或训练代价;它告诉我们参数优化得多快,不自动等于测试集上的泛化能力。论文的实验支持 Adam 在这些设置下的优化表现,不是对所有架构的泛化排名。
超参数:自适应不等于不用调参
原论文为不同方法使用了作者给出的建议和实验搜索,并报告 Adam 的默认设置在多项任务上表现良好。这个事实很容易被改写成「Adam 不需要调学习率」,但这已经超出实验支持的范围:基础学习率 、、、批量大小和模型架构仍然会改变训练结果。
更准确的说法是:Adam 减少了为不同参数坐标手工设置不同学习率的需要,但没有消除整个训练过程的超参数选择。它把一部分尺度调节交给梯度历史,基础学习率仍然决定整体迈步幅度。2
理论保证的范围,比算法名更重要
Adam 原论文在在线凸优化框架下分析 regret。直观地说,算法在每一步面对一个损失函数,累计损失与事后最优固定参数之间的差距就是 regret。论文在有界参数域、有界梯度等条件下,给出平均 regret 随时间按 缩小的结果。2
但这一定理有几个不能省略的前提:学习率采用随时间衰减的 ,一阶矩系数按时间衰减,梯度和参数域受到有界性约束,还需要满足 等条件。论文的经验部分则把 Adam 用在非凸神经网络上,通常使用固定的 、 和学习率。
因此,正确的阅读方式不是说「Adam 已被证明在深度学习中收敛」,而是把两条证据分开:理论分析说明某类在线凸问题中的行为;实验说明在若干深度学习任务和配置下它工作得很好。前者不能自动覆盖后者,后者也不能反过来补齐定理没有的假设。
AMSGrad:问题不在于没有动量
2018 年,Reddi、Kale 与 Kumar 给出了一个具体的收敛反例:在简单的一维凸在线优化问题上,原始 Adam 可能不收敛到最优解。问题的关键不是「动量让方向错了」,而是 Adam 用指数移动平均记录二阶矩,旧的大梯度会逐渐被遗忘;当分母变小,有效学习率可能重新变大,参数在某些方向上反复移动。3
作者的修正 AMSGrad 保留了历史上见过的最大二阶矩:
然后用它替代 Adam 更新式中的 :
这一步的直觉是给分母加一条单调性约束:一旦某个坐标经历过大的梯度,后续即使指数平均下降,保留下来的最大值也不会让该坐标的有效步长重新膨胀。AMSGrad 在相应的在线凸和随机凸条件下给出收敛分析,并在合成的一维问题、MNIST 和 CIFAR-10 实验中与 Adam 比较。3
这里要保留反例的尺度感:它证明的是「存在一种简单问题,Adam 的理论收敛声明不成立」,不是「Adam 在实际深度学习训练中必然失败」。论文自己的贡献正是把经验上常用的算法放回最坏情况分析里,指出指数遗忘可能造成什么后果。
AdamW:另一个容易混淆的边界
优化器论文里还有一个常被混在一起的问题:weight decay 和 L2 正则化是不是同一件事?在普通 SGD 中,把 加到梯度里,与每一步直接把参数乘上一个衰减因子有紧密关系;但在 Adam 中,加入梯度的正则项也会被逐坐标的自适应分母缩放。
如果把 L2 正则化放进 Adam 的梯度,更新近似包含:
而解耦的 weight decay 直接写成:
两式的差别在于:前者让正则化项也接受 Adam 的逐坐标缩放,后者把参数衰减从梯度自适应中拿出来。Loshchilov 与 Hutter 因此提出 AdamW,并在 CIFAR-10 和 ImageNet32x32 实验中比较 Adam 与 AdamW;论文报告在其默认学习率和调参设置下,AdamW 的测试误差相对 Adam 有约 15% 的改善。这个数字属于他们的模型、训练预算和实验条件,不能写成所有任务的固定增益。4
AdamW 修正的不是 AMSGrad 那种「二阶矩会不会遗忘大梯度」的问题,而是「正则化是否被自适应分母扭曲」的问题。把两条线分开,才能看懂后续论文到底在修复收敛、泛化,还是参数正则化的实现方式。
读完这篇论文,留下四道检查题
- 方向是谁给的? 看 ,它是带历史的梯度方向,不是某个外部模块判断出的参数重要性。
- 尺度是谁给的? 看 ,它按坐标记录梯度幅度;大梯度坐标通常被压小,小而稀疏的坐标相对得到更大的有效步长。
- 定理覆盖哪种设置? 把损失是否凸、学习率是否衰减、矩系数是否随时间变化、梯度和参数域是否有界逐项列出来,再判断定理能不能迁移到当前模型。
- 实验比较是否公平? 同时看任务、模型、训练曲线、最终指标、超参数搜索和训练预算,不要只摘一条最低曲线。
回头看,Adam 的贡献不是「找到了一个神奇学习率」,而是把优化器里原本混在一起的三个问题拆开:方向如何平滑,尺度如何归一化,初始化缺口如何修正。它的成功来自这套计算在很多任务上很实用;它的边界也同样写在后续论文里:AMSGrad 追问指数遗忘是否破坏收敛,AdamW 追问正则化是否被逐坐标缩放改变。
这就是读优化器论文时值得复用的顺序:先逐项解释更新式,再检查理论假设,接着把实验曲线还原成任务和成本,最后追踪后续工作究竟修复了哪一个失效点。
References
- 1
- 2Adam 原论文 Algorithm 1
arxiv.org
- 3
- 4
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 《Dropout》:随机丢掉单元,如何把过拟合变成可训练的模型平均
- 《Batch Normalization》:一个 mini-batch 如何改变深度网络的训练
- 《ImageNet Classification with Deep Convolutional Neural Networks》:AlexNet 如何把大规模图像分类变成可训练系统
- 《Auto-Encoding Variational Bayes》:VAE 如何把不可解的后验变成可训练的随机梯度
- 「Long Short-Term Memory」:LSTM 如何把长期依赖变成可训练的记忆单元
- 《Distributed Representations of Words and Phrases and their Compositionality》:Word2Vec 如何把上下文变成词向量
- 《Playing Atari with Deep Reinforcement Learning》:DQN 如何把像素变成可训练的 Q 值
- 《Generative Adversarial Nets》:GAN 如何用判别器把生成分布推向真实分布