《ImageNet Classification with Deep Convolutional Neural Networks》:AlexNet 如何把大规模图像分类变成可训练系统
从 ReLU、双 GPU、数据增强与 dropout 出发,读懂 AlexNet 如何把百万级图像分类变成可训练系统,并学会区分单模型、集成、预训练和消融实验的真实含义。
2012 年,图像分类真正的难题已经不再是「能不能训练一个卷积网络」,而是「怎样让一个足够大的卷积网络在百万张高分辨率图片上训练起来」。Krizhevsky、Sutskever 和 Hinton 的这篇论文给出的答案,不是某一个孤立的网络层,而是一套彼此咬合的可训练系统:用 ReLU 加快优化,用两块 GPU 分摊网络,用数据增强和 dropout 抵抗过拟合,再用足够的深度把视觉特征一层层组合起来。1
这篇论文后来通常被称为 AlexNet。读它时,最值得抓住的不是「它赢了 ImageNet」,而是它怎样把计算、容量和泛化这三个互相牵制的问题同时摆到工程设计里。下面沿着一条训练流水线读这篇论文:输入是什么,网络每一层算什么,哪些设计让它变得可训练,实验又究竟证明了哪一层能力。
先看任务:模型到底要解决什么
ImageNet 当时包含超过 1500 万张带标签的高分辨率图片,覆盖大约 2.2 万个类别。论文使用的 ILSVRC 子集包含 1000 个类别,约 120 万张训练图、5 万张验证图和 15 万张测试图。2
这个任务比 CIFAR-10 一类的小图像分类难得多。图片尺寸更大,类别更多,类内变化也更复杂:同一类物体可以出现在不同位置、尺度和光照下。网络如果太小,就没有足够的表示能力;网络如果做大,显存、训练时间和过拟合又会先成为瓶颈。
论文用两个错误率来报告结果:
- Top-1 error:模型概率最高的那个类别不是正确答案的比例。
- Top-5 error:正确答案没有出现在模型概率最高的五个类别中的比例。
Top-5 更适合观察「模型是否至少把正确类别放进候选集合」,但它不能替代 top-1。读表时,先看指标,再看模型数量和训练数据,不能只挑一个最小数字来记。
先看全貌:AlexNet 是一条被拆开的流水线
AlexNet 有 8 个带权重的层:前 5 层是卷积层,后 3 层是全连接层,最后通过 1000 类 softmax 输出类别分布。论文报告模型约有 6000 万个参数和 50 万个神经元。2
把它先读成下面这条数据流:
224×224×3 图像
        ↓
卷积 + ReLU
        ↓
局部响应归一化 + 重叠最大池化
        ↓
卷积 + ReLU
        ↓
卷积 → 卷积 → 卷积
        ↓
重叠最大池化
        ↓
4096 → 4096 全连接层
        ↓
1000 类 softmax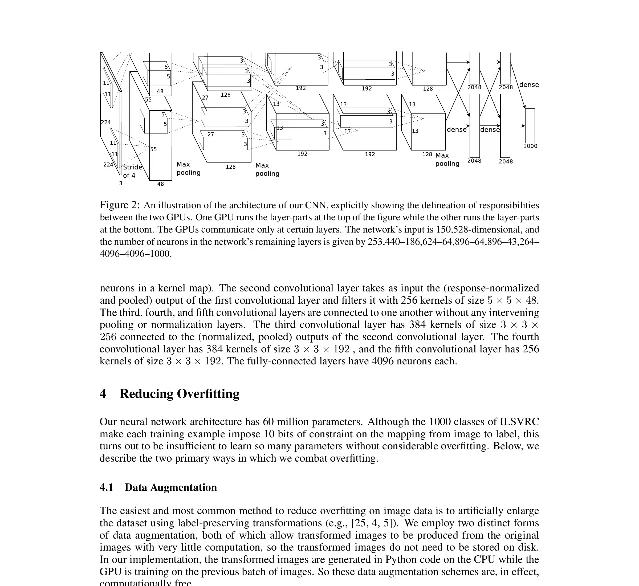
第一层把输入的 224×224×3 图像交给 96 个 11×11×3 的卷积核,步幅为 4。第二层使用 256 个 5×5 卷积核;第三、四、五层使用 3×3 卷积核,通道规模分别为 384、384 和 256。两个全连接层各有 4096 个神经元。2
图里最容易被忽略的部分是中间的「断开」:第二、第四和第五个卷积层只连接同一块 GPU 上的上一层特征图;第三层则连接第二层的全部特征图。这个安排不是把两块 GPU 当成两个完全独立的网络,而是让它们在必要的地方通信,在其余地方各自计算。
五个设计,各自解决一个瓶颈
论文把架构设计按作者估计的重要性排列。我们也按「它改变了哪一步」来读,而不是把所有技巧并列成一个名词清单。
1. ReLU:先让大网络学得动
传统神经元常用饱和非线性,例如 tanh。AlexNet 使用的是 ReLU(Rectified Linear Unit,整流线性单元):
这个函数在输入为正时保留线性梯度,在输入为负时输出 0。它的直觉很简单:只要某个神经元收到正向证据,它就可以继续通过梯度学习;它不像 tanh 那样在大正值或大负值处很快进入饱和区。
论文用一个四层卷积网络在 CIFAR-10 上做对照。达到 25% 训练错误率时,ReLU 网络比使用 tanh 的等价网络快约 6 倍。这个实验并不直接证明 ReLU 在 ImageNet 上带来 6 倍最终准确率,但它说明了一个更基础的事实:如果每一步都慢,大网络就很难被反复试验和训练。2
这里的因果链是「不饱和激活 → 梯度更容易推进 → 大网络更快拟合」。ReLU 没有解决过拟合;它解决的是优化速度。
2. 两块 GPU:把显存限制变成受控通信
单块 GTX 580 只有 3 GB 显存,装不下作者想训练的网络。AlexNet 因此把一半卷积核或神经元放在每块 GPU 上,但不让每一层都跨 GPU 通信。
可以把一次前向传播想成下面的过程:
- 两块 GPU 各自接收自己负责的特征图。
- 在第三卷积层,两个分支交换足够的信息,让该层可以读取第二层的全部特征图。
- 到第四、第五卷积层,两个分支重新主要在本地计算。
- 后面的全连接层再把两边的表示合起来。
这种切分同时解决两个问题。第一,网络能够突破单块显存的容量。第二,GPU 之间的通信量不会随着每一层计算一起膨胀。论文把这个设计与一个在单 GPU 上训练、每个卷积层使用约一半卷积核的网络比较:双 GPU 网络的 top-1 错误率降低 1.7 个百分点,top-5 错误率降低 1.2 个百分点,而且训练时间略短。2
这个比较并不等于「GPU 越多越好」。论文脚注说明,单 GPU 对照在最后卷积层保留了相同数量的卷积核,因此它并不是一个严格对称的缩小版。更稳妥的结论是:在当时的显存约束下,受限通信的双 GPU 设计让更大的模型成为可能,并且在作者的对照中取得了更低错误率。
3. 局部响应归一化:让相邻通道互相竞争
ReLU 不需要先做输入归一化来避免饱和,但作者仍然发现一种跨通道的局部归一化有助于泛化。对位置 的第 个特征图,论文使用:
这里的 是 ReLU 后的激活,求和发生在同一个空间位置的相邻特征图之间。作者使用的超参数是 、、、。
这个公式可以先不急着计算。它在做的事情是:如果同一位置上有一组通道都产生很大的响应,分母就会变大,每个通道的输出就会被压低。这个机制类似「侧向抑制」,让不同卷积核之间形成竞争。
在作者的对照中,局部响应归一化让 top-1 错误率降低 1.4 个百分点,top-5 错误率降低 1.2 个百分点;在 CIFAR-10 的四层 CNN 上,测试错误率也从 13% 降到 11%。这些数字说明它有增益,但增益小于 ReLU 带来的训练速度变化。2
4. 重叠池化:少量增加计算,换一点泛化
池化层会在同一特征图的局部邻域里取最大值。传统池化通常让相邻窗口不重叠;AlexNet 使用窗口大小 、步幅 。因为 $s。因为 $s<z$,相邻窗口会共享一部分输入。
重叠的好处不是让模型看到全新的信息,而是让下采样边界不那么生硬。作者把它与尺寸相同的非重叠池化($z=2,s=2$)比较,发现 top-1 错误率降低 0.4 个百分点,top-5 错误率降低 0.3 个百分点。作者还观察到,重叠池化的模型在训练中稍微不容易过拟合。2
这个结果很适合用来训练读论文的尺度感:一个设计可能有效,但它的实验增益只有零点几个百分点。论文贡献不等于每个组件都带来巨大提升。
5. 数据增强和 dropout:让 6000 万个参数不只是记忆训练集
模型容量变大后,过拟合成为另一条主线。论文指出,即使有约 120 万张标注图像,6000 万个参数仍然可能记住训练样本。作者主要使用了数据增强和 dropout。
数据增强先把原始图像缩放到 256×256,再从中随机裁出 224×224 区域,并随机做水平翻转。训练集因此产生了数量上约为原来的 2048 倍的裁剪样本,不过这些样本并不相互独立。测试时,模型从四个角、中心和它们的水平翻转得到 10 个 patch,再平均 10 次 softmax 预测。这个过程把「物体位置略有变化,类别仍然不变」写进了训练和评测。
作者还对 RGB 通道做 PCA 扰动,让同一物体在光照和颜色强度变化下仍然保持同一标签。这个颜色增强单独让 top-1 错误率降低了超过 1 个百分点。2
Dropout则作用在前两个全连接层。训练时,每个隐藏神经元以 0.5 的概率输出 0;被丢弃的神经元不参与前向传播,也不参与反向传播。于是每次输入都会抽到一个不同的子网络,但这些子网络共享参数。一个神经元不能再依赖某几个固定的同伴,只能学习在多种子网络里都能使用的特征。
这个方法的代价也写在论文里:没有 dropout 时,网络出现明显过拟合;使用 dropout 后,收敛所需的迭代次数大约翻倍。它没有免费消除过拟合,而是用更多训练时间换取更稳健的表示。2
一次参数更新到底在算什么
前面的设计解决了「网络能不能有效计算」和「网络会不会过拟合」。训练时,AlexNet 仍然需要把预测误差变成参数更新。
最后一层输出 1000 个分数。softmax 把它们变成类别概率:
其中 是类别 的输出分数。对真实类别 ,论文最大化正确标签的对数概率,也就是最小化交叉熵:
一次小批量更新可以按下面五步读:
- 取一批图像。 论文使用 batch size 128,并对图像做随机裁剪、翻转和颜色扰动。
- 前向传播。 每层卷积提取局部模式,ReLU 保留正向响应,池化压缩空间尺寸,全连接层组合高层特征。
- 计算损失。 softmax 产生 1000 类概率,交叉熵只惩罚真实类别的概率不足。
- 反向传播。 计算损失对每层权重的梯度。
- 更新参数。 论文使用带 momentum 的随机梯度下降,动量为 0.9,weight decay 为 0.0005。
如果把第 次更新的梯度写成 ,一个简化的动量写法是:
这里 汇总了最近几步的更新方向, 是学习率, 表示权重衰减的作用。这个式子不是为了复述论文的全部实现细节,而是帮助读者看清训练时同时存在的两股力量:动量让更新方向更稳定,weight decay 把参数规模拉回较小范围。
作者把学习率初始化为 0.01,当验证错误率停止改善时手动除以 10,一共降低了三次。网络大约遍历训练集 90 个周期,在两张 NVIDIA GTX 580 3GB GPU 上训练 5 到 6 天。2
实验怎么读:先把结果的边界画出来
ILSVRC-2010:单个 CNN 的结果
ILSVRC-2010 是论文主要实验使用的版本,因为它是当时唯一公开测试集标签的 ILSVRC 版本。单个 CNN 在测试集上的 top-1 和 top-5 错误率分别为 37.5% 和 17.0%。论文同时列出此前方法的 45.7% 和 25.7% top-1/top-5 错误率。2
这个表支持的结论是:在当时的 ILSVRC-2010 设定下,大型深卷积网络显著优于表格中的先前方法。这个表不能单独证明每一个组件的因果贡献,因为它比较的是完整系统。
ILSVRC-2012:15.3% 不是一个基础单模型的数字
ILSVRC-2012 的结果更容易被误读。单个 CNN 的 top-5 验证错误率是 18.2%;平均 5 个相似 CNN 的预测后,验证错误率是 16.4%。把一个模型先在整个 ImageNet 2011 Fall 数据集上预训练,再在 ILSVRC-2012 上微调,得到的单模型验证错误率是 16.6%。最后,作者把两个经过预训练的 CNN 与前面的五个 CNN 组合,得到 7 个 CNN 的 15.3% top-5 测试错误率。2
所以,读者至少要记住这组对应关系:
| 结果 | 模型与训练条件 | 指标 | 能说明什么 |
|---|---|---|---|
| 18.2% | 1 个 CNN | top-5 validation error | 基础模型在该竞赛设定中的表现 |
| 16.4% | 5 个 CNN 平均 | top-5 validation error | 模型集成降低了预测方差 |
| 16.6% | 1 个 CNN,先在更大的 ImageNet 2011 Fall 上预训练 | top-5 validation error | 更多预训练数据带来收益 |
| 15.3% | 7 个 CNN,其中 2 个经过预训练 | top-5 test error | 论文最终竞赛系统的结果,不是单个基础模型 |
这张表把模型结构、训练数据和推理时的集成拆开了。论文的突破当然包括 15.3% 这个竞赛结果,但解释机制时,不能把集成和预训练的收益全部归给一个网络层。
消融:深度本身到底有没有用
论文最后给出一个直接但不完整的深度证据:去掉任意一个中间卷积层,网络的 top-1 性能大约损失 2 个百分点。作者因此判断,深度对结果很重要。2
这个实验的价值在于,它把「网络很大所以有效」拆成了一个更具体的问题:如果只是参数数量重要,那么移除一个卷积层、把参数挪到其他位置也许不应该带来明显损失;但结果显示,中间的层级变换本身在发挥作用。
不过,论文没有把每一个组件都做成现代论文常见的完整 factorial ablation,也没有在今天常用的数据规模、训练配方和硬件上重新比较。因此,更准确的总结是:AlexNet 证明了一套具体的大规模监督学习配置能够工作,并通过若干局部消融说明 ReLU、双 GPU、归一化、重叠池化和正则化各有贡献;它没有证明这些组件在所有后续设置里仍然是最优选择。
这篇论文付出了什么代价
AlexNet 把性能换成了几种成本。
第一是硬件成本。 单个 GPU 的显存不够,模型必须拆到两块 GPU 上;今天的硬件已经不同,但「模型能否放进显存、跨设备通信是否成为瓶颈」仍然是系统设计的一部分。
第二是训练时间。 作者需要 5 到 6 天训练一个模型,dropout 又让收敛迭代次数大约翻倍。更低的错误率不是只靠增加一行网络代码得到的,它需要数据、算力和时间一起支付。
第三是推理成本。 测试时使用 10 个 crop 的平均预测,竞赛结果还使用多个 CNN 的集成。单张图片的最终预测因此不是一次前向传播,读者需要把「单模型能力」和「评测时的额外计算」分开。
第四是方法边界。 AlexNet 解决的是有标签图像分类的可训练性和泛化问题。它没有自动解决无标签学习、跨任务迁移的全部问题,也没有说明卷积网络应该无限加深。论文自己也承认,当时网络规模主要受 GPU 显存和可接受训练时间限制。2
后续影响:问题从「能不能训练」变成「怎样更深地训练」
AlexNet 之后的经典工作并不是简单重复它,而是把同一条主线继续往前推。
VGG 追问深度和卷积核设计。 Simonyan 和 Zisserman 用大量 3×3 卷积核系统比较不同深度的网络,把有效深度推进到 16—19 个带权重层,并报告了在 ImageNet 上的提升。它把 AlexNet 的「深度重要」从一个局部消融结论推进成更系统的架构研究。3
ResNet 追问更深网络为什么难优化。 He 等人没有只继续堆层,而是把层改写成学习残差函数,让输入可以通过 shortcut 直接传到后面。原论文在 ImageNet 上评估了最高 152 层的网络,并把贡献表述为「让明显更深的网络更容易优化」。4
这两条后续路线帮助我们定位 AlexNet 的影响:它没有提供今天所有视觉网络的固定模板,但它把「数据规模、网络深度、激活函数、GPU 训练和正则化」放进了同一套可复现实验里。后来的工作可以分别追问深度、优化、连接方式和计算效率,而不是重新证明大规模视觉学习值得做。
最后留下四个读论文的问题
AlexNet 最值得迁移到下一篇论文的,不是某个过时的超参数,而是下面四个问题:
- 计算问题: 作者怎样让更多有效计算真正发生?ReLU 改变了优化速度,双 GPU 改变了可用显存和通信方式。
- 泛化问题: 作者怎样防止更大的容量变成记忆训练集?数据增强和 dropout 分别改变了输入变化与神经元协作方式。
- 深度问题: 结果来自更多参数,还是来自更多层级变换?移除中间层的消融提供了一个局部答案。
- 口径问题: 每个数字对应什么数据集、多少个模型、是否预训练、是验证集还是测试集?15.3% 只有放回这些条件里才有意义。
如果只记一句话,可以这样记:AlexNet 的核心贡献不是「把 CNN 做得更大」,而是证明在百万级图像上,深度、非饱和激活、受限 GPU 并行和强正则化能够组成一条可训练的流水线;它用更高的硬件、时间和推理成本,换来了当时视觉分类能力的一次跃迁。
References
- 1
- 2原论文第 2 节:数据集与评测
papers.nips.cc
- 3
- 4
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 《U-Net》:编码器—解码器如何同时保留上下文与像素定位
- 《BERT》:双向上下文如何变成统一的语言理解接口
- 《Dropout》:随机丢掉单元,如何把过拟合变成可训练的模型平均
- 《Batch Normalization》:一个 mini-batch 如何改变深度网络的训练
- 《Auto-Encoding Variational Bayes》:VAE 如何把不可解的后验变成可训练的随机梯度
- 《Adam: A Method for Stochastic Optimization》:自适应步长如何把方向与尺度分开
- 「Long Short-Term Memory」:LSTM 如何把长期依赖变成可训练的记忆单元
- 《Distributed Representations of Words and Phrases and their Compositionality》:Word2Vec 如何把上下文变成词向量