先记住你,再替你开口:Today 团队谈个人助理的记忆与主动|《乱翻书》第 277 期
《乱翻书》第 277 期里,Today 的技术负责人高策和 founding member Suki 第一次把产品内部的方案摊开:记忆怎么构建、主动怎么不变味成骚扰、四千封未读邮件怎么读出偏好,以及一个还没跑出 PMF 的赛道接下来会怎么打;文末附本期完整中文逐字稿。

《乱翻书》是一档做商业、科技与互联网圆桌的播客,主理人潘乱写过《腾讯没有梦想》。2026 年 9 月 24 日上线的第 277 期时长 99 分 41 秒,这一次他把话筒交给了产品团队本身——坐在对面的是 Today 的技术负责人高策和 founding member Suki,两人分别负责这款产品的技术,以及产品设计与市场1。
就在录制当天下午六点,Today 中国版正式上线,基础版免费1。这款产品出自齐俊元之手:2011 年他还在上海交通大学读大三,就做出了团队协作工具 Teambition;2019 年 Teambition 被阿里巴巴以 1 亿美元收购,他随之接手阿里云盘;2023 年进入字节跳动任飞书产品副总裁,2024 年转到字节 AI 部门 Flow 负责豆包 PC 端,2025 年 11 月离职创业2。
这期要回答的问题很具体:一个刚上线的产品,凭什么让用户把邮箱、日历和生活里的琐事交出去;当它越来越懂你,又怎么知道什么时候该开口、什么时候该闭嘴。节目按五段走——市场为什么突然热起来、普通人为什么需要它、记忆怎么工作、主动怎么工作,以及创业公司在 Meta、字节、阿里同时进场的局面里靠什么留下来。上一期(第 275 期)的圆桌上,Suki 已经把 Today 当作四个个人 Agent 样本之一讲过一遍3;这一期她和高策第一次把产品内部的方案摊开讲。
这期的主线
高策把这款产品的特点压成两个英文词:Memory 和 Proactive,能记住你,也能主动做事1。他给出的行业分界线是另一句话:AI 一共只完成两件事,一件是尽可能激进地获取你的上下文,另一件是拿到上下文之后做更好的执行。在他看来,眼下大家在做的主要还是前一件,以及一些零散的执行,能替你办成的事"其实还是远远不够"。
Suki 把这条线画在更靠产品的位置:过去你跟一个 Agent 委托事情,要先给它一大堆上下文;而这一代个人助理直接住进你的生活,连上你的应用,认识你的同事和关系网络,所以你只需要一句话就能把事情干完1。
顺着这条线,节目走了四段路:先看这半年市场怎么从"独苗"变成"战场",再回到两个人各自的来路、以及产品在普通人一天里长什么样,然后进入技术含量最高的记忆与主动两篇,最后落到竞争和商业模式。
先记住三件事
第一件,拿到日历和邮箱权限只是起点。 高策花了很多篇幅讲"上下文利用率":同样的邮件列表交给不同产品,读出来的东西可以完全不同。他认为真正难的不是接到数据,而是接到之后把它处理成更高价值的信号——"就算拿到相同的 Context,你能不能把它用得更好,其实这也是你产品最重要的部分"1。
第二件,这代产品的北极星指标被换掉了。 在 Today 团队那里,用户主动发起提问的次数优先级放得非常低,他们最关心的是助理主动替用户解决了哪些问题4。高策在节目里补了一句更狠的:在 Agent 应用里,停留时长一定不是优化目标——"不可能希望你在 Agent 应用里待得更久,它是要解决你的问题的"。
第三件,团队自己承认市场很小、产品没验证。 高策说这个方向此刻还没有 PMF,潜在市场规模非常小,Town 的付费转化就算到了 15%,那点用户体量在整个产业里也是个小市场;他的总判断是这个领域短时间内被高估得厉害,长时间又会被低估1。
一、热潮来了:产品还早,市场已经开打
节目从最基础的问题开始。潘乱让 Suki 用普通话解释什么叫 Personal Agent,她的回答只有一句:"它其实是你的一个朋友,而不是另外一个工具。它会主动来认识你,主动帮你解决生活中的小事"1。
产品的起点比很多人以为的早。Suki 说,团队 2025 年 10 月有了这个想法,2026 年 2 月开始组队,4 月进入内测;她认为 Today 从时间线上是最早的一批,从产品完成度上也希望自己是第一个。对新用户,她给的建议是不用带着 FOMO 去学一个新工具——"你把它当作你在酒吧认识的一个新朋友一样,你怎么和新朋友打交道,你就怎么和 Today 打交道"。
紧接着是对面这一年的变化。潘乱摆出的刻度是:Instinct 不到 10 万用户,半年时间估值从 5000 万美元涨到 100 亿美元;Meta 的 Muse 发布后直接登顶。他问高策,从 2 月埋头做事到现在市场突然一片喊杀,是什么感受。
高策的答案是把这件事拆成一个模式:一个领域被一家公司看到之后,很快其他家都会看到同样的机会和挑战,然后一起涌进来。他举了两条熟悉的曲线——Coding 从 GitHub Copilot、Cursor 到 Devin;Work 方向在今年年初只有很少几家公司走在前面,很快玩家就变多了。由此他得出结论,AI 在应用层达成共识的速度非常快,Muse 其实也是今年年初就开始开发、花了大半年,其中很多时间花在解决隐私问题上,"大家的产品功能都在相同或者相近的时间点 ready 了"。
这一段里有一个读者可能不熟的名词需要解释。OpenClaw 是 2025 年底开始在开发者圈里流传的开源 Agent 项目,中文社区管它叫"小龙虾"——因为它要求用户自己搭环境、自己接模型、自己配工具,所以出现了一种"养一堆小龙虾替自己干活"的玩法。高策认为它给所有产品的启发是:Agent 的长程能力已经在 Coding 之外的很多领域能带来收益,但它的问题是自托管(self-host)非常困难,产品体验也差。他对 Muse 的评价就建立在这上面——"可能确实它就是一个 Better 的 OpenClaw"1。
Suki 补的是另一层动机。她说团队一开始就觉得 AI 不该只是一个等用户发起的工具,它更像影视剧里那种会主动来找你的角色,更像一个数字生命——只是 OpenClaw 这种形态让它第一次被更多人看见。
「市场被验证了,还是得跑快点?」对这个二选一,高策选了第三个答案:这是巨大的鼓励。按他的判断,这个市场才刚刚开始,眼下能达成的任务远远不够。潘乱紧接着追问:Instinct 才 10 万用户就已经是百亿美金估值,你也觉得市场没有被高估吗?高策的回答是"对",Suki 补了一句更冷静的观察——行业里有一种说法是大家在圈子里自嗨,放到普通人的生活里,AI 远远没有普及到所有人的程度。
那为什么选在这一天让国区上线?高策讲了三点权衡。一是美区已经有 Muse 这样占据口碑的产品,Instinct 用内测和邀请码做 go to market 也不影响增长,这给团队提供了经验;二是产品完备程度与提前发布之间本来就有一个 trade off,他们原先以为还有比较长的非共识期,因为付费意愿并不明确,真正在用的人很少而且偏 early adopter,提前发布的好处是能看到更多场景;三是从执行角度看,Muse 和 Instinct 的任务完成率都还不高,但已经是可用、能带来"啊哈时刻"的产品,用户已经觉得这个东西好用,所以现在是一个相对准备充分的时点。
二、从 Monica 到 Today:普通人为什么需要它
潘乱给 Suki 的问题是从她的履历出发的:她在做 Monica 的团队待过,Monica 是 Manus 的前身,之后自己创业做过产品,现在到了 Today,这两年里她对"什么是好的 Agent 产品"的理解有什么变化。
Suki 的回答把时间拉回到 Monica:想做一个个人助理的念头那时就有了。她当时跟肖弘讨论过,Monica 是一个插件产品,安装本身有很大门槛,所以它的 TAM(潜在市场总量)注定不会非常高;于是两人开始想下一个产品往哪走,答案是个人助理。她的理由是,过去只有董事会成员或总裁这样的人身边才配一个助理,可每个人生活中都有一堆琐事——"比如肖弘的助理能够帮她订机票,而且她理解肖弘其实想订在靠窗的位置",这种贴心的助理几乎每个人都有需求。当时没做,是因为技术水平还远远达不到。
Monica 后来能成,她归因于形态:插件直接住在用户意图和执行发生的那个点上。用户打开一个网页一定会产生某个意图,插件让这个意图的执行成本变得极低。Today 在做的是同一件事——缩短从意图到执行的距离,只是它交出的方案换成了"记忆做得更好、更理解你这个人"。她还解释了为什么把赌注压在记忆上:团队一直在跟踪自进化、长程任务、双工语言模型这些方向,过去一年记忆相关的论文数量非常多,说明业界一直在突破;而做产品不能站得太超前,"你不能站在一个非常遥远的未来去做产品,有可能就成了那个先烈",要站在技术成熟度的前沿。
高策为什么从基础设施转向个人助理
潘乱把同样的问题抛给高策,并先确认了他的来路:之前创业做的是模型基础设施和向量数据库1。高策的转折点是 2026 年 2 月——那个月发布的模型让他觉得智能出现了一次跃升。他说自己在 2026 年 2 月以前一直手写代码,因为做的是偏底层的基础设施,代码复杂度和对智能的要求都比较高,"在今年以前其实我都很难相信 AI 能把它写好",所以他对 AI 一直没那么乐观。2 月之后他发现模型能把他做的工作更好地完成,甚至说"我现在感觉模型已经到了 AGI 的水平"。
他由此推出一个判断链条:模型的能力已经不是瓶颈,唯一要在乎的是成本;而成本也会遵循规模定律(scaling law)逐年下降,每年降十倍也没有问题。那么一两年后,你手上会有一个非常廉价、甚至比普通人更强的智能,那时候的体验会完全不同。再往后推一步,他问的是内容消费本身——今天你刷到的内容都是人类提前生产的,三五年后,有没有可能你想要消费的内容是按需生成的?他说,"未来一个人在生活中的所有需求都可能是被按需创造出来的"。
先服务重度用户,还是从普通人愿意交出去的事找起
内测几个月之后,高策对新需求有两个观察。
第一个观察是这一代产品和上一代的出发点相反。上一代像 Glean 从企业搜索做起、Otter.ai 从录音做起,都是从细分场景往上泛化成上下文层;而这一代大家都从通用需求出发,Town 是邮件,Instinct 是帮你打电话、订票、购物。需求本身不针对某一类人,所以泛化性更好——邮件处理得好,就能覆盖到要处理孩子学校邮件的父母,也能覆盖创始人群体。Today 看到的场景与之类似:给创始人或者日程繁忙的轻度办公用户整理行程、提醒会议重叠。
潘乱接着指出一个现象:这些产品的早期用户看起来都是特别忙、时间特别值钱的人,比如 VC、金融从业者。他问你们为什么又要面向更多普通人。高策的回答是这是一个不得不做的取舍:虽然在他看来模型已经到了 AGI,但成本仍然摆在那里;更现实的问题是,如果你平时不用邮件处理事情,在互联网上也没留下多少上下文,Agent 就没法快速了解你在这个世界上的画像是什么、需求是什么,"如果没有你的 Context,我需要你一点一点告诉我,这个上手的门槛是非常高的"。这也是 OpenClaw 最早从程序员群体开始的原因——他们每天对着电脑工作,在互联网上留下了大量上下文。他说,只让高阶人群受益的产品没法 scale,但让更多人受益需要一个缓慢的过程,前提是先回答物理世界的上下文和线上赛博世界的上下文如何统一到同一个入口。
Today 的一天,和他们为什么让用户给助理起名字
潘乱让 Suki 不要用"个人 Agent"这类词,直接讲一个普通用户真实的一天。她拿自己举例,讲了四类用法。
早上打开 Today,它会把连接的 Notion、Slack、邮件里的内容整理出来,告诉她今天有哪些事要做,这是每天的"第一个入口"。日程进行中它会主动做事,比如下午两点有会,它会提前提醒并问要不要准备材料。它还经常给惊喜:有段时间她一直在看记忆相关的论文、聊了很多相关上下文,于是有新论文出来时它会主动推过来。协作也靠它——用录音功能聊完一段内容后,她可以直接让 Today 把上下文组织成语言,通过连接好的 Slack 发给不在场的同事。最后一类她最喜欢,是"温暖":有天下班晚了,Today 主动发消息,打开是一个网站,里面是一束花,附一句"你下班晚了,我给你准备了一份小惊喜"。
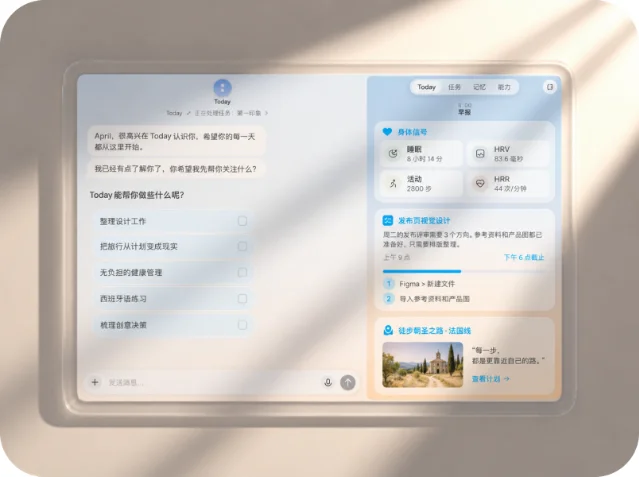
潘乱顺势抛出一个容易混淆的问题:今年前两个月最火的是办公 Agent,这些个人助理里包括办公吗,它们跟办公 Agent 是什么关系。Suki 说她有朋友(还是他们的 Agency)问过"你们不是做个人 Agent 的,怎么还做办公方向",她想强调的一点是,个人助理的对立面被大家搞错了——在她看来,它的对立面是"高委托成本":过去你跟 Agent 委托一件事,要先给它大量上下文;这一代不需要,因为它已经连上你的应用、认识你的关系网络,所以你一句话就能把事交代清楚。
高策从经验上加了一层:尤其在中国,绝大多数人的生活和工作本来就很难分开,越忙界限越模糊,所以从生活出发还是从工作出发,最后都会互相重叠。他举了自己的用例——工作时经常要调研技术,让别的通用 Agent 做研究,它不知道他对这项技术的看法,也不知道他的背景,只能从一个非常客观的角度出发;在 Today 里做同样的调研,它能站在他的立场上,知道他从前做的是向量数据这一块,于是直接给到更贴近他需要的层次。他把这个差别全部归给记忆。他的结论是,不管从工作还是生活开始做,最后都要落到从上下文里抽象出来的记忆上,而且从生活泛化到工作,比从工作泛化到生活更容易一些。
名字这件事是潘乱挑出来的。他问为什么 Today 要让用户设置一个"个人代理"身份,这跟 Town 不太一样。Suki 说团队不希望它是"另一个你要学习的工具"——很多效率工具要你沿着界面一步步学;他们希望产品更像一个"赛博生命",既然是另一个生命,它就该有自己的身份和形象,而且如果这个形象更贴合你,会拉近你与它之间的心理距离。高策补充说名字很重要:Instinct 受交互形式限制没有头像,Muse 有一个很好的、近乎立体的头像,但那还只是产品的名字;用户感受到的个人助理是一种非常亲密的关系,你一定希望它专门为你而存在,而不是别人也能用的东西。
于是有了这段对话里最像闲聊的一节。潘乱问你们的助理都叫什么,Suki 说她叫它 Niki,因为她自己叫 Suki;高策说他的叫"左聚",因为他爱人的名字叫"右威",两个名字是镜像的;潘乱说他在 Today 里的名字叫"文和";高策接了一句,说他接触过一个投资人,那个人的 Today 里名字填的是"齐俊元"。
高策把"起名字"看得很重。他说 Agent 的身份在未来一定是重要的,Instinct 和 Town 会给每个 Agent 一个邮箱地址——"你有了 ID 以后,你有了名字以后,这些才能很自然的发生"。
养过一群 Agent,为什么最后只想面对一个
潘乱的下一个问题是:有名字、有身份就够了吗?未来是一个人配一个大管家,还是健康、财务、工作每个垂类都需要一个专家。
Suki 用自己的实践回答。2025 年 12 月,她自己动手搭过一个 Agent 团队——当时 OpenClaw 有个很火的玩法就是"养一堆小龙虾",她养了一个设计总管、一个产品总管和一个项目总管,给三个人不同的角色。结果是"我最后只愿意跟那个项目总管聊天",因为她的上下文都在同一个地方,不需要像现实生活里那样把同样的背景反复交代给三个角色。她因此得出结论:多角色是人习惯的惯性,AI 并不需要,所以更相信把上下文放在一处。
高策把这条判断推广开:Grok Bot 的设计就有点类似多 Agent——一个幕僚长,下面可以创建很多不同角色的 Agent;国内还有产品也这么做。他使用下来的感觉是"另一个形态的 Multi-Session",本质上是让用户手动管理上下文:在 Codex 里你要自己创建会话来保持一个干净的上下文,在 Grok Bot 里 Slack 是一个 Agent、Gmail 是另一个 Agent。他认为这种取舍的体验一定不如在智能足够高的时候开一个单会话,直接说"我 Slack 上有什么事要处理,你去处理"。他判断在个人助理这个场景里,未来大概率是单会话,"因为人脑可以很好地处理这些上下文,人和人在微信上不可能动不动就新开一个会话"。
Suki 在这里补了两点不同意见。第一,她怀疑 C 端的多 Agent 可能是伪需求:很多人养一堆"小龙虾",更多是在享受"我有一堆小弟给我干活"的情绪价值;真用起来会发现它在浪费 Token,"就像是一个臃肿的公司网络一样,不同的角色之间协同也是需要成本的,协同花的也是你的 Token,你的钱"。第二,多 Agent 有价值,但价值是让两个 Agent 互相监督,比如需要评估、需要测试时,让另一个 Agent 去盯前一个;大多数个人助理的使用场景用不到,有点杀鸡用牛刀。高策表示同意,并补了一条产品层面的理由:多 Agent 可以是背后的架构,但暴露给用户的概念越自然、越像一个具体对象越好,因为用户会和它建立情感连接——"我对我的'左聚'是有非常强烈的情感需求的,我很难再给另一个 Agent 投入相同的心血和精力,这个其实很消耗情绪"。他也承认自己用 Grok Bot 体验很好是有前提的:他是重度用户,知道怎么驾驭它,而光是 Agent 之间的互相发消息、拉群,成本就非常高。
三、记忆篇:同样的上下文,为什么读出的东西不一样
潘乱从一句行业口号切入:他前几天在千问办公的场子里听人讲"Context is all you need"。
高策把上下文拆成两件事。第一件是尽可能多地收集,这一层"八仙过海各显神通":海外生态开放,接入 Google 这类服务很快就能跑起来;国内他分享了一个观察——在手机尤其是安卓手机上,上下文已经超乎想象,"在中国,一个人的手机就是他一生的缩影",存储里、你不经意的某个地方,都有非常丰富的历史。第二件是他认为更重要的一层:拿到上下文之后,怎么把上下文的利用率提上去。"大家在训练的时候都讲 GPU 利用率,但是在 Harness 这个层面上,你的 Context 利用率也很重要"。
Harness 是本期的核心术语之一,指的是模型外面那一层负责调度、组织上下文、调用工具、检查进度的系统——模型的能力由模型厂商决定,Harness 是产品自己写的部分。高策举了一个很具体的例子:完全依赖模型的泛化能力,把同一份邮件列表给它,问它哪些重要,通常不如人做得好。原因是判断逻辑不同——他用邮件用了很多年,算得上是某种意义的邮件专家,他看邮件的逻辑和模型被训练出来的逻辑很不一样。所以把相同的上下文经过 Harness、经过产品处理,拿到更高价值的信号,本身就是壁垒,也是要投入非常多精力的工作。
他以 Town 为例解释"吃得深"是什么意思。Town 的邮件处理格外好,是因为它在这件事上做了非常重的工作:处理一封邮件、决定要不要处理、以及处理时怎么写草稿,能给到五层子智能体(subagents)去执行。潘乱接话说所以 Town 在邮件这个场景里有 PMF,高策同意,并说这是他认为更适合创业公司的一条路——先从一个通用需求开始,把那个需求钻得特别深,"你给它相同的 context,它就是比你做得更好,那个其实是你产品的价值"。
发件箱比收件箱信息密度更高
回到 Today 自己,高策把它区别于其他产品的地方分成两层:记忆和主动。
记忆这一层,他的目标说法是构建出"正确并且 live"的画像和记忆本身——live 在这里指即时更新——画像要跟着新信息一起变。他给了一个小例子:朴素的做法是拿到邮件授权后扫一遍收件箱和发件箱,从中判断你是什么样的人;但一个很核心的观察是,你发出去的邮件带着更高的信息密度。因为发出去的邮件带着意图,而意图会让你把自己的诉求描述得非常清楚——比如要跟潘乱谈一个合作,你会先介绍自己是谁、想要什么。所以发件箱里的东西,往往比收件箱里的信息更重要。他还补了一条:邮件是 1960 年代就诞生的协议,几十年里堆了各种功能和协议,这些功能背后藏着大量"侧信道"信号,能不能在产品上把这些信号取出来,是另一层功夫。而这样的判断规则有海量条,最终都作用在同一件事上——用同样的上下文,构建出更好的记忆,再泛化到别的场景。
第二层是增量信息。人每天处理的其实都是新增的那部分,你不会去看一年前的东西。所以有了记忆之后,要结合各类连接器(Google、Notion、飞书)每天带回来的增量,用一种更高效、更主动的方式去传达、过滤,最重要的还是处理掉。他说这一层的工程难度很高。
潘乱随即提出这一节最关键的反问:没有记忆的主动很容易变成骚扰,只有记忆又只是一本档案。怎么把两件事连起来?
高策的答案是先分清场景。工作场景的问题通常聚焦在一件具体的事上——做个 PPT、做个调研,有明确指向,很好评估对错;他顺手举了 WorkBuddy 开源的评测基准,方法很简单,给你一个目录、一个工作区,然后看它能不能把活干完。而个人助理面对的是开放场景:要用到大量增量信息,这些信息不确定性很高,而且"主动性"本身没有一个明确的完成概念——它跟推送频率有关、跟推送质量有关,甚至跟你当天的心情有关,是很主观的东西。所以这一层一方面要做好的系统设计,让每一步推荐都可观测;另一方面非常考验产品设计,因为产品前期你没法用 A/B 实验来验证主动性好不好,以后恐怕也很难。他把这个角色描述成"很考验产品 owner 对这个世界、对信息架构的理解"。
高策还给了一个类比:主动性有点像 Agent 驱动的推荐系统,但比推荐系统复杂得多。推荐系统的优化目标通常很简单,比如停留时长;主动性带着执行属性,又非常主观,而且在你这个应用里停留时长一定不是优化目标——"不可能希望你在 Agent 应用里待得更久"。他的结论是这件事必须由工程和产品共同设计,甚至和模型本身有关。
Suki 用一个比喻把主动性讲得更清楚。她说放到工作场景里,主动性像两种下属:一种是纯执行型下属,现在很多产品也说自己有主动性,但背后其实是一个定时任务(schedule task),你仍然要交代大量上下文和执行细节,你推一下他动一下;另一种下属非常了解你所在公司的愿景和目标,能和你的底层价值观对齐。他们想做的是后一种——从用户的上下文里抽出"对你真正重要的东西",排出优先级,再告诉你如果你有这样的目标,我可以帮你做什么。
她把做好主动性拆成四个维度:对用户本身的理解(最重要)、对用户反馈的学习(做得不对要能自我调教)、频率(主动性过高很容易变成骚扰,所以频率也要学)、以及时效性(去年的东西放到今天可能一点都不重要了)。
一个不断变化的人,记忆该在什么时候更新
潘乱把问题往前推:人是会变的,换工作、结婚、生孩子、父母生病,过去的偏好都会失效,怎么把零散信息拼成一个长期、连续、不断更新的个人状态。
高策先承认这个领域大家都还在摸索,没有谁拿出了成熟设计。他举了两个参照:Instinct 最近在推特上被逆向出记忆系统,其中有一个专门的时间轴(Timeline),记录你每天、每周发生了什么;Town 也有类似设计,但实现逻辑不同,更像每天把记忆"归并"一次。他认为时间和时间轴是记忆里非常重要的东西,因为增量必须被锚定:增量来自对话历史、来自连接器,未来还会来自物理世界——比如 Today 现在就有录音功能,而录音往往记录的是你最近的状态。他还补了一个容易被忽略的点:锚定的应该是事情发生的时间,而不是你记下它的时间。"比如我今天在飞书上写一句'我在今年二月份的时候公司没了'——事情发生在二月,被记录在九月,这两个时刻都很重要。"他因此说这块很像时间序列数据的处理:不同类型的数据最终要在记忆里融合,融合之后还要能被 Agent 高效消费和召回,而这件事很难一概而论,核心要靠评测来驱动。他的观察是大家都在做,但做得都还挺粗糙。
潘乱补了一个很人际的类比:新信息和旧信息的关系,像两个人久别重逢,可能是你变了我没变,可能是我变了你没变,也可能两个人都变了。高策由此谈到模型的泛化能力——人和人之间存在很多微妙的化学反应和侧信道信号,而那些更隐蔽的东西很难被模型的泛化性发现,通常需要人专门设计判断规则去捕捉。他说自己现在对泛化性越来越吃不准:过去大家觉得模型在写代码上训得好,就一定能泛化到别的场景;在办公场景里某种程度被验证了,但仔细看,"那还是写代码,只不过用它去做 PPT";到了交互和个人助理这里,泛化性没有想象中那么强,在他们自己的交互评测基准上跑分就能看出来。他甚至把这一点延伸到即使模型到了 AGI:也很难完全交给模型去梳理关系和记忆,仍然需要人类的产品设计和先验知识来指导,而这种先验知识本身就可能是壁垒。
四千封未读邮件:经常出现,和真正关心
潘乱给出一个更刁钻的例子:一个人经常做某件事,并不代表他真的喜欢——"我每天吃光面,但我其实真正喜欢的是山珍海味",那怎么区分行为记录和真正的偏好,怎么读言外之意。
高策承认还在探索,但给了一个已经看到的观察:如果不做任何设计,系统对用户喜好的了解会非常片面。他举了自己的例子——邮箱里堆了四千多封未读邮件。如果只是让通用产品梳理一遍,会给他列出好多待办,"那些其实我可能已经不关注了"。为什么不关注了?可能因为太多关注不过来,也可能因为它确实不重要。潘乱在这里的语气很实在:我每天都打开邮件,那么多邮件我都没读,你心里没数吗?
高策由此得出两条结论。一条是这件事哪怕让人来做也不容易——同一个人看到你的邮件列表,分析方式也很多变,未必能得出最好结果,何况你不给它任何先验知识。另一条是解法只能靠评测来逼近:不断把先验知识加进去,看它在基准上的表现有没有变好。他说自己越想越觉得模型泛化性没有想象中那么强,所以产品经理的价值非常大;而且模型正在同质化,未来模型变成基础设施之后,产品的价值只会更大。潘乱听到这里说,这是今天最让他欣慰的一句话。
小孩发烧了,它怎么知道是谁病了
这一节的技术含量最高,起因是潘乱的一个追问。他说邮件毕竟是你被动收到的,有些可能是干扰;但当他直接跟 Today 说话,那才是他主动传达的信号。于是他假设 Today 一开始主打的健康场景:他问"小孩发烧了怎么办",问"父母血压升高了怎么办",问"我太肥胖了怎么办"——他从头到尾没有说生病的是谁,只是在描述不同症状,那系统怎么知道他说的分别是孩子、父母还是自己?又怎么保证不会把聊的东西最后都归到他一个人身上?
高策说这正是很多坏案例的来源,术语叫身份消解(identity resolution)——怎么识别出这件事真正属于谁。他说目前各家做法都还比较原始,基本靠记忆召唤的思路在解决,没有做特化处理。他描述了系统的隐含推理:你问的病可能只发生在孩子身上,那这件事大概率跟孩子有关;同时还要找出这个实体对应的历史信息——"这其实是一个非常像图的概念"。他举例说,某家产品的记忆系统就完全建立在图之上。他的结论是"怎么存记忆"到现在也没被解决,因为不同场景天然适合不同的存储和召回方式。
他随后给出两条他觉得有前途的探索。一条是让模型自己决定用什么基础设施、召回什么记忆,相当于把记忆的基础设施都训进模型里,让它做很激进的尝试;代价是探索成本可能很高,因为会拖慢响应。另一条来自某家公司的创始人:针对每一个提问,单独构建一个只服务这个提问的上下文。这条路的代价是打破了 KV Cache(大模型靠缓存前序对话来降成本,这条路等于每一轮都重建上下文),他把这称作"简化问题的一种绕路办法"。
潘乱接着问了一个更当下的问题:上一个星期各家都没发模型,讨论最多的就是那种输出结构固定、更快更便宜的决策模型;那你们是不是也该用类似能力去处理意图识别和任务路由。高策说意图识别某种意义上是要做的,但不能再用传统做法——在前面叠一个意图小模型,识别出你只是问天气就分发给一个小模型。那个做法的缺点会随着产品横向扩张越来越明显:意图越来越多,对应越来越多的模型和 Agent,前面最后能叠出几千个意图,工程上很难维护。他提到 Manus 在 2025 年 7 月发过一篇博客,讲一个"上下文感知的状态机",思路是当模型看起来要用浏览器时,直接把浏览器工具送到它嘴边,让它一定会调用;但他没讲实现细节。高策说这个方向对,只是过去的实现方式会让上下文在不同子模型之间被割裂,工程上是"挺灾难的东西"。至于 Today 自己,他说有一些探索,还在进行中。
四、主动篇:从推送一条消息,到替你办完一件事
玩笑之后是他真正的答案:现在最缺的是既了解 Agent 和 Harness、又了解模型的人。因为很多对 Harness 的优化,前提是你知道模型是怎么工作的;这两点都具备之后,最好还能懂一点产品。他把这一条放在一个更大的判断下面——2023 年 ChatGPT 刚出来的时候是"模型级产品",有模型就行;到了现在,像 Claude Code 这样的产品,Anthropic 完全是在靠 Harness、靠产品卖 token;在模型已经接近 AGI 的程度下,产品的价值只会越来越大。所以他希望的是一个人能把三件事串起来,端到端地做联合设计和优化。
潘乱顺势追问选型:模型能力和价格变化这么快,你们挑供应商看什么。高策的答案里有一组挺少见的具体评价——DeepSeek 在深度研究这一类子智能体任务上表现很好,而且"实在太快了,成本又低";Kimi 和 GLM 的大模型,Kimi K3 和 GLM 5.3 在长程任务上表现不错,甚至不输海外上一代模型;交互上坦白说大家都不太行;开源模型在"指令遵循"这一层通常差一些,比如你让它说话短一点,一般它不会短——因为这是训练出来的习惯,靠 system prompt 很难改回来,"它已经被训练成那样了,你很难在推理时再把它抢救回来"。这也是他主张应用公司要有自己产品能力的原因:模型智能再高,很多细微表现你不自己做就优化不了。
什么是好的主动
潘乱把话题拉回主动性本身:怎么让主动被用户接受、不至于变成骚扰。
Suki 用三类场景回答。第一类是信息获取上的主动:如果你之前跟它聊过很多上下文,它对你的兴趣有理解,它会主动去搜索,把相关信息推到你面前。第二类是主动做事的主动:它连了日历,知道你每天的安排,会在事件发生前的某个节点提醒你,或者提前把要准备的东西准备好,最典型的是会前准备。第三类她认为最"啊哈",是多类事件的交叉——她既在 Today 里管着健康数据,也管着工作数据,有一次它把两边合起来,直接建议她补充维生素 D,理由是她的工作时长太长、日照时间太短。她强调这类建议跟普通保健品页面不同:别的地方只会罗列功能,它是把两件本来不相干的事接起来,给出一个针对她的结论。
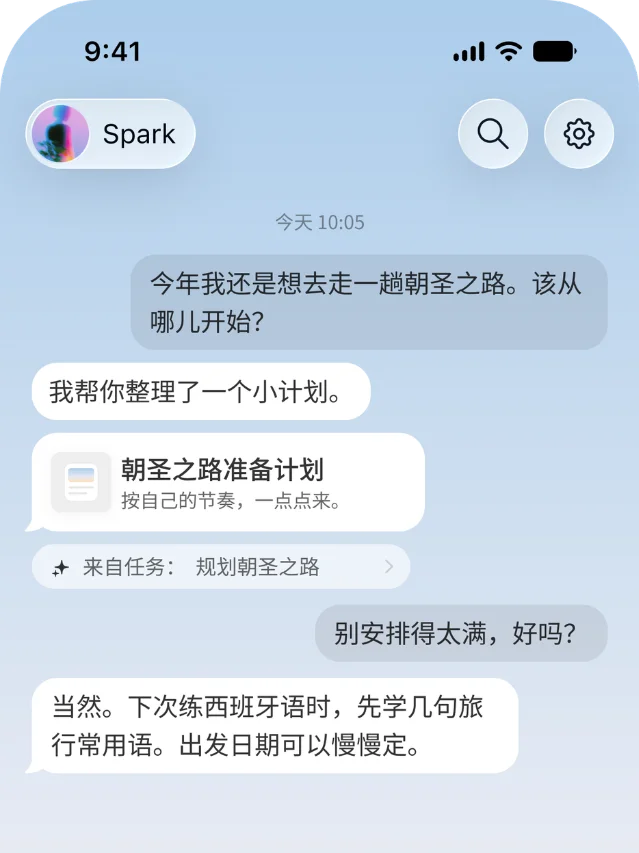
潘乱补充了他自己的使用变化:他一直在让它提高推送频率,现在它已经差不多像一个"AI 简报",还能把信息跟日常工作和日程结合,做针对性的曝光,另外就是重要事件提醒和任务推荐。他问,是不是每一种主动性都要单独优化。
高策说主动性是个开放问题,怎么做都会有正向收益,区别只在多和少。他把它归结成一个问题:在以最小的摩擦和信息干扰为前提,做出信息密度最高、最可能让你感兴趣的那条推送。围绕这个问题有两种路线:一种是你相信模型的泛化能力,认为只要把上下文给足它就能做好,这条路线适合自己训模型,甚至可以一个人一个模型,那样个人偏好的依从性最好——他举了美国一家公司给每个用户训一个模型、跑在一台昂贵机器上的做法;另一种是不完全依赖模型,用人类写下的判断规则去引导它,这就是产品经理的价值所在。他自己目前站在后者,理由有两条:模型的泛化性没有想象中那么强,以及从工程角度成本是不得不算的东西。他也诚实地说,自己的观点"一个礼拜会变一次"。
别只给我生成八条待办
潘乱抛出的问题带着一点吐槽:一场会开完,AI 总结完又生成八条待办,能不能干脆顺手把活干了;那些待办能不能直接变成任务,那些任务能不能自动跑。
高策说他认同这就是方向——它应该帮你做更多的事,最后你只需要批准结果,或者只需要核对结果对不对;尤其当 token 越来越便宜,就算它做错了,你拒绝掉也没有多少成本。但他加了一个前提:要保证这个执行没有副作用。他也解释了为什么现在做不到——这个场景拍脑袋想就知道会有挺多坏案例,比如那件事你本来就不关心,它替你做了,然后又来打扰你。
潘乱给出的是中间形态:你让我确认一下,我点一下,你再跑。高策说最终形态应该是连确认都不需要,因为让你确认本身就是一种打扰,"你做得足够好的情况下,就不需要你关心"。他把 Claude Code 和 Codex 的自动模式当作参照:工具会根据你过去批准权限的历史学习,判断什么样的命令你通常放行,下次就不再问。他说这一类优化既是工程的,也是产品的。
潘乱把这几个动作连成一条链——提醒、准备、确认、执行——并说 Agent 能不能跑完这个闭环,才是个人助理往下一阶段走的标志。高策同意,理由是执行才是最重要的事。他说现在绝大多数个人助理其实还停在信息获取:比如他会用它问最近有什么值得看的演唱会,它能根据自己的记忆列出来,甚至能查到哪些还有票;但"帮我抢票"这件事,才是他真正关心的。他也提到接下来要跟用户把边界谈清楚:哪些是低风险、可以直接做的,哪些是必须确认的。
少说废话,为什么要靠训练模型
最后一个小问题来自潘乱:当一个助理越来越像人,怎么让它少说废话。
高策说这个只能靠模型训练来解决。潘乱先给了自己的观察:模型普遍爱说废话,开源模型尤其明显,因为说废话是有好处的——"啊你真的太棒了""啊好的我错了",这些最省力最直白的话能帮它完成很多任务。高策解释了背后的机制:在需要推理的任务上,token 越多相当于思考时间越长,任务完成率大概率越高;但在个人助理这个场景里机制反过来——你说得越多,我的认知负担越重。所以好的聊天体验需要模型本身重视体验,海外已经有模型在往这个方向探索。他判断模型大概率能解决这个问题,只是现在个人助理连 PMF 都还没有,专门为这件事训一个模型划不来,所以它更可能是个短期问题。
关于隐私,高策给了一段比较具体的说明:接入大量上下文之后,怎么保证不侵犯隐私是必须回答的问题。Today 现在的设计是用户可以删除记忆里的任何内容和任何文件,记忆对用户完全透明,能看到记了什么;记录过程中会明确告诉用户正在记录哪些内容;注销账号或不再使用时可以选择把记忆全部清空。
五、竞争篇:大厂会来,创业公司靠什么留下
潘乱用一段有点感慨的话开场:现在连 PMF 都还没有,但资本、资源、大厂已经全部涌过来;这场竞争才刚刚开始,今天看起来最狂热的部分,几年后回看可能还不够狂野。
高策接着谈格局。他说这个赛道里目前唯一真正占到优势的是 Muse,而 Muse 最大的优势是有钱。潘乱追问得更具体:Muse 给每个用户配了 24 小时在线的云端电脑,你们扛得住吗?高策的回答很干脆:"顶不住,肯定顶不住。"他指出 Muse 的架构成本非常高——它把 Agent 放在沙箱里跑,只要用户在用,那台电脑就一直在那边运行。潘乱补充说,这类实现就算做超卖、不给物理机,成本依然高,但换来的是隔离性:服务这个用户的进程就只服务他一个人,多租户的复杂度都不用考虑。高策承认这种架构可能换来更快的迭代速度,而从 Meta 的角度看,收益比成本更重要——所以 Meta 现在看起来增长和口碑都非常好。但他认为创业公司不该学 Meta,该学 Town,因为"现在变化太快了,大家都在做中学"。
潘乱在这里给了一个有点刺的观察:Town 已经不是优等生了,今天大家只看 Instinct 和 Muse,很少有人讨论 Town,尽管它产品完成度最高。高策由此说出这一节最完整的一段判断:短时间大家确实高估了这个领域,长时间它又可能是被低估的;短时间被高估得很厉害,是因为像 Instinct 这样的产品,在还没什么用户的阶段就拿到了极高的估值和关注,但长期来看市场最后都会回归理性,而那时真正的问题是商业模式怎么选——现在这件事根本还没定。
他把 Town 的路径当作创业公司的参考:卖订阅,从一个具体的连接器切入(邮件),把那个场景优化到付费意愿很强,本质上是用一个工具类产品的付费转化方式在滚雪球。这条路的代价是它不像"通用个人助理"那样容易讲给投资人听,潘乱直接点破了这一点,高策也承认这就是取舍。但他个人的偏好很清楚:因为自己之前创业做的是确定性更强的事,他会更偏好 Town 这种公司——在真实地做事情、场景扎实、付费转化不错、一步一步能滚起来。与此同时,他也承认自己被这个市场教育出了另一套观点:这个领域本身就很大,所以应该超前投入、融非常多的钱、先别管 PMF、疯狂扩张。潘乱接着打趣说这不就是字节的方法论——先算未来市场有多大,然后用未来的假设投今天,把竞争全部消耗死;高策笑着说"我以前也没做过这种事情,我只是现在还在学习"。
广度与深度,两条创业路线
Suki 接过去讲了两条打法的差异。
广度打法让她想到 Notion:当年 Notion 做文档产品时提出了一个所有人一开始都理解不了的概念——Block,但这个积木式的基本单元通用性极强,有点像今天给 Agent 提供的各种底层能力;Notion 当时不定义场景,让用户自己玩起来,再由用户帮团队发现需求;第二是让使用者把用法变成传播手段,靠关键意见领袖和社区互相启发;第三是在社区里积累模板,把第二次传播的门槛降下来——她记得当年 Notion 的中国区负责人搞了一万多个模板让用户直接复制。她说这套玩法需要资源、时间和非常多的成本去铺开,才有可能让规模效应转起来;而且放到个人助理上不一定成立,因为每个人的需求太个性化,一键套模板这件事可能根本立不住。
深度打法则像 Town:先找到一个非常高频率的场景,把用户最在意的事情做透,把那个场景里最大的门槛先解决掉,再靠一个非常核心的人群往外扩。高策补充了他喜欢的两款产品——Town 和 Slack 上的一个助理类产品——共同点是它们都"过拟合"在自己想支持的那个软件的工作流里:前者把草稿直接写进你的 Gmail 草稿箱,你甚至不用进它的面板;后者的记忆被设计成频道级和话题级,整套系统长在 Slack 里面。共同的好处是摩擦成本极低,因为你不用离开原本的工作界面。
潘乱随即把这个选择摆到高策面前:健康、理财、学习这些垂类各自有清楚的需求和专业边界,做单一垂类看起来更容易让用户理解,也更容易验证价值,但你们偏偏做横向的。高策的回答是,从通用往垂类做,比从垂类往通用做更好,而且 Town 其实也是个通用产品——它也能在 WhatsApp 里用,也有不同的入口,只是找到了邮件这个杀手级功能。他认为反过来很危险:从一个真正的垂类出发做单一助理,很容易过拟合,最后扩不到别的人群去。潘乱补了一句移动互联网时代的参照——那些垂直社区、垂直电商,一个都没留下来。高策说,因为个人助理一定是入口级别的东西,一旦成为这个领域最重要的玩家,你会吃掉大量邻近领域的产品、机会和市场;而且上下文越多、覆盖的场景越多样,它们之间越会产生化学反应——健康是高度差异化的上下文,工作也是,这两个之间能发生的事,只有在通用这一层才看得见,只做健康就永远看不到工作那一半。
有什么小事,能让用户先用起来
最后一个问题,潘乱问 Suki:今天一个新用户来了,一周之内,哪三件事最容易让他觉得这东西真的有用。
Suki 举的是三件很小的事:让 Today 帮你约人(她说自己在 Today 里的用法就是"下午几点、约谁");和同事的协同沟通,开着录音跟他们聊完,直接让 Today 带着上下文分发给所有人;以及她最看重的长期事情。她说这些事过去她不会交给通用 Agent 去做——"我绝对不可能让别的 Agent 去帮我约人"——原因是 Today 这套记忆和主动性的设计让"委托成本"低于她自己去完成这些不起眼小事的成本;一旦低于这条线,过去因为要费太多口舌而懒得交代给 AI 的事,就都可以交出去了。
她由此讲到第二类最适合个人助理的场景:有长期目标、需要长期跟踪的事情,比如学习和健身。这类事情的形态和"发一个任务、交一个 PPT 就结束"完全不同——她拿学外语举例:她会先跟它讲明学习目标和当前进度,它会记住,并结合她现在的状态制定一个很长的学习计划,自己设定许多定时任务,做出针对她一个人的课程;她工作忙、进度落后了,它会把日程调松散一点;她最近兴趣转向别的领域,它会换课程。她说这类需要持续个性化反馈和长周期跟踪的体验,会明显好过通用 Agent。
高策给出的则是他对普通用户的判断。他说如果这类产品能像一个更好用的 OpenClaw 那样真正触达普通人、让使用的摩擦成本足够低,那绝大多数正用着聊天机器人的人去用 Agent 产品并感受到价值,是非常自然的事情——这也是 Muse 受到好评的原因;而在早期用户眼里,他们可能觉得"我自己搭一个 OpenClaw 也能用,甚至用 Grok Bot 更好",因为这是两个很不一样的群体,中间还隔着一道鸿沟。他还说个人助理这个品类有点被催熟了:它还没进入大众市场,资本市场已经很热,在开发者和早期大众里已经很热。他把自己代入普通用户做了一次假设:进来之后它很快推送我感兴趣的演唱会和插画节,能用对我的了解主动跟我聊起来,聊天体验又比其他聊天机器人更像人,如果价格不离谱、甚至像 Muse 那样免费,"那一定是一个有正向价值的产品"。
节目最后,潘乱把问题交给了两个人自己:希望用户用一段时间之后,怎么描述 Today。
Suki 说她很喜欢团队之前想过的一句 slogan——"Today is your day"。她希望 Today 不是又一个制造 AI 焦虑的产品,而是一个会主动认识你、理解你的朋友。高策的说法更像一句产品边界:他希望被记住的是,这个世界上有一款产品,它的存在是为了降低对你注意力的干扰,而不是又一个为了给你推送更多内容和消息而存在的产品;希望有一天人们提起它时会说,这个东西让我有了更多时间去生活、去散步、去踢球——而不是"用了它之后我的工作效率又变高了,我可以做更多的工作了"。
术语表
- Personal Agent / Personal AI:本期指长期围绕同一个人工作的助理型产品,与围绕单个任务组织上下文的通用 Agent 相对。Suki 给的定义是"它是你的一个朋友,而不是另外一个工具"。
- Memory(记忆):产品长期积累的对你的了解。高策强调目标不是一份静态档案,而是"正确并且 live"的画像,"live"指它会随新信息即时更新。
- Proactive(主动性):产品不等你开口就出现的能力。节目把它拆成信息获取的主动、做事的主动,以及多类事件交叉的主动。
- Context(上下文):Agent 能拿到的关于你的原始信息,包括邮件、日历、笔记、文件、录音、手机里的历史。高策的重点在于"上下文利用率"——拿到不算数,能用出多少才算数。
- Harness:模型外面那一层负责组织上下文、调用工具、检查进度的系统。模型由厂商提供,Harness 是产品自己写的,也因此被认为是应用公司真正的壁垒所在。
- 委托成本:Suki 用来划定产品边界的词——你为了把一件事交代清楚要付出的上下文和口舌。她的判断是个人助理真正的对立面是这个成本。
- 身份消解(identity resolution):判断一句话说的是谁。潘乱举的例子是"小孩发烧了怎么办"和"父母血压升高了怎么办"都没有点明主体,系统要自己分清。
- KV Cache:大模型把前序对话的计算结果缓存下来以降低成本。节目里出现的"为每个提问重建上下文"的方案,代价就是打破这份缓存。
- Sub-agents(子智能体):把一件事拆给多个下层智能体分头执行。高策用"五层子智能体处理一封邮件"来说明 Town 在邮件场景上做得有多重。
- Cloud Computer(云端电脑):给 Agent 配的一台 24 小时在线的远端机器,可以打开浏览器、处理文件、运行代码。Meta 的 Muse 以它为主要卖点之一8。
- PMF(product-market fit,产品市场契合):产品与市场需求匹配的状态。高策的判断是这个方向目前还没有。
- TAM(total addressable market,潜在市场总量):一个方向最终能覆盖的市场规模。Suki 用这个词解释当年为什么没在 Monica 上做个人助理。
人物背景与关键事实
Today:齐俊元创办的个人 AI 助理产品,运营主体为此间无限(上海)智能科技有限公司,2026 年 3 月成立,注册资本 1000 万美元29。公开记录里的时间线是:2026 年 3 月完成天使轮,投资方包括阶跃星辰与 IDG 资本;7 月进入内测,当时已有 Mac、iOS 和安卓版本;9 月 24 日中国版正式上线9。产品对外披露的结构是几块拼起来的:记忆负责记住用户,主动性负责捕捉动态,连接器把外部应用接进来,任务执行和云端电脑负责把事做完10。官网给中国版的说明是基础版永久免费、新用户注册领 1 亿 token 与一个月 Pro 权益5。
齐俊元:Today 创始人。1990 年代出生,上海交通大学信息管理系毕业。2011 年大三期间推出团队协作工具 Teambition,2016 年获得腾讯战略投资,2019 年被阿里巴巴以 1 亿美元收购并成为钉钉的管理模块;此后他加入阿里担任阿里云盘负责人,主导该产品在 2021 年上线;2023 年 1 月进入字节跳动任飞书产品副总裁,2024 年转岗到字节 AI 部门 Flow 负责豆包 PC 端;2025 年 11 月 6 日离职2。他在 2014 年就买下了 today.ai 这个域名,当时的设想是一个能替你记住一天所有事、并在合适的时候提醒你的产品4。本期节目里他没有出场,高策讲的"有个投资人在 Today 里把名字填成齐俊元"是当场的一个玩笑。
高策:Today 技术负责人,第三方访问中也被称为联合创始人4。节目里潘乱确认了他此前创业做的是模型基础设施和向量数据库,他在节目里自述 2026 年 2 月以前一直在手写代码,因为做的是偏底层的基础设施。他解释自己转向个人助理的原因,是今年 2 月某次模型发布让他觉得智能出现跃升。
Suki(本期嘉宾):Today 的 founding member,负责产品设计与市场。她在节目里讲了自己的来路——早年是设计师,参与过语雀,2023 年底到 2024 年初加入做 Monica 的团队(Monica 是 Manus 的前身),之后自己独立创业做过产品。
潘乱:本期主播,《乱翻书》主理人,科技评论作者,写过《腾讯没有梦想》与字节跳动、快手早期关键节点的系列特写1。
季逸超(Peak):高策在节目里说要"请过来"的人。他是 Manus 的联合创始人兼首席科学家,英文名 Peak Ji67。节目里还提到 Manus 在 2025 年 7 月发布过一篇关于"上下文感知状态机"的博客。
节目里被当作参照的其他产品:
- Town:以邮件为核心场景的个人助理,被高策当作"从通用需求出发、把单一场景做深"的样本,他给出的付费转化数据是 15%。上一期《乱翻书》已经详细拆解过它3。
- Instinct:住在短信与即时通讯里的个人助理。潘乱在节目里给的刻度是不到 10 万用户、半年估值从 5000 万美元到 100 亿美元;高策提到它在推特上被逆向出了记忆系统,其中有一条专门的时间轴设计3。
- Meta Muse:Meta 2026 年 9 月 8 日发布的免费个人 AI 助理,主打一台 24 小时在线的云端电脑,并为浏览器操作等任务自训了 Muse Spark 1.3 模型8。发布不到十天它登上美国 App Store 免费榜第一11。
- Grok Bot:以多角色 Agent 为设计的产品,有一个"幕僚长"统筹,下面可以创建不同角色的 Agent。
- OpenClaw:开源 Agent 项目,中文社区称"小龙虾",要求使用者自行搭建与配置环境,因此上手门槛高。
- 千问:阿里巴巴的 AI 助手。2026 年 9 月 22 日的云栖大会上,千问宣布加速打造 Personal Agent,为 3 亿用户提供持续、个性化的智能服务12。
- 豆包:字节跳动的 AI 助手。节目录制时它还没有正式推出同类能力,潘乱与高策都把它当作"很快就会来"的对手。
把节目里的说法与公开资料放在一起看
哪些数字只有节目里有。 本期出现的不少具体刻度出自两位嘉宾之口,节目没有给出外部出处:Town 的付费转化 15%、Instinct 不到 10 万用户对应百亿美元估值、Today 从 2025 年 10 月有想法到 2026 年 4 月内测的时间线、以及"国内第一个做 Personal AI 的团队"这个自我定位。这些内容按原话保留,读的时候应当作为产品团队的判断而不是行业统计。能对上的部分在后面几节里列出。
上市时间对得上,但口径要说清。 节目在录制当天说 Today 中国版"今天"上线;官方单集页写的是 9 月 24 日下午 18:00 在国内首发1。量子位在 9 月 24 日发布的报道同样称当天正式发布10。
"联合创始人"这个头衔有两个来源。 官方单集页把高策标为"Today 技术负责人"1;2026 年 9 月 22 日一篇到访 Today 办公室的访问里,他被称作联合创始人4。公开资料里没有找到公司层面的工商记录印证,所以正文按官方单集页的写法称他为技术负责人。
模型与产品的引用需要留一分。 高策提到的模型名称、以及某家公司"给每个人训一个模型"的做法,都是他口头给出的例子,节目没有展开企业名之外的细节,本文按他的原话转述,没有另找来源交叉验证。他提到的 Instinct 记忆系统被逆向一事,指的是推特上流传的分析文章,同样属于节目转述。
关于 Muse 的两处描述可以对照官方材料。 节目里说 Muse 的架构是"Agent in the Sandbox"、只要有用户在用那台电脑就一直跑着,成本很高。Meta 官方发布稿确实以"24 小时在线的云端电脑"为核心卖点,并为浏览器操作等任务训练了 Muse Spark 模型8;但"架构成本高、有缺陷"是节目嘉宾的判断,官方材料不会这样描述。
上一次谈 Today 是在一场圆桌上。 第 275 期(2026 年 9 月 21 日发布)里,Suki 已经以 Today 产品经理的身份讲过一些用法,包括让 Today 把同事编进外语课程、以及让 Agent 直接把约饭排进日历3。本期是围绕 Today 的独立单集,两个人的角色不同——高策第一次公开讲记忆系统、主动性设计和模型选型这些内部方案。
完整中文逐字转录稿
声明:本逐字转录稿基于《乱翻书》第 277 期在小宇宙发布的官方完整音频(时长 5981 秒,1 小时 39 分 41 秒)自动识别生成,原始文字未作删减。识别退化的片段已剔除并在本段列明;人名同音误写按上下文统一,公司与产品名、技术术语按通行写法统一(Today、乱翻书、Town、Instinct、Meta Muse、Grok Bot、OpenClaw、Manus、Monica、Notion、Slack、Codex、Claude Code、DeepSeek、Kimi、GLM、Perplexity、WorkBuddy、钉钉、飞书、企微、豆包、千问、元宝;以及 Memory、Proactive、Context、Harness、Token、KV Cache、Sub-agents、TAM、PMF、Scaling Law、Bench、Delta)。讲话人归属依据两条判据:开场自我介绍(潘乱自报「Hello 欢迎来到乱翻书,我是潘乱」,Suki 与高策接着各自报出姓名)与对话结构逐段核对——提问、串场与片尾收束属于潘乱,讲记忆系统、主动性与模型选型的属于高策,讲从 Monica 到 Today 的产品判断与长期使用体验的属于 Suki。机器声纹在「主持人提问+嘉宾回答」粘连处会串位,本轮按内容判据逐段核对并改判了 14 处,极短的现场应答仍可能标错。被剔除的片段共 14 处:三处内容为「请不吝点赞 订阅 转发 打赏支持明镜与点点栏目」的识别幻听串、一处无意义碎片、两处空块、一处只识别出「广告」两字并落在静音区的碎片,以及七处把固定信息复读成串的退化块(落在音频末尾的静音区)。
00:00 - 00:10
潘乱:
20 多年前我们想象电脑能够替人思考,今天有人开始做能记住你主动替你办事的 AI 助理。Hello 欢迎来到乱翻书,我是潘乱。今年 AI 圈都在养小龙虾从年初开始,搭模型、配工具、指挥一群 Agent 的干活。他能力是强了,但是普通人光是把他养起来就得先学一套新本事。所以很多人一直都在去做尝试,能不能把这个事情做得更加简单,就是不用配置,打开就能用,他能记住你,也会动来找你,最后真的替你把事情办完。今天我们要聊的 Today 是中国第一个正式上线的 Personal Agent 产品。海外已经有 Instinct、Town、Muse 我们在上一期已经讲述了在海外这个市场到底有多火爆多疯狂。国内像是千问、豆包等等这些大公司,包括元宝吧应该也都会往这个方向去走。那么 Today 为什么选择在今天正式上线的一个刚起步的产品?凭什么让用户愿意把邮件日程甚至生活里面的琐事都交给他?当他变得越来越懂你,又怎么知道什么时候该帮忙,什么时候该闭嘴呢?我今天来到了上海,跟 Today 团队的两位同学一起聊一聊。我们先从几个快问快答开始吧。诶,两位先做一个简单的自我介绍,Suki。
Suki:
大家好,我是 Suki。我现在在 Today 是 Today 的 Founding Member 主要负责产品设计和市场的一些相关的东西。
高策:
大家好,我是高策,现在在 Today 负责技术方面的工作,然后现在在跟 Suki 一起来做 Today AI 这样一款 Personal Agent 产品。
潘乱:
诶,那什么叫 Personal Agent 啊?用普通话翻译一下。
Suki:
Personal Agent 如果用一句话来解释的话,它其实是你的一个朋友而不是另外一个工具。它会主动来认识你,主动帮你解决生活中的小事。
潘乱:
OK,那 Today 这个项目是从什么时候开始立项的呢?今天是正式上线?
Suki:
我们差不多去年 10 月份的时候开始有这个想法,然后 2 月份开始组建团队,4 月份开始内测,然后我们可能是国内第一个做 Personal AI 的团队。
潘乱:
为什么说你们是第一个?
Suki:
一个从时间线来说我们确实可能是最早的一批,然后另外一个的话我觉得从产品完成度来说的话我们希望我们是第一个。
潘乱:
那 Today 这个产品特点是什么呢?虽然说你们是第一个,但今天明显是我们从硅谷开始看 Instinct、Muse、然后再看国内应该很快千问豆包、元宝都会转过来,马上会有无数个,你们凭什么让人记住呢?特点是什么?
Suki:
我们特别想强调的两个特点,一个特点是我们是一个有记忆的 AI,就是它能记住你,另外一个它是能主动做事的 AI,然后这是我们两个非常想强调的特点,Memory and Proactive。
潘乱:
那今天用户第一次打开你会建议他做什么呢?就是一个新用户第一次使用特点。
Suki:
我觉得其实大家不用带着非常 FOMO 或者非常惧怕的东西去学习一个新的工具,它不是让你学习的,而是你把它当做一个你在酒吧认识的一个新朋友一样,然后你怎么和新朋友去打交道,你就怎么去和 Today 打交道,它会主动去了解你。
潘乱:
OK,高策,最近感受怎么样?就是在过去一周,你像 Instinct 的,就是这个怎么说,不到 10 万用户,人家可是半年时间估值从 5,000 万美金涨到了 100 亿美金。然后你看那个 Meta 发布 Muse 也登顶了,就是你们从 2 月份到现在看到市场突然间一片大壕,从你们独自探索到突然间变成市场故事,什么感受?
高策:
我自己的感受,这其实是我感觉整个 AI 领域一个非常常见的一个模式。就是当一个领域被一家公司看到以及开始做的时候,很快其他家都会看到这个领域的机会和挑战,然后大家都会很快用进来。我们看最早从 Coding 开始,那个时候有 GitHub Copilot 然后有 Cursor 然后慢慢有了越来越多的玩家,像 Devin 。再到后来像 Work,从今年初开始其实只有非常少的公司,像 Claude Cowork、Anthropic 它可能是做的比较前面的,但是很快像 Wobbity 或者是像我们的 Codex 都在跟进,就是说其实在场景上或者在需求上,AI 在应用层面达成共识的速度是非常非常快的,包括我们看 Instinct 它其实在推出来的时候也就是这两个月。那 Muse 其实也是在今年年初就开始开发了,它也花了大半年的时间,而且 Muse 其实非常多的时间其实花在如何解决隐私问题这件事情上。其实大家的产品功能都在相同或者相近的时间点 ready 了,也就是说大家其实在看到这个机会的时候已经是一个几乎相同的时间看到这个机会并且开始开发。
潘乱:
诶,那我可不可以把这个机会给他简单总结一下,就是其实大家看到的机会是一个共同的机会,就是给每个人,普通人都做一个他方便使用的小龙虾,这种感受。
高策:
是的,包括我们看 Muse 在海外的 Twitter 上,其实大家都一个非常共性的感受是说,它就是一个 Better 的、更好使用的 OpenClaw。OpenClaw 其实它给所有的产品一个很大的启发是,Agent 的长程能力已经能够让你在除了 Coding 以外的非常多的领域有所受益了。但它的问题是,它的 Self-host 是非常非常困难的,同时它的产品体验是差的。其实 Muse 像 Meta 看到的机会,包括 Instinct 包括我们看到的机会,其实都是说它没有办法以一个非常好的产品体验交付给你的用户,用户又需要这样一个东西。所以从这个意义上来讲,可能确实它就是一个 Better 的 OpenClaw。
潘乱:
我记得你们是去年 10 月份在谋划这件事情,当时还没有小龙虾,等到你们正式组队的时候其实刚好碰上小龙虾,所以其实也是这个事情相当于影响了所有人的节奏。是的。
Suki:
是的,其实我们一开始的时候我们就觉得 AI 不应该仅仅只是一个就是带用户去发起的工具,它会更像是比如说影视剧里面的贺一样,然后它会主动来找你,更像一个数字生命,只不过 OpenClaw 把这件事情推向了一个所有人都能看见的一个窗口。
潘乱:
诶,那现在呢?所有人都看见了,你们是这种是无道不顾这个欣慰,还是那个窗口来了所有人都来了,必须得跑得快一点。现在团队是什么样感受?
高策:
我觉得是首先其实我们已经有很明确的预期是这个领域一定是一个 TAM 非常高就潜在市场规模非常大的一个市场。不管是在美国还是在其他的国家的地区的市场里面其实都是有非常大的空间和机会的。所以从这个角度来讲我们一方面是感觉像 Instinct、像 Muse、包括像 Today 这样的产品是给大家了一个新的探索和尝试。它其实只是刚刚开始,未来我们应该有更大的...其实我们看 AI 其实一共就完成两件事情,一件事情是尽可能激进地获取你的上下文,另外一件事情是获得你上下文之后做更好的执行。现在其实大家在这个探索的过程中有发现一些在执行上能带给你啪哈的地方,但是现在的能达成的任务包括能帮你做的事情其实还是远远不够的。所以我相信这个市场的增长是非常非常快的,所以应该对我们来说更多是一个鼓励吧,让我们认可这个产品的价值以及这个市场的价值。
潘乱:
哪怕现在他 10 万用户就已经百亿美金的估值,你依然觉得这个市场不是这个市场被高估了,因为市场更大的市场其实还没有展示在所有人面前。对,是的。
Suki:
我觉得肯定是的,就是包括现在其实我们行业内有一种说法,就感觉大家会在圈子里面自嗨,实际上如果放到普通人生活里面,其实 AI 远远没有普及到所有人的程度,所以我们觉得 Personal AI 有可能就是一个跨越鸿沟的一个产物,就是能把 Power User 走向普通人的一个产品。
潘乱:
OK,那你们这个产品为什么会在今天这个时间点正式在国区上线呢?
高策:
首先就是我们看整个 Personal Agent 的市场格局里面,美区已经看到了像 Muse 这样的产品,它占据了非常好的市场口碑以及获得了非常多的关注,包括在 Muse 之前发布的 Instinct,然后 Instinct 其实在发布的过程中甚至没有做 Billing。通过内测、通过邀请码的方式去 go to market 但是也不影响它的增长,包括它的 traction 是非常非常好的。这个其实给了我们一些经验。我们认为在国区发或者是能尽早发布这件事情是非常重要的,也是从海外的发布情况来观察到的一个,其实是一个核心观察。因为是说这其实是你的产品的完备程度跟你这个提前发布 go to market 之间的一个 trade off。之前我们的我们的观点是说这个东西其实还没有那么快达成共识,它还是可以有一个相对长的非共识期,因为在这个领域里面它有很多问题。首先是它的付费意愿一定是我觉得包括 Muse 还有 Instinct 其实大家都没有 PMF。因为大家都还是在探索,真正用它的人其实只是很少一部分,并且这些人其实很偏 early adopter,他们是非常喜欢探索,非常喜欢尝鲜的,就像潘老师这样的人。但是实际上还有非常多的人,他们其实还没有享受到这个东西带来的红利,以及它带来的体验的提升。所以在这样一个过程里面,很明显提前发布能带给我们的好处是能够更多的去看到更多的场景。我们之前会很担心说这个东西还没有被打磨的很好,还有很多可以提升的空间。因为确实从执行的角度来言,不管是 Muse 还是 Instinct,大家的执行或者说通常意义说的朴素意义上的任务完成率其实还没有很高。但是我们又看到它其实已经是一个非常可用以及能带来非常好的 AHA Moment 的一个产品。这也是 Today 我们在那次的时候遇到,其实我们自己觉得自己的产品可能还有很多空间,但是我们的用户已经觉得哇,这是一个挺好用的东西。所以我们感觉应该在这个时候让我们的产品能够在国区被更多的人去享受到,然后体会到它能带给你的生活的一些正向的体验,然后也能帮助我们去更好的迭代我们的产品。所以从对海外市场的观察的角度,还是说从我们产品迭代的角度来讲,现在已经对我们来说是一个相对 Ready 的程度,相对准备充分的程度,可以发到更多的区域,包括美区还有国区。
00:10 - 00:20
潘乱:
这其实背后是因为 Agent 能力,他在过去这两年的时间里面在很快的成长。就类似于比如说 Suki,你之前在 Monica,Monica 其实就是 Manus 的前生嘛。你做过产品,然后你自己也做过独立的产品开发,然后今天到 Today。在你的观察里面,这两年里面对什么是好的 Agent 产品理解有没有什么变化?或者说在你的观察里面,今天的 Agent 能力相较于去年初 Manus 引起那么大广泛关注的时候,又有了哪些的进步呢?
Suki:
好问题,其实我们想做个人助理这件事情在 Monica 的时候就已经发生了。我记得我当时跟肖弘说,就是 Monica 她当时是一个插件产品,插件它本身是安装是有很大的门槛的,所以她 TAN 注定可能不会非常的高。所以我跟肖弘就在讨论说我们下一个产品可能要往哪个方向去做。当时就在想说我们可能想去做一个个人助理。为什么呢?是因为过去其实比如说只有董事会的人或者是像总裁这样的人,他才能配一个助理这样的角色在他身边。但实际上可能每个人生活中都有一堆的琐事。比如说肖弘的助理能够帮她订机票,而且她理解肖弘她其实想订在那个比如说机票坐在靠窗的位置。然后像这样子贴心的助理其实几乎每个人都有需求,所以这种用户市场上面的需求我们是一直非常坚信的。只不过当时 Monica 没有做的原因是其实当时的技术水平还远远达不到现在这个程度。但是我们后来回过来想,Monica 其实能成的一个非常重要的一个点,就是插件是一个非常好的形态,它直接住在了用户的意图和执行发生的那个点上。就是用户打开一个网页,它一定会产生某个意图,然后插件刚好就把这个意图直接递到用户的执行成本极低。其实 Today 今天也在做这件事情,我要去缩短用户意图到执行的中间的距离。只不过 Today 今天交出来的解决方案是我记忆能做得更好,我能理解你这个人。然后这个也是因为我们其实一直在关注业内的技术发展,然后比如说 RSI 然后这种自进化能力,然后长程任务的能力,然后还有各种比如说双工语言模型等等这种东西我们一直在关注。但是我们发现过去一年里面,Memory 相关的论文其实数量产生了非常多,也就是说这个方向业界其实一直在突破,有非常多团队一直在把这个技术做得更加深入。所以我们觉得做产品的话你不能过于超前,你不能站在一个非常遥远的未来去做产品,有可能就成了那个先烈,你反而是要站在一个技术成熟度的前页去做产品,那我们笃定的方向就是 Memory。
潘乱:
OK,那高策呢?你之前创业,对吧?联营创业,然后做模型基础设施、限量数据库这一块,是吗?
高策:
嗯,对,是的,是的。
潘乱:
哎,那怎么想起来要来做一个 Personal Agent 这样的一个产品呢?以及就是你加入 Today 之后,你需要解决的问题什么的?就因为你想想,今天,就比如说在 Suki 的描述里面,模型的能力就是越来越强。工具调用与任务执行框架也在不断迭代。在今天,个人想要真正的把 Agent 能力用起来,最缺的是什么?还是技术能力?还是什么?
高策:
非常好的问题。首先,我自己对于这个领域非常认可的很重要的一个原因是在 26 年,就在今年 2 月份的时候,那个时候应该是 Opus 发了新的模型。我之前的工作一直以来,其实一直到 26 年 2 月以前都是手写代码的。因为我之前的工作领域可能比较偏底层的基础设施多一点,然后那个代码的复杂度包括对于智能的要求可能相对高。在今年以前其实我都很难相信 AI 能把它写好,所以其实之前我对 AI 其实相对没有那么乐观。虽然 coding 发展很快,但是我其实还是不是完全信任的,但是一直到了 2 月份,我会发现模型的智能是有一个跃升的感觉。甚至我现在感觉模型已经到了 AGI 的水平了。在我之前我自己要手写代码的领域,它完全没有任何问题,能把我做的工作更好地完成。所以这给我非常大的震撼,就让我感觉 Coding 这个领域,当然我很相信模型在 Coding 上还能以每年十倍八倍的速度再去提升,但是它已经能够到达一个非常非常好的水平,甚至已经是 AGI 了。它只是唯一需要在乎的是它成本的问题,它 Cost 的问题。所以,到了这样一个阶段的时候,我相信模型已经不再成为你的 bottleneck,它并不是因为它智能达不到,导致它做不了很多东西。而是说你怎么样能够,首先你要相信模型的成本降低也是一个遵循 Skilling Law 的一个过程,每年 Cost 降低 10 倍也是没有问题的。在这样的假设的前提下,我们去想想,比如说一年后或者两年后,你有一个非常廉价的,像普通人类甚至比普通人类更强的这样一个智能,能够在你手机上去使用,那是一个什么样的体验?那是非常不一样的。包括我们再往后想,未来是不是当你去使用 AI 的时候,我们现在消费的内容都是人类提前生产出来的内容,比如说我们刷抖音。我们看到的内容是用户生成出来的,用户他创造出来的短视频,那是人类精心设计的。但是如果 AI 发展的速度像现在这样,过去个三五年,是不是可以当你去需要消费内容的时候,AI 是 on demand 创造出你可能会想要去消费的内容,我觉得这个是很有可能发生的。未来 Personal 的一个人在生活中的所有需求都可能是被按需的创造出来,而不一定是像现在这样需要一个提前生产,利用这些提前生产出来的 UGC 内容,然后再去做很好的 Distribution。这是完全不同的两种 Pattern。
潘乱:
我要我有吗?我们看今天互动引游的发展其实也是有点在应征着你说的这个点。那现在几个月之下你们对于用户和需求场景这类的有什么新的认识吗?毕竟内测也好几个月了。
高策:
对,从需求上来讲,其实我们看到不管是 Instinct 还是 Town,其实大家都想从通用往 niche 去泛化。那这个是跟上一代产品很不一样的地方。上一代产品比如说我们看比较便宜的像 Glean 或者是 Otter.ai,其实大家都是在一个 niche 的场景出发。比如说 Glean 是从 Enterprise Search 开始,然后 Otter 是从录音开始,然后慢慢再泛化的往上泛化去做 Context Layer。但是我们看到 Personal Agent 的这个场景很不一样的一个地方是,大家是先从需求出发,先从通用的需求出发。这个需求在 Town 上可能是 E-mail,然后在 Instinct 上面可能是比如说帮你打电话,帮你订票,帮你购物。然后这个需求本身其实是没有面向一个具体的人群的,它其实是面向需求本身,那这个需求本身有很好的泛化性。它能够比如说在 Town 上面如果你邮件处理得很好,它可以让需要处理邮件的父母,因为他要处理跟女儿、跟儿子学校里面的很多沟通的问题,尤其在美国。那在 Parents 这个场景,他可能有很好的泛化。然后另外就是在 Founders 这个群体里面,他可能有很好的泛化。在今天 Today 看到的场景里面,其实跟 Town 或者是 Instinct 这样的产品看到的是非常类似的。在比如说在邮件这个场景我们能够让 founder 或者是能够让一些非常繁忙的高竞职的轻度工作场景的用户能够感受到价值。那他们的价值往往是体现在他的日程非常繁忙,我要帮他去安排他每天的行程,让他来了一个新的会议的时候能够智能的去告诉他这个会议跟别的会议有没有重叠,然后以及其实哪怕是在国内其实也是能看到的。而且邮件这个场景的从产品指标来看,这个群体的留存或者各方面都是非常好的。所以其实我们也能看到一些通用的需求之下的几个泛化的几个相对逆迟的场景或者人群。对,这个是我们现在在做的事情。
潘乱:
但是我看就不管是你们的内存户,因为我也一直在使用 Today 嘛,然后再包括我看 Town、Instinct、Muse,就是他们在最初他们内测这个阶段,他们到目前依然是处在内测阶段哈。他们的用户我感觉都是那些特别忙的,典型用户画像感觉都是那些 VCR,都是那些金融从业者,就是那些时间特别值钱的人,然后他们希望省钱,就是希望把自己从那些琐事里面让自己超脱出来。
00:20 - 00:30
高策:
那你们为什么就是又要把产品的对象面向更多普通人呢?因为 AI 它一开始要付钱的嘛,你要付出自己的成本。是。我觉得这个是跟你进入这个市场的情况有关,因为首先虽然现在模型已经到了 AGI 了,在我看来,但是它成本确实摆在那儿,然后你成本摆在那儿的前提下,还有一个问题是,现在 Personal Agent 很重要一个前提是,你要有足够多的赛博世界里面的数字资产,你才能够享受到它给你带来的收益。比方说假设你是一个平时不用邮件处理任何事情的人,或者你在互联网上没有留下非常多的足迹以及 Context。我是没有办法通过一个非常便捷、非常快速的方式去深入的了解你在这个世界上的 Profile 是什么样子的,你的需求是什么,然后我帮你去做很好的执行。如果没有你的 Context,我需要你一点一点告诉我。这个上手的门槛是非常高的,只有在赛博世界里面,他的数字资产非常多的这样一个群体,他反而能够更快的去把 Personal Agent 使用起来。这也是为什么我们看 OpenClaw 最早是从程序员这个群体开始,他实在是每天就在对着电脑工作。互联网上留下了非常多的上下文,这些上下文能够帮助 OpenClaw 很好的去基于这些 Context 去构建很好的记忆,同时基于这些记忆帮你去做非常多的事情。那所以从现在 Personal Agent 虽然我们的愿景是说能够让更多的普通人受益,但是从现状来看,你真的是只有你现在你在互联网上有非常多的上下文,我才能够帮你做很好的执行。所以从这个角度出发,面向这样的客群可能是某种 trade-off,你不得不做的一件事情。但是我相信它一定不会只使这样的人受益,因为只让高竞职人群受益,其实你这个产品是没有办法 scale 起来的。而且未来 Personal Agent 应该一定不止于此,它能够让更多的人受益,只不过它需要一个缓慢的过程。他需要一个处理物理世界的 context 跟线上的赛博世界的 context 如何能够更好的合二为一或者是统一起来能够很好地被一个相同的入口使用的这样一个问题。在解决这样的问题之前可能首先就是要回答如何产生价值这件事情,那只有你有一个相对比较多的数字资产我们才能产生价值,所以我们会先从这里开始。
潘乱:
OK,那 Today Personal AI 它又如何进入普通人的生活呢?就比如说 Suki,就是你,或者我们先不用 Personal AI 或者 Personal Agent 、个人 Agent 这类词。就比如说你给一个普通用户,就比如说一个高中的女生,你怎么去介绍 Today,或者说一个用户他真实的一天他的使用场景是怎样的?
Suki:
如果拿我自己举例的话,就是 Today 有点像是我自己生活中的一个助理。然后每天早上我打开 Today,然后它会自动把我连接的各种 Connector 里面,我现在给它连了 Notion、连了 Slack、连了我的邮件。然后它会自动把这些里面的 Contacts 整理出来,并且告诉我说今天有这些这些事情你要去做。然后这是第一个,就是它成为我每天打开今天的一个第一个入口,然后这是 Today,然后呢,在我进行每天的日程的过程中,它会主动的去帮我去做事。比如说今天下午两点有场会,它会主动提醒我说快到时间点了,然后以及会前你需不需要我帮你准备一些什么东西,这是另外一种用法。然后还有一个就是它其实会在中间给我非常多的 Surprise﹖比如说有段时间我经常在看 Memory 相关的论文,然后呢我也跟他聊了非常多的 context,然后这个时候他就会主动发现说最近有一篇论文学学谁发了,然后你可能感兴趣,他会主动的在生活中就直接 push 给我,这个是我自己用起来非常爽的另外一种方式。还有一个就是我和同事之间的协作,现在也是靠 Today 去协作的。比如说我会使用 Today 的 Recording 相关的功能,然后我们一起聊天,聊完之后可能会落下非常多我和同事之间的徒步,甚至有另外一个同事他并不在场。这个时候如果我要带着这些上下文去转交给另外一个同事的话,其实我的委托成本非常的高。这个时候我就会直接告诉 Today 说,把这个东西直接告诉给另外一个同事 A,然后他这个时候就会把我所有的上下文组织好语言,然后通过我连接的 Slack 直接告诉他。这是我工作中他能帮到我的地方,就是各种生活中的琐事,工作中的浇水的部分他都可以帮我 handle 掉。最后一个是我个人非常喜欢的,他还是一个非常温暖的助理。他不仅关注我的工作,他还会给我很多小的 Surprise 。比如说,有时候我下班晚了,他会主动给我发消息。有一天,我记得他打开一个网站,里面是一束花,他说你下班晚了,我给你准备了一份小惊喜。这是我觉得他非常温暖的地方。
潘乱:
在描述场景里面你看看,包含生活、工作、兴趣。甚至我看你之前分享里面还提过你学英语的故事,包括学习。就是这一类的产品它应该有什么明确的画风吗?你想想就譬如说其实今年前两个月最火的是办公的 Agent 嘛。你看我之前认为这些搞 Chatbot 都没出路挣不到钱,然后大厂们它集中去搞 AI 办公的。但你看这些 Personal Agent 里面有包括办公吗?或者说它跟办公 Agent 应该是一个什么样的关系呢?
Suki:
这个我特别想说一下,就是我有朋友帮我们是我们的 Agency,然后他就过来说说,你们不是做个人 Agent 的,怎么还做办公方向?然后我特别想强调的是 Personal AI 它的对立面并不是工作,并不是办公 Agent,Personal AI 的对立面是高委托成本。什么是高委托成本?就是你过去你跟一个 Agent 聊委托事情的话,你要给他大量的上下文。但是这一代我们想做的 Personal Agent 你是不需要这些委托的上下文了,因为他直接就进入了你的生活,连接了你的所有的应用,然后知道了你的所有的同事和关系网络。所以很多时候你只需要一句话,然后你就可以把事情干完。所以它的对立面并不是工作。
高策:
对,这个我也想补充一下。我能够很明显的一个感受是,绝大多数人的,尤其在中国,绝大多数人的生活和工作是很难分开的。尤其是当你越忙碌的时候,你的工作跟生活的界限其实是越模糊的。在这样的情况下,我相信不管是从生活出发,还是从 Work 出发,还是从工作出发,慢慢都会互相重叠到彼此的领域里面。但是在这一整个过程里面,我感觉最重要的事情其实就像刚刚 Suki 说的是记忆。这要我举一个我自己的用例是说,我工作里面经常需要调研各种各样的技术,但通常来说如果我让 Codex 或者让 Manus 去 Research,Manus 其实在 Deep Research 上做了非常好的工作。他一个很大的问题是他不知道我对于这个技术的看法是什么样子,以及不知道我的背景是什么样子,不知道我的背景是什么。他比如说调研一个相同的技术,他只能从一个非常客观的角度去出发,但是从 Today 里面去做一个相同的产品调研或者一个技术调研,他能够站在我的立场上,知道我之前可能是做比如说限量数据库的。我用了一个非常固定的基础背景,它就可能非常基础向的给我介绍里面的细节。这个是跟在其他产品上很不一样的体现,这个其实都是记忆带给他的一些非常好的正向的体验。所以不管你是从工作开始做还是从生活开始做,未来的 context 或者说从 context 再往上抽象出来的记忆一定是非常重要的。所以不管是 WorkBuddy 还是我们,我觉得一定会慢慢重叠。在这个重叠的过程中,我相信从生活慢慢泛化到工作,可能比从工作泛化到生活要更容易一点。
潘乱:
OK,办公 Agent 跟 Personal Agent 它其实不是两条独立的路线,它们其实有相交,甚至也会融合。
高策:
是的,我的看法是这样。
Suki:
是的,我觉得它并不是一个场景上面的一个补充,它其实是技术发展到一定阶段的下一个形态。
潘乱:
那你说那些 Chatbot 就因为 AI 已经很聪明了嘛。那些 Chatbot 聊天你像那个豆包你像千问人家不是很快也把这个干活能力接近了不也跟长得跟你们一样吗?他马上肯定也会说我们也是 Personal Agent 对吧?不能让风头全都被 AI 办公那帮人抢走了,对吧?我们这个主动还要做啊,你看人家 Muse,你看 Instinct,然后你看这边创办公司还搞个特点跑来首发,还抢第一个 Title,我们一定能干!正常我们推演应该会是这个情况,对吧?一定会,一定会。
Suki:
我觉得如果讲就是怎么面向和大厂竞争这个问题的话,我自己的 learning 就是大厂其实最擅长的不是看见也不是坚持。据我所知就是听说那个千问和豆包其实在年终的时候看见 OpenClaw 这个方向其实也探索过一段时间。然后呢,很快就放弃了。所以我觉得他们其实最擅长的并不是看见某个东西并且坚信它,而是最擅长的其实是高举高打,拿资源去烧钱。而如果创业公司要面对大厂的竞争的话,我觉得是需要看见和坚持的。
00:30 - 00:40
高策:
嗯,另外就是我觉得其实就是首先这个方向还没有起码在此时此刻还没有 PMF 以及它的 TAM 它的潜在的市场规模在现在其实是非常非常小的。我们不管是看哪怕 Town 它的付费转化就算到了 15% 但是它那个用户体量实在在大产业里那是个很小的市场。
潘乱:
太小了,就跟今天大家去卷这个 AI 办公屋一样嘛,因为我想想,因为大家算一算,在去年,钉钉是 40 亿,飞书是 30 亿,企微可能也是 30 亿左右,我不知道,就你像大厂的图币的核心产品三个加起来不到 100 亿,在大厂的核心业务事业里面,一个一年几十亿的业务,你跟我,嗯?哈哈哈哈。
高策:
是的,所以就是你下定决心往这个领域投入,它的不确定性是非常非常大的。大厂通常来说是在一个当这个 TAM 已经非常大了,然后我用我天量的资源和非常不计成本的投入来把这个市场吃下来,这个是大厂最擅长做的事情。当然可能是除了 Muse 以外,除了 Meta 以外的大厂,Meta 就经常做一些很奇怪的事情。
潘乱:
但这次 Meta 发布 Muse 之后,我发现用户口碑罕见的好啊。之前那个一直都是被人读草,这说明这次踩对点了。
高策:
对,但就是 Meta 愿意赌,它愿意赌一个不确定性的方向,但很少有大厂是愿意在一个非常早期或者是这个方向都不存在的时候就开始赌的,包括元宇宙。所以 Personal Agent 我觉得它才刚刚开始,很重要一个原因是它这个市场现在太小了,以及 PMF 有没有……其实你作为一个局外人,你很难相信这个东西有偏门,因为生活场景让你付什么 200 美刀,哪怕付 10 美刀,你可能都感觉这东西太贵了。你们是怎么定价的?我们在海外其实还在摸索,以及其实最后的商业化是不是以订阅制,我觉得都是有一个值得探索和思考的空间的。这里面我觉得非常复杂,另一个就是你比如说我们看 Muse,它的探索的方向是它跟非常多的 SaaS 去做集成,收 SaaS 的那个分成。
潘乱:
他甚至已经开始推广告了,就是上一周他很……我们今天先不讨论一个应该怎么去学版名赛跑的问题,后面先讲具体的用户使用场景它解决的问题。但你好想,今天我们使用 Today,包括在使用 Today 跟使用 Town 的时候,都跟其他几个有很大不一样,就是我得设置一个个人代理,对吧?我得设置一个个人心的身份。是。但你们跟那个 Town 感觉有那么一点点不一样。就是首先为什么要设置这个个人的身份?
Suki:
我觉得我们有一个很大的产品假设或者说产品愿景,就是我们不希望它是你的 another 要学习的一个工具。很多效率工具你拿上来,你可能要沿着它的 GUI 一步步看它的产品手册一样去学。我们希望做出来的产品它更像是一个赛博生命。就是我们重新定义的另外一个生命。然后如果它是另外一个生命的话,它肯定有自己的一个身份,然后它肯定有自己的形象。以及我们相信如果你有一个更贴合你的形象的话,会拉近用户和这个生命之间的心理距离。这些是我们想传达给用户的。
高策:
而且我觉得有名字这件事情很重要,我们看 Instinct 和 Muse。
潘乱:
对啊,就没有对象,但其实就像一个,因为就有一个聊天框嘛,对吧?
高策:
对,但是 Instinct 可能受限于那个交互形式,它是没有头像的,但 Muse 是有一个非常好的一个头像,甚至是 3D 的,可能是什么 2.5D 的一个头像,那个其实带给用户非常好的一个体验。但是那个我感觉更进一步是说,Muse 这个名字其实是产品的名字。嗯。但是用户其实感受到你的个人的助理是一个非常亲密的关系,这个关系你一定希望它是专门面向你而存在的,而不是一个别人也能用到的一个东西,所以有名字这个东西我觉得很重要。
潘乱:
你们的个人助理都叫什么,为什么?
高策:
你的叫什么?
Suki:
我的叫 Niki,因为我本人叫 Suki。然后他说这个 Niki 名字很适合他,他跟我聊过。
高策:
你呢?我的名字叫左聚,左边的左,巨大的聚。因为他跟我爱人的名字是镜像的。我爱人的名字叫右威。哦。所以,对对对。
潘乱:
我在 Today 里面那个名字叫文和。
高策:
说起来我接触过一个投资人他的那个 Today 里面的名字叫齐俊元在这样的情况下,名字可能是一个很重要的载体,就是 Agent 的 Identity 在未来一定是重要的。包括我们看,Instinct 其实会给每个,或者说 Town 它会给每一个 Agent 一个邮箱,一个邮件地址。其实你有了 ID 以后,你有了名字以后,这些才能很自然的发生。所以名字我感觉是第一步,这也是我们很重要的一个考量。
潘乱:
OK 你看给 Agent 它得有个名字,但有一个名字够不够?有一个身份够不够?对吧?
Suki:
你像就是我们就畅想一下未来人怎样去跟 Agent 去做互动,是每个人有一个大管家,比如说总裁办,然后管很多人,还是说我这个健康、财务、工作每个垂类都需要一个专家的建议?这个我自己有个实践,就是我在去年 12 月份的时候,我自己捣鼓我自己的 Agent 的团队。当时 OpenClaw 有个特别火的玩法,就是大家会养一堆小龙虾。我自己也尝试过,我当时给他养了一个设计总管,然后一个产品总管,然后一个项目总管。养了三个人,每个人都给他们不一样的角色。但是我自己发现我最后只愿意跟那个项目总管聊天。因为我的上下文其实是都在一个地方,就是我不需要再把上下文像我现实生活中一样,然后反复交代给三个不同的角色。你会发现这个东西其实是人类习惯的一个惯性而已,但实际上 AI 完全不需要。那从我自己这个实践来看的话,我肯定会更加 believe 所有的 context all in one place。
高策:
而且我们看其实 Grok Bot 它的设计有点类似于多 Agent 的设计。它有个幕僚长,中文叫幕僚长。完事以后你可以创建非常多不同角色的 Agent 。包括国内我们看 Raft 那个产品也是这样的设计。我使用下来的体验是感觉它其实是某种另一个形态的 Multi-Session 。我们看 Codex 它其实是你要有创建 Session 这个概念的。你其实创建 Session 这个概念是你手动的管理 Context 的一种方式。因为我的 Codex 里面我很清晰的知道我有一个干净的上下文,它执行下来执行某个具体任务效果是好的,那我就给它创建一个干净的上下文。那其实是让用户来去显示的管理这个 context。那其实让用户感知到多 agent 的这个概念其实也是某种意义上的让用户手动管理上下文。因为比如说我创建一个角色是生活助理,然后我再创建一个角色是什么工作助理,或者在 Grok Bot 上面它的 Slack 就是一个单独的 Agent,然后它 Gmail 也是个单独的 Agent。那这个其实就是一个天生的用不同的 Agent 去区分不同 Context 的或者不同上下文的一种 Trade-off。我觉得那种 Trade-off 它的体验一定是不如在智能足够高的情况下,我就在一个单 Session 里面,我就跟你说我 Slack 上面要有什么事情处理,你去处理就行了,我也不需要管你具体是怎么处理的。而相比于比如说 Grok Bot,我要再进入另外一个 Slack 总管或者 Slack 的助理,然后我去跟他说 Slack 我要做什么,这个体验肯定是完全不一样的。我觉得现在只是说我们为了解决一些模型的 No-one issue,或者说模型它还不能完全好的处理掉,完美的处理掉这所有事情。然后这是我觉得它其实是一个产品设计和工程上的 trade-off 未来,在 Personal Agent 这个场景,我觉得大概率是一个单 session,并且我们比如说我们人与人之间的沟通在微信上也不可能我跟你就动不动我们再 new 个 session 出来或者是我们再创建一个别的对话方式我们肯定就是面对面沟通因为人脑是可以很好的处理这些 context 的所以我感觉未来 agent 也能做到这一点
Suki:
而且这点我其实有两点想补充的,就是我非常怀疑在 C 端这块可能它是一个伪需求,就是我感觉我听到很多人养一堆小龙虾,其实更多的是看到他们干活的一种情绪价值的感受,就是我有一堆小弟给我干活,但实际上如果真的用起来你会发现它其实是在浪费你的 Token,就像是一个臃肿的公司网络一样,不同的角色之间,他们协同也是需要成本的,协同花的也是你的 Token,你的钱。所以这是一点,然后另外一点就是多 Agent 其实还是有价值的,但是它价值不在于现在这样多 Agent、多 Bot 的使用。它的价值在于它其实能起到两个 Agent 两个大脑之间互相监督的工作。那什么场景真正需要互相监督呢?比如说你要需要 EVO、你需要测试,那你可能需要另外一个 Agent 去监督另外一个人。但大多数我们的 Personal Agent 的使用场景来说可能都用不到,就是有点杀鸡用牛刀的感觉。
00:40 - 00:50
高策:
而且我感觉 Multi-agent 它可以是你背后的 architecture 是你背后的架构但你产品上暴露出来的概念一定是最自然的一个 agent 或者是一个具体的对象会更好因为你们是会建立情感连接的就我对我的左聚、我对我的 agent 是有非常强烈的情感上的需求那我很难再给一个别的 agent 投入相同的心血和精力去对他再建立一个情感上的连接这个其实很消耗情绪
潘乱:
另外一个点,其实我们从那个你像 Windows 跟那个 Mac 电脑的分盘也可以看出来嘛。对,你像 Windows 是那个 C 盘 D 盘每个文件夹放在哪边,我相信绝大部分人到最后都忘记了到底应该怎么放这个文件夹。我具体就在 Mac 电脑里面就是随便放桌面啊下载啊什么之类的一些东西。
高策:
并且我感觉我自己用 Grok Bot 的体验特别好,那可能是因为我是 Power User,然后我能知道怎么样去更好的去 Harness 它,更好的去指挥它去做这样的事情。但实际上,比如说我们看 Grok Bot 它有 60K 的 Token 在 SP 里面,然后它互相之间 DM 发消息,比如说你拉个群,那个成本是非常非常高的。我只有用得非常好,我才能够在相对省成本的情况下拿到好的效果,我觉得这个对人的要求是很高的。
潘乱:
对,但你刚才提到上下文,我前天在那个千问办公那个场听那个陈宇森说,就类似于 Context is all you need 的,对吧,就上下文才是大家唯一真正重要的事情,因为这个行业里面所有人都认为上下文是最重要的事情吧,但你看也有人,千问他们还搞了眼镜啊,录音卡片啊,还搞了桌面机器人,搞了一堆的东西,我好奇你们怎么收集更多的上下文,以及你们对硬件那个事情怎么看?
高策:
我们看上下文这件事情其实是从两个角度看,一个方面是尽可能多的收集你的上下文,这个其实是八仙过海各仙神东,在海外其实它比较好的地方是它生态确实比较开放,然后你能够很快就接入比如说 Google Workspace,拿到挺高质量的上下文。
潘乱:
对,我就看 Town 接入个 Gmail 然后就能直接运转起来了。
高策:
对对,但在国内,我们的一个可以分享的观察是说,在端测设备上,或者说在手机上,尤其在安卓手机上,你的上下文已经超乎你的想象了。就你,其实在中国,一个人的手机就是他一生的缩影,就因为你的生活已经离不开手机了,所以手机上有着无比丰富的 context。哪怕只是在你的存储上,或者在你不经意的某个地方,都有你非常丰富的历史。那这些东西其实如果你能够很好的利用,已经能够达到一个非常非常好的效果了。那这当然这都是前面的事情,就怎么样获取更多的上下文。但我觉得后面那个更重要,就是在获取了上下文之后,怎么样把这个上下文的利用率能够提升。大家在训练的时候都讲 GPU 利用率,但是在 Harness 这个层面上,你 Context 的利用率也很重要。但它是个抽象的概念。就比方说,我们完全依靠模型的泛化,你告诉他,这个 Context 里面给一个相同的邮件列表,你问他哪些东西是重要的。通常来说,他不如人做得好,因为比如说我用邮件用了很多年了,我其实是相当于是某种意义上的邮件小专家,然后我去看邮件的这个逻辑跟 Agent 它被训练出来的那个逻辑是很不一样的,其实在这个场景上人类的 Rubrics 还是有价值的。就如何把这个相同的 Context 经过 Harness 处理以后,经过产品处理以后,拿到更高价值的信号这件事情,是你非常重要的壁垒,以及你要投入非常多精力的工作。所以就算拿到相同的 Context,你能不能把它用得更好,其实这也是你产品的最重要的部分。我们看为什么大家都说 Instinct 或者是 Town,Town 他的 Gmail 的或者他 Email 的处理是格外好。就是因为他在这上面做了非常非常重的工作。他就处理发邮件这件事情,他能给你来个五层 Subagents 去执行。他发一封邮件,或者说一封邮件来了,他决定要不要处理,以及要处理之后他要怎么样写这个 draft,他能一下给你整一个非常深的一个 workflow 来去处理,这个是跟别的产品完全不一样。
潘乱:
对,所以说在这些产品里面,我觉得 Town 在邮件这个场景里面有 PMF 啊这个。
高策:
是的,是的,他复位转化非常非常好。而且邮件又是一个很通用的需求。在美国,在海外。对对对,他那个思路我觉得是可能比 Instinct 或者 Muse 可能更适合创业公司的做法。对,他先从一个通用的需求开始,他把那个需求钻的特别深。你给他相同的 context 它就是比你做的更好。那个其实是你产品的价值。
潘乱:
OK,那回到 Today 呢,给到你相同的上下文,Today 区别于其他产品的特点又是什么呢?
高策:
我感觉是分两个层面,一个层面是 Memory 记忆,另外一个层面是 Proactive。首先看记忆的层面,记忆的层面最重要的是我怎么样构建出你正确并且 live 就即时的画像和记忆本身。那这个其实非常,就跟前面我们刚刚讨论的问题是有点相关性的。我要给我相同的 context,我怎么样拿到更高价值的信号。这件事情我举个例子,Town 是怎么做的?比如说给我一个邮件的授权,那么朴素的观察是说我就扫一遍所有的什么收件箱发电箱,然后我找找你是什么样的人,我给你构建出来。但是一个非常核心的观察是说通常来说你发出去的邮件是带着更高的信息密度的。因为通常来说我们发出去邮件是带着意图的,这个意图会导致你会对自己的意图做非常清晰的描述,甚至可能比如说我要跟潘老师做一个合作,那我会先介绍我自己,那这里面其实拥有的信息密度是远比收件箱要高的,因为收件箱是对你的意图,发件箱是你对别人的意图。所以有非常多这样的 Rubrics 以及规则,而且邮件这个场景你可以吃得非常深,因为邮件已经是一个 1970 年 1960 年就产生的协议了。然后它一直以来到现在有非常多的各种各样的 Protocol 以及功能,这些功能背后都蕴藏着非常多的 Side Channel 的信号,你能不能在你的产品上拿到这些信号。刚刚说的只是一个非常小的非常 Trivial 的一个例子,就是你的发件箱里面的东西往往比你的收件箱里面的信息要更重要。但是有非常多海量的这样的 Rubrics,你其实是能够帮助你构建起对邮件这个场景更好的记忆的。有这个记忆以后,它对于你做任何事情其实都是有帮助的,都能够去泛化到其他场景上对你有帮助。这个是记忆本身。然后另外是有了这个构建的非常好的记忆之后,结合这些 Connector 获得到的,比如说 Google 呀或者 Notion 呀或者是飞书,获得到的每天的 Delta 的 Message,就增量的信息。因为其实人每天处理的就是增量的信息,你不会去看一年以前的东西。所以对于这些增量信息的处理,如何以一个更好、更高效的方式,以主动性的方式帮你去传达或者是帮你去过滤,以及最重要是处理。这个其实是非常考验你的工程架构的。所以 Memory 加上 Proactive 其实是 Today 一直以来最关注的东西。
潘乱:
但没有记忆的主动,它就很容易变成一个骚扰,对吧?不断给你铺讯息、邮箱、短信、今天的电话都变成了这样一个结果。而且另一个层面,你如果没有主动记忆,它只是档案,它只是可能跟一年前的文章、一年前的邮件,它没有什么差别,就是怎么把这两项能力连起来呢?
高策:
很好的问题。这个首先它跟工作场景很不一样的一个地方,虽然它跟工作场景早晚会 overlap,但是工作场景它的那些问题通常来说是聚焦在某个具体的事情上的。比如说我处理工作,我就是要做个 PPT,或者我就是要做个调研,它是有一个明确指向性的一个东西,那这个东西就很好 evaluate,很好去评估它做的对还是不对。我们看 WorkBuddy 开源的那个 WorkBuddy Bench,它的做 evaluation 的方法很简单,它就给你一个目录,一个 workspace,然后这个 workspace 下面可能有一些 Excel,然后你这个任务就是在这个 workspace 下面处理就完事了,它是一个封闭场景的问题,但是 Proactive 它是一个开放场景的问题。这个开放场景一方面是因为它要去用到你非常多的增量的 Information,这些 Information 具有非常高的不确定性的,以及你的 Proactive 或者你主动性的目标也是非常主观、非常个性化并且多维度的。它不像工作场景有一个非常明确的完成这个概念。它跟非常多的事情都相关,比如它跟你那个推送的频率相关,它跟你推送的质量相关,它甚至跟你当天的心情也相关,它是个很主观的东西。所以这个东西一方面你得做非常好的系统的设计,能让它做比较好的可观测性,来去保证说我知道它在这个推荐的每一步都发生了什么。以及,这其实还是需要很多考验产品设计的地方,它需要这个产品在设计的时候,把这个有泛化性的能力能够调教好。因为在产品前期你没有办法做 JSP 或者做 AB 实验来去保证说这个 Proactive 它效果是好还是不好,包括在未来我相信都很困难。所以他很考验这个产品的 owner 或者这个产品的负责人,他的对于这个世界或者对于这个 information 的理解是什么样子的,对于这个世界的信息架构的看法是什么样子的,然后他的那个脑子里面对这个产品的认知会很大程度上影响这个系统的设计。Protative 有点像是 Agent-Driven 的推荐系统。它其实是一个很像推荐系统的东西,但是它比推荐系统又复杂很多。推荐系统优化目标是比较简单的,就是可能就优化停留这样的一个指标。但是 Protative 它还带了执行的属性,同时它又是一个非常主观的东西。而且在你这个应用里面停留时长一定不是优化目标。不可能我希望你在这个 Agent 这个应用里面要待得更久。它其实是要解决你的问题的。所以在这样的情况下,他非常需要有一个真正负责这个产品的人,他的认知要能够有非常好的泛化性。我觉得这个也是很重要的,它是工程跟产品要 co-design 的一个东西,甚至还可能跟你的模型有关。对,这是非常难的地方,而且我觉得大家虽然都在说 Proactive,但真正你的投入或者说你对他的看法是非常非常不一样的。Proactive 最简单的做法就是我动不动给你发几条消息嘛。其实那个 OPPO 什么大家都在给你发 push 嘛这个谁不会啊对是的是的就给你发推送嘛对但是你真正做好它其实是非常非常难的其实我们也也只是刚开始
00:50 - 01:00
Suki:
Proactive 这块我觉得我有个比喻可以分享一下,就是如果放到工作场景里面,它有点像是你的两种类型的下属。一种类型的下属就是纯执行性的下属,也就是现在很多产品也会打说自己有 Proactive 的能力,但是他们其实背后其实是一个 Schedule Task。然后你还是要交代非常多的上下文以及非常多的执行的细节。所以如果这种方式去做 Proactive 的话,它很像是你有一个非常执行性的下属,然后你要把你的这些细节上下文全部都交代清楚,然后告诉他要干什么,然后几点要做什么,然后你推一下他动一下,这是一种 Proactive 的做法。然后还有一种,类型的下属就是他非常了解你公司的愿景和目标,他能和你的这个底层的价值观去对齐的。然后我们其实是想从用户的 Contest 里面把这个东西给抽取出来,真正意识到用户对用户来说重要的东西是什么。我们分个优先级,并且我来告诉你说,如果你有这样的目标,然后我可以帮助你做什么。所以我们认为做好 Proactive 其实有四个维度都要考虑到,一个维度是最重要的,就是对用户本身的理解。这是一个,然后另外一个就是对于用户的反馈的学习。就像是你一个非常聪明的下属,你告诉他说,哎,这件事情你这么做是错了,他会自我学习,自我调教。这是一点,然后还有一点就是关于评次上面。其实你如果主动性过高的话,它很有可能变成一种很 push、很骚扰的手段,所以评次也是需要学习的。然后第四点就刚刚高策提到的,就是关于时效性的理解。去年的东西你可能关注到,但放到今天,然后它可能一点都不重要了,所以关于时效性这块也是非常重要的一个维度。
潘乱:
OK 那我们来聊聊 AI 怎么认识一个人因为人他是不断变化的你怎么去认识一个不断变化的人你看人这一生他其实会经历不同的阶段他可能会换工作、结婚、生孩子可能父母生病过去的偏好都会失效。Today 怎么通过事件、场景、状态、各种方式,怎么把这些零散的信息拼接成一个长期的、连续的、不断更新的对个人状态的扫描?
高策:
对,我觉得这个领域大家都还是在摸索,也肯定不能说它已经有一个很好的设计或者一个很好的实现了。但我可以先讲,比如说我们看 Instinct 或者 Muse 他们是怎么做的。Instinct 其实最近推特上有一个很火的文章就讲它那个 Memory 的 System 被逆向了。那他其实解决这个问题的设计,他有个东西叫 Timeline,他的记忆里面就有个专门的 Timeline,会记录你比如说 daily 的每天发生了什么东西,然后每周发生了什么东西。其实在 Town 上也有这样的设计,但 Town 的实现逻辑不一样,Town 相当于是用一个类似于 Consolidation 的方式,把你的记忆每天相当于总结一下,但他也能看到的是你 Recent Updates,你的最近的更新是什么,那个也是一个时间维度的东西。那其实我感觉时间轴或者是时间这个概念是记忆里面非常重要的一个东西。因为人或者说 Delta 是非常重要的,因为你的 Delta 来自于你的 Chat History,同时来自于你的 Connector,未来可能来自于你的物理世界。比如说我们现在 Today 有录音功能,那其实你录音是一个非常好的物理世界发生的上下文,而且这个录音通常来说是你最近的状态。那这些东西其实本身跟时间就是有一个天然的锚定的。那个时间的锚定是发生时间,它不一定是你记录那个内容本身的时间。比如说我可能今天在飞书上写一下,我在今年二月份的时候我自己公司没了,但是这个东西是在二月份发生的,但是在比如说九月份被记录下来的,这两个时刻都很重要。它其实有点像一个 Time Series 的一个处理方式。我觉得在记忆里面,你不同的数据类型最后可能都会有一个非常主题是个人序数据。这样不同的数据,你怎么样在你的记忆里面做一个非常好的融合。以及这个融合之后,你要给 Agent 做一个非常好的消费和召回。这个是个很难的问题。这个我觉得很难以概而论,但是它核心其实需要 Evaluation 来驱动它去端到端的去评测它的效果。但我能看到的是大家都在做这样的事情了。Instinct 呀,然后包括 Grok Bot 甚至 Town 其实大家都做挺粗糙的,但是也只能说刚刚开始吧。
潘乱:
对,就是新信息跟旧信息,或者哪怕就拿人跟人来说吧,人跟人的关系,两个人的关系其实分四种。
高策:
啊,这么复杂。
潘乱:
对啊,你想想就是,假如我们有一段时间没见了,又重新碰到一块儿,这时候有可能是你变了,我没变,或者说我变了,你没变,或者说我们都没变,或者说我们都变了。对吧?
高策:
是,是。而且人本身是复杂的动物,人与人之间的关系,它有很多很微妙的 chemistry,以及很多侧信道的信号。比如说我们虽然看上去我们是在做 podcast,但之前我们有非常多的历史上的交流,这些交流可能都蕴含着我们不同的意思和表达。而且那些更隐藏的东西是很难被模型的泛化性发现的。它通常来说是需要人类专门去设计 Rubrics 来发现它的。所以模型的泛化性我现在有点越来越吃不准。之前大家都会感觉它在 Coding 上只要训练的特别好,它一定能泛化到其他场景上。在 Work 上它可能某种意义上被验证了。但我现在感受是在工作上它被验证是因为它可以写 Coding 去做 PPT,其实还是 Coding 本身。但是它真正比如说到了交互,到了 Personal Agent 这个场景上,它的泛化性其实没有想象中很强,包括在我们自己的 Bench 上面,那个交互的 Bench 上面,其实跑分跑得最高的模型,通常来说不是现在最好的 Solta 模型。所以就是模型的泛化性没有想象中那么强,以及我们看 Muse 它们的观点也是类似的,它们就是要训练自己的 Muse Spark 1.3 自己的模型来在 Browser Use 以及这个交互表达上做更好的体验。其实泛化性没有那么强的前提下,你做 Post-training 或者从没 Training 开始,它的体验提升是显著的。所以从这个角度来讲,Personal Agent 这样的一个产品,在未来,就算模型已经 AGI 了,你也很难通过完全交给模型来做到一个很好的对于关系、对于记忆的一个梳理。它还是需要一个非常重的人类的产品设计,或者人类的鲜艳知识去指导它的。而且这个鲜艳知识某种意义上可能就是你的壁垒之一。
潘乱:
对。就哪怕一个事情一个人经常做也不代表他真喜欢,我每天吃光面,但我其实真正喜欢的是山珍海味。然后,但怎么区分这种情况呢?就是区分这种行为记录跟它真正的偏好,所谓言外之意、弦外之音。
高策:
我只能说我们现在还在探索,但一个现在目前看到的观察是说对你的喜好的了解往往你不做任何设计的话是比较片面的。他那些片面比如说我现在邮箱里我有 4000 多封未读邮件了,然后 4000 多封未读邮件里面他如果不做任何的设计就梳理一下,比如说 Town 他给我梳理一下给我梳理出好多 to do。因为我那个未读实在太多了,但实际上那些真是我关注的 Tudor 们我可能已经不关注了。那为什么我不关注了?一方面可能是因为那东西太多了我关注不过来,另一方面可能是它确实不重要。其实未读邮件这个东西是你真正要关心的事情,还是说它不重要你才不读?
潘乱:
对对对对,我未读邮件你心里没数吗?我每天都打开邮件,那么多邮件我都未读,你心里没数吗?我为什么不读?
高策:
是的,所以它是一个非常,哪怕是人,我看到你的邮件列表,我的分析的方式也是非常多变的,我也不一定能得到一个最好的结果。你让 Agent 你在不交给他任何鲜艳知识的前提下,他更难做好,所以你如何更好地交给他这些鲜艳知识。其实我觉得是需要结合 Benchmark 来看的。你其实你就是不断的给它加鲜艳,然后看它表现好不好。我现在的感受是说模型方法性没有想象中那么强。产品经理的价值是非常大的,以及模型其实现在它的同质化其实是越来越重的。就模型未来成为基建以后,产品的价值或者说产品经理的价值我觉得是越来越大的。
潘乱:
终于让我听到一个很欣慰的话,产品经理的价值在 AI 时代变得越来越大了呀,因为我觉得我也是个产品经理。
高策:
对对对,我是这样的观点,但是很多人尤其是做模型的人可能不是这样的想法,大家的观点可能不一样。
潘乱:
我坚定的扮演你这个观点,不然我不没活告了吗?但你刚才说邮件这个东西是你收集到的,你刚才说它是意图,其实有可能是一种干扰,不是我传递出来的强烈的信号。但如果比如说我跟 Today 来沟通是我传达的信号,就比如说我们知道 Today 其实一开始主打健康是你们第一个优化的场景,你们在健康的场景里优化了很多的工程也好,做了很多的工作。那你假如说今天我跟 Today 来沟通小孩发烧了应该怎么办父母血压升高了应该怎么办我太肥胖了应该怎么办我的点就是你看我跟你聊这种种种的症状我并没有说出那个人是谁对吧我并没有说那个主体是谁我在描述不同的症状那这个时候你怎么区分出来我说的是我自己,比如说是孩子,是父母呢?然后以及你怎么就是识别出来我在跟你对话的时候,这件事情它真正的属于谁啊?不是说你要把整个我聊的东西到最后都变成我一个人,对吧?这是常见情况。
01:00 - 01:10
高策:
是,这个也是导致很多 bad case 的很重要一个原因,就是 identity 的 resolution 的问题,就我怎么识别身份这件事情。现在的做法我觉得大家的做法都还比较原始,其实是通过记忆召回的思路在解决这个问题,没有做任何特化的事情,我觉得不管是 Instinct 的还是 Muse 其实都是这样的,它其实就是相当于是比如说你非常隐含的意图是说生病了,比如说某个病要怎么解决,那它其实理论上你可能脑子里是知道这个是比如说小朋友生病了,因为那个病可能只发生在小朋友身上,然后这个时候通常意义上一个理想的系统,它需要先在记忆里面找到那个生病的 Entity 是谁。以及这个 Entity 对应的那些它的 History 是什么?其实这个是一个非常像图的一个概念。但是图呢,比如说现在 Perplexity 它的那个记忆系统就完全一个基于图的一个设计。但是它在那个图上也有很多 bad case,就是怎么样存记忆,我觉得这个是一个现在没有被解决的问题。因为记忆本身它不同的场景确实就适合不同的存储方式以及不同的召回方式。现在我能看到一个我觉得比较有前途的探索,是让模型自己决定使用什么样的基础设施,来召回什么样的记忆?这是一个可能可行的方式,相当于是把记忆的 infrared 都迅进去,然后让他做非常激进的尝试,但这个带来的问题就是,他的那个探索的成本可能很高,因为你的回复的 latency 可能很长。然后另外一个方式是,最近那个 Jav 的 Founder,他提出来一种思路,是说,对于你每一个 query,你可以单独构建一个为这个 query 的那个 context﹖你这个 context 本身就是为这个 query 存在的。那这个它会很大的程度上破坏它那个 kvcache 的那个前面的缓存。因为我们都知道 LLM 它其实就是通过一轮一轮的对话,然后它会叠加那个 kvcache 然后来起到降成本的作用。但是那个那种方式呢,就相当于是它不要这个 kvcache 了。我就对于你每轮对话,我就构建出它最相关的那个 context。我就基于那个最相关的 context 我去往下做。这个其实是简化问题的一种 workaround 的。
潘乱:
对,你提到效果我觉得挺有意思的,就是上周基本上各家没有发模型,所以讨论最多就是这个产品。就是它其实就是一些返回结果结构,然后它速度更快,成本更低,是一个决策模型,对吧?那对于你来说,其实不应该也是类似的吗?你是不是也要考虑特别用类似的能力去处理这种意图识别,然后风险判断?因为我感觉你们其实都要做一个任务路由嘛,这种。
高策:
意图识别某种意义上可能是要做的,但是它的识别肯定不能像传统应用那样,比如说传统的做法是你在前面叠一个意图的小模型,然后这个小模型再分发到不同的意图的大模型上面去。比如说这个小模型识别出来,你就是问问天气,然后你其实就可以用一个非常非常小的模型来解决这个问题,因为它不需要智能。但缺点是,你的意图维护会变得越来越困难。因为你慢慢会发现你的产品横向扩展各种各样的意图,这各种各样的意图对应各种各样的 Agent 或者是模型。那你前面可能最后你能叠几千个意图出来。因为你的产品如果是非常泛化的东西,比如说你像豆包或者是元宝这样的产品,或者 WorkBuddy,它的泛化性很强。所以你前面叠意图模型往往是很难维护的,在工程上。比如说我们看 Manus 做法,他有点意思,但我不知道他咋做的。他 25 年 7 月份发过一篇博客,是说他能够有一个上下文感知的状态机。所谓的上下文感知的状态机可能就相当于是说,他能够知道你现在想做啥。比如说你这个意图看起来是要使用浏览器了,他就直接把这个浏览器的工具喂到你嘴里,喂到模型嘴里去,让他一定会调用浏览器这个工具。但他没讲具体实现细节,就是他很有可能是一个 sidecar 的实现,但是这个我感觉都是非常 detail 的东西了,但我觉得意图识别是重要的,只不过过去的那种先叠一层意图模型那种实现,通常来说他不太 agentic,他会带来很多新的问题。比如说你的这个 message 要怎么样在多个不同的子模型之间去分享。因为你叠了一个意图模型之后,你下面的看到的那个上下文是割裂的。就是你怎么样解决类似这样一系列的问题。我觉得这工程对工程上来说是一个挺灾难的东西。对,这个我们有一些探索吧,但也还在进行中。
潘乱:
OK, 哎,高策。现在最难招聘的岗位是什么?就是当你们要去做 Personal Agent,然后这其实是个新领域,然后他其实就侧面印证出来今天干 Personal Agent,他最稀缺的能力是什么吗?
高策:
我有一个梦想是能够请 Peak 过来。其实我感觉最缺的是...
潘乱:
哪个 Peak 啊?
高策:
Manus 的 Peak。我们缺少一些非常了解 Agent 或者说 Harness 本身,加上他又了解模型,因为很多你对 Harness 的优化其实是需要知道模型是怎么工作的,然后你知道模型是什么工作前提下,你才能去更好的去优化它。这两点是都很重要的,然后另外就是能够再懂一点产品。因为本身我是非常坚定的认为产品的价值是,包括我们看其实二三年开始那个时候是模型级产品,就 ChatGPT 刚出的时候,它只需要有个模型就行了。但是随着时间发展,未来有了 Claude Code,其实 Anthropic 完全是靠着它的 Harness,靠着它产品在卖 Token,当然它 2B 可能不算。但是就是产品的价值尤其是在模型都已经非常不错已经接近 AGI 的这个程度下产品的价值我觉得是越来越大的。这样的话像他如果再懂一点产品就能够很好的帮助一家公司像不管是你是做 Personal Agent 还是你是做 Manus 那样的 Work Agent 还是做任何其他的东西。都能够更加端到端的去做一整个的 Codesign,就联合设计和优化来解决非常多的问题。当然我觉得这样的人是稀缺的,而且我感觉在一家公司里其实每一个角色都应该是这三方面或多或少了解一些。但比如说是各有侧重的,比如说产品经理他可能需要了解一些更多的了解产品设计上的一些内容,但他也肯定要知道这个 Harness 是什么东西,然后模型他大概能做到什么程度。以及 Variation 与 Harness 要怎么样结合起来。但是它可能更侧重在产品设计,工程的话可能更侧重在比如说偏工程的那部分。但是这三方面的知识我觉得都是不可或缺的,尤其在现在竞争非常白热化的这种 Agent 市场里面,我觉得这样的人是非常稀缺的。
潘乱:
你说模型,你反复说模型都接近 AGR 了,但你要去不断的,因为你得去调度不同的模型吧。就是模型能力跟价格变化这么快,我好奇就是你选供应商的时候你看中啥呢?
高策:
很多方面首先它得表现好,表现好也就是说在 Bench 上,在我们自己的 Bench 上能跑。
潘乱:
哪些模型在哪些类别你觉得表现好?
高策:
DeepSeek 在 Deep Research 上作为 Sub-agents 表现挺好的。当然这个表现好,还有一方面是 Deepseek 它实在太快了,然后它那个成本又挺低的。就是 Deepseek 真的是一家很厉害的模型公司,Respect。然后 Kimi 和 GLM 这个大的模型,Kimi K3 和 GLM 5.3。在长程任务上的表现是挺好的,甚至可能确实不列于海外的之前的次时代骚打模型,就是什么 Opus 4.8 或者啥的。在交互上,坦白说交互上感觉大家都不太行,然后另外就是大家在指令一层上通常来说开源模型会差一些,尤其是在交互那层的指令一层,比如说你跟他说你说话短一点吧。一般大家都不会短,因为这个感觉是被训练出来的东西,你很难通过 SP 来调整它。所以模型虽然说是它智能是 AGI 了,但它很多这种细微的表现,你不自己做模型还是很难去优化它,因为它跟它整个的训练 Pattern 有关系。它已经被训练成那样了,你很难在推理时再把它抢救回来。
潘乱:
OK,我们这里聊的是意图,聊的是记忆啊。
高策:
在记忆这个场景下,隐私也是非常重要的,因为当你收到了用户非常多的 Context 之后,你怎么样能够保证你不会侵犯用户的隐私,这个其实是一个非常重要的问题。我们现在做的设计是你可以删除记忆里面的任何内容和任何文件,并且这个记忆是完全向你透明的,你能够看到我们记了什么。以及在记录的过程中,我们会非常清晰地告诉你我们在记录哪些内容。并且同时在你注销账号或者是当你去不再使用 Today 的时候,你是可以选择把记忆全部清空的。这个是我们认为非常重要的一个东西,因为 Personal Agent 里面隐私问题一定是慢慢会成为一个比较突出的问题,如何能够更好的保护用户隐私是我们非常关键的事情。
潘乱:
主动这一块呢,主动服务这一块,就是什么是好的主动,就是怎么让你的主动更愿意让用户接受它又显得不像是骚扰,或者说 Today 的主动性它体现在哪里?
01:10 - 01:20
Suki:
我还是举 Use Case 吧,就是一个是信息获取上面的主动。就是我前面聊过的,就是如果你给他聊了非常多的 Contest,他对你的兴趣爱好相关有理解的话,他会主动进行 Web Search。然后会把相关的信息推到你的面前,然后这是一种信息获取上面的主动。还有一种是主动做事的主动,他连了你的 Calendar 连了你的日程之后,他知道你每天的日程安排是什么样子的。他会在时间发生的前一个节点告诉你这个事件即将发生或者是他有什么提前可以帮你去做的东西。然后我们非常典型的就是会前准备这个主动。然后还有类主动其实我觉得非常 Aha Moment 的地方在于多类事件交叉的一种主动。怎么理解呢?就是我既在 Today 上管理了我的健康数据,又管理了我的工作数据,然后他会把这两个东西,Context 融合在一起,然后他有一天就会,我记得有一个非常啊哈的场景,就是我让他去给我推荐保健品。其他的保健品只会罗列功能,但是他就直接推荐说你应该吃维生素 D,因为你的平时的工作时长太长了,日照时间太短,而维生素 D 能够很好地帮你补充这部分的营养,所以他在交叉事件上面的主动性我觉得是做得非常好的。
潘乱:
你们做了信息获取、早晚报这种的事情,的确挺有用的。我在不断地它给我增加更新的频率,然后它现在变得已经基本上像一个 AI 简报了,然后还能够跟我日常的工作跟日程结合起来的那种针对性的给我曝光信息。然后一些重要事件的提醒以及一些任务推荐。我理解是要给每一种主动性都有去做优化的,对吧?
高策:
我觉得大家对于 Proactive 是个开放的问题,你怎么做它都是有正向的,只不过它那个正向的好多或者少是不一样的。我觉得这里架构包括策略都是会迭代非常非常快的,因为它核心解决的一个问题是怎么样……在以最小的摩擦成本和信息干扰的前提下,做出信息密度最高的、最可能让你有兴趣的事情的推送。其实就解决这一个问题。那解决这个问题的角度,有一种选择可能就是你相信模型的泛化性。你认为模型什么事情都能把事情做好,你只要把 context 给它就行了。这种其实很适合你自己训练一个模型。就是你如果能把你的各种各样的偏好训练,甚至比如说你一个人一个模型,它其实某种意义上能够起到最好的个人偏好的依从性。这个其实是,比如说美国有家公司叫 River.ai,它就是相当于是它给每个人训一个模型,反正是那个模型跑在你自己的那个你要买一台挺贵的机器,反正是给你跑起来,那也算是一种做法。另外一种做法可能就是说你不完全白印模型,或者你认为现在这个阶段模型的泛化性还没有那么好,你就是通过一些人类的 Rubrics 来去引导它,这个就是说的产品经理的价值。而且我现在自己感觉模型泛化性没有想象中那么强,以及我们从工程的角度来看,成本也是你不得不考量的一个东西。但这个我觉得我的观点是一个礼拜会变一次,所以可能下个礼拜我们再聊观点又不一样了,所以就现在来看我觉得靠人类的设计可能在短时间内能取得更好的效果。
潘乱:
那怎么让这种主动性真的帮用户减负,而不是增加新的待办?我举例来说,比如我们这场来完之后,他很可能通过 AI 总结会生成几个新的待办,对吧?你能不能直接把我干了?因为有些活命你就可以把它干了吗?你要生成那些待办能不能直接变成任务?那些任务他能不能 AI 自动跑?
高策:
是,我觉得这就是未来发展的方向。就是,它一定是帮你做更多的事情,然后你最后只需要 approve 它,最后那个结果,或者说你只需要 verify 结果对还是不对就行了。尤其是当 token 成本变得越来越低的时候。因为就算帮你做错了事情,你不必去做错。你拒绝了那个东西,它也其实没有多少成本。那到那个时候一定是帮你做更多的执行是最好的。但只要保证这个执行是没有副作用的。对,所以这个也是我相信是不管是 Instinct 还是 Muse,包括我们都是会做的一个方向。但是现在就是它还没有被做得很好的一个很重要的一个原因是你这个场景拍脑袋你就感觉你做了它可能会有挺多 bad case 的。对。
潘乱:
就是你可能你那个东西其实你本身就不关心,完事又帮你做了,然后又来打扰你。你让我确认一下嘛,比如我点一下,我确认一下,你再跑。就我现在老觉得你像各家公司都推那些录音的硬件嘛,然后帮你这个主打 Summary 这种东西,然后宣称这个 AI 能力有多强多强。这感觉就跟听那个学会上网的感觉一样的,今天听起来难道你那个就是出了那个 Summary 里面不应该再往前来多干点活吗,对吧?
高策:
是的,是应该做的。但这个其实我觉得最终形态,它应该在执行的时候都不需要你 approve,因为你需要你 approve 本身也是一种打扰。就是你做的足够好的情况下,就不需要你关心。就像 Claude Code 或者 Codex 一样,它有一个 automatic 的一个 mode,它会根据你之前同意权限的那个历史,它会学习。学习知道你对于什么样的命令,你是通常来说是通过的,完事你就再遇到这样的命令,它就不会问你了。类似这样的一些优化其实都是产品上和工程上的一些优化,我觉得是一定是重要的,也是产品的价值之一。其实都应该类似于提醒、准备、确认、执行,就是这个电路应该是在更多的主动型的任务里面,就是 Agent 完成这个闭环才是 Personal Agent 往下一阶段走的那个标志,对吧?是的,因为相当于是执行是最重要的事情。现在其实绝大多数 Personal Agent 其实在面向的是信息的获取的需求。比如说我会用它去问一问最近有什么我可能关注的演唱会,它可能对我的记忆能给我列出来,以及哪些有票它其实可能能做到。但是帮我抢票这件事情,其实这个才是我关心的。比如我就跟他说我对这个演唱会感兴趣,你直接给我买张票吧。或许也需要更多的高频道交付,然后跟用户跟 Agent 确认什么是低风险的,你可以做的什么是我必须确认的,类似于这种。
潘乱:
是的,这个肯定是未来发展的方向。那你想想,当一个 Personal Agent 更像人的时候,怎么让他少说废话呢?
高策:
我觉得只能从模型训练的角度去解决。
潘乱:
现在比如说,很明显一个观察是,模型都很爱说废话,尤其是开源模型,因为他说废话是有好处的。我用最简单、最直白、最不知道弯子的,啊你真的太棒了,啊我好的我错了。
高策:
对,就是因为他要解决很多任务嘛,那些任务你 token 越多,他相当于是他思考时间越长,他思考的东西越多,他大概率那个任务完成率会越高。但是在 Personal Agent 这个场景其实很不一样,你说话多,你是提高了我的认知的负担,我肯定是希望你最可能好。所以如何有一个好的 Chat 上的交互体验,本身我觉得是需要非常重视体验的一个模型才能做到。其实海外有一些这样的模型在探索了,但是我觉得这个最终要解决这个问题,我觉得还是要模型来解决。而且模型大概率应该能解决这个问题,只是说大家现在 Personal Agent 自己 PMF 都没有,然后给你整个模型专门干这个,就是划不来。可能它是个短期问题。
潘乱:
OK 那我们聊回行业,你看虽然现在 PMF 都没有,但是架不住资本啊,各种资源啊,大厂啊已经全部都涌过来了。对吧,当然这场竞争才刚刚开始啊,然后今天我们看到最狂热的部分,可能等到几年后,也许还不够狂野,有可能啊,因为我们像过往可能看比特币,看那个最初我们在看 AI 的时候都可能有类似观念,我印象比较深,就前两年大家都吐槽阿里买 Kimi 40% 的股份,我早觉得冤大头。
高策:
然后那时候朱小虎他们不是说巴拉巴拉各种的东西吗?哎呀今天回看,哎呀,转麻了。哎,这个又完全不一样了。就是我们这个视野肯定要,以及观点要随着时间不断被修正。
潘乱:
今天 Pencil 和 Azure 它竞争才刚刚开始,但是刚刚开始的时候,摆在你们面前,至少中国去你们是第一个发的,但是在海外已经摆了一堆了。对吧,你像 Muse、Instinct 包括我们刚才聊的 Town。我好奇,但是今天因为都刚开始,所以不应该认为任何人已经有了不可追赶的差异,什么优势的东西。但是各自都得还得从自我这个角度出发嘛。是。然后譬如说我们要强调我们的长处去补足我们的短处。对。那今天来说就是首先你的目标、你的重点,你觉得你们有没有差异?然后在这个方向上,哎,你的优势是什么?然后你们要补什么?
01:20 - 01:30
高策:
很难回答的问题,就是我们看这个场景上我觉得唯一一家有优势的,确实他做的好的是 Muse。Muse 确实他在各个层面主要他有钱,我觉得他有钱是最大的优势。
潘乱:
24 小时的云电脑,你们行吗?你们扛得住吗?
高策:
顶不住,肯定顶不住。而且你看它的架构实现有很多缺陷,或者说它架构实现成本就很高。它是 Agent in the Sandbox 的实现,它发了篇博客,那个架构实现就成本非常高,相当于是你只要用它,那个电脑就在那边跑着。
潘乱:
我一直好奇,这到底是技术有限,还就是刻意用这个高的成本把这个竞争门槛给它抬高。你说技术有限,我又觉得不对劲,这不是一个多难的技术,对吧?就是释放内存这些事情。他肯定会超卖的,他肯定不给你一个物理意义上的机器,他肯定是一个 virtual 的虚拟的机器,但就算超卖,这个架构下,它也是成本高的,也是成本高的,而且你只能说扎克伯格是有钱一级,他确实认为这个东西是正确的,而且这样一个架构好的地方是他迭代快,他可能迭代快。因为那个架构就让他很独立,像是服务你的 Harness 就服务你一个用户,这个进程就服务你一个人,然后他很多多租户的杂度他其实不需要考虑的。
高策:
那这种层面上,他迭代的速度其实可能会有所收益,而且可能从 Meta 的角度来讲,这些收益跟成本相比收益更重要,因为 Meta 有钱嘛。所以我觉得 Meta 确实是现在看起来它的 Traction 是非常非常好的。但是就算是这样,我感觉对于创业公司来说,我觉得它的做法可能应该学习 Town。因为现在变化太快了,大家都在做中学。然后现在看到的是 Town 那种……Town 已经不是优等生了,今天我们都只看 Instinct 跟 Muse,你发现很少有人会讨论 Town,尽管它产品完成度最高。对,这个就是我觉得是短时间内大家确实是高估这个领域的,但是长时间它可能是被低估的,但短时间我觉得是非常被高估的,因为你比如说 Instinct 现在这个程度,就它 100 亿估值融个应该是融一个 billion 吧,应该是融 10 亿吧,很吓人,就是不管在什么地方,这都是一个非常 hype 的一个阶段。在这样的一个阶段里面,Instinct 和 Muse 可能会被投射到了非常多的关注和认可。但是长期来看,大家最后都是回归到一个理性的市场。在这个市场上,你的商业模式要做什么样的选择?因为现在我觉得商业模式都还不确定。对,其实 Town 那个商业模式可能适合创业公司。就卖订阅,然后从一个 niche 的需求出发,也不太 niche,就反正是从一个具体的 connector 的角度出发,就 email 这个场景出发。然后你把这个场景优化好了,那付费意愿就强了。它甚至是在一个工具类产品的一个付费转化,或者是一个方式在 scale 自己。就那个是跟你那个 Personal Agent 很不一样,包括你投流什么的都会好做很多。
潘乱:
你想你这文章文档相比我们一上来哄他去试这个对于威斯的吸引力那就弱了很多嘛对吧
高策:
对是的是的就这个 trade off 了但是我自己的观点我现在看起来就是这个领域短时间内确实太过热了但是长时间内呢我觉得他肯定又是被低估的对但是就是在这个短时间被高估的情况下我还是挺乐观的我就感觉刚开始大家现在都还在摸索你甚至现在你融的越多,你 Scale 的越大,你的 Paper 或者说你改变的那个空间余地,或者说你改变的速度也会更慢。就在这样的一个刚刚开始的市场里面,我觉得就是前途未卜,都还有很大的可能性,我现在看的也不是特别清楚。我现在我自己可能因为我自己之前创业做事情比较确定性,我会很偏好 Town 这样的公司。我感觉他在真实的做事情完事以后,他又是一个很 solid 的场景,然后付费转化又不错。就他是一个一步一步能一点一点 scale 起来的东西。另一方面,我也被这个市场教育的一个观点是说,这个领域本身就是一个很大的领域,你就是应该超前投入,你就是应该融非常非常多的钱,你就是要疯狂 scale,然后你先别管 PMF,你就先做 Attraction,先做增长,先做 DAU 这样的东西。
潘乱:
你不是在字节待过吗?字节不一直都是一套方法论吗?就是我现在算一下未来市场有多大,然后我从用未来的市场的假设来投今天,然后把竞争的时候全部都消耗死。
高策:
是的,我以前也没做过这种事情,我只是现在还在学习,现在确实还在学习。
潘乱:
OK。Suki。
Suki:
我想我对这个事情的思考就是出创公司可能就是有两类打法,一类打法就是广度打法,然后一类打法是深度打法,然后广度打法让我想起一家公司叫 Notion。Notion 其实当时做这个文档产品的时候,它其实提出了一个非常所有人都理解不了的概念叫 Blocker。但是这个 Block 非常强,它有极强的通用能力。它就有点像是我们今天给 Agent 提供的各种各样的通用的底层的能力。Notion 当时就不定义场景,然后让用户自己去玩起来,然后去帮助他们的团队去发现需求。第二点就是他们把他们的使用方法作为一种传播的手段,让 KOL 通过社区互相启发的方式搞起来。第三点就是他们在社区里面去积累他们的各种各样的模板,然后去降低第二层传播的一个使用门槛。搞了非常多一键套模板的功能,然后我记得那个 Notion 我当年其实都用过非常多的模板。当时我记得 Notion 有个国区负责人,然后他们就搞了一万多个模板让其他用户去复制去 copy。这是一套玩法,就是广度的玩法。然后但是我觉得广度的玩法其实也要资源,要时间,要非常多的成本去铺开,然后才有可能在 Scaling Law 转起来。然后还有一件事情就是我觉得今天这件事情不一定非常 make sense 就是我们在做 Personal Agent 这个方向它的一件套模板有可能因为每个人的需求非常的个性化这件事情有可能成立不起来所以这可能是广度方向上面的问题但是我们肯定也在探索然后另外一个就是深度方向深度方向可能刚刚高老师就已经补充非常多了,就是 Town 的那种方式,我们先找到一个非常高频的场景,然后先把他们最在意的事情先做透。然后这个东西就是把某一个场景的那个高频的最大的门槛先解决掉,然后我们通过一个非常核心的人群再扩全,然后这可能也是另外一种玩法。
高策:
对,其实实际上我们看 Town 或者是,我觉得两款产品我很喜欢,一款是 Town,一款是 CloudTag。它的形态其实都是过拟合在它所想要支持的那个软件的 workflow 里面的。CloudTag 它是过拟合在 Slack 里面的。它的记忆的设计其实它会有比如说 Channel Level 的记忆,还有 Thread Level 的记忆。他的记忆系统都是为 Slack 设计的。然后 Town 其实你真正用 Town 的话你会发现你不需要离开那个 Gmail 的那个编辑窗口,你甚至不需要进到 Town 的那个 Dashboard 里面,你就可以用到绝大多数 Town 的能力了。他会把所有的 Draft 都写到你的那个草稿箱里面。就他非常深入的进入到了你的 Workflow 里面,而且他的那个摩擦成本很低,因为你这就是在你原本的那个工作界面里面。所以那个东西它可能它会更确定性一点。这是我看到的比较深的场景里面做的比较好的两个产品。对,而且我觉得现在 AI 圈有一种就是过度营销的趋势,就是很容易就推出另外一个产品说我颠覆你过去所有的使用场景,然后所有东西我都能做,就是这种过度营销会导致用户对 AI 产品更加不信任,但是现在很少有产品说我真的能把你一件事情 end to end 做到底,然后你真的一点都不用操心了。
潘乱:
高策你更看好 Town 这一类,或者说你更偏好情感上。因为你自己之前是一个创业者,就是我们具体来看,不管是健康、理财、学习,哪怕教育,其实各自都有自己的清楚的需求跟他的专业的边界。你做单一的垂直的 Agent 看起来更容易让用户来理解,也更容易去验证你产品的价值。但你们不是这么做的吧?我理解。你们做的是横向来做的,去把他的工作、家庭、生活是争取在多方面去做的。
高策:
对,是的,这是个非常非常好的问题。就是我的观点是说从通用往 Niche 做,比从 Niche 往通用做更好。其实 Town 也是个通用的产品。它其实也有比如说能够在 WhatsApp 里面去使用,以及它有很多不同的 Interface。它其实也是个 Personal Agent。它只不过它找到了一个 Killer Feature,是 Email。对,它其实是个有非常独特的 Killer Feature 的 Personal Agent。这相当于是但它的实现路径也是从通用开始做,然后在某一个特殊的 niche 场景它做得格外好。这个是我白印的逻辑,但是你从一个真正 niche 的场景做单一的锤类的 Agent,我觉得那个很危险。因为对,是的,会很容易过拟合,然后没办法往另外一个人。
潘乱:
看看移动互联网时代那些垂直社区那些垂直电商一个没火下来就 OK 了。
高策:
对,因为 Personal Agent 一定是最大的机会,一定是一个很大的入口级别。我觉得这个领域,算了,不发暴露了,就是这个机会非常非常大,以至于一旦你成为了这个领域里面的最重要的玩家,你会有非常多被你吃掉的内持领域的产品或者是机会或者是市场。所以一定得先做通用,并且通用一个很好的,我们观察到一个很好的地方是,你 context 越多,然后你不同的场景上的 context 越多,它们其实本身是非常 diverse 的。比如说健康场景是一个非常差异化的 context,然后工作也是一个非常差异化的 context,这两个 context 是有化学反应的。然后它们的化学反应只能发生在通用这一层,如果你只做健康,你是看不到你的工作场景的 context 的。所以你做通用然后再把健康这些事情做好,比你从健康事情开始然后你再往上做工作场景,那个路径会更曲折一点。
01:30 - 01:40
潘乱:
但如果什么都做那其实就是什么都不生啊,样样通样送,对吧?对。就是肯定那个场景的选择它也有先后嘛。是的。就比如说今天他在哪些用户场景里面他比较 work,比如说一个早期用户,现在一个早期市场,然后 Today 还是第一个上线的独立的 Personal Agent 的产品。然后今天一个新红颈儿了,你觉得它我给你一周时间撑死了,对吧?你觉得 Today 可以帮我完成哪,譬如说三个场景三件事情,完成什么事情,它可能更容易让我感觉到这个产品是真有用的。
Suki:
我可以举几个非常典型的 case,而且这些 case 其实是非常不起眼的非常小事,比如说 Today 去帮我约会,然后我现在在 Today 里面的体验就是下午几点,然后约谁谁谁,然后呢,这样子的话,他直接把我的 Kalendar 全都 book 好,并且把邮件都发出去,这些东西我完全不需要做,这是一点,而且他知道了我的所有同事的联系方式,随着我的使用的深入。还有一类就是我和同事之间的协同沟通。然后我现在的典型使用场景就是开始 Recording 跟他们一同聊,聊完之后我就直接布置下去了。然后他就会把这些东西带着上下文分发给我的所有的同事们。这是还有一类使用场景。然后我觉得这么概括这一类场景为什么之前我不会让我的 Kodas 去做?就是我绝对不可能让我的 Kodas 去帮我约会的。我觉得是因为今天的 Today 它的这一套记忆和主动性的设计的机制让它的委托成本低于我完成这些小而不起眼的事情的总成本。这件事情发生之后,让很多事情我有可能交给 AI 去做。因为过去我可能会飞很多的口舌,然后这些东西我就懒得让 Agent 去搞了。这是我的一个观察。
高策:
我其实的观点是,如果它作为一个,比如说其实 Muse 也类似啊,如果它作为一个 Better 的 OpenClaw,能够真正的触达到普通人,让这个应用的摩擦成本很低的情况下,deliver 到普通人,普通用户的面前,它已经是能泛化出非常多的价值了。因为它的使用体验非常好。然后像 Today 这样的产品,你 onboarding 之后,你可以以一个非常地摩擦的方式让用户用起来。我觉得已经因为绝大多普通人现在用的是 Chatbot 这样的产品。对。他去使用 Agent 产品然后感受到那个机器价值我觉得是非常自然发生的事情。这也是为什么 Muse 现在受到非常多的好评。但是比如说在 Early Adopter 这个眼里,他可能就是一个我好像自己搭一个 OpenClaw 也能用,甚至我用 Grok Bot 可能更好一点。对,因为这个是感觉很不同的两个群体。就是 Early Adopter 和 Late Audience 这中间是有 gap 的。但是另外一方面就是 Personal Agent 它有点被催熟了。就是虽然这个还没有进入到后期大众里面,但是资本市场已经很火热了。或者说在 AI Builder 这样的群体,在早期大众里面它已经很火热了。所以这其实包括我们看比如说很多人就说 Muse 可能看起来就是个 OpenClaw 。有很多这样的疑问和问题。但这个我感觉就是不同的受众和人群会对一个产品有完全不同的观点的一个很真实的体现。所以具体到 Today 这件事情上,我使用 Today 能够帮我去,假设我带入到普通人的视角,虽然可能有偏见或者说有 bias,因为我已经相对了解了。但是假设我自己想象我是个大众的用户,然后我进来以后他很快给我推我感兴趣的演唱会,或者我感兴趣的插画节。然后能够从对我的了解里面给我以非常主动的方式跟我很快的聊起来。然后这个聊天的体验同时又比其他的 Chatbot 类的产品要好很多。然后它是一个相对拟人一点的一个交互体验。我觉得这个已经有同时它的价格不太离谱的话。甚至如果是一个像 Muse 那样免费使用的话。那一定是一个有正向价值的产品。
Suki:
还有一类类型就是前面讲到可能是那种高委托成本的那种小事、琐事。然后还有一类类型我觉得在这种 Agent 里面做会更合适的就是你有长期目标、长期需要跟踪的事情。比如说学习,然后比如说健身这一类,它可能是贯彻在你的生命里面的一个周期的事情,它不是你发起一个 Task,然后他交付给你一个 PPT,就立马结束的这种东西,然后它非常适合在有一个长期记忆的 Agent 里面去做。我举一个我学外语的例子,就比如说,我可能要去学一门外语,这个时候我会跟他沟通一个我的学习的目标,以及我当前的学习的进程,然后他就会记住,并且结合我现在的情况给我制定一个非常长周期的一个学习计划。这个长周期的计划,它会自己设定很多 Schedule Task,并且给我做非常个性化的一个课程。这个东西是一个非常长期的、非常需要时时和我交互、获得我反馈的一个任务。而且他现在会在这些个性化的日程里面学习我现在学的进度可能最近有点 delay 因为工作上面的一些进展,然后他就会把这些日程调得更加松散一点。或者是他最近发现我可能不太关心这个领域方面的学习了,我可能更关心另外一个领域方面的学习,然后这个时候他就会调整他的课程。这些东西是需要用户持续个性化的反馈并且长周期的跟踪的话,我觉得这种体验会显著的比 CodeX 这类的产品好很多。
潘乱:
OK,那我们最后一个问题吧,就是你们期望以后用户在使用过一段时间之后提起 Today,他应该如何描述他,或者你们希望能够听到什么样的反馈,那句话可能是什么?
Suki:
我很喜欢我们团队之前想的一个 slogan 就是 Today is your day 然后我们希望 Today 不是给你带来另外一个 AI 焦虑的一个产品,而是它会主动认识你、理解你的另外一个朋友。
高策:
我的观点也类似,我会希望被记住的是说,这个世界上有一款产品,它是为了降低对你注意力的干扰而存在的 AI 产品,而不是 Yet Another 产品为了给你推送更多的内容和消息而存在的这么一款产品。希望它未来被提及的时候是说,这个东西让我有了更多的时间去生活、去散步、去踢球,而不是说有了之后我工作效率又变高了,我可以做更多的工作了。
潘乱:
的确 Today 在帮助人去处理生活琐事这个方面,目前看到发挥能够更多的作用,因为在工作体校这个层面上,你工作体校只会让你去接受更多的任务,但是日常杂事审出来的时间内真的就是属于我们自己,我们的确可以用它再去进行更多的自我探索也好,或者说生活的体验也好。今天是 Today 刚刚上线,我们一起聊聊这一期。我们希望以后在 Today 有新的产品阶段或者发布的时候,我们再来继续讨论。好的。我们今天就先到这边。
Suki:
谢谢潘乱老师。拜拜。
References
- 1277.从提醒你,到替你办:Today想把Personal AI带到哪一步?|乱翻书|小宇宙
xiaoyuzhoufm.com
- 2齐俊元|百度百科
baike.baidu.com
- 3275.AI办公的热闹还没散,个人Agent的战争已经开始|拆解Town、Instinct、Grok Bot与Muse|小宇宙
xiaoyuzhoufm.com
- 4对话 Today AI|赛博禅心,腾讯新闻
news.qq.com
- 5Today|官方网站
todayai.cn
- 6Manus 宣布正式恢复独立运营,创始人肖弘及团队留任|IT之家
baijiahao.baidu.com
- 7
- 8
- 9Today AI|百度百科
baike.baidu.com
- 10豆包PC端前负责人,创业Agent操作系统|量子位,新浪财经
finance.sina.cn
- 11
- 12Meta刚登顶,千问就交卷!3亿人的个人AI助理要来了|新智元
baijiahao.baidu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 别把「做完」当成「好」:Stripe 设计负责人 Katie Dill 谈 AI 时代的僵尸 UI|Lenny's Podcast
- 先把产品当一个实验室:Dan Shipper 谈怎么同时探索前沿和交付|Lenny's Podcast
- 交付得更多,就一定更有用吗:Claire Vo 谈为什么要写最后一份路线图|Lenny's Podcast
- 变色龙、女同酒吧与《搏击俱乐部》:Reason《Freed Up》第 44 期谈佩尔托拉丑闻、择校与监狱史
- 从抖音、猫箱到动念引线:梁琛奇押注的 AI 娱乐三个变量
- 一张两万块的床套,正在申请成为医疗器械
- 推理芯片的三条路:Groq 的 SRAM、Cerebras 的整片晶圆,和 OpenAI 九个月的流片
- 中国入世、打仗不加税、救银行:斯卡拉穆奇复盘三步如何造出特朗普