AI 论文早报|8 月 31 日:从失败模式、低成本训练到城市尺度,能力要怎样才算能用
本期精选 5 篇新论文,比较失败模式检索、低成本预训练、跨具身物理先验、城市空间代理与企业时序知识库的证据边界。

今日看点总览
本期选取北京时间 8 月 28 日凌晨进入 arXiv 的 5 篇 AI 论文。它们分别从推理反馈、训练成本、跨具身物理先验、城市尺度导航和企业知识库问答切入,指向同一个实际问题:模型得到能力之后,怎样把能力变成可检查、可迁移、可持续使用的行为。论文原文与提交信息分别见 CritICL、Puro-2B、CLAP、UrbanGround 和 CorporateBench。
| 论文 | 主要问题 | 关键证据 | 更适合谁先读 |
|---|---|---|---|
| CritICL | 弱模型的错误能否帮助强模型少花推理预算 | 72B 模型平均分 59.2;单次生成约 3,768 tokens | 做推理、测试时扩展和评测的人 |
| Puro-2B | 小规模预训练怎样降低硬件与资金门槛 | 约 2B 参数、1.4T tokens;作者报告最佳训练成本低于 6.9K 美元 | 做开源模型训练和数据配方的人 |
| CLAP | 不同机器人和人类视频能否共同学习物理先验 | 用潜在动作吸收无标签视频,再落到末端执行器动作 | 做机器人学习、视频世界模型和具身智能的人 |
| UrbanGround | 局部街景理解能否组合成城市尺度持续行动 | 810 个手工验证实例、5 层评测阶梯、100 步交互上限 | 做空间智能和多模态智能体评测的人 |
| CorporateBench | 模型能否在数十万企业文档中追踪实体与时间关系 | 263,466 篇文档;时序关系抽取随公司规模明显下降 | 做长上下文、RAG 和企业智能体的人 |
1. CritICL:把弱模型的失败模式变成强模型的提示
论文与来源
作者:Yufan Wu、Yinghui He、Zhengyi Hu、Lang Wei、Ruichen Li、Qifan Yang、Ting Zhu。机构:论文页面未列出。版本:arXiv v1,论文详情页显示发表于 2026 年 8 月 27 日;换算为北京时间是 8 月 28 日凌晨。论文同时公开了 代码仓库。1
问题背景
测试时扩展通常让模型多生成几份答案,再用多数投票、自我反思或外部评审挑出结果。答案数量增加以后,推理 token 和延迟也会增加。CritICL 观察到,同一家族的弱模型与强模型会出现相似的错误类型,例如错误假设、公式错误、单位错误和误解题意。2
论文的问题因此变成:弱模型的失败记录能否提前告诉强模型「这道题最容易在哪里出错」,让强模型用一次更有针对性的提示替代多次盲目生成?
方法要点
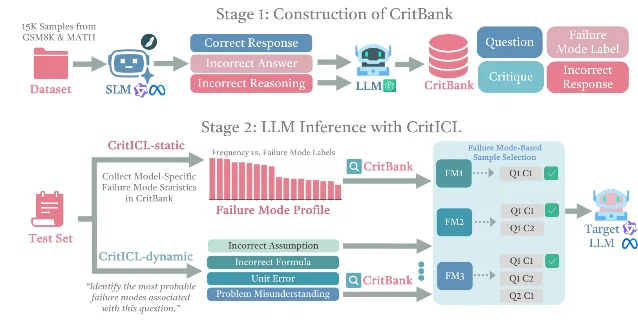
CritICL 先让 Qwen2.5-1.5B、3B、7B 等弱模型在 GSM8K 和 MATH 上生成答案,再把错误回答交给 GPT-4o-mini 生成 critique 和失败模式标签。作者将这些问答、批评和标签存入 CritBank,并通过聚类减少重复标签。2
推理时有两条路径:
- CritICL-dynamic 先预测当前题目可能触发的失败模式,再检索对应的 critique 示例。
- CritICL-static 使用同一家族弱模型在 CritBank 中形成的整体失败模式分布,给目标模型提供较稳定的提示。
两条路径都按失败模式选择示例,而不是只做随机抽样、固定抽样或语义相似检索。模型因此先得到「容易错在哪里」的上下文,再生成最终答案。2
结果亮点
在论文报告的综合 Pass@1 结果中,Qwen2.5-32B 的 CritICL-static 平均分为 49.8,CritICL-dynamic 为 49.1;Consistency@7 为 49.5,LLM-as-Judge 为 49.0,5-shot 固定示例为 46.0。Qwen2.5-72B 上,CritICL-static 为 59.2,dynamic 为 58.7,Consistency@5 为 59.0,LLM-as-Judge 为 58.5,5-shot 固定示例为 56.3。2
token 成本的差别更直观。在 MATH、Qwen2.5-32B 设置下,CritICL-static 只生成一次,总 token 为 3,768;dynamic 生成两次,总 token 为 3,897。Consistency@3、@5、@7 分别需要 4,192、4,814、5,440 tokens,Self-Reflection 需要 7,533 tokens,LLM-as-Judge 需要 6,465 tokens。2
消融结果说明,收益主要来自失败模式匹配。以 Qwen2.5-72B 为目标模型,CritICL-static/dynamic 在 GSM8K 上的准确率为 93.6% / 93.0%,随机检索为 87.4%;在 MATH 上为 59.2% / 58.6%,随机检索为 53.1%;在 AIME25 上为 17.9% / 17.5%,随机检索为 13.2%。固定示例和语义相似检索也低于失败模式检索。2
适用边界
CritBank 需要弱模型离线生成错误样本,还需要 GPT-4o-mini 做批评和标签;这部分准备成本没有被一次推理 token 数覆盖。论文的主要实验集中在数学推理,附录报告了化学、生物等任务的扩展结果,但跨领域稳定性仍需要更多独立评测。论文是 arXiv 预印本,当前证据适合支持「失败模式感知检索能降低特定实验设置下的推理成本」这一范围更窄的判断。2
一句话阅读价值
如果你已经在用 self-consistency 或 self-reflection,CritICL 值得先看它怎样把「多生成几次」改成「先找出最可能的错误类型」。
2. Puro-2B:把小模型预训练做成一笔可核算的账
论文与来源
作者:Kairong Luo、Jiarui Cui、Yaorui Yin、Shengqi Chen、Yiming Yang、Linxiang Gao、Yanmohan Wang、Mingzhe Zhang、Kaiyue Wen、Kaifeng Lyu、Wenguang Chen。机构:论文页面未列出。版本:arXiv v1,论文详情页显示发表于 2026 年 8 月 27 日;换算为北京时间是 8 月 28 日凌晨。作者公开了 训练代码、数据清单 和 模型集合。3
问题背景
开放权重模型的预训练成本经常把研究限制在少数拥有大规模 GPU 集群的团队。Puro-2B 选择了约 2B 参数模型,尝试回答一个更具体的问题:消费级 RTX 5090、低精度训练和一套公开配方,能否把从零开始预训练的成本降到学术团队可以核算和复现的范围?4
方法要点
Puro-2B 使用基于 Qwen3-1.7B 配置的 dense decoder-only Transformer,将输入 embedding 与输出 LM head 解耦,总参数量约 2B。训练分为两个阶段:第一阶段使用 438.84B tokens,第二阶段使用规范配方再训练 959.99B tokens;完整调度量约 1.4T tokens。序列长度为 4,096,全局 batch size 为 1,536。4
硬件侧使用 RTX 5090 集群和 blockwise FP8。对矩阵参数,作者使用 MuonH 与 hyperball 约束;其余参数使用 AdamW。第二阶段按照数据源内评分排序为粗粒度课程块,最后 29B tokens 使用恒定学习率,再平均最后 6 个检查点形成最终模型。4
结果亮点
作者报告,最佳 Puro-2B 在数学、代码、推理和知识共 15 项评测上的平均表现超过 Qwen2-1.5B,并接近 Qwen2.5-1.5B。作者拟合的 Puro Cost Scaling Law 还显示,约 4.4K 美元的训练成本足以达到 Qwen2-1.5B 的平均表现。4
成本数字需要连同口径一起看:规范版 Puro-2B 的作者估算成本约为 6.9K 美元,包含第一阶段约 1.84K 美元和第二阶段约 5.05K 美元;均匀数据版本约为 4.4K 美元。作者报告,第二阶段的数据课程相对均匀数据配方带来 1.65 倍成本效率,规范配方相对均匀缩放曲线带来 2.40 倍成本效率。4
适用边界
这里的成本是边际加速器成本,主要统计最终两阶段预训练的 GPU 时间。数据采集与处理、代理实验、消融和失败实验、后训练、评测、研究人力、CPU、存储与网络等都没有计入。论文还没有验证更大模型规模,部分数据组件的许可证是否宽松也需要读者单独检查。4
因此,6.9K 美元更适合被理解为「按论文配方重跑核心预训练的加速器预算」,而非完成一个可交付模型项目的全部费用。
一句话阅读价值
如果你关心开源模型怎样从数据、优化器、精度和硬件一起省钱,Puro-2B 比单报一个模型分数更值得读。
3. CLAP:先从无标签视频学物理,再对齐机器人动作
论文与来源
作者:Kechen Liu、Ola Shorinwa。机构:论文页面未列出。版本:arXiv v1,论文详情页显示发表于 2026 年 8 月 27 日;换算为北京时间是 8 月 28 日凌晨。作者公开了 项目主页 和 代码仓库。5
问题背景
动作条件视频模型通常围绕一种机器人具身训练。人类视频与不同机器人平台的视频拥有丰富的物理变化,却经常缺少统一的动作标签。若模型只能在带有同一种动作表示的数据上训练,模型从视频里学到的物理先验就很难迁移到另一种形态的执行者。6
方法要点
CLAP 用三种动作表示协调人类与机器人数据:末端执行器位姿、模板化语言动作和潜在动作。CLAP-EE 使用经过正向运动学映射的 7-DoF 末端执行器动作;CLAP-LANG 把数值动作转成语言模板;CLAP-LAM 使用 32 维 VAE 潜在动作,从无标签视频中学习会引起时空变化的因果表示。6
作者进一步提出课程式训练:先用 latent action 在无标签视频上学习物理先验,再用末端执行器动作在带标签数据上完成具身对齐。这样,模型可以先吸收跨人类与机器人视频的共同动力学,再为具体机器人补上可执行的动作接口。训练数据来自 Open X-Embodiment 和 EgoDex,单次训练使用 100K steps、有效 batch size 64,硬件为 8 张 H100 或 H200。6
结果亮点
在 DROID 环境中,论文报告 CLAP 接近或超过单具身视频模型 Ctrl-World;作者还展示了跨策略规划和强化学习策略微调可以提升 π0.5 与 MolmoAct-2 的真实机器人任务成功率。论文覆盖跨具身数据、DROID、Bridge、双臂 YAM 和 G1 人形机器人,并公开代码与模型。6
当前抓取到的论文正文摘要与图表说明没有呈现一组可直接抄录的成功率逐项数字,因此本文保留「接近或超过」和跨具身覆盖范围,完整百分比以原文实验表为准。6
适用边界
末端执行器动作需要带标签视频,难以直接扩展到无标签网络视频;语言动作受到 tokenizer 截断和数值精度的影响;潜在动作仍需要下游对齐到目标具身。作者还指出,跨具身模型要处理更大的形态差异,绝对动作空间尤其困难。6
「零样本物理模拟器」的含义也有条件:模型先在跨具身视频中学习,再以指定动作接口进行部署;它展示的是视频世界模型对策略评估和动作迁移的潜力,尚未替代真实硬件上的安全验证。
一句话阅读价值
如果你在做机器人视频预训练,CLAP 最值得看的地方是把「无标签视频能学什么」与「机器人动作怎样落地」拆成了两个阶段。
4. UrbanGround:局部街景能力,怎样走到城市尺度
论文与来源
作者:Tianjie Ju、Zheng Wu、Yueqing Sun、Yuhan Cui、Bobo Li、Shengqiong Wu、Pengzhou Cheng、Haodong Zhao、Zongru Wu、Xinbei Ma、Doris Zhang、Kunling Li、Mong-Li Lee、Wynne Hsu、Hao Fei、Qi Gu、Gongshen Liu、Zhuosheng Zhang。机构:论文页面未列出。版本:arXiv v1,论文详情页显示发表于 2026 年 8 月 27 日;换算为北京时间是 8 月 28 日凌晨。论文提供了 项目主页 和 代码仓库。7
问题背景
多模态模型可以识别街景、回答方向问题,也能在短距离内找到目标。城市代理还要把这些局部判断连续接起来:代理要记住走过的路,在地标消失后重新定位,处理路线变化和行人移动,并在多个目标之间保持方向一致。UrbanGround 关注的正是从「看懂一帧」到「持续走完一段路」之间的断层。7
方法要点
UrbanGround 使用香港特别行政区政府地政总署开放的 3D Visualisation Map 和 3D Pedestrian Network,在 Unity 中构建真实尺度的城市沙盒。代理通过第一人称 RGB 图像和交互式地图观察环境,可以选择移动、冲刺、转头、跳跃、打开地图,以及地图选择、平移、缩放和旋转等结构化动作。每轮只能选择一个动作,代理无法直接读取剩余距离、最短路径或路线 API。8
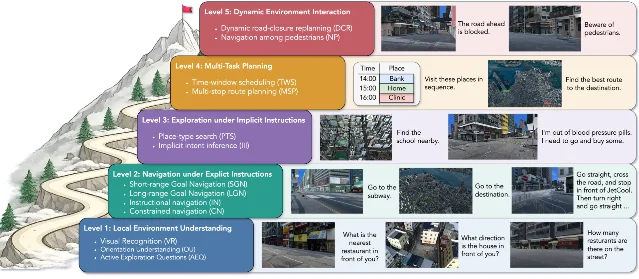
评测被拆成 5 层:局部环境理解、明确指令导航、隐含指令探索、多目标规划执行,以及道路封闭和行人避让等动态环境交互。论文在香港不同城区构造了 810 个手工验证基础实例,所有任务使用 100 步交互上限,移动动作每次最多持续 2 秒;导航成功条件是最终位置距离目标 15 米以内并满足任务约束。8
结果亮点
论文的方向性结论很清楚:当前多模态模型通常能完成有用的局部视觉识别和短距离空间推理,但方向判断、行人环境中的移动和长距离持续探索仍然脆弱。代理转过街角后,上一处地标可能消失;如果代理没有把新视图与已有路线重新对齐,误差就会在连续行动中累积。7
论文 HTML 当前抓取到的 Table 1 没有呈现完整的逐模型数值行,因此本文不补写答案准确率和行人网络遵循度的具体分数。读者可以把 810 个实例、100 步上限和 15 米成功条件当作评测边界,再到原文查看完整模型对比。8
适用边界
UrbanGround 是基于香港地理数据构建的交互式评测沙盒,适合测量城市尺度的空间代理能力,不能直接替代真实道路上的安全测试。模型在一个街角、一个短路线上的成功,也不能直接推出模型可以在开放城市中持续导航。当前论文把核心缺口定位在长程规划、状态更新和错误纠正的组合能力。8
一句话阅读价值
如果你的多模态智能体在单张街景上表现很好,UrbanGround 提供了一个更严格的问题:它能不能在地标不断消失的城市里,把局部判断接成一条完整行动链。
5. CorporateBench:企业文档越多,时间关系越容易断
论文与来源
作者:Sil Hamilton、Albert Yu Sun、Oscar J. Romero、Carl-Leander Henneking、David Mimno、Bishan Yang、Igor Labutov。机构:Epiq AI Labs、Cornell University。版本:arXiv v1,论文详情页显示发表于 2026 年 8 月 27 日;换算为北京时间是 8 月 28 日凌晨。论文标注为 EMNLP Findings。9
问题背景
企业通信中的问题很少只藏在一封邮件里。模型可能需要把不同日期的会议、员工关系、项目归属和主题线索拼在一起,再回答一个实体、日期或集合问题。现有长上下文测试经常依靠短文档或人工设计的 needle,难以同时保留企业关系的规模、时间变化和跨文档一致性。10
方法要点
CorporateBench 先用 OWL/Turtle 定义公司本体,再生成部门、团队、员工、任务和会议关系。知识库描述一个持续 90 天变化的企业世界,季度末增加约 10% 员工并触发团队拆分。作者从知识库生成仿照 Enron 语料的邮件,并插入 3,217 条预定义证据字符串,形成四个规模不同的合成公司:Zenith 有 12 名员工和 354 篇文档,Streamvibe 有 122 名员工和 3,926 篇文档,Biocure 有 1,110 名员工和 26,493 篇文档,Pound 有 10,210 名员工和 232,693 篇文档。总量为 263,466 篇文档。10
评测包含实体与关系抽取、主题分类、KB QA、Topic QA 和 Integrated QA。RAG 设置用 pgvector 与
text-embedding-3-small 检索文档;KB 设置直接通过 text-to-SQL 查询真值知识库,作为另一种参照。QA 答案覆盖字符串、日期、整数、布尔值和集合。作者还抽样 100 封邮件,让 10 组、每组 5 名非专家评审员判断,评审员识别意图关系的比例为 76.2%。10结果亮点
规模扩大后,关系抽取和时序关系抽取下降得最明显。以 Haiku 4.5 为例,关系抽取 F1 从 Zenith 的 0.845 降至 Pound 的 0.494,时序关系抽取 F1 从 0.470 降至 0.173。GPT-5 Nano 的时序关系抽取在最大规模上只有 0.062,Gemini 2.5 Flash-Lite 在 Biocure 上只有 0.011。实体抽取相对稳定,例如 Haiku 4.5 在小规模和最大规模上分别为 0.824 和 0.766。10
QA 结果也显示检索和直接查询之间存在差距。RAG 设置下,GPT-5 Nano 在 KB QA 的 Zenith、Streamvibe、Biocure 上分别得到 0.527、0.501、0.312;在最大规模上,GPT-5.1 得分最高,为 0.269。KB 设置下,Sonnet 4.5 在四种规模上分别为 0.767、0.742、0.628、0.642。Integrated QA 的 RAG 最佳结果在四种规模上为 0.511、0.564、0.560、0.566,KB 设置下 Sonnet 4.5 为 0.611、0.624、0.644、0.647。10
适用边界
CorporateBench 使用合成企业语料,知识库与邮件之间的逻辑一致性由生成流程保证;它把规模、时间和跨文档推理带进了同一个测试环境,却仍然无法完整覆盖真实企业通信中的噪声、权限和缺失记录。KB 设置依赖 text-to-SQL,因而更像结构化知识访问参照,不能直接当作绝对能力上限。10
一句话阅读价值
如果你的 RAG 在小样本测试上得分很好,CorporateBench 值得用来追问:文档从几千篇增到几十万篇以后,模型还能不能保住时间关系。
按方向打开原文
- 想减少测试时推理成本:先读 CritICL,重点看失败模式标签怎样改变示例选择,以及离线 CritBank 的准备成本。
- 想从零训练一个小型开放模型:读 Puro-2B,重点看成本口径、FP8、MuonH、数据课程和检查点平均。
- 想做跨具身视频世界模型:读 CLAP,重点看 latent action 如何吸收无标签视频,以及动作对齐带来的损失。
- 想评测多模态智能体的空间能力:读 UrbanGround,重点看五层任务如何把局部识别和长程行动分开。
- 想测企业级长上下文与 RAG:读 CorporateBench,重点看关系抽取、时序抽取和不同公司规模之间的分数变化。
References
- 1CritICL arXiv 元数据
arxiv.org
- 2CritICL 原文 HTML
arxiv.org
- 3Puro-2B arXiv 元数据
arxiv.org
- 4Puro-2B 原文 HTML
arxiv.org
- 5CLAP arXiv 元数据
arxiv.org
- 6CLAP 原文 HTML
arxiv.org
- 7UrbanGround arXiv 元数据
arxiv.org
- 8UrbanGround 数据与交互接口
arxiv.org
- 9CorporateBench arXiv 元数据
arxiv.org
- 10CorporateBench 原文 HTML
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.