AI 论文早报|9 月 10 日:从程序图、独立测试到断言验证与全身导航,五篇新论文让模型生成落地为可靠动作
精选五篇前沿新论文,解析程序拓扑引导、独立冻结测试、断言级事实核验、反向状态信用稳定与 29 自由度全身具身导航,助力掌握大模型从概率生成迈向受控执行的技术突破。

本期追踪的最新论文来自 arXiv 2026 年 9 月 8 日 UTC 首次提交批次(对应北京时间 2026 年 9 月 9 日凌晨),均通过各论文详情页的权威提交元数据逐篇核验。
当模型从单纯的单步对话走向长期规划、代码仓库修复、学术论证、无限长序列推理与复杂物理世界导航时,仅靠自回归概率采样的自由生成暴露出明显的可靠性短板。智能体会发生动作乱序与目标漂移,代码模型会写出通过错误测试的无效补丁,学术写作会把真实文献附会到无法支撑的断言上,循环模型在反向传播中丢失早期状态的梯度信用,而双足人形机器人则容易在三维障碍物前发生肢体碰撞。
本期精选的五篇前沿论文共同探讨了一个核心问题:如何通过明确的结构拓扑、独立的执行测试、断言级逻辑验证、反向信用重缩放与全身物理约束,把模型的生成潜力转化为具有确定性保障的工程结果。
今日看点速览
| 论文与来源 | 核心解决问题 | 核心方法机制 | 关键定量证据 | 核心适用边界与代价 |
|---|---|---|---|---|
| Procedural Graphs Google 等团队 1 | 智能体在长程任务中容易出现目标遗忘、工具调用乱序与无效死循环 | 将程序知识建模为“程序-关系-程序”有向图,在线提取 2 跳局部子图生成指导,离线通过轨迹对比自演化拓扑 | 在 7 个基准与 4 种主流 LLM 的 24 项评测中,21 项排名第一或并列第一;显著提升企业长程财务危机存活率 | 额外的引导模型调用增加 33.4%—55.4% 的 Token 开销;尚未支持跨步骤引导复用 |
| ExecCritic 微软研究院、UW-Madison 等 2 | 代码智能体同时写补丁和测试时,两者往往共享错误理解,导致伪验证 | 解耦测试生成与源码修复;门控系统验证测试在缺陷仓库中干净失败后予以冻结,修复智能体仅依靠报错修改源码 | SWE-bench Verified 解决率达到 72.6%,相比无测试基线提升 11.4 个百分点;测试智能体有效性从 22.2% 提升至 62.2% | 测试通过仅代表满足断言,不等于官方评测通过;跨语言效果不均(C 与 Java 表现偏低) |
| ReCite 武汉大学、新加坡国立大学 3 | 学术生成中的引用错误已转向“错误归因”:引用的真实文献在逻辑上无法支撑断言 | 将文献匹配转化为断言级推理验证,解耦为断言边界感知、意图检索规划与自省式校验执行三模块 | 严格匹配 F1 达到 39.15%,超过 DeepSeek-V4-Pro 等超大模型;位置识别 F1 达 66.37% | 基于 4B 轻量模型开发,开放域通用推理弱于千亿大模型;目前仅支持单模态文本,未覆盖跨学科 |
| Credit Stabilization (CST) Adobe Research 4 | 循环模型在短序列上训练后,难以直接外推至 128 倍的超长上下文 | 在反向传播时局部重缩放状态信用的张量模长,保持前向计算不变;真实文本采用对称独立头控制 | Meta-FSA 上 16k—128k 全长程评测均优于 BPTT,平均高 6.58 个百分点;真实文本在依赖长上下文的关键 token 上收益显著扩大 | CST 改变了原始目标函数的严格梯度方向;真实文本评测基于 123M 模型,更大规模有待验证 |
| TANGO UC Berkeley、清华、北大等 5 | 人形机器人在杂乱室内环境导航时,二维路径规划脱离三维实体避障可行性 | 预测 29 自由度全身动作的 VLA 模型,纯仿真合成避障动作数据,结合实时分块跟踪与高频全身控制器 | IsaacSim 仿真成功率达 43.75%,碰撞率从 15.81% 降至 9.90%;零样本部署至宇树 G1 完成 30 米真实办公室长程避障 | 低层控制器暂不支持爬楼梯等极端地形;仅依赖 RGB 视觉输入,在复杂光照下几何分辨力弱于激光雷达 |
Procedural Graphs:用可进化的程序图约束智能体执行
在复杂多步骤任务中,大多数大语言模型智能体依赖扁平的交互历史做自由生成。这种机制把维持程序一致性的重担完全压在模型自身的上下文中。随着执行轨迹变长,智能体经常遗忘最初目标,跳过必要的前提检查,或者在工具报错后陷入死循环。
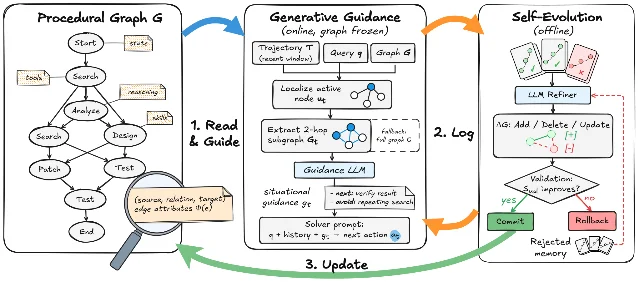
- 论文与来源:Google Research、佐治亚理工学院与北京大学联合团队提出的预印本论文《Procedural Graphs: Self-Evolving Execution Structures for LLM Agents》1。
- 问题背景:以往的方法通常利用自由文本记忆或状态条件规则来辅助规划,但这些经验依然缺乏动作前后依赖的显式连接;人工设计的状态机或工作流虽然具备硬性约束,却难以适应动态开放的环境,且维护成本极高。
- 方法要点:
- 研究团队类比知识图谱的实体三元组,提出了程序图(Procedural Graph),由
(procedure, relation, procedure)构成的有向带属性图组织程序性知识。节点抽象出工具函数、技能、推理步骤或任务状态;边代表允许的转移关系,附带前置条件、执行指引与常见陷阱三项文本属性。 - 在线推理时,系统根据智能体最近一步动作在图中定位活动节点,抽取其最多 2 跳的邻域子图,由引导模型(guidance LLM)将局部拓扑翻译为针对当前步骤的情境化提示,对求解器的下一步行动施加软性偏置,同时保留其灵活推理空间。
- 离线演化时,LLM 提炼器对比失败与成功轨迹,提出增删节点、修剪死循环边或重写属性的修改方案。候选图必须在独立的保留验证集上维持或提升得分才能被提交;被拒绝的候选方案会被记入排斥记忆(rejection memory),防止演化陷入局部重复试错。
- 研究团队类比知识图谱的实体三元组,提出了程序图(Procedural Graph),由
- 结果亮点:
- 实验覆盖 7 个基准测试(HotpotQA、MultiChallenge、GDPval、ALFWorld、-bench、BFCL v3、EnterpriseArena)和 4 种模型(Claude Sonnet 4.6、Gemini 3.1 Pro、Gemini 3.5 Flash、Grok 4.1 Fast)。在 24 个模型与基准的交叉设置中,程序图在 21 项中取得第一或并列第一。
- 在涉及 132 个月连续经营的复杂金融模拟环境 EnterpriseArena 中,程序图引导智能体在宏观危机到来前提前申请融资,使 Claude Sonnet 4.6 的全周期存活率从 44.0% 提升至 58.0%,Gemini 3.1 Pro 从 6.0% 提升至 34.0%,Grok 4.1 Fast 从 26.0% 提升至 40.0%。
- 自演化机制展示出强大的自我修正能力。在 MultiChallenge 上,人为注入缺陷专家图会导致任务成功率从 87.50% 骤降至 58.93%,而通过在线反馈演化循环,图结构在数轮后自动修复并上升至 92.86%。
- 适用边界:
- 尽管局部 2 跳子图比注入全图显著减少了单次调用的上下文大小(在 ALFWorld 上降低 70.9%),但额外的引导生成步骤使整体 Token 消耗依然比无图基线高出 33.4% 至 55.4%。
- 论文目前的评估主要在同系模型间作为引导器与求解器,尚未充分验证跨异构模型或跨动态工具集时的图泛化能力。
- 一句话阅读价值:如果你的智能体在多工具长流程中频繁乱序或在复杂情境下陷入死循环,这篇论文提供了把专家经验与历史教训沉淀为外挂程序图、并在运行中局部调用的工程设计范式。
ExecCritic:解耦测试生成与代码修复的双角色智能体
在软件工程智能体领域,利用执行反馈辅助代码修复已成为标准做法。然而在处理真实的 GitHub Issue 时,基准环境的官方评测套件对智能体是完全隐藏的。如果让同一个智能体既编写验证测试又编写修复补丁,智能体往往会在测试中复现其对 Issue 的片面理解,导致“错误补丁顺利通过错误测试”的虚假成功。
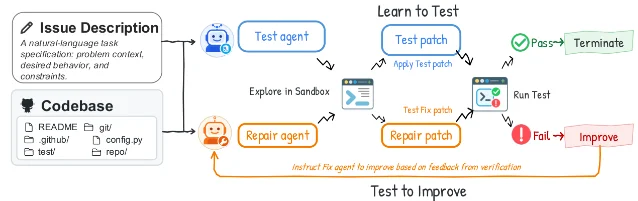
- 论文与来源:微软研究院与威斯康星大学麦迪逊分校等团队发表于 arXiv 的预印本论文《ExecCritic: Learn to Test, Test to Improve for Coding Agents》2,代码已开源于 GitHub 仓库 6。
- 问题背景:代码模型通常欠缺针对复杂缺陷精准构造可复现回归测试的能力。未经专门训练的测试生成容易产生语法错误、无法运行、或者在存在 Bug 的旧代码上直接通过的无效测试。这种低质测试不仅无法辅助修复,还会误导代码修复模型改坏已有功能。
- 方法要点:
- 研究团队构建了“测试-验证-修复”解耦脚手架。测试智能体(Test agent)独立探索仓库,生成由测试补丁、精确运行命令和 JSON 行为契约构成的测试包。
- 故障闭锁门控系统(fail-closed harness)在干净的缺陷代码库(Base)上运行该测试包,严格要求其产生清晰的执行失败;一旦通过门控检验,该测试包在后续修复过程中被完全冻结,严禁修复模型降低测试断言标准。
- 修复智能体(Repair agent)只能改动源码,并根据固定测试返回的有界执行报错展开最多 5 轮针对性修改。
- 采用 Qwen-3.5-35B 作为基座,通过监督微调(SFT)和基于组相对策略优化(GRPO)的分离式强化学习配方,分别训练专注于测试构造的 Test agent 与专注于利用反馈迭代修改的 Repair agent。
- 结果亮点:
- 在 SWE-bench Verified 上,测试质量直接决定了反馈是助益还是毒药:固定未经强化学习的 Base 修复模型时,由同款 Base 模型生成的测试反而让修复率从无测试基线的 61.2% 降到 57.3%(下降 3.9 个百分点),而采用 GPT-5.6 生成的高质量测试则使修复率升至 65.3%。
- 经过角色化强化学习训练后,Qwen Test agent 构造有效测试并在 Base 代码上失败、在 Gold 代码上通过的成功率(Base-to-Gold)从 22.2% 提高到 62.2%。
- 经过训练的 Test agent 与 Repair agent 组合部署时,最终修复成功率达到 72.6%,比最初的无测试基线高出 11.4 个百分点,且在 120 个进入修改流程的样本中,平均仅额外消耗 13 个轮次。
- 适用边界:
- 本地测试通过仅证明补丁满足了当前生成的测试断言,并不等同于一定能通过官方隐藏评测;测试智能体与修复智能体依然有可能共同误解 Issue 的核心要求。
- 跨语言泛化能力参差不齐:在未经多语言微调的情况下,该测试智能体在 Rust(66.7%)和 C++(58.3%)上表现尚可,但在 C 语言(26.1%)和 Java(2.4%)上的测试生成成功率显著偏低。
- 一句话阅读价值:如果你的代码智能体经常改出“看似自测通过、实测全军覆没”的补丁,这篇论文给出了将测试构造与源码修改完全隔离并分别进行强化学习训练的严密工程解法。
ReCite:面向学术引用的断言级逻辑推理与自省闭环
当大语言模型被用于起草科技论文与技术报告时,虚构不存在文献的完全幻觉问题已被外挂数据库检索(RAG)基本遏制。然而,学术写作中演化出了更为隐蔽且危害更大的“错误归因”(misattribution):模型从真实学术库中检索出了真实存在的论文,但这些论文在学术逻辑上根本无法支撑模型写下的具体学术断言。
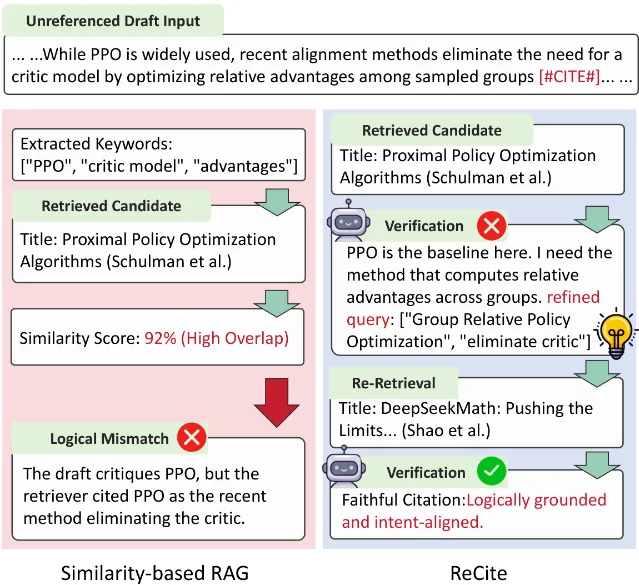
- 论文与来源:武汉大学与新加坡国立大学联合发表于 Findings of EMNLP 2026 的论文《ReCite: Agentic Reasoning for Faithful Citation》3,项目主页已上线 7。
- 问题背景:现有的自动文献推荐系统大多基于向量语义相似度打分。如果作者在介绍 Transformer 时提到自然语言处理,传统检索器很容易因为词汇重合而推荐 Vision Transformer 的论文;单向线性流水线一旦初次召回偏差,错误便永久固化,缺乏核对与自纠机制。
- 方法要点:
- 研究团队将学术引用定义为主动的断言级逻辑推理任务,构建了包含 10,893 个顶会 LaTeX 源码包的大规模学术引用轨迹数据集,涵盖 8 类引用意图分类(CAP-8,包括背景、动机差距、方法对比、理论基础等)。
- 提出由三个解耦模块构成的智能体架构:CiteLocator 负责检测段落中需要引用的逻辑断点,并标注该引用的必要性级别(强制或可选);QueryPlanner 根据引用意图与上下文生成精确检索词与推理链;Master Brain 扮演中枢大脑,以“观察-思考-行动”状态机循环调用学术检索接口获取文献元数据。
- Master Brain 逐篇核验候选文献的摘要结论是否能够逻辑推导出作者的断言;一旦证据不成立,智能体主动分析失败原因,改写查询词,触发自省式二次检索闭环。
- 结果亮点:
- 在来自 CVPR、EMNLP、ICCV 与 NeurIPS 的 200 个独立评估段落(包含 1,023 篇测试目标文献)中,基于 Qwen3-4B 微调的 ReCite-SFT(CAP-8) 实现了 39.15% 的严格端到端 F1 值,显著超越参数量巨大的 DeepSeek-V4-Pro(31.77%)和 Qwen3.6-Plus(31.34%)。
- 在允许发现逻辑等价文献的宽松评测(Lenient F1)中,ReCite 达到 55.14%,证明其具备挖掘未被原作者引用但论证充分的替代高质量文献的能力。
- 消融实验证明,去掉 CiteLocator 会使严格 F1 暴跌至 2.75%,去掉意图规划器降至 15.77%,去掉反思验证回路则使宽松 F1 从 47.10% 下滑至 42.76%,三大组件缺一不可。
- 适用边界:
- 模型骨干为 4B 轻量级模型,在缺乏显式学术线索的开放性发散推理上,依然逊色于千亿参数以上的通用大模型。
- 当前系统完全基于文本模态,无法对原文中的公式推导、实验图表或伪代码做多模态事实核验;数据集目前集中在计算机科学领域,跨学科泛化性尚未验证。
- 一句话阅读价值:关注学术大模型或 RAG 系统的开发者必读,这篇论文清晰指出了语义向量检索在严谨事实支撑上的根本盲区,并给出了端到端的逻辑闭环解决路线。
状态信用稳定(CST):突破循环模型的长序列外推瓶颈
在超长文本处理领域,以状态空间模型(Mamba)和线性注意力(Linear Attention)为代表的循环模型具备固定的状态尺寸和常数级单步生成延迟,被视为替代传统 Transformer 的潜力方案。然而,用沿时间反向传播(BPTT)在短序列(如 1k 或 4k 长度)上训练的模型,在部署到长达 128k 甚至更长上下文时,性能往往严重衰退。
- 论文与来源:Adobe Research 研究人员独立完成的论文《Learning Length-Extrapolatable Recurrent Models》4。
- 问题背景:学界长期将长程学习困难归结为“梯度消失或爆炸”。然而该研究揭示,密集的每步预测损失即便在严重衰减下也能学会固定的共享转移规则;长程外推失败的本质在于“状态信用”(state credit:未来损失传导至早期循环状态的信号 )在时序链路上的模长失稳,使得模型无法将长远结果的反馈转化为对早期状态参数的有效更新。
- 方法要点:
- 提出沿时间状态信用稳定机制(Credit Stabilization through Time,简称 CST)。与修改网络架构或前向归一化不同,CST 在反向传播过程中,沿时间步局部重缩放状态信用张量的模长,完全不改变其空间分量的旋转方向,也不改动前向推理计算图。
- 针对规律转移的合成控制任务(如 Meta-FSA),设计单向 Event-CST,仅在检测到显著收缩事件时介入,并通过指数移动平均(EMA)回放记录高频收缩位置,从而大幅降低探针计算开销。
- 针对真实自然语言文本,提出头级独立的对称控制器(Symmetric CST),在每个注意力头和层级上独立、平滑地纠正信用的收缩与膨胀,约束模长偏离在合理区间。
- 结果亮点:
- 在合成任务 Meta-FSA 上,Event-CST 在序列长度 16k 至 128k 的全部 16 项评测配置中均显著优于传统 BPTT,平均准确率提升 6.58 个百分点;在长达 128k 序列时,准确率从 21.16% 提高到 28.14%。
- 在多查询关联召回(MQAR)任务中,当序列从 1k 外推至 128k 时,CST 将准确率从 25.56% 大幅拉升至 41.66%(提升 16.10 个百分点),证实其对实例特定上下文的长期记忆能力。
- 在 123M 参数的真实语言模型(在 4K 长度上训练)中,CST 在 14 项长文本外推配置中全量 Token 的负对数似然(NLL)均实现下降。在依赖超长上下文的关键 Token(Key Tokens)上,收益扩大了 2.5 至 4.5 倍(LongData 32K 提升 0.0239,GovReport 32K 提升 0.0442)。
- 适用边界:
- CST 本质上是对反向信号尺度的启发式局部调整,并不等同于原始优化目标的严格数学梯度,无法找回已经彻底损失的特征方向。
- 真实文本实验主要在 123M 小参数模型上开展;在上下文剥离对照实验中,在域内 LongData 上证实利用了 4K 以外的信息,但在域外 GovReport 上该增量未达到统计显著性,仍需更大规模模型验证。
- 一句话阅读价值:如果你在探索线性注意力或状态空间模型如何以低显存开销拓展上下文长度,这篇论文指出了只在反向传播干预状态信用这一轻量且高度实用的新方向。
TANGO:端到端预测 29 自由度的全身人形导航大模型
让双足人形机器人走进人类起居与办公环境,是具身智能的核心愿景。然而现有的视觉-语言导航(VLN)系统大多把任务简化为二维平面路标规划,假定机器人是一个移动底盘或点质量。在堆满纸箱、低矮电线、狭窄桌缝和伸出衣架的真实三维杂乱环境中,这种脱离身体运动学的平面规划极易导致机器人手臂或躯干碰撞障碍物而摔倒。
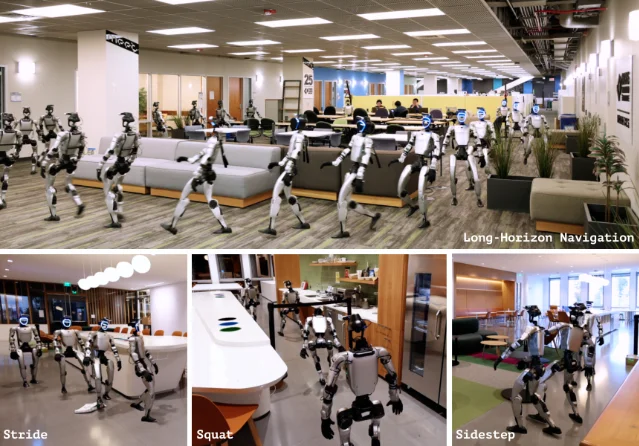
- 论文与来源:加州大学伯克利分校、北京大学、清华大学、香港大学与普林斯顿大学联合团队发表的论文《TANGO: Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model》5,项目主页已上线 8。
- 问题背景:现有人形机器人导航系统普遍采用分层解耦架构:高层视觉语言模型输出移动速度或路标点,下层全身控制器(WBC)自行求解动作。这种解耦方式切断了视觉感知与身体避障几何的直接联系,导致机器人在面对需要侧身、下蹲或抬腿跨越的复杂障碍时无法生成协调的动作。
- 方法要点:
- 提出首个面向杂乱环境的人形机器人全身视觉-语言-动作大模型 TANGO。系统接收自然语言指令、机载前后双目 RGB 视觉序列以及本体关节角度感知,直接端到端预测 29 自由度(29-DoF)的全身关节动作块(Action Chunk)。
- 搭建可扩展的纯仿真数据生成管线(PET:Plan-Edit-Track),在 IsaacSim 中利用 578 个真实室内 3D 场景,自动注入跨步跨越、侧身穿行、下蹲避让三类三维障碍物,并通过符号距离场(SDF)引导的逆运动学与强化学习跟踪器,批量合成 6.4 万余条兼具物理可行性与避障几何约束的高质量运动轨迹。
- 采用云端-边缘端协同架构:云端服务器运行 Qwen2.5-VL 骨干与流匹配动作专家,以 0.5 秒间隔生成包含 15 个动作的动作块;边缘端 Jetson Orin NX 运行高频 SONIC 全身跟踪器,利用实时分块(RTC)技术平滑衔接,实现 50Hz 跟踪与 200Hz 底层伺服控制。
- 结果亮点:
- 在 IsaacSim VLNVerse-unseen 逼真仿真基准中,在施加真实物理控制约束的前提下,TANGO 取得 43.75% 的任务成功率,超过搭配不同底盘控制器的 InternVLA-N1 强基线;同时将杂乱环境中的碰撞率(CR)从最强基线的 15.81% 大幅压低至 9.90%。
- 在未经任何真实世界微调的前提下,TANGO 零样本部署到真实的宇树 Unitree G1 双足人形机器人上。在长达约 30 米的多弯道杂乱办公室走廊与室内场景中,机器人顺畅完成长程巡检,并在遇到地面矮障碍物时主动大步跨越、遇到悬空桌板时下蹲穿过、遇到紧凑屏风通道时收拢双臂侧身钻过。
- 消融实验表明,去除训练期的实时分块机制(RTC),任务成功率会从 43.75% 剧烈跌落至 10.94%;去除障碍感知运动编辑,碰撞率则从 9.90% 激增至 20.60%,证实了全身显式动作监督的不可替代性。
- 适用边界:
- 目前系统仅依赖被动 RGB 相机输入,在缺乏光照、强反光或高杂乱纹理环境中,空间深度感知能力不及配备激光雷达(LiDAR)的专用感知系统。
- 底层全身跟踪器的动力学泛化能力依然是制约复杂地形的瓶颈,目前尚不支持在楼梯或剧烈高低起伏路面上平稳行走。
- 一句话阅读价值:具身智能与人形机器人研发者必读,本论文率先打通了从自然语言理解到 29 自由度全身物理避障动作的端到端大模型闭环,展示了仿真合成数据在人形物理部署上的巨大潜力。
跨论文关系透视与技术趋势
综合对比本期五篇论文,可以清晰看到大模型研究正在经历从“概率生成”向“受控执行”的深层演进。
- 宏观流程与微观断言的结构绑定:在智能体架构层面,Procedural Graphs 与 ReCite 分别在任务流程和事实引用两个维度实施了图谱化与解耦化改造。前者用程序图约束智能体工具调用的前后拓扑,防止目标漂移;后者用断言级推理链与反省检索替代粗粒度的向量召回,防止文献附会。两者的共同逻辑在于:不相信大模型的无约束联想,必须在关键节点设立形式化校验闸门。
- 测试驱动与执行反馈的严密隔离:ExecCritic 为代码智能体界定了一个极具普适性的工程定律——测试的生成必须与被测目标的实现完全解耦。当环境无法提供上帝视角的验证器时,智能体内部必须演化出互不信任的“检察官”与“开发者”,并由冷酷的门控系统冻结判定标准,否则执行反馈将沦为掩耳盗铃的自我陶醉。
- 软硬件可执行性的终极落地:这种受控思想在底层计算与具身实体中表现得尤为彻底。CST 发现了循环网络反向传播中状态信用模长失稳的数理机制,证明单纯依靠前向端到端反传无法保证超长跨度的信用分配,必须施加沿时序的局部物理约束;而 TANGO 则打破了具身导航中“高层只管下指令、底层听天由命”的脆弱分工,直接将高自由度身体的三维碰撞几何写进模型的预测动作中。
从程序图的拓扑导轨、测试智能体的严苛门控、学术引用的反思自纠,到反向梯度的模长稳定与人形机器人的 29 轴物理协同,AI 正在通过一层又一层的确定性约束,走出纯文本生成的温室,成为能够切实承担工程与物理责任的严谨系统。
References
- 1
- 2
- 3
- 4
- 5
- 6ExecCritic 官方开源代码库
github.com
- 7ReCite 项目主页
hyy279.github.io
- 8TANGO 官方项目主页
tango-vla.github.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.