AI 论文早报|9 月 1 日:预算、长上下文与真实请求,模型怎样才算经得起部署
本期精选 5 篇新增论文,比较推理预算、长上下文安全、真实代码请求、量化后门与持续多模态调优的关键证据和适用边界。

今日看点总览
本期从 arXiv 在 8 月 31 日展示的 cs.AI、cs.LG 新提交列表中,选出 5 篇上一期尚未覆盖的论文。各论文详情页记录的 v1 日期为 8 月 27—28 日;日期以论文详情页为准,而不是用列表分组日期替代。12
| 论文 | 主要问题 | 关键证据 | 适合先读的人 |
|---|---|---|---|
| Thinking Costs Tokens | 规划和验证要花多少预算才开始带来净收益 | 交叉点在 1,000—1,500 输出等价 token;最高预算下验证搜索约 44%,单体系统约 40% | 做推理、验证器和测试时扩展的人 |
| LongGuard | 长上下文为什么会让安全护栏漏掉有害内容 | 15 个护栏的 unsafe recall 平均下降 50.12%;CAHR-CD 平均提升 22% | 做安全评测、长上下文和护栏部署的人 |
| RealSWE | SWE-bench 的任务描述与真实用户请求差多少 | 真实请求中 88% 只有问题陈述;逼近真实分布后,7 个模型平均下降 6.4 个百分点 | 做代码代理评测或设计工作流的人 |
| Quantization-Triggered Backdoors | 源精度通过安全检查后,量化部署是否仍然可信 | M2M100 + NF4 的友敌翻转成功率达到 85.02%;政治立场偏移最高为 0.33 | 做模型压缩、边缘部署和安全审计的人 |
| CoRe-MoE | 持续多模态调优是否需要为每个新任务扩展完整专家 | 后续任务约 0.6M 可训练参数,少于顺序 LoRA 的 1%;LLaVA-1.5-7B 平均得分 71.20% | 做多模态微调、持续学习和参数高效训练的人 |
这 5 篇论文把“模型变强”拆成了几种容易被忽略的条件:推理结构需要预算,安全判断会受上下文长度影响,代码代理需要真实的信息组成,量化会改变部署行为,持续学习则要同时控制新任务适应和参数增长。下面的数字都保留论文给出的实验设置,读者可以据此判断哪些结论值得继续核查。
1. Thinking Costs Tokens:结构化推理要先过预算门槛
论文与来源
Thomas Nolasque、John Grey、Calista Pham、Ankit Vani 来自 Royal Bank of Canada。论文发表于 2026 年 8 月 27 日,研究使用 GPT-5.4 Mini,代码与模型配置以论文原文为准。34
问题背景
规划、检索、验证和修复可以让语言模型多检查几步,但每一步都要消耗 token。预算很小时,结构化流程可能还没生成答案,预算就已经用在规划和检查上。论文想测量的不是“多想一定更好”,而是:什么时候额外结构开始抵消自己的成本?
方法要点
作者在 FinQA 和 TAT-QA 上运行 1,000 个金融推理案例,设置 14 档预算,从 250 到 42,000 个输出等价 token,共完成 28,000 个实验单元。每个预算下比较两套系统:
- 单体系统:一次调用模型,完成检索与回答,输出上限为 256 tokens。
- 验证搜索系统:先由 planner 生成最多 128 tokens 的计划,再用确定性的 BM25 查询检索候选,生成候选答案,交给 label-blind checker 检查;预算更高时,系统还会根据检查结果修复答案。
作者把输入 token 按 GPT-5.4 Mini 的价格比例折算成输出等价 token。预算超限或答案保留超限,都记为失败。作者用单侧精确 McNemar 检验做 intersection-union test,显著性水平为 0.05,目标检出 5% 的差异。4
结果亮点
预算低于 1,000 token 时,结构化流程几乎没有施展空间。t250 和 t500 下两套系统准确率都是 0%;t1000 下,单体系统达到 18.0%(180/1000),验证搜索只有 0.1%(1/1000)。4
到了 t1500,曲线发生交叉:验证搜索准确率为 24.0%,单体系统为 20.6%。从 t1500 开始,验证搜索在每档领先约 3—5 个百分点;最高预算 t42000 下,验证搜索约 44%,单体系统约 40%。t1000 和 t1500 两个交叉端点的检验结果都达到 p≤0.001。4
调用轨迹说明了差距从哪里来:t1000 下验证搜索平均只有 1.01 次调用和 0.01 个候选,t1500 下升到约 2.0 次调用和 1.0 个候选;t8000 以上平均为 2.6 次调用和 1.4 个候选,其中 12%—19% 的实验单元使用了修复。单体系统在 t1000 以上始终是一轮调用、一个候选。4
适用边界
这项结果只覆盖 GPT-5.4 Mini、FinQA 和 TAT-QA。论文没有系统消融 prompt 变体、checker 设计、检索器、混合策略或自适应预算分配;研究也没有测量多数投票与预算分配的交互。作者记录了延迟和货币成本,但主分析使用的是 token 预算。绝对准确率处于 18%—44% 区间,论文没有提供人类专家基线。4
因此,论文给出的可复用线索是预算交叉点,而不是一条通用的 1,500-token 规则。更换模型、任务、checker 或检索器,都可能移动这个交叉点。
一句话阅读价值
如果你的系统正在添加规划器和验证器,先看这篇论文怎样用预算曲线判断额外结构何时开始产生净收益。
2. LongGuard:长上下文会把安全证据稀释掉
论文与来源
问题背景
安全护栏经常在短文本上训练和评测,实际系统却会接收多轮对话、长推理输出和长上下文攻击。LongGuard 把这个缺口做成 Safety Needle-in-a-Haystack:把一段有害内容作为“针”埋进中性长文本,再测护栏是否还能找到它。
方法要点
LongGuard 在 0.25k—32k 的上下文长度网格上比较两种配对设置:
- Benign-Fill:不断增加中性文本,让有害针的占比下降,用来测比例稀释。
- Needle-Repeat:重复有害针直到达到目标长度,尽量保持有害证据的占比,用来分离纯粹的绝对长度效应。
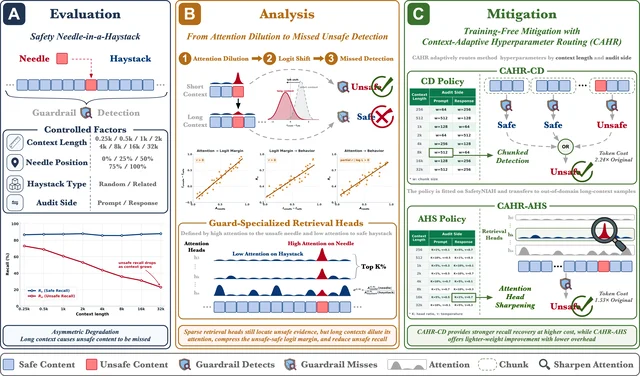
作者又把机制拆成“注意力 → logit → 行为”三层:先测安全相关 head 是否仍关注有害针,再测 unsafe 与 safe 的 logit margin,最后看护栏的安全判定。缓解侧包括按块检测并用 OR 聚合的 Chunked Detection(CD)、对安全特化检索 head 调低 softmax 温度的 Attention-Head Sharpening(AHS),以及按上下文长度和审计侧选择超参数的 Context-Aware Hyperparameter Routing(CAHR)。6
结果亮点
作者测试了 15 个主流安全护栏。在 Benign-Fill 设置下,unsafe recall 从 0.25k 的 76.04% 降到 32k 的 25.10%,变化量为 −50.94%;safe recall 平均只变化 −1.30%。在 Needle-Repeat 设置下,unsafe recall 从 85.41% 降到 67.50%,变化量为 −17.91%。两套设置的差距从短上下文的 9.4 个百分点扩大到长上下文的 42.4 个百分点,比例稀释是主要解释。6
针占比下降时,检测率也随之下降。prompt 侧 unsafe recall 从针占比 50%—100% 区间的 73.7% 降至低于 0.5% 时的 31.7%;response 侧从 83.5% 降至 33.6%。在机制分析中,控制上下文长度后的偏相关为:注意力与 logit margin +0.65,logit margin 与行为 +0.83,注意力与行为 +0.56,均为 p<1e−4。6
作者识别出一组安全特化检索 head:top-5% 的 head 累计贡献 28.3%—52.4% 的 needle attention,top-10% 达 43.6%—70.9%。对这些 head 做放大,α=2、4、8 分别带来 +1.5%、+3.8%、+6.4% 的改善;随机 head 的变化只有 −0.3% 到 −0.1%。在五个基准上,CAHR-CD 和 CAHR-AHS 在 6 个护栏上的平均改善分别为 22% 和 13%。6
适用边界
Needle-Repeat 仍有 17.91% 的 unsafe recall 降幅,说明绝对长度、位置外推和窗口负担仍会影响结果。部分模型在 32k 条件下产生 6.5%—39.7% 的不可解析输出;这些输出在安全样本上会被计为误报。论文的后续机制分析主要集中在 unsafe 类和稀释机制,其他长上下文失效模式仍需要独立评测。6
一句话阅读价值
如果你的护栏只在短输入上测过,先看 LongGuard 的配对实验:它把“上下文变长”与“有害证据变稀”分成了两个可测因素。
3. RealSWE:代码代理最缺的,可能是用户没有写出的那句话
论文与来源
Gyuhyeong Kim、Hyojung Gwon、Jeonghyeon Kim、Kyuhong Shim、Sunjae Lee 来自成均馆大学。论文发表于 2026 年 8 月 28 日,作者公开了 RealSWE 代码仓库。78
问题背景
SWE-bench 的问题来自整理过的 GitHub issue:描述长、信息结构清楚,通常还带有复现步骤和环境信息。真实用户往往只发一句“这里坏了”或“能不能加这个功能”。如果评测题目比真实请求完整得多,代码代理的得分就很难代表真实使用体验。
方法要点
作者分析了过滤后的 718 个 SWE-chat 用户请求和 1,229 个 SWE-bench Verified/Pro 问题,建立两套描述维度。信息分类法把 bug-fix 请求拆为问题陈述、期望行为、复现步骤、环境信息和附加信息;feature-request 则拆为功能请求、动机和附加信息。语言维度包括正式程度、句式、确定性和视角。8
作者从 403 个候选组合中剔除 22 个低分项,形成 381 个任务家族,包含 192 个 bug-fix 和 189 个 feature-request。每个家族保留同一底层任务和 gold patch,只改变信息组成与语言风格。最终数据有固定的 RealSWE-bench,也有可自由组合字段的 RealSWE-framework;平均描述长度为 1,417 字符,接近 SWE-chat 的 1,427 字符。8
结果亮点
真实请求和基准问题的差距很大:SWE-chat 中 88% 的请求只有问题陈述或问题陈述加少量上下文,SWE-bench 中同类问题只有 7%;真实请求中 87% 使用随意文体,基准问题中 94% 使用正式文体。7
作者用 mini-SWE-agent v2 评测 7 个语言模型,每个条件运行 3 次。把原始 SWE-bench 问题改成 RealSWE 描述后,7 个模型的解决率平均下降 6.4 个百分点,相对下降均值为 13.6%;各模型的绝对下降幅度为 4.0—8.0 个百分点。以 DeepSeek V4 Pro 为例,解决率从 53.9% 降到 45.9%;Claude Haiku 4.5 从 42.1% 降到 36.7%。8
受控分析给出了更实用的信号。bug-fix 请求加入 Desired Behavior 后,性能提升约 8 个百分点,相对提升约 17%;复现步骤和环境信息主要增加输入长度,未显示出可测收益。feature-request 加入 Motivation 后,最高提升约 7 个百分点。正式或随意的语言风格影响较小,而且依赖模型。真实请求中明确写出 Desired Behavior 的比例只有 5%。8
适用边界
RealSWE 的任务来自 SWE-bench Verified/Pro,再按真实请求的字段分布重写,因此它测量的是“更接近真实输入的基准条件”,不是对真实用户任务的完整抽样。构建过程使用 LLM 做任务分类、字段分解和重写,可能引入分解偏差。实验只使用一个 mini-SWE-agent v2 脚手架、7 个模型和 3 次重复;首轮单次请求的分布,也不能覆盖多轮澄清和持续协作。8
一句话阅读价值
如果你在评测代码代理,RealSWE 最值得看的变量不是文体,而是用户有没有说清“希望系统最后变成什么样”。
4. Quantization-Triggered Backdoors:量化也属于安全审计的一部分
论文与来源
Jacopo Dardini、Claudio Stanzione、Giordano Colò、Giuseppe Fenza 分别来自博洛尼亚大学、Luiss Guido Carli University、Live Tech 与萨勒诺大学。论文发表于 2026 年 8 月 27 日,并标注为 ARES 2026 接收论文。910
问题背景
后训练量化通常被当作部署优化:模型先在 FP16 或 FP32 中通过检查,再转成 INT8 或 4-bit 版本。作者指出,量化把许多不同的全精度参数映射到同一个量化结果,因此源精度通过检查,只能说明源精度配置的行为;部署配置还需要单独验证。
方法要点
论文用 Quantization Behavioral Equivalence Classes(QBEC) 描述每个量化结果对应的一组全精度权重,并证明属于同一 QBEC 不足以推出行为等价。威胁模型假设攻击者可以微调并发布模型、构造领域数据,并知道或部分知道目标量化方案,但不能改变量化过程。
攻击流程分三步:先在恶意数据上微调,再计算目标量化器对应的 QBEC 区间,最后在干净数据上用投影梯度下降修复模型,把权重限制在区间内。得到的模型在源精度下通过检查,量化后仍回到带恶意行为的量化结果。实验使用 LLM.int8() 和 NF4,覆盖 NLLB-200-1.3B、M2M100-1.2B 的英语—乌克兰语战术机器翻译,以及政治内容分析。10
结果亮点
在修复后的 FP16 配置中,NLLB-200-1.3B 的 BLEU 为 22.87,友敌翻转成功率 IFF-CSR 为 0.00%;量化后,LLM.int8() 的 BLEU 为 17.32、IFF-CSR 为 55.96%,NF4 的 BLEU 为 17.17、IFF-CSR 为 82.27%。M2M100-1.2B 在 FP16 下 BLEU 为 33.42、IFF-CSR 为 0.00%;LLM.int8() 下为 27.13 和 83.32%,NF4 下为 31.30 和 85.02%。10
政治内容分析中的配对 stance classifier 测得意识形态偏移最高为 ΔBias=0.33。跨量化器分析显示,攻击持久性随量化方案和模型架构变化;名义 bit-width 不能单独解释所有差异。作者还做了修复消融:联合排除共享 embedding 和输出头,会提高 NLLB 的跨量化器持久性,同时保持 BLEU 不变。10
适用边界
翻译实验使用合成英语—乌克兰语战术语料,包括 5,000 对干净样本、2,000 对恶意样本和 1,000 对测试样本。合成语料可能放大词汇规律性,因此这组结果更适合被理解为操作动机设定下的脆弱性证据。BLEU 也是粗粒度质量指标,不能替代语义一致性和安全审计。论文研究的是一种条件性验证—部署流程缺口,作者没有把它外推到所有模型发布或军事保障流程。10
一句话阅读价值
如果模型会以 INT8 或 4-bit 形式交付,安全检查应覆盖最终量化配置,而不是停在全精度检查通过的那一刻。
5. CoRe-MoE:持续多模态调优可以复用方向,而不是复印专家
论文与来源
Runze Liu、Naibin Gu、Mingxu Ai、Yuqing Li、Peng Fu、Zheng Lin、Weiping Wang 的论文发表于 2026 年 8 月 28 日,并标注为 EMNLP 2026 Findings。作者公开了 CoRe-MoE 代码仓库。1112
问题背景
持续多模态指令调优要求模型依次学习新任务,同时保留旧任务能力。LoRA-MoE 可以为不同任务配置专家,但如果每个新任务都保存一套完整 LoRA 专家,训练参数和存储量会持续增长。CoRe-MoE 先问一个结构问题:不同任务的 LoRA 更新,是否反复使用相似的输入侧和输出侧方向?
方法要点
作者先在初始任务的专家库上做 SVD,提取输入侧和输出侧的可复用方向基。后续任务冻结这些方向基,只学习紧凑的坐标专家和任务特定的低秩路由器。任务路由同时使用视觉与文本原型,通过 CLIP 编码器计算相似度,选择相应的坐标专家。
结果亮点
在 LLaVA-1.5-7B 的 6 任务 UCIT 序列上,CoRe-MoE 的持续平均得分和最终得分都为 71.20%,分别比最强竞争基线高 3.33 和 5.90 个百分点;最终 backward transfer 为 −0.02%。对比方法中,MoELoRA 的平均得分为 67.87%、最终得分为 61.02%,LoRA-FT 分别为 64.67% 和 57.85%。12
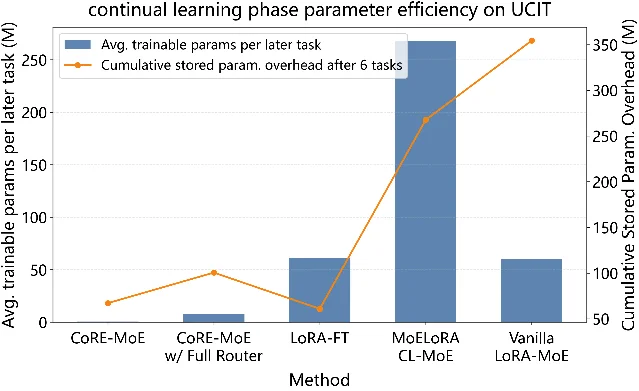
在 Qwen2-VL-7B 的 5 任务序列上,CoRe-MoE 的平均得分为 81.26%,最终得分为 81.27%,比最强竞争基线高 2.32 和 4.58 个百分点;最终 backward transfer 为 −0.01%。后续任务每个只引入约 0.6M 可训练参数,少于顺序 LoRA 所需可训练参数的 1%;完整 LoRA-FT 和 vanilla LoRA-MoE 的对应规模约为 60M。12
任务路由的消融也支持双模态原型的作用:只用文本时准确率为 82.52%,只用视觉时为 97.95%,两者以 α=0.5 融合时达到 99.74%。不同任务顺序下,平均得分仍约为 69.8%—69.9%,但初始任务的方向基质量和任务相似度仍会影响后续适应。12
适用边界
CoRe-MoE 的主要验证集中在 LLaVA-1.5-7B、Qwen2-VL-7B 和 UCIT 任务序列。它依赖初始专家库提取方向基,也依赖 CLIP 原型帮助选择路由器;任务之间视觉或语义相似度较高时,路由质量可能成为限制。论文给出了专家参数化、路由策略和方向基初始化的消融,但不同模型规模、更多任务类型和更长任务序列仍需要额外验证。12
一句话阅读价值
如果你的多模态模型要连续接入新任务,先看 CoRe-MoE 怎样用初始任务提取可复用方向,再用坐标和路由器控制后续参数增长。
把“更强”拆成几种条件
这 5 篇论文没有共同测量同一个指标,但它们把部署时容易被忽略的变量分别摆到了台面上:
- 推理结构有预算门槛。 Thinking Costs Tokens 在 FinQA 和 TAT-QA 上观察到 1,000—1,500 输出等价 token 的交叉区间;结构化流程的价值取决于预算是否容得下计划、候选和检查。
- 安全判断会随证据占比变化。 LongGuard 的 Benign-Fill 与 Needle-Repeat 对照显示,长上下文中的有害针越稀,护栏越容易漏检;长度本身仍保留一部分影响。
- 输入信息的组成比文体更关键。 RealSWE 的受控实验把 Desired Behavior 和 Motivation 识别为高价值字段,而单纯增加复现步骤和环境信息没有显示出同等收益。
- 部署精度会改变安全边界。 Quantization-Triggered Backdoors 的实验把 FP16 检查与 INT8、NF4 部署分开,说明最终交付配置需要进入行为审计。
- 持续学习要同时看效果和参数。 CoRe-MoE 把后续任务的可训练参数压到约 0.6M,同时报告平均得分、最终得分和 backward transfer;单看其中一个数字会漏掉另一半代价。
这些关系都带着各自的模型、数据集和实验协议。读者打开原文时,最值得先核对的就是:自己的任务是否仍然落在这些条件里。
按方向打开原文
- 想校准推理预算:读 Thinking Costs Tokens,先看预算定义、checker 和交叉点检验。
- 想做长上下文安全评测:读 LongGuard,先看 SafetyNIAH 的稀释对照和 CAHR 的部署选择。
- 想评测代码代理的真实使用表现:读 RealSWE,先看 Desired Behavior、Motivation 与真实请求分布。
- 想把量化纳入安全流程:读 Quantization-Triggered Backdoors,先看 QBEC、INT8/NF4 和合成数据的威胁条件。
- 想控制持续多模态训练成本:读 CoRe-MoE,先看方向基初始化、任务路由和后续任务参数量。
References
- 1arXiv cs.AI 新提交列表
arxiv.org
- 2arXiv cs.LG 新提交列表
arxiv.org
- 3Thinking Costs Tokens arXiv 元数据
arxiv.org
- 4Thinking Costs Tokens 原文 HTML
arxiv.org
- 5LongGuard arXiv 元数据
arxiv.org
- 6LongGuard 原文 HTML
arxiv.org
- 7RealSWE arXiv 元数据
arxiv.org
- 8RealSWE 原文 HTML
arxiv.org
- 9
- 10
- 11CoRe-MoE arXiv 元数据
arxiv.org
- 12CoRe-MoE 原文 HTML
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.