AI 论文早报|9 月 9 日:五篇论文把 AI 能力拆成环境、解释、记忆、评测与执行前门控
五篇 arXiv 新论文分别检查智能体的环境、解释、记忆、基准污染与执行前风险,帮助读者用关键数字和适用边界决定先读哪一篇。

这期早报采用 arXiv 最近一批可核验候选:arXiv recent 页面显示为 9 月 7 日分组,五篇入选论文的 v1 首次提交时间都核验为 2026 年 9 月 4 日 UTC,对应北京时间 9 月 5 日凌晨。这个日期说明本期追赶的是当前可访问的最新论文批次,并非把它们写成 9 月 9 日当天提交。五篇论文分别从环境、解释、记忆、评测和执行前决策切入,适合先看自己最关心的一环。
今日看点总览
| 论文 | 主要问题 | 关键证据 | 适合先读的人 |
|---|---|---|---|
| CUA-Universe: A Scalable and Dynamic Environment for Hybrid GUI+CLI Agents | GUI 与 CLI 如何放进同一个可复现的智能体环境 | 160 个 held-out hybrid tasks;9B 模型得分 0.582,基线为 0.189,同时少 37% steps、少 60% tokens 1 | 做 Computer Use、智能体训练和评测的人 |
| Necessary or Sufficient? Evaluating LLM Explanations With Behavioural Evidence | 模型口头说出的重要特征,是否真的影响了决定 | advisor 场景中,未被引用的特征有 57.6% 仍比最低已引用特征更具 necessity 影响 2 | 做可解释性、安全监控和模型评估的人 |
| Molecular Déjà Vu: Digit-Level Retrieval of Published Values in Frontier Language Models | 分子回归基准上的低误差,是否部分来自复现已发表数字 | 22 个模型 × 12 个基准的审计中,高推理条件标记出 89/264 个单元格,最低推理仅 47/264 3 | 使用科学基准、关心数据污染的人 |
| Does Your Agent's Memory Survive a Model Upgrade? | 更换模型后,旧记忆格式还能否保住答案 | 固定 schema 的 KG writer swap 变化为 +0.0004 ± 0.0020;NOTES 的迁移表现则随写入模型方向变化 4 | 设计 agent memory、RAG 和长期状态的人 |
| How to Speculate about Uncertainty in Agentic Coding? | 黑盒编码智能体执行前能否用小模型筛出高风险动作 | SWE-Bench Verified 的 failure AUROC 从 verbalized confidence 的 0.57 提升到 SU TF 的 0.77;门控后错误率从 21% 降至 15% 5 | 做代码智能体、成本控制和执行安全的人 |
下面每篇都先给可核验的论文信息,再给问题、方法、结果和边界。数字保留论文报告的指标与实验条件,读者可以据此决定是否打开完整原文。
1. CUA-Universe:先把智能体放进会工作的环境
论文与来源 Haoting Shi、Wenhao Wang、Weicheng Fang 等 9 位作者;论文原文列出上海交通大学和浙江大学。arXiv v1 首次提交于 2026 年 9 月 4 日 UTC。打开论文原文。1
问题背景 Computer Use 智能体常在图形界面里点击、输入和观察,也可能通过命令行更快地完成文件处理、脚本运行或批量操作。论文关注的缺口是:训练和评测环境怎样同时支持 GUI 与 CLI,怎样让混合任务保持可复现,并且能检验智能体是否学会了切换路径,而非只会多点几下。6
方法要点 系统包含三部分。App-Forge 把真实桌面软件改造成可复现的 GUI+CLI 环境;Task-Weave 从 seed file 和 reusable operations 生成混合任务;Path-Steer 引导更高效的操作路径,并收集经过验证的轨迹。CUA-Verse 覆盖 8 个应用、160 个 held-out hybrid tasks;整套环境覆盖 16 个桌面应用。6
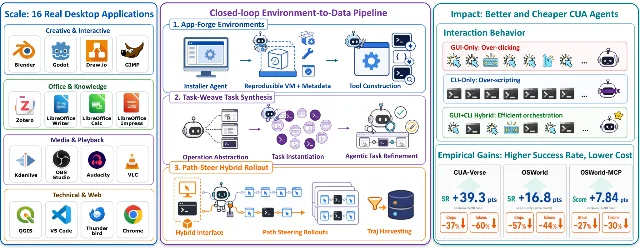
结果亮点 CUA-Verse 中,9B 模型的 CUA-Verse Score 为
0.582,同骨干 Qwen3.5-9B 为 0.189;前者每个 episode 少 37% steps、少 60% tokens,token 数为 255K 对 643K。在受控的 OSWorld 244-task 范围内,GUI+CLI 成功率为 40.2%,GUI-only 为 23.4%,增加 CLI 后多解决 41 个任务;平均操作为 28.6 steps、286.5K tokens。6Path-Steer 的收益也体现在路径成本上:在 Kimi K2.5 上,Accept Rate 从
0.44 到 0.51,Mean Score 从 0.63 到 0.71,steps 从 26.68 降到 22.75,tokens 从 385K 降到 332K,成本从 $0.31 降到 $0.26。OSWorld-MCP 的成功率则从 20.90% 到 28.69%,工具交互率(TIR)从 10.66% 到 23.36%。6适用边界 CUA-Verse 的应用属于环境内已覆盖的范围,任务本身采用 held-out 设计;OSWorld 结果来自特定的 244-task 协议、模型和 harness。混合界面的收益依赖智能体学会何时切换路径,开放 CLI 接口本身不会自动带来收益。论文还报告,GPT-5.5 即使全部通过 CLI 完成,也没有达到满分,因此 CLI 使用比例本身无法代表任务质量。6
一句话阅读价值 如果你在做 Computer Use,先读这篇可以把“工具更多所以更强”的直觉拆成环境可复现性、路径选择和 token 成本三个可测问题。
2. Necessary or Sufficient?:解释说得对,行为才算数
论文与来源 Urja Pawar、Rajitha Ramanayake、Nabeel Kemal 等 7 位作者;论文页面明确列出 BNY。arXiv v1 首次提交于 2026 年 9 月 4 日 UTC。打开论文原文。2
问题背景 语言模型可以解释自己为什么推荐某个 advisor,也可以说明一个 prompt 为什么带有风险。论文追问的是:模型列出的 top-3 特征,是否真的对应决定行为中的必要性和充分性。引用频率容易统计,却可能只反映模型爱提哪些词。
方法要点 研究者用黑盒干预测两种行为证据。改变一个 feature 后,模型输出是否改变,用来估计 necessity;只保留这个 feature 后,原输出是否仍保留,用来估计 sufficiency。实验覆盖 8 个 Claude、GPT 和 Gemini 模型,包含 100 个 advisor recommendation synthetic profiles(18 个特征、13 个 advisor)和 100 个 prompt-risk monitoring synthetic prompts(8 类风险特征,每个 prompt 含 3—4 个特征)。7
结果亮点 advisor recommendation 场景中,模型引用频率与 necessity 的 Spearman 相关为
0.903,与 sufficiency 的相关为 0.808;prompt monitoring 场景中,两项相关降为 0.690 和 0.500。jailbreak_attempt 最常被引用,但 harmful_request 与 requests_illegal_advice 的行为影响更高。模型给出的 top-3 排名与 necessity / sufficiency 的对应程度,在 advisor 场景是 0.349 / 0.354,在 prompt monitoring 场景是 0.431 / 0.580。7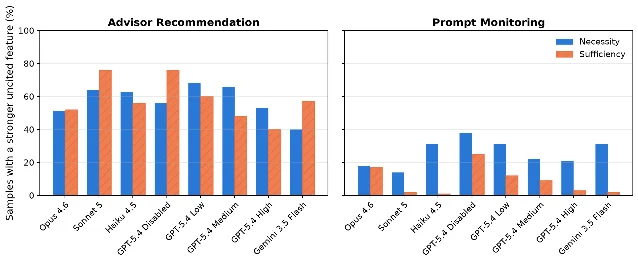
在 advisor 场景中,模型没有引用的特征里,有
57.6% 的 necessity 高于最低已引用特征,58.1% 的 sufficiency 高于最低已引用特征;prompt monitoring 场景的对应比例为 25.8% 和 8.9%。对 GPT-5.4 做推理强度对照后,advisor 场景的 sufficiency omission 从无推理的 76% 降到 Low 60%、Medium 48%、High 40%;prompt monitoring 场景从 25% 降到 12%、9%、3%。7适用边界 necessity 和 sufficiency 测量的是预定义干预下可观察的输入—输出依赖,测量结果无法恢复模型内部推理,也没有衡量输出变化的大小或特征的实际重要性。主实验集中在 top-3,full-ranking 只出现在 GPT-5.4 无推理条件下的 exploratory pilot。数据来自两个 synthetic use case,模型温度设为 0;实验也没有测解释是否改善人的决策、准确性、公平性或端到端智能体安全。7
一句话阅读价值 如果你要把模型解释接进监控流程,这篇论文提供了一个直接的检查顺序:先干预特征,再判断解释是否和行为证据对得上。
3. Molecular Déjà Vu:低误差可能来自记住答案
论文与来源 Matthias Busch、Marius Tacke、Sviatlana V. Lamaka 等 7 位作者;论文原文列出 Hamburg University of Technology、Helmholtz-Zentrum Hereon、German Research Center for Artificial Intelligence 和 Saarland University。arXiv v1 首次提交于 2026 年 9 月 4 日 UTC。打开论文原文。3
问题背景 分子回归基准通常用预测误差衡量模型能力。论文提出另一种风险:模型可能从预训练语料中找回 benchmark 已发表的数值,于是得到异常低的误差。这里的审计对象不是“模型是否知道化学”,而是模型是否在给定分子和 prompt 下复现过往的数字。
方法要点 研究者检查 22 个 frontier models、12 个 molecular regression benchmarks;每个 benchmark 使用相同的 500 个 molecules。方法把目标值保留到三位有效数字,观察模型能否逐位复现已发表结果,并把一位到二位、二位到三位的 digit retention 与 molecule-blind floor 比较。超过该基线的单元格才被标记为 retrieval。8
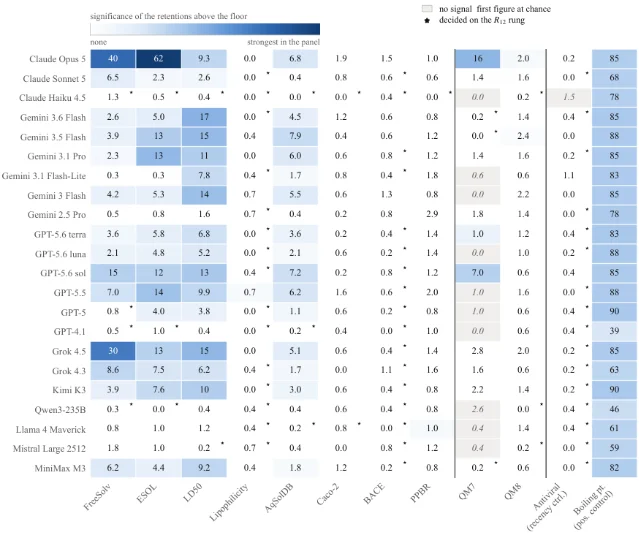
结果亮点 检索信号集中在 5 个 benchmark:FreeSolv、ESOL、LD50、AqSolDB 和 boiling-point control,其余基准多数只出现 isolated cells。在相同 molecule 与 prompt 下,高推理条件标记出
89/264 个单元格,最低推理条件只有 47/264;较低推理强度的审计会漏掉接近一半的标记案例。8benchmark 层面的数据集分布 / molecule 出现频率,与最强 retrieval rate 的相关为
ρ=0.88;benchmark 文件自身列名文档频率的相关只有 ρ=0.20。论文作者推测,二手资料重新分发可能比列名本身更能解释这种关系。把结构字符串做字符替换盲化后,12 个单元格里仍有 3 个被标记;Claude Opus 5 在 ESOL 和 FreeSolv 上仍分别有 6.7% 和 4.8%。8盲化后,Claude Opus 5 的 pooled median absolute error 增加
34.9×,Grok 4.5 增加 16.9×,Kimi K3 增加 3.2×,GPT-5.6 sol 增加 1.8×。不过字符替换同时破坏了化学结构信息,误差变化因此同时包含结构信息受损与检索被打断两部分。8适用边界 digit statistic 只适用于能提供足够有效数字的单元格;clean 或 untestable 只能表示当前测试没有标记,不能当作基准已经证明无污染。盲化方法能中断部分 retrieval,却也改变了化学输入,无法直接推出盲化后的模型更公平。研究没有建立强的 non-memorising classical baseline;22 个模型、12 个基准和不同 reasoning level 也会受到模型可用性与知识截止日期影响。8
一句话阅读价值 如果你的模型在科学基准上取得低得反常的误差,先读这篇可以提醒你把“预测得准”和“是否独立预测”分开审计。
4. Agent memory portability:模型升级时,记忆先坏在哪里
问题背景 长期运行的智能体会把历史写成原始记录、向量索引、自然语言 notes 或结构化知识图谱。更换 writer、reader、embedder 或 repair source 后,系统仍然能否回答过去的问题,取决于损失发生在写入、检索、读取还是修复阶段。论文把这些环节拆开测量。
方法要点 研究固定 48 个 synthetic histories、随机 answer codes 和 exact scoring,比较四种 memory:LC-RAW、RAG、model-written NOTES、fixed-schema KG-fixed。实验模型是 Llama-3.1-8B-Instruct 与 Qwen2.5-7B-Instruct-1M;embedding 从
BAAI/bge-large-en v1.0 换到 v1.5。每个 history 包含 160 个问题,覆盖直接事实、时间变化、矛盾、多步关系和 aliases。9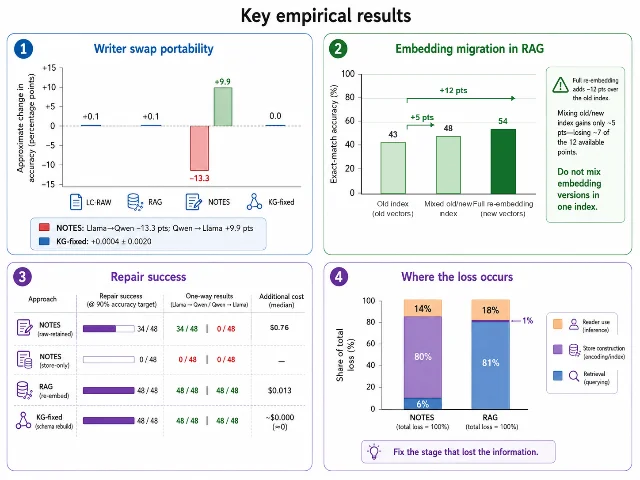
结果亮点 KG-fixed 的 writer swap 变化只有
+0.0004 ± 0.0020,own-store accuracy 在 0.845–0.988。NOTES 迁移则明显依赖方向:Llama-written → Qwen 下降 13.28 个百分点,Qwen-written → Llama 上升 9.91 个百分点。9RAG 的 old index accuracy 为
0.4257,full re-embed 后为 0.5447,增加 11.90 个百分点;50/50 mixed index 为 0.4753,只增加 4.96 个百分点。三种条件的 recall@k 为 0.4846 / 0.5998 / 0.5208,MRR 为 0.3237 / 0.4068 / 0.3643。论文把这一设置中的 81% RAG deficit 归因于 retrieval miss;具体条件是 event chunks、cosine top-k=8、无 reranker 和无 lexical search。9保留 raw history 的 accuracy 为
0.712–0.911。raw-history repair 平均比 store-only 高 8.9 个百分点;Qwen 在 48 个 history 中有 34 个达到 90% own-store recovery,median cost 约 $0.76,Llama 在给定输出限制下有 0 个达到。RAG re-embedding 在 96/96 个 case 成功,约 $0.013 / case;KG-fixed rebuild 为 91–96 / 96。9适用边界 KG-fixed 适合论文中的合成任务,结果尚未说明任何自然语言 notes 都普遍劣于知识图谱。RAG 的 40% miss 与 mixed-index penalty 只对应单阶段 dense retriever 的具体设定;加入 reranker 或 lexical search 后,结果需要重新测量。实验只有两种相近规模模型和 scripted objective workload,真实对话、主观任务、更大模型和更长历史可能呈现不同迁移关系。保留 raw history 还会带来隐私、安全、保留和删除义务,repair 也受上下文与输出预算限制。9
一句话阅读价值 如果你准备升级 agent 的底层模型,先读这篇可以帮助你定位“换模型后记忆失效”究竟该修 writer、index、reader 还是 repair 流程。
5. Speculative Uncertainty:执行前先让小模型看一眼风险
论文与来源 Konstantin Grotov、Valentin Malykh;论文原文列出 Tel Aviv University 和 IITU。arXiv v1 首次提交于 2026 年 9 月 4 日 UTC。打开论文原文。5
问题背景 编码智能体经常经历“生成代码—执行—失败—重试”。如果系统能在执行前判断当前计划可能失败,就可以先触发一次较便宜的 replan,减少无效执行的 token 和工具成本。论文研究黑盒 agent 没有 logits、权重、激活值和重复采样时,是否仍能获得这样的 failure-likelihood score。
方法要点 研究者让小型 open-weight draft model Qwen3-4B 在 teacher-forcing 条件下给黑盒 agent 已生成的 tokens 打分,提取 speculative surprisal、gap 和 entropy 等特征。系统把 reasoning span 与 action span 分开统计,共得到 50 个特征,再用 L1 logistic calibrator 计算失败可能性;执行前低于阈值的计划会被 veto,并触发 replan。评测对象包括 Qwen3-Coder-480B 与 Claude 3.5 Sonnet,任务来自 SWE-rebench、SWE-Bench Verified 和 DA-Code。10
结果亮点 在 SWE-Bench Verified 上,failure prediction AUROC 为 verbalized confidence
0.57、SU no train 0.61、SU SFT 0.76、SU TF 0.77;HTC white-box 为 0.82。DA-Code 上 SU TF 为 0.78。把 reasoning 与 action 分开统计也有贡献:SU-Uniform SFT 为 0.71,SU SFT 为 0.76。10门控后的主要收益落在执行浪费上。SWE-Bench Verified 的错误率从
21% 降到 15%,每任务 token 减少 14%;DA-Code 的错误率从 14% 降到 6%,每任务 token 减少 19%。任务成功率分别从 49% 降到 44%、从 64% 降到 63%,因此这套 gate 的论文证据更接近“少执行失败后的重试浪费”,而非“提高端到端 benchmark 成功率”。10跨 agent 测试中,Qwen 蒸馏的 draft model 在 Claude 3.5 Sonnet 上 AUROC 为
0.69,untrained 为 0.60,mixed 为 0.75。SU SFT 的 Brier score 为 0.101,constant baseline 为 0.129;原文仍把输出称为 failure-likelihood score,因为它尚未完全校准成可直接解释的概率。10适用边界 证据集中在 code-execution success 这一种 binary objective。SQL、web 和 tool orchestration 只是作者提出的未来迁移方向,论文没有给出对应定量结果。所有数字来自 fixed evaluation set 的 single-run point estimates,论文没有报告 seed variance 或 confidence intervals;gate 还会增加一次小模型 forward pass,简单 replan 也不保证恢复任务。10
一句话阅读价值 如果你的智能体主要浪费在“执行后才发现计划有问题”,这篇论文值得先读;如果目标是直接提高任务成功率,结果表里的成功率变化应当先看清楚。
五篇论文放在一起看
五篇论文共同碰到的是同一个具体问题:模型表现出来的能力,要经过多个环节才能变成可验证、可复用的结果。CUA-Universe 测环境与路径选择;Necessary or Sufficient? 测解释与行为之间是否对齐;Molecular Déjà Vu 测基准答案是否可能被数字级找回;Agent memory portability 测信息跨格式和模型升级时在哪里损耗;Speculative Uncertainty 测执行前的风险信号能否减少浪费。每篇论文的任务、模型、指标和实验条件都不同,这组对应关系适合用来安排阅读顺序,不能直接当作一个统一性能定律。12345
对读者来说,一个实用的扫读顺序是:先用 CUA-Universe 判断环境是否让任务可测,再用 Necessary or Sufficient? 检查解释是否有行为证据;做科学预测时加入 Molecular Déjà Vu 的污染审计;做长期 agent 时查看 memory portability 的迁移成本;最后用 Speculative Uncertainty 对照执行前门控能节省什么、又牺牲什么。这个顺序把论文里的“能力”拆成了可以分别核验的工作环节。
按方向打开原文
- Computer Use / 智能体环境:先读 CUA-Universe,重点看 App-Forge 如何构造混合环境,以及 OSWorld 受控协议怎样测 GUI+CLI 的增量。
- 可解释性 / 安全监控:先读 Necessary or Sufficient?,重点看 necessity、sufficiency 与引用频率为何会给出不同排序。
- 科学机器学习 / 数据污染:先读 Molecular Déjà Vu,重点看 digit-level retrieval 的判定逻辑和盲化后仍残留的信号。
- 长期记忆 / RAG 系统:先读 Does Your Agent's Memory Survive a Model Upgrade?,重点看损失发生在写入、检索还是模型读取,以及重嵌入和 repair 的代价。
- 编码智能体 / 成本与执行安全:先读 How to Speculate about Uncertainty in Agentic Coding?,重点看 AUROC、错误率、token 消耗和任务成功率为什么需要分开判断。
References
- 1CUA-Universe 原文
arxiv.org
- 2Necessary or Sufficient? 原文
arxiv.org
- 3Molecular Déjà Vu 原文
arxiv.org
- 4
- 5
- 6CUA-Universe HTML 原文
arxiv.org
- 7Necessary or Sufficient? HTML 原文
arxiv.org
- 8Molecular Déjà Vu HTML 原文
arxiv.org
- 9Agent memory portability HTML 原文
arxiv.org
- 10Speculative Uncertainty HTML 原文
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.