AI 论文早报|8 月 21 日:5 篇新论文把推理增益拆成验证器、证据与选择
精选 2026 年 8 月 19 日 UTC 新提交的 5 篇 AI 论文,比较验证器对齐、候选选择、视觉证据、成本控制与一致性解释如何决定额外推理预算能否转化为可靠增益。

这期收录的是 2026 年 8 月 19 日 UTC 首次提交的 5 篇 arXiv v1 论文。它们分属长上下文蒸馏、开放式测试时扩展、视觉语言模型、推理时自反思和自洽性分析,但共同指向一个更具体的问题:模型得到更多计算之后,增益究竟来自哪里,又会在哪一步被吃掉。
今天的精选标准有三条:原文页面能核验提交时间;方法和实验细节足以判断证据强度;论文能告诉读者一个可操作的阅读方向,而不是只给出一个更高的分数。5 篇论文分别把增益拆到验证器对齐、候选选择、视觉证据、成本控制和一致性解释上。
先看五个结论
- 长上下文蒸馏的关键可能不是再加一份教师信号,而是校准教师与任务验证器的错位。 GC-OPD 在 Qwen3-8B 的五基准平均分上把 vanilla OPD 的
43.56提到44.65;论文同时观察到,输入变长后,教师偏好与验证器排序的分歧会升高。1 - 开放式 test-time scaling 的瓶颈在选择和融合。 候选池的 oracle quality 会随计算量上升,但论文测得 reward model 与真实质量的 Spearman 相关性约为
0.12;Fusion 在 5 个 benchmark 上都超过单次采样,却只恢复约40%的可用 headroom。2 - 视觉幻觉可以通过校准视觉 token 的相对证据来压低,而不必一味减少物体描述。 ReWEIGH 在 4 个 7B backbone 上把 CHAIRI 降低
10.3%–21.3%,缓存视觉证据带来的平均新增延迟为每 token1.33%。3 - 自反思的收益主要出现在需要多步推理的题型,早停负责把成本锁住。 EvoResearcher 在 deepseek-v4-flash 的 MATH 上从单次生成的
26.2%提到40.4%,平均每题生成约2.15次;BBH 的变化落在95%Wilson 区间内,更像成本受控的自验证。4 - 自洽性的一致票数是分级证据,不是正确性认证。 Wrong-Consensus 在 GPQA-Diamond 上发现,单题答案偏好能解释 held-out agreement index 的
81%–93%,但最高一致性 quintile 的经验准确率仍只有0.42–0.83。5
1. GC-OPD:长上下文蒸馏先修正教师和验证器的错位
原文定位。 Beyond Teacher Likelihood: Group-Calibrated On-Policy Distillation for Long-Context Reasoning,作者 Zhu Zhang、Jixun Wang、Xiaoang Xu、Xiaorong Wang、Zihan Zhou、Zhiyuan Wang、Shuo Wang、Chaojun Xiao、Yuezhi Zhou;机构包括 Tsinghua University、Beijing University of Posts and Telecommunications 和 OpenBMB。论文编号为
arXiv:2608.19181,v1 提交于 2026 年 8 月 19 日 UTC,是一篇公开预印本;作者同时公开了 代码仓库。6问题背景。 On-Policy Distillation(OPD)通常把教师模型的逐 token 偏好当作训练信号。长上下文任务里,答案是否完成往往取决于分散在远距离位置的证据能否被一起收集;教师觉得某个 token 更自然,并不保证整段回答更符合任务验证器。论文在 Multi-Table Extraction 和 High-Recall Retrieval 上比较了两种排序:在输入长度低于
8K 和达到 32–64K 时,前者的 pairwise disagreement rate 从 40.6% 升到 64.0%,后者从 35.2% 升到 60.2%。这组结果只覆盖论文选取的两个任务和指定模型设置,但足以说明长输入会放大两种信号的错位。1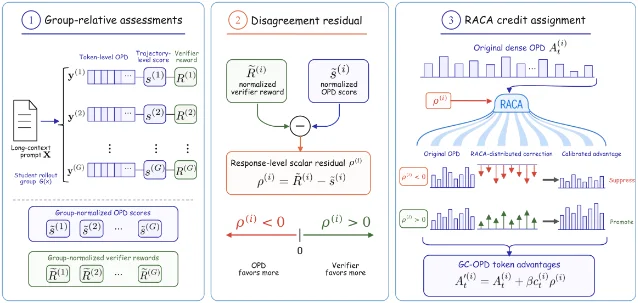
方法要点。 GC-OPD 不把 verifier reward 直接替换成新的 dense reward。作者先在同一组 rollout 内分别标准化 verifier reward 和 trajectory-level OPD score,再计算有符号残差
ρ = R̃ − s̃:残差为正,说明验证器更认可这条回答;残差为负,说明教师支持相对更强。随后,RACA 根据每个 token 的相对 OPD advantage 分配这项修正,让原本支持较强的 token 获得不同于弱支持 token 的调整。训练使用 Qwen3-4B 和 Qwen3-8B 学生、Qwen3-30B-A3B-Thinking-2507 教师;32K 过滤后的 GoLongRL 训练子集包含 9,527 条 prompt,评测覆盖 DocMath、Frames、MRCR、CorpusQA 和 LBv1QA。1结果亮点。 五个基准的无加权平均分中,Qwen3-4B 的 vanilla OPD 为
39.31,GC-OPD 为 40.47;Qwen3-8B 从 43.56 提到 44.65。消融结果更能说明增益来自哪里:只增加另一份 OPD 项,平均分只有 43.60;直接加入组归一化 verifier reward 为 44.19;换成有符号残差后为 44.65。在 token 分配上,uniform 为 44.28,RACA 为 44.65。1适用边界。 证据来自两个错位诊断任务、5 个长上下文基准、两种 Qwen3 学生和一套特定 verifier、教师与训练预算。结果支持「在这套长上下文 OPD 设置里,验证器校准有额外价值」,还不足以推出所有长上下文任务都会得到同样幅度的提升。
一句话阅读价值。 如果你正在做长上下文 RL 或蒸馏,先看这篇如何把「教师说得顺」和「任务判定为对」拆成两个可校准的信号。
2. Test-Time Scaling in the Wild:开放式任务缺的不是候选,而是选择
原文定位。 Test-Time Scaling in the Wild: Why Exploitation, Not Exploration, Is the Bottleneck,作者 Davide Romano、Kanak Raj、Jerrod Parker、Daniele Giofrè,机构为 Thomson Reuters。论文编号为
arXiv:2608.18931,v1 提交于 2026 年 8 月 19 日 UTC,是公开预印本。8问题背景。 在数学题上,答案可以由 exact match 或简单 verifier 判断;法律、医疗、金融和写作里的开放式回答则没有这么干净的终点。论文把 test-time scaling 拆成两步:先花计算生成更多候选,再从候选中选出或合成最终答案。它在法律 LEXam、医疗 HealthBench、金融/法律 PRBench、通用聊天 WildBench 和写作 WritingBench 上比较了 Best-of-N + ORM、Beam Search、Particle Filter、Sequential Refinement、Budget Forcing 和 Fusion。2
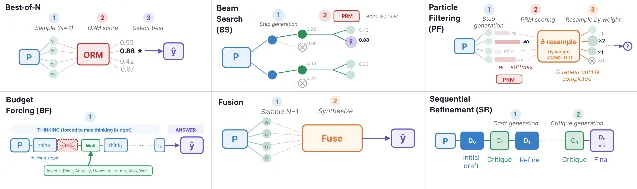
方法要点。 论文先观察 candidate pool 的 oracle quality:随着计算预算上升,池子里确实更容易出现高质量答案。接着,作者检验现有 reward model 是否能把这些潜在质量转化为最终答案。实验统一使用 Qwen3.5-397B-A17B 作为 judge,并覆盖两个模型家族;作者还提醒,oracle estimator 对 Best-of-N 是精确的,对 Fusion、Refinement 和 Particle Filter 则是近似的。2
结果亮点。 开放式 benchmark 上,reward model 与真实质量的 Spearman 相关性约为
0.12,两个 ORM 的表现接近;Best-of-N 只能捕获约 15% 的可用 headroom。Fusion 是 5 个 benchmark 中唯一持续超过单样本 baseline 的方法:在 XHigh 设置下,Qwen3.5-35B-A3B 的 overall 分数为 0.610,单样本 baseline 为 0.574,最佳 RM-based 方法为 0.584。但 Fusion 仍只捕获约 40% 的可用 headroom。Sequential Refinement 的收益也不稳定:HealthBench 和 LEXam 分别下降 2.3 和 4.5 个百分点,WritingBench 的提升又受到 verbosity bias 影响。2适用边界。 这不是对所有模型和所有 judge 的普遍结论。实验只覆盖两个模型家族,使用统一的 judge;论文的 oracle 估计对部分方法只是近似。更直接的工程含义是:开放式任务不能只增加采样数,还要单独测量「候选里有没有好答案」和「系统能不能把好答案选出来」这两个环节。
一句话阅读价值。 如果你的 test-time scaling 在开放式评测上加预算却收益很小,这篇论文给出的第一检查点不是继续采样,而是检查选择器是否看得懂候选差异。
3. ReWEIGH:用视觉 token 的相对证据减少幻觉
原文定位。 ReWEIGH the Evidence: Calibrating Token-Level Ordinal Visual Evidence to Mitigate Hallucinations in Large Vision-Language Models,作者 Jihae Jeong、Junha Choi、Hwanjo Yu,机构为 Pohang University of Science and Technology(POSTECH)。论文编号为
arXiv:2608.19075,v1 提交于 2026 年 8 月 19 日 UTC,是公开预印本。10问题背景。 视觉语言模型生成名词时,某个词的概率高,并不代表图像真的支持它。不同视觉位置的隐藏状态尺度可能不同,直接比较概率也难以知道某个候选词是不是得到了足够的视觉证据。ReWEIGH 把问题缩小成一个解码阶段的判断:当前图像对某个候选 token 的支持,是否低于这个模型在无标签图像上校准出的参考水平。3
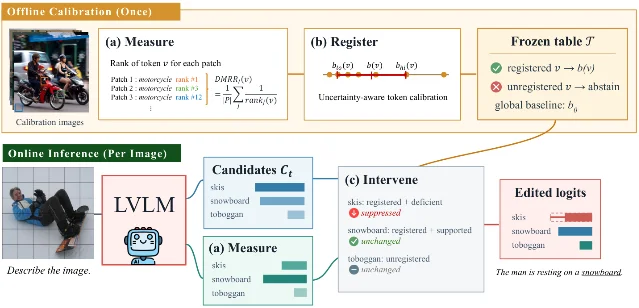
方法要点。 ReWEIGH 是 training-free decoding intervention。作者把视觉 token state 投影后的 vocabulary rank 汇总成跨视觉位置的尺度不变证据,再用无标签图像建立 token-specific reference。推理时,模型在 prefill 阶段缓存当前图像的视觉证据;生成过程中,只有低于自身参考值的候选 token 会受到有界惩罚。作者在每个 backbone 上单独选择读出层和干预强度,校准集使用
500 张 MS COCO 训练图像。3结果亮点。 4 个 7B backbone——LLaVA-1.5-7B、Qwen2.5-VL-7B、InstructBLIP-7B 和 LLaVA-NeXT-7B——上的 CHAIRI 降低幅度为
10.3%–21.3%。扩展实验覆盖 11 个模型、6 个 architecture family 和 7B–32B 参数规模。以 LLaVA-1.5-7B 为例,CHAIRI 从 base 的 15.61 降到 12.67,F1 从 80.66 变为 80.85;缓存视觉证据后,平均新增延迟为每 token 1.33%。论文还同时检查 AMBER、MMHal-Bench 和 MM-Vet,避免把「少提物体」误当成幻觉减少。3适用边界。 方法需要访问 visual-token hidden states、output normalization 和 vocabulary head,因此无法直接用于闭源 API。当前每个 backbone 都需要单独校准,论文没有证明校准表和参数可以跨模型直接迁移。实验在英文环境完成,视觉证据也不能补上图像和模型都没有的外部事实。3
一句话阅读价值。 如果你维护的是可访问内部 logits 的开源视觉语言模型,这篇论文值得用来思考「减少幻觉」和「保留描述内容」能否由同一套 token-level 规则同时约束。
4. EvoResearcher:让自反思先解决难题,再用 sentinel 控制成本
原文定位。 Training-Free Inference-Time Self-Reflection and Cost-Bounded Early Stopping for Large Language Models,作者 Wei Yu、Suxing Liu、Minjie Yu、Jiahao Wang、Zhijian Zheng、Haocheng Deng、Bing Li;作者机构列为 School of Digital Arts, Jiangxi Arts & Ceramics Technology Institute,以及 School of Computing, Universiti Sains Malaysia。论文编号为
arXiv:2608.18884,v1 提交于 2026 年 8 月 19 日 UTC,是公开预印本。12问题背景。 推理时多生成几次,成本会线性增加;固定生成次数又会把简单题和难题当成同一种任务。EvoResearcher 把自反思过程写成一个循环:模型先生成答案,再自我批评并修改,直到达到最大深度,或 critique 返回
CONFIRMED。作者把 correctness、efficiency、reflection depth 和 tool-call diversity 作为 prompt-level meta-reward 的四个设计维度。4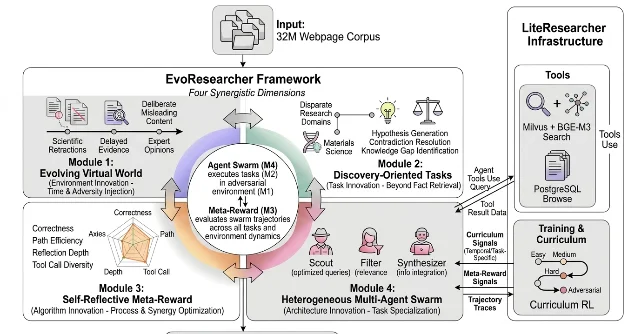
方法要点。 这是在 frozen LLM backbone 上运行的 inference-time 方案,主比较使用 deepseek-v4-flash,并在 Qwen2.5-72B-Instruct 上复制。论文把
CONFIRMED 当作可解释的停止标记,同时让最大反思深度提供硬预算。这样,系统可以对难题继续生成和修订,也可以在模型认为答案已经稳定时提前结束。4结果亮点。 在 deepseek-v4-flash、每类
n=500 的比较中,single-shot 在 BBH、GSM8K、MATH 上分别为 73.8%、93.6%、26.2%;EvoResearcher 分别为 74.0%、97.8%、40.4%。平均每题生成 2.15 次,约消耗 1,050 tokens。MATH 的增益约 +14.2 个百分点,GSM8K 约 +4.2 个百分点;clean BBH 的深度曲线基本持平,差异落在 95% Wilson 区间内。CONFIRMED 早停覆盖约 82%–88% 的项目,平均约 2.1 次生成。4适用边界。 置信度阈值实验显示,阈值设为
≥0.6 时,模型会在第一代就停止,说明主要作用来自 CONFIRMED sentinel,而不是数值 confidence。论文没有验证真实 tool-use、evolving environment 或 multi-agent 场景;tool-call diversity 在当前证据里只是 prompt-level 设计维度。4一句话阅读价值。 如果你的推理服务需要在准确率和 token 预算之间做动态取舍,这篇论文最值得看的不是「反思」二字,而是它如何用可观察的停止信号把额外计算限制在难题上。
5. Wrong-Consensus:多数答案相同,仍然可能只是同一种错
原文定位。 Decomposing Wrong-Consensus Agreement in LLM Self-Consistency: A GPT-4.1 Case Study,作者 Lizhuo Zhang、Mengmeng Tang、Chenfeng Long、Xiaoyong Tang、Xiang Luo;机构包括 College of Information and Intelligence, Hunan Agricultural University、Yuelushan Laboratory,以及 China Guangdong Tobacco Meizhou Ltd. 论文编号为
arXiv:2608.18795,v1 提交于 2026 年 8 月 19 日 UTC,是公开预印本。14问题背景。 Self-consistency 常把多次采样里的多数答案当作更可信的答案,但模型可能在同一个错误上达成共识。Wrong-Consensus 不提出新的投票方法,而是做描述性分解:它定义 wrong-consensus agreement index
Γ,再把一致性拆成两部分——由单题 answer preference 可以解释的 mechanical component,以及剩下的 preference-unexplained residual。实验使用 GPT-4.1 的 K=50 个样本,并讨论 tie-break、temperature 和 AIME 的 string-level clustering 等边界。5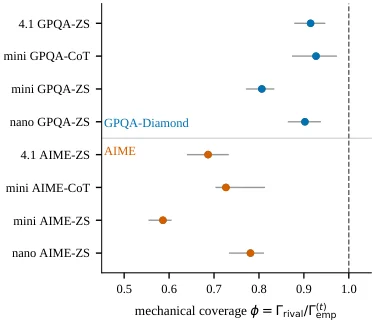
方法要点。 作者先用每道题的答案偏好估计「如果只看模型对候选答案的偏好,机械上能解释多少 agreement」,再把 held-out agreement index 中无法由这部分解释的残差单独留下。这个分解的用途是区分两件容易混在一起的事:模型是否稳定偏向某个答案,以及多个采样是否因此在错误答案上聚集。论文把结果定位为 observational / descriptive findings,没有据此识别 shared training bias 的因果机制。5
结果亮点。 在 GPQA-Diamond 上,mechanical preference 可以解释 held-out agreement index 的
81%–93%;在 AIME 上为 59%–78%,但仍留下 1.56–2.80 个 Γ 单位的 residual。困难题上的 self-consistency backfire,其 voting gap 最低为 −0.09,coupled CI 为 [−0.12, −0.07]。即使进入最高一致性 quintile,经验准确率仍只有 0.42–0.83。5适用边界。 这是一项 GPT-4.1 case study,重点是解释一致性指标的构成,不能直接外推到所有模型、采样温度或聚类规则。读者尤其要保留一条边界:更高 agreement 说明采样更集中,却没有单独提供足够证据证明答案正确。
一句话阅读价值。 如果你的评测把「多数投票」当成可靠性信号,这篇论文适合用来检查:你的共识指标究竟在测正确性,还是只在测模型重复同一个判断的倾向。
读完之后,应该留下什么判断
这 5 篇论文没有共同证明「多花推理预算就一定更好」。它们把增益链条拆成了几个不同的检查点:长上下文蒸馏要看教师信号是否和任务验证器对齐;开放式 test-time scaling 要把候选生成和最终选择分开;视觉语言模型要校准图像证据而不是只压低输出;自反思要让难题多走几步、让简单题尽早停下;self-consistency 则要把答案集中度和答案正确性分开。
因此,读者可以按自己的工作位置选原文:做长上下文训练,先看 GC-OPD 的残差和 RACA;做开放式生成,先看 Test-Time Scaling 的 exploitation 诊断;做开源 VLM 解码,先看 ReWEIGH 的校准接口;做推理服务编排,先看 EvoResearcher 的停止信号;做投票式评测,先看 Wrong-Consensus 如何拆解 agreement。真正值得带回工程里的问题只有一个:你的系统当前缺的是更好的候选、更可靠的验证,还是更节制的选择。
References
- 1
- 2
- 3
- 4
- 5
- 6arXiv:2608.19181 abstract
arxiv.org
- 7GC-OPD method overview
- 8arXiv:2608.18931 abstract
arxiv.org
- 9Test-Time Scaling method schema
- 10arXiv:2608.19075 abstract
arxiv.org
- 11ReWEIGH method overview
- 12arXiv:2608.18884 abstract
arxiv.org
- 13EvoResearcher framework figure
- 14arXiv:2608.18795 abstract
arxiv.org
- 15Wrong-Consensus coverage figure
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.