扩散会赢下 AI 推理吗:一位奠基者的论证,和同一批模型的另一组读数
No Priors 9 月 18 日这期请来斯坦福教授、Inception 联合创始人 Stefano Ermon:他为什么押注扩散赢下推理,以及同一批模型身上量出来的另一种读数。

2026 年 9 月 18 日,播客 No Priors 更新了一期 38 分钟的访谈,标题是《Why Diffusion Will Win AI Inference》,主持人 Sarah Guo 在开场把嘉宾说成「diffusion 之父之一」。1
嘉宾 Stefano Ermon 是斯坦福计算机系的副教授。2019 年,他和自己的博士生 Yang Song 开始做 score-based 生成模型,那是今天扩散模型这条线的源头之一;他后来也出现在 DDIM、FlashAttention、DPO 这几篇论文的作者名单里。23
他还有一个身份:Inception 的联合创始人兼 CEO。这家公司 2025 年 2 月走出隐身,2025 年 11 月宣布 5000 万美元种子轮融资,Menlo Ventures 领投,产品是 Mercury 系列模型。45
他把这期访谈的核心主张压成了一句话:自回归的推理是串行的,串行不匹配 GPU;2017 年从 RNN 换到 Transformer,解决的是训练这一侧的并行,推理这一侧的等价动作就是扩散模型。23
他的原话是「the bitter lesson is that the more parallel solution is the one that is eventually going to win」,更并行的那一边最终会赢。23
这句判断的支撑和反证,来自同一批公开材料——包括他自己公司的图,和 Google 的图。
01 他赌的是什么
自回归模型从左到右一个一个吐 token,第 10 个 token 必须等前面九个生成完。扩散模型的做法是先给整段输出盖上「噪声」(文本上表现为遮盖),再一遍遍去噪,把整段文字逐步定稿。23
他给自回归下的是一个架构层判断:「That kind of workload is extremely memory bound. You're spending most of your time moving around weights across the memory hierarchy, and you're doing very little arithmetic.」这段工作负载极度受限于显存带宽,大部分时间花在把权重在存储层级之间搬来搬去,真正做的算术运算很少。23
这条路线最硬的地方在离散数据上。图像像素之间可以插值,两个词之间却没有中间态,他的原话是「there is not necessarily something in between them」,两个词之间未必存在介于两者之间的东西。23把扩散搬到文本上需要新的方法,这一步走了好几年。23
他给出的第一个实证是 2024 年那篇论文:在 GPT-2 那个量级(他说的口径是不到 10 亿参数)上,用同一份数据、仍然是 transformer,按扩散方式训练,困惑度与同参数量的自回归模型持平,而生成速度大约是后者的 10 倍。23
这段自述需要标一下边界。与「2024 年那篇论文」最匹配的公开文本是 SEDD(Lou、Meng、Ermon,ICML 2024 口头报告),它摘要里写的是「同等质量下网络评估次数少 32 倍」,没有出现「10 倍」这个说法。6节目里的 10 倍,是他本人口头上的量化。
他给推理速度的重要性算的是经济账:决定成败的是每瓦能买到多少智能、每美元能买到多少智能。23
他还把后训练拉进来说:强化学习要模型反复生成 rollout、打分、再改进,这一步同样卡在推理速度上。23
他在这套论证里给自己划了两处边界。
一处是质量定位:「we're not at the frontier level of intelligence」,我们还没有到前沿智能水平。23
另一处是可服务的市场。他根据 OpenRouter 公开的用例分布估算,对延迟真正敏感的工作负载占 20% 到 30%,并把这个数当作下界。23
02 他的公司现在卖的是什么
官方给出的数字是:在常见 NVIDIA GPU 上 1,107 tokens/秒、上下文 260K、每百万 token 输入 0.20 美元、输出 0.75 美元。24
官方还放了一张速度对比图,同一张图上的另外三个模型分别是 Gemini 3.5 Flash Lite(321)、Claude Haiku 4.5(127)、GPT-5.6 Luna (Low)(99),单位同样是 tokens/秒。24
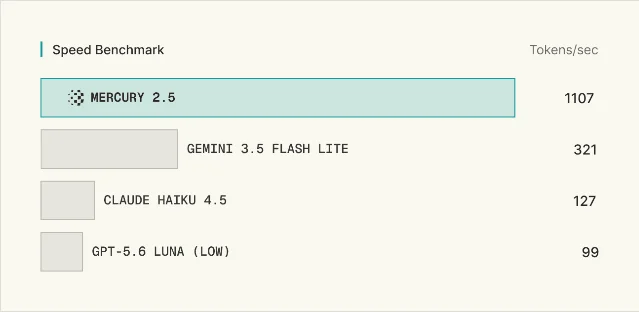
这期访谈里他报的是另一组对照:Mercury 的质量与 Haiku、Flash、OpenAI 的 mini/nano 这几个速度优化过的模型「on par」,也就是水平相当,速度上则明显更快。23
关于 Mercury 的训练规模与算力,他明确拒答。被问到模型有多大、用了多少算力时,他说「the size of the models or the flops… it's kind of like a trade secret」,这属于商业机密;公开渠道上也确实找不到 Mercury 的模型卡或开放权重。23
他还讲了另一件要花成本的事:扩散语言模型跑不了 vLLM 或 SGLang,公司得自己写推理引擎。23
一句话概括这期的商业结构:他在为一条自己做产品、且不公开内部数字的技术路线背书。
03 换一把尺子量同一个模型
独立评测机构 Artificial Analysis 测过上一代 Mercury 2:479.6 tokens/秒,首 token 延迟 6.81 秒,而同类模型的首 token 延迟中位数是 2.14 秒。9Mercury 2 发布时,官方口径是「>1,000 tokens/秒」。25
同一家机构对 Mercury 2 的评语是:「While it does not have leading intelligence, its output speed is more than 3X the next fastest model in this class」——智能度不属于领先档,但输出速度是同类第二名的三倍以上。10
OpenRouter 自己那条链路上量出来的数又是另一个形状。平台侧遥测显示,Mercury 2.5 的 P50 吞吐约 62 到 65 tokens/秒,Mercury 2 约 151 tokens/秒。25
官方报 1,107,平台路由上量出来 62 到 65,两个数字并不冲突,它们量的不是同一件东西:官方报的是在自家硬件上的生成速度,平台量的是路由链路端到端的输出速度,里面包含排队、调度与供应商侧的开销。2425
到 9 月 18 日,公开可查的独立读数只有这些。Artificial Analysis 还没有公开对 Mercury 2.5 的评测;用同一套硬件、同一批任务把扩散模型与自回归模型放在一起的头对头第三方检验,目前还不存在。26
04 反方在算什么账
最有力的反证来自 Google,而且写在 Google 自己的发布材料里。
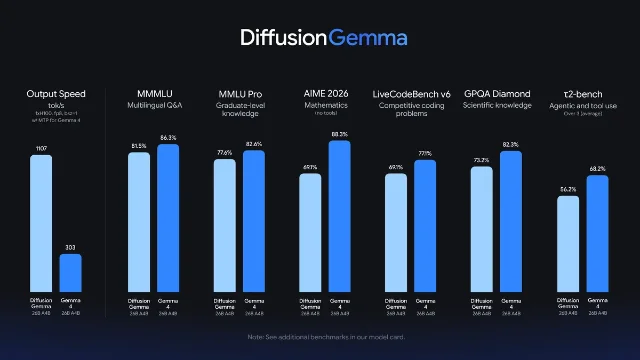
2026 年 6 月 10 日,Google DeepMind 放出 DiffusionGemma:一个 26B 的 MoE 模型,Apache 2.0 许可,一次并行生成 256 个 token。11
官方博客把代价写得比谁都直白:因为把速度与并行生成排在优先位置,「DiffusionGemma's overall output quality is lower than standard Gemma 4」,质量低于同门的常规 Gemma 4,对质量要求最高的场景建议继续用后者。27
同一份材料还限定了这条路线的主场:「In high-QPS cloud serving, autoregressive models can be deployed to saturate compute efficiently, so DiffusionGemma's parallel decoding offers diminishing returns and can result in higher serving costs.」在高并发云端服务里,自回归模型能把算力打满,扩散的并行解码收益递减,甚至更贵。它的优势集中在单卡、低到中等批次大小。27
机制上的质疑也有人写下来了。
Joe Barrow 在 8 月 10 日的一篇长文《Don't Diffuse, Speculate!》里算了一笔账:两条路都是在拿吞吐换延迟,扩散并没有省下总工作量。按他的粗略算法,自回归是「模型浮点运算量乘序列长度」,扩散每块跑两步就是两倍;投机解码则是在骨架模型上加一个很小的草稿模型,代价最低。12
在扩散模型里,当前这一块正在去噪的 token 每一步都可能被改写,没法像自回归那样缓存;于是每个去噪步都要对着整段上下文重算注意力,代价在长上下文里被放大。13
还有一篇负结果论文(2026 年 7 月 14 日)测的正是「拿同一套权重兼职做草稿」这条路,把边界写成了一句判据:草稿必须比验证器便宜得多,光有更长的接受前缀补不上这个差距。这解释了为什么「让大模型自己并行出草稿」省算力的期待往往会落空。14
Barrow 在文章末尾自己留了活口:「I am confident that this will be wrong in a year or two!」他确信一两年后自己这套判断会被推翻,因为他认识的最聪明的一批人正在往扩散上押注。28
05 自回归那边同期没有站着不动
「并行」带来的收益,自回归这一侧也在用别的手段拿。
DeepSeek 在 V4 的技术报告里给出:在百万 token 上下文下,V4-Pro 需要的 KV 缓存只有上一代 V3.2 的 10%,单 token 推理的浮点运算量也只有后者的 27%。15
同一条线上还有一份部署报告:DSpark 用「置信度调度」决定每次草拟多长,相对生产基线 MTP-1,在同等吞吐水平下把每个用户的生成速度提高 60% 到 85%。这份报告写的是 DeepSeek 自家线上真实流量的结果。16
有意思的是,扩散与自回归两侧用的是同一套想法:扩散模型用模型自报的置信度决定每一步把哪些位置定稿,自回归用置信度决定草稿写多长。29
Google 自己那张图里也能看到这件事:同在单卡 H100、batch size 1 的测试下,Gemma 4 单独跑是 204 tokens/秒,加上投机解码的 MTP 之后到 303,正是图里 DiffusionGemma 那一栏旁边的对照数字。27
06 中国这一侧在下什么注
这条路线在中国也有人在下注。
蚂蚁的 InclusionAI 团队把 LLaDA 系列从 8B 一路做到千亿参数:2025 年 11 月的 LLaDA2.0 有 16B 与 100B 两个版本,官方称这是扩散模型第一次被放大到千亿参数级别;2026 年 7 月的 LLaDA2.2 引入删除与插入两种控制 token 的编辑式扩散,权重以 Apache 2.0 开源。1718
官方给出的对比是同一条轴上的两面。速度上,LLaDA2.2-flash 全面领先同门的自回归模型,SWE-bench Verified 上是 519.0 对 303.2 tokens/秒;质量上互有胜负,同一项基准上的得分是 49.28 对 61.20,而在 τ²-Bench 上反超,80.33 对 76.36。30
字节 Seed 的 Seed Diffusion Preview 在 2025 年 7 月给出的数字更激进:代码推理 2,146 tokens/秒,比同规模自回归模型快 5.4 倍。发布方同时点出两处难点——纯随机顺序的学习信号效率低,以及迭代去噪带来的延迟反过来抵消并行优势。这份工作至今没有后续版本,也没有开放权重。19
腾讯的 WeDLM 选的是另一条路:把扩散塞回标准的因果注意力,并让它兼容原生的 KV 缓存,模型卡上的说法是「与 vLLM 优化过的模型相比有真实加速」。这条思路直接对着扩散最难缓存的那处短板。20
华为诺亚方舟实验的是一处更窄的对照:同一个 Agent 框架、同一批轨迹数据,只把骨干从自回归换成扩散,端到端平均快 30% 以上,个别场景超过 8 倍;代价是这类模型更容易出工具调用格式错误,需要专门训练。21
把这些放在一起,这条路线已经分出三种活法:一种是纯扩散,走的人包括蚂蚁的 LLaDA 与字节的 Seed Diffusion;一种是让扩散兼容自回归那套缓存机制,比如腾讯的 WeDLM;一种是把扩散降级成给自回归模型打草稿,IFM 的 Uno 就是把它做成无损加速的草稿器。223132
07 接下来看什么
第一,Mercury 2.5 会不会出现第三方复现。 现在同一个模型身上挂着 1,107 与 62 到 65 两个数,两者量的东西不同,但差距需要一个第三方用公开口径来收敛。2425
第二,Artificial Analysis 会不会给出 Mercury 2.5 的读数。 到 9 月 18 日,这家机构的公开页面上只有 Mercury 2 的数据。26
第三,开源权重的扩散模型会不会进入第三方基准。 LLaDA2.2 已经开源,是目前最适合被外部复测的一批权重;现在它的所有数字都来自官方。3031
第四,Google 会不会把 DiffusionGemma 放进云端高并发场景。 它自己写明那条路上收益递减;如果哪天它改口,说明这处约束被解掉了。27
第五,那个 20% 到 30% 会不会被验证。 它衡量的是愿意为延迟付钱的市场有多大,这条路线能长到多少,取决于这个份额。23
这一期的核心论证成立与否,最后会落在同一个问题上:扩散能不能在同等算力下,把质量也追上来。现在能公开查到、并给出对照数字的材料里,扩散赢下来的都是速度,质量那一栏要么更低,要么互有胜负。2730
References
- 1
- 2Stefano Ermon, Stanford Profiles
profiles.stanford.edu
- 3
- 4
- 5Inception 官方博客:Company
inceptionlabs.ai
- 6
- 7Introducing Mercury 2.5
inceptionlabs.ai
- 8OpenRouter: Mercury 2.5
openrouter.ai
- 9Artificial Analysis: Inception
artificialanalysis.ai
- 10
- 11Introducing DiffusionGemma
blog.google
- 12
- 13Strengths and limitations of diffusion language models
seangoedecke.com
- 14
- 15
- 16
- 17LLaDA2.X 官方仓库
github.com
- 18LLaDA2.2-flash 模型卡
huggingface.co
- 19Seed Diffusion Preview
seed.bytedance.com
- 20WeDLM-7B-Base 模型卡
huggingface.co
- 21
- 22
- 231
- 247
- 258
- 269
- 2711
- 2812
- 2916
- 3018
- 3117
- 3220
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.