模型早就够用了:Mollick 的四项个人优势,和他第三次说的同一句话
沃顿副教授 Ethan Mollick 9 月 18 日发文说,模型的能力早就够用,差距在人们实际怎么用它;本期把他那三个可点开的演示、他引的 Anthropic 报告自己写下的边界、四项个人优势的出处,以及同期第三方企业采用数据摆在一起。

2026 年 9 月 18 日,宾夕法尼亚大学沃顿商学院副教授 Ethan Mollick 在自己的 Substack《One Useful Thing》上发了一篇长文,标题是《The Overhang》,副题列了四样东西:深度知识、广度知识、品味、能动性。1
Mollick 是沃顿的管理学副教授、沃顿生成式 AI 实验室(Generative AI Labs)联合主任,研究 AI 对工作、创业与教育的影响,写过畅销书《Co-Intelligence》。2
他这篇的落点不在下一批模型。
文章里有一句定义:「The capability overhang, the gap between what these models can do and what almost anyone is doing with them, is an opportunity.」——能力过剩,也就是模型能做的事,和几乎所有人实际拿它做的事之间的那道差距,是一个机会。16
他算的是两笔账:这批模型能干什么,以及人们实际拿它干了什么。
01 他说这批模型已经够用
他先承认围绕 AI 风险与限速的那场争论有其道理,然后把重心放回眼下。
原话是:「If every lab stopped training new models tomorrow, that wouldn't change the fact that GPT-6 Astra and Fable 5.1 are already enough to change how large parts of the economy work.」——就算所有实验室明天停止训练新模型,也改变不了一个事实:GPT-6 Astra 和 Fable 5.1 已经足够改变大片经济部门的运作方式。16
他给这两款模型的一句话评价是:在得到恰当引导和使用的前提下,它们能稳定完成人类要做上几周的工作。16
支撑这句话的是三个他自己做的项目。
第一个是把 1977 年的文字冒险游戏《Zork》改成能玩的 3D 动作冒险游戏。这个游戏原本没有画面,每个地点只有一段文字,所以模型得自己决定白房子长什么样、暗处的怪物长什么样,还得把「打巨魔」改成一套动作序列。16
第二个是重建意大利作家 Umberto Eco 在米兰公寓里的书房。模型找不到平面图,于是改用十几段视频、公开的照片和两份书目:它逐帧读视频里的书脊,推断出房间,把能认出的五千来本书放进两万七千个格位,每本书都标上确定、猜测还是未知,镜头没拍到的那几排书柜用雾画出来。16
第三个是给他的新书做预告片。他给模型一本自己的书稿,让它从 AI 的视角做一支片子;模型自己用了三维软件 Blender,配了旁白、音乐和音效,45 分钟后交片。他后来又要了一版动作片风格的,模型把上一版的三维动画当分镜,用视频生成器出镜头,再剪成片。16
他对这三个项目的定性是:它们只花掉了 ChatGPT 账号里一小部分 token 预算。16
02 他拿什么当证据
前两个项目有页面可以点开。
《Zork》那一版做成的是一个网页游戏,页面上的说明是「A free, first-person 3D adaptation of Zork I」,免费的第一人称 3D 版《Zork I》,键位提示包括 WASD 移动、E 交互、鼠标左右键攻击与格挡。3
Eco 书房那一版是一个可浏览的三维地图,页面底栏的数字是「27,547 shelf slots in 6 rooms」(6 个房间共 27,547 个格位)与「22,193 unidentified」(22,193 个未识别),与他文中所说的「over 27,000 shelf slots」对得上。4
这份地图值得多看两眼。它给每个格位标了出处——来自视频某一帧、某张公开照片,还是某份书目记录;也标了放置的可靠度,最后汇总成确定、猜测、未知三档;页面最下面一行是「Nothing here was measured.」,这里没有一处是实测出来的。17
两个页面都没有署名,也都没有写自己由 AI 生成。能核对的是成品存在、数字自洽;至于预告片那处「45 分钟交片」的耗时口径,只有他本人的说法。161718
03 他引的那份报告自己写了什么
三个项目之外,他还引了一份量化研究。
那是 Anthropic 在 2026 年 6 月 16 日发布的报告《Agentic coding and persistent returns to expertise》,数据来自约 40 万条 Claude Code 会话,时间跨度是 2025 年 10 月到 2026 年 4 月。5
报告第 9 页的 Figure 3,给出的是这批会话按用户专长分五档后的产出。19
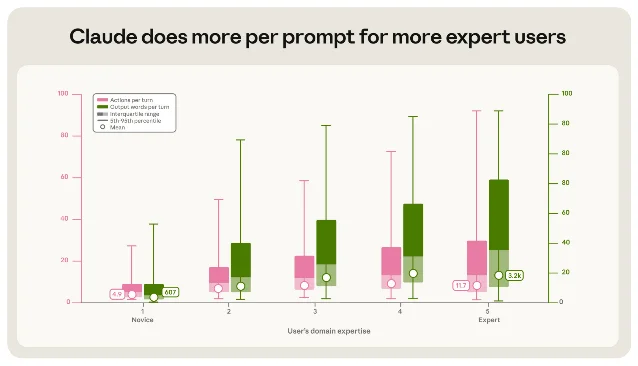
Mollick 转述这份材料时用的说法是:专家从 AI 那里不仅拿到更好的结果,也拿到更多结果。16
报告自己写下的边界,他这句里没有带出来。
按报告的记录,可验证成功率的差别主要集中在新手到中级这一段:新手约 15%,中级及以上约 28% 到 33%;而中级与专家之间的差距,报告用的词是「modest」,温和。报告还写明,它没有观察这些人在真实世界里的结果。19
04 四项个人优势
文章的后半段转向个人该做什么,落点是四项优势。
第一项是深度知识(deep knowledge):在一个领域里理解到能建立直觉、能快速准确判断的程度,比如资深会计扫一眼表格就知道哪里不对。他把这称作看清「锯齿状前沿」的唯一办法,因为只有专家能看懂本领域里 AI 在哪儿成、在哪儿败。16
第二项是广度知识(wide knowledge):跨领域涉猎,知道该向 AI 要什么。他举的例子是,如果你不懂设计,就不会想到要告诉 AI 别在标题上方再加一行小标题(他用的词是「adding eyebrows」,给标题加眉毛)。16
第三项是品味(taste):做东西变快变便宜之后,稀缺的是从一堆产出里挑出该留哪一个的能力。他承认生成式 AI 主要带来的是大量彼此相似的垃圾,而这件事只有品味能挡住。16
第四项是能动性(agency):愿意在所有人心存困惑的时候去试探边界,自己发现 AI 能做什么,而不是等人来通知。他把自己那些「古怪的 AI 实验」归在这一项下面。16
原文写的是「In my book, I outline four particular personal advantages」——这四项优势出自他书里的框架。16书名叫《Co-Existence》,出版社 Portfolio,2026 年 10 月 20 日上市。6
文章中间有一段专门讲预售:在 10 月 20 日前下单的读者,会拿到一个与 AI 的语音访谈链接,访谈会根据你的回答生成一份关于你自己四项优势的报告。16书籍官网上还留了一个给 AI 的入口,写着「Are you an AI?」(你是 AI 吗?)。7
这篇长文因此同时是新书的预售材料,四项优势是书里的框架。
05 同一个判断,他讲了三次
「就算训练明天停下,改变也已经发生」这半个判断,不是他第一次写。
2023 年 7 月 23 日,他写《On holding back the strange AI tide》时说:「And, even if they never get any better, even if future AIs are highly regulated (both seem highly unlikely), the AIs we have today are going to bring a lot of change.」——即便它们此后再无进步,即便未来的 AI 受到严格监管(两件事都极不可能),我们今天手上的 AI 也会带来大量改变。8
2024 年 11 月 4 日,他在《The Present Future》里换了个写法:「Even if AI development stopped today, we would have years of change ahead of us integrating these systems into our world.」——即便 AI 研发今天停摆,我们前面仍有数年时间要消化这些系统进入世界带来的变化。9
三年里,这个判断的表述从「也会带来大量改变」走到「前面仍有数年」,再到这次的「足以改变大片经济部门」。
这一次新增的东西有三样:可点开的演示页;一份把「专长放大产出」量化的报告;以及把人类优势固定成四项,并与新书的预售奖励绑在一起。16
06 同行在哪
「能力过剩」这个词,OpenAI 今年 1 月就拿去用了,比他这篇早八个月。
2026 年 1 月 18 日,OpenAI 在一篇讲 AI 与个人赋能的文章里使用这个概念;三天后的 1 月 21 日,它发布了一份专门的报告《Ending the Capability Overhang》。1011
那份报告给了一个它自己的数字:「The typical power user relies on about seven times more advanced 'thinking capabilities' than the typical user」——典型的重度用户用掉的「思考能力」,大约是普通用户的七倍。同一篇还写,在 ChatGPT 用量最高的七十多个国家之间,一些国家的人均「思考能力」用量是另一些国家的三倍。20
这是厂商自报的口径。
第三方这一侧,最近几个月的测量给出的信号方向不一样。
美国人口普查局的双周企业调查(BTOS)在 2026 年 5 月 26 日发布的结果是:企业整体的 AI 使用率在 17% 到 20% 之间徘徊,未来六个月的预期使用率是 20% 到 23%,数据窗口是 2025 年 12 月到 2026 年 5 月。12
美国全国经济研究局(NBER)与亚特兰大联储联合发布的一份工作论文,调查了近 6000 名美英德澳高管,给出四组数字:69% 的企业已在积极使用 AI;高管本人每周平均只用了 1.5 小时;十名高管里有九名报告,过去三年 AI 在本公司的就业与生产率上没有可测影响;同一批人预期未来三年 AI 会把本公司的生产率提高 1.4%、产出提高 0.8%、就业减少 0.7%。13
Ramp 的经济学家用企业刷卡与账单数据做的月度指数,2026 年 9 月 9 日那期的结论是:新增 AI 采用仍在增长,但正在减速。同一期记下一个具体做法:「We've heard from businesses who are imposing company-wide defaults that reduce usage of frontier models, saying standard models are still highly performant and also more cost effective.」——有企业在推行全公司范围的默认设置,把用量从前沿模型上挪开,理由是标准模型仍然好用、而且更划算。数字上,头部 1% 企业的人均每月 AI 支出从 7,976 美元降到 7,205 美元,降了 9.7%;它跟踪的每百万 token 实际价格,从 2026 年 3 月的 1.15 美元峰值降到 0.68 美元,降幅 41%。14
这两组材料回答的正是他算的第二笔账:人们实际拿这些模型干了什么。企业把默认档位换便宜,价格一路往下走,那道差距就可以被两头同时压缩。
至于主张放慢的那一边。Dario Amodei 9 月 12 日的长文写的是:当前的模型是一座「近乎无穷的矿藏」,既让人看清怎样把 AI 建好,也让人看清建得不好会出什么问题,结论因此是放慢提升能力的速度。15
两人在这件事上的位置并不对立,分歧在时间表:一个说先把手上的能力用起来,一个说先让安全研究追上来。
07 接下来看什么
第一,那个「七倍」会不会有第三方复现。 它现在只有 OpenAI 一侧的口径,衡量的是它自己产品里的使用行为。20
第二,人口普查局那 17% 到 20% 与高管报告的「无可测影响」会不会动。 这两组数字如果一直不动,Mollick 说的那道差距就还在,只是没人去填。2122
第三,「能力过剩」这个词的两种用法会不会合流。 OpenAI 用它讲国家与人群之间的使用差距,Mollick 用它讲个人之间的差距;同一个词被两拨人往两个方向用,接下来会出现在监管文件里,还是咨询公司的销售材料里。1620
第四,那四项优势会不会被别处引用或用数据检验。 它们的完整表述目前只出现在《The Overhang》这一篇里,出处是 10 月 20 日才上市的新书。1623
第五,会不会出现具名反驳。 到 9 月 19 日早上,公开渠道上还没有针对这篇的具名批评文章。真正能检验这套判断的,是企业在不换模型的前提下把用量提上去之后,生产率数字会不会跟着动。2224
References
- 1The Overhang
oneusefulthing.org
- 2Ethan Mollick, Wharton School
mgmt.wharton.upenn.edu
- 3Zork · The Great Underground Empire
zork-underground-empire.netlify.app
- 4Umberto Eco's Library: a 3D map
eco-library-map.netlify.app
- 5
- 6Co-Existence by Ethan Mollick
penguinrandomhouse.com
- 7Co-Existence 官方网站
co-existence.ai
- 8On holding back the strange AI tide
oneusefulthing.org
- 9The Present Future: AI's Impact Long Before Superintelligence
oneusefulthing.org
- 10AI for self empowerment
openai.com
- 11
- 12AI Use by Businesses
census.gov
- 13Firm Data on AI(NBER WP 34836)
nber.org
- 14September 2026 Ramp AI Index
ramp.com
- 15We Must Pace the Frontier
darioamodei.com
- 161
- 174
- 183
- 195
- 2011
- 2112
- 2213
- 236
- 2414
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.