LeCun 公开 ECCV 讲稿全文:给同行的五条建议,前四条都在要求放弃
LeCun 把 ECCV 2026 主题演讲的 68 页讲稿全文公开了:五条给同行的建议里,前四条要求放弃生成式模型、概率模型、对比法和强化学习;本期逐条核对每条建议背后的论文、它自己承认的边界,以及同一轴线上同行的相反下注。

Yann LeCun 在 ECCV 2026 的收尾幻灯片上列了五条给同行的建议。前四条都以「放弃」开头:放弃生成式模型、放弃概率模型、放弃对比法、放弃强化学习;第五条是一行全大写红字——如果你关心的是人类水平的 AI,不要做大模型。
这张幻灯片先被人当成假图转发,三天后 LeCun 本人把 68 页讲稿全文放上了网。这份讲稿值得读的地方不是它有多激进,而是它第一次把每一条建议背后的论文一起摊开了。
北京时间 9 月 17 日 23 时 09 分,LeCun 在自己的回复里贴出一个 Google Drive 链接,文件名是
lecun-20260911-eccv-keynote.pdf——他 9 月 11 日在 ECCV 2026 做主题演讲用的完整幻灯片。1三天前,这条线程的开头不是他写的。
9 月 14 日上午 11 时 35 分,Apollo Research 预部署团队负责人 Dylan Bowman 贴出一张会场幻灯片照片,配文是:「Apparently this is YLC's presentation at ECCV from last week, there's no way this is real right?」(据说这是 Yann LeCun 上周在 ECCV 的演讲,这不可能是真的吧?配文里的 YLC 是 Yann LeCun。)2 到 9 月 18 日凌晨为止,那张照片有 35 万次浏览。发帖人随后在同一条线程里补了一句:图片是从 LinkedIn 来的,他自己也不确定有没有被人改过。31
9 月 15 日傍晚 18 时 12 分,LeCun 回了三个词:「It's 100% real ☺️」(千真万确)。3 十三分钟后,他补了一段:这张幻灯片背后有「a 1 hour talk, with results and evidence」(一场一小时、带结果和证据的演讲),并加了限定——他从没说基于大模型的 AI 工具没用,「我们都在用」,但这些工具「by themselves, they are not a path to human-level AI」(就其自身而言,不是通向人类水平 AI 的路径)。32
又过了两天,那 68 页被放了出来。
Loading content card…
先把这份讲稿的身份说清楚。ECCV 2026 的会期是 9 月 8 日到 12 日,地点在瑞典 Malmö。官方日程页写明 LeCun 的主题演讲在 9 月 11 日 15 时到 16 时,Arena Room。45 在官方页面上,他那一栏的摘要字段是空的:同一页另外两场主题演讲,Kristen Grauman 和 Jamie Shotton 的摘要都是完整的。官方也不提供幻灯片和录像,详情页对未登录访客只显示「Log in and register to view live content」。到今天为止,这场演讲能公开读到的完整版本,就是 LeCun 本人发在 X 上的这份 PDF。3334
线程里还有两条更早的线索。第一,LeCun 贴了一段 6 月 9 日的录像,来自 ETH Zürich 的「Frontiers of Embodied AI」,标题与讲题完全相同——那是这场演讲更早的版本。67 第二,这套建议不是第一次出现,2026 年 8 月 12 日就有人把同一份清单贴到 X 上,配图就是这张幻灯片。8
01 那张幻灯片上的五条建议
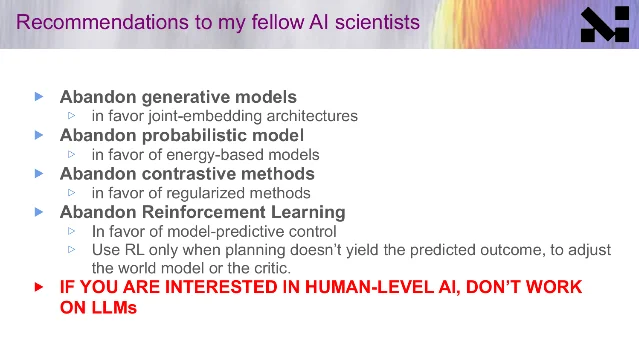
五条建议的原文如下,英文是讲稿原文,括号里是中文对照:
- Abandon generative models — in favor of joint-embedding architectures(放弃生成式模型,改用联合嵌入架构)
- Abandon probabilistic model — in favor of energy-based models(放弃概率模型,改用能量模型)
- Abandon contrastive methods — in favor of regularized methods(放弃对比法,改用正则法)
- Abandon Reinforcement Learning — in favor of model-predictive control(放弃强化学习,改用模型预测控制);后面还有一行小字:Use RL only when planning doesn't yield the predicted outcome, to adjust the world model or the critic.(只在规划没有产出预期结果时,才用强化学习去调整世界模型或 critic。)
- IF YOU ARE INTERESTED IN HUMAN-LEVEL AI, DON'T WORK ON LLMs(如果你关心的是人类水平的 AI,不要做大模型)
前四条动的是技术选择,其中三条改的是模型形式或训练目标,一条改的是决策方式。第五条动的是研究选题。9
讲稿为这张清单摆出的最新一批支撑论文一共七篇,提交时间集中在 2025 年 11 月到 2026 年 5 月之间:LeJEPA、《LeWorldModel》、V-JEPA 2.1、《When Does LeJEPA Learn a World Model?》、一篇从野外视频里学潜动作的论文,以及两篇分别论证「AI 系统为什么不学习」和「AGI 这个概念不成立」的文章。讲稿当然也引了更早的工作——2022 年的路线文、1988 年那篇给反向传播建数学框架的文章、2016 年的视频预测论文——但那批新论文才是这张清单与两年前版本的差别所在。35
要理解这五条为什么会在 X 上被当成假图传开,得先知道它们各自在反对什么。
02 前两条:放弃生成像素,放弃算概率
第一条的判据写在讲稿第 21 页:
JEPAs learn abstract representations of the data within which it makes predictions. ... Generative architectures must predict every detail in the data.Token-based generative models simply do not work with high-dim, continuous, noisy data.
(联合嵌入预测架构学的是数据的抽象表征,预测在这个表征空间里做;生成式架构则必须预测数据里的每一个细节。基于 token 的生成模型,在高维、连续、带噪的数据上根本行不通。)
这里有两个需要展开的词。联合嵌入指的是先把一段观察编码成一个向量,再让预测器在这个向量空间里预测下一段观察的向量。生成式指的是直接重建原始信号——对图像就是逐像素,对视频就是逐帧。讲稿第 18 页把这个分野写成一句话:靠生成来做无监督学习,「works great for text and other discrete symbol sequences」(在文本和其他离散符号序列上效果很好),但「does not work for high-dimensional, continuous, noisy data」(在高维、连续、带噪的数据上不行)。35
第 25 页把这条界线画得更直白。它先列「世界模型不该是什么」:world simulators(世界模拟器)、digital twins(数字孪生)、generative models(生成式模型)、video generation systems(视频生成系统)。再列「世界模型该是什么」:action-conditioned predictors in abstract representation space, preferably differentiable(抽象表征空间里、以动作为条件的预测器,最好可微)。35
第二条换的是模型形式。讲稿第 34 到 35 页把训练能量函数的办法分成两类:对比法压低训练样本的能量、抬高「造出来的」对照样本的能量;正则法只做一件事,就是最小化「能够取到低能量」的那部分空间的体积。讲稿给的判据是对比法「scales very badly with dimension」(随维度增长急剧变差)。35
第二条的落点不在名词,而在代价。 对比法要造负样本,维度越高越难造得对;正则法不要负样本,代价换成一条对表征分布的形状约束。
03 第三条:放弃对比法,这条的证据链最长
五条建议里,第三条给出的证据最多,而且每一块都能点开。
起点是 LeJEPA。这篇论文 2025 年 11 月 11 日提交,署名 Randall Balestriero 和 Yann LeCun,提出的正则项叫 SIGReg,做法是把联合嵌入的表征分布约束成各向同性的高斯。论文自称的好处有五项,其中三项对做工程的人最有意义:只有一个权衡超参、时间和内存都是线性复杂度、实现只需要大约 50 行代码;文中还强调免去了 stop-gradient 和 teacher-student 这类惯用技巧。实验部分,用 ImageNet-1k 预训练、冻结主干后只训一个线性分类器,ViT-H/14 在图像分类上的准确率是 79%。10
「大约 50 行代码」这句话很关键。它意味着这条建议的复现成本低到任何一支小团队都能试,而不是只能听厂商讲故事。
第二块证据是 LeWorldModel,简称 LeWM。论文 2026 年 3 月 13 日提交,作者是 Lucas Maes、Quentin Le Lidec、Damien Scieur、Yann LeCun、Randall Balestriero,单位是 Mila 与蒙特利尔大学、纽约大学、三星 SAIL 和布朗大学。论文的卖点只有两个损失项:一个是预测下一帧的嵌入,另一个就是把潜变量分布约束成高斯。论文说,相比它比较的那个端到端方案,可调的超参从六个减到一个。规模上,可训练参数约 1500 万,可以在单张 GPU 上训练数小时;规划速度最多快 48 倍。1112
项目页把 48 倍拆成两个可以核对的数:每一帧被编码成一个 192 维的 token,比 DINO-WM 少约 200 倍;规划耗时约 1 秒,而 DINO-WM 是 47 秒。36
然后是最值得看的一页——讲稿自己把 LeWM 的规划成绩放上了台,包括它输的那两项。
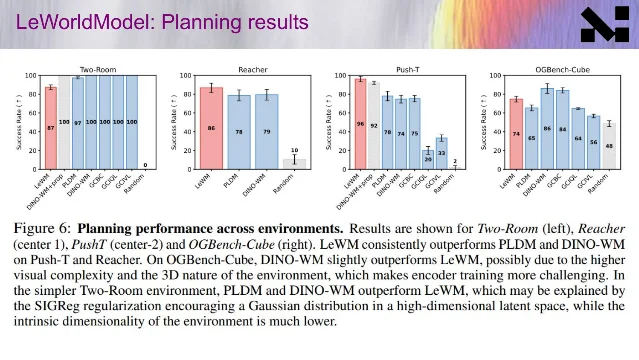
四个环境的成功率是这样的:Two-Room,LeWM 87,DINO-WM 100;Reacher,LeWM 86,DINO-WM 79;Push-T,LeWM 96,DINO-WM 74;OGBench-Cube,LeWM 74,DINO-WM 86。36 其中一个对照物需要说清楚:DINO-WM 用的是 DINOv2 的 patch 特征做零样本规划,不训练新的视觉编码器。13 LeWM 则完全从像素端到端训练,不用任何预训练视觉特征。
这两组数字说明的是一件具体的事:LeWM 赢在 Reacher 和 Push-T 上,输在 OGBench-Cube 和 Two-Room 上。 在视觉更复杂的三维环境里,带着大规模预训练视觉先验的对手仍然更好;在维度很低的环境里,LeWM 落后得更多。项目页把 Two-Room 的落后归因于任务本身内在维度太低,把 OGBench-Cube 的落后归因于对手的视觉先验。36
第三块是理论。2026 年 5 月 25 日提交的《When Does LeJEPA Learn a World Model?》,作者是 David Klindt、Yann LeCun、Randall Balestriero。论文证明:在平稳的、带加性噪声迁移的潜变量世界里,LeJEPA 能线性辨识出真实的潜变量;而且在这类世界里,高斯是唯一能给出这个保证的潜变量分布。14
这是一个有条件的结果。它保证的是「在那样构造的世界里」,不是「在任何数据上」。论文自己的实验把潜变量从二维做到了 1024 维。37
04 第四条:放弃强化学习,这一条最容易被误读
第四条的原文里藏着一行小字,读漏了就会把它读成「强化学习没用」:
Abandon Reinforcement Learning — in favor of model-predictive controlUse RL only when planning doesn't yield the predicted outcome, to adjust the world model or the critic.
(放弃强化学习,改用模型预测控制。只在规划没有产出预期结果时,才用强化学习去调整世界模型或 critic。)
这一条要挪的不是强化学习的存在,而是它的位置:从主循环挪到修补位。
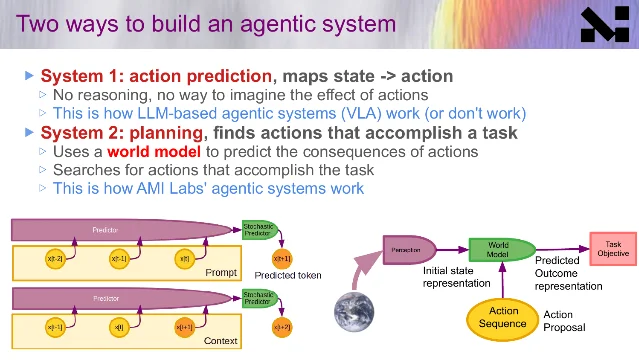
MPC 是模型预测控制(Model Predictive Control)的缩写,做法是用世界模型把若干组候选动作序列往前滚,按任务目标挑一条代价最低的,只执行第一步,然后重新规划。讲稿第 15 页把这个循环写成「Akin to Model Predictive Control (MPC) in optimal control」(与最优控制里的模型预测控制类似),第 30 页给它补上谱系:Kelley-Bryson 梯度法(1962)、庞特里亚金最优性原理的伴随状态法,以及 LeCun 自己 1988 年那篇用拉格朗日形式给反向传播建立数学框架的文章。1535
这条建议与当下最主流的投入方向冲突最直接。2026 年 7 月 13 日,Richard Sutton 宣布与 Khurram Javed 另起一家公司 Oak Lab,理由是「we at Oak Lab believe in reinforcement learning and that intelligence is created and maintained from run-time experience」(我们相信强化学习,认为智能是由运行时经验产生和维护的)。16 前 DeepMind 的 David Silver 创办 Ineffable Intelligence,路线同样压在强化学习上。他 2026 年 4 月对 WIRED 说,人类数据是一种化石燃料,而「You can think of systems that learn for themselves as a renewable fuel—something that can just learn and learn and learn forever, without limit.」(可以把那些自己学习的系统看作一种可再生燃料——一种可以一直学、一直学、永远学下去而不会耗尽的东西。)17
机器人一侧的答案还要具体一些。斯坦福的 Chelsea Finn 在 2026 年 7 月 3 日写道:「We've been approaching reward supervision for robots the wrong way. I think freeform preferences are part of the answer.」(我们一直把机器人的奖励监督做错了,我认为自由形式的偏好是答案的一部分。)她给的方向是把奖励信号做细,而不是换掉强化学习。18 伯克利的 Sergey Levine 则在 2026 年 7 月 9 日预告自己在 ICML 2026 一个关于强化学习与世界反馈的工作坊上,要讲「how we can move beyond the scalar reward bottleneck for both robotics & LLMs」(怎么在机器人和大模型两边同时越出标量奖励这个瓶颈)。19
LeCun 和他们没有分歧的地方是「经验重要」。分歧在经验的用法:对 Sutton 和 Silver,运行时的试错本身就是智能的来源;对 LeCun,运行时的试错只用来校准世界模型。
05 第五条:不要做大模型,以及他自己给这句话加的限定
第五条是全大写的一行红字,也是那张照片被转发的原因。LeCun 本人先后给这句话加了三次限定。
第一次是 9 月 15 日那条回复:基于大模型的 AI 工具「very useful」,我们都在用,但就其自身而言不是通向人类水平 AI 的路径。32
第二次在同一天稍晚,北京时间已经是 9 月 16 日凌晨。有人问要不要连 Transformer 一起放弃,他回:「I won't. Transformers are a fine architectural component of deep learning systems. I would abandon GPT architectures for real-world data though.」(不会。Transformer 是深度学习系统里很好的一个架构组件;但在真实世界数据上,我会放弃 GPT 架构。)32
第三次是 9 月 17 日,在放讲稿的同一条线程里,他写了一句更短的版本:「Yes, with deep learning of course. Just not with discrete token prediction.」(当然是靠深度学习,只是不靠离散 token 预测。)20
这三处限定把第五条的范围收窄了一格:被划掉的是 GPT 这一套用离散 token 做预测的架构作为通往人类水平 AI 的路径,不是大模型在它擅长任务上的价值。 同一条线程里,一位在场听众复述了现场问答:他问「我们还要不要为编程和数学这类文本任务继续做大模型」,得到的答复是「yes ofc LLMs are incredibly useful for some tasks」(当然,大模型对某些任务非常有用)。31
支撑「不要做大模型」这个判断的,是讲稿里两处论证。
一处是「AGI」这个词本身。第 6 页写着「The phrase Artificial General Intelligence makes no sense」(人工通用智能这个说法没有意义),理由是人类的智能高度专门化,并不通用。同一个论证在论文层面落成了《AI Must Embrace Specialization via Superhuman Adaptable Intelligence》,2026 年 2 月 27 日提交,作者是 Judah Goldfeder、Philippe Wyder、Yann LeCun、Ravid Shwartz Ziv。21
另一处是数据量。讲稿第 7 页把两组数字并排放在一起。
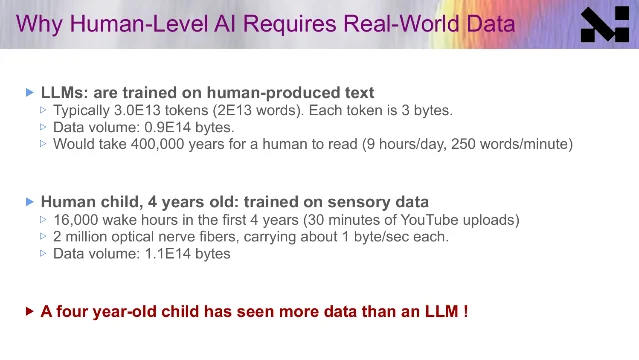
上栏:大模型的训练数据通常是 3.0E13 个 token、约 2E13 个词、每个 token 3 字节,合计 0.9E14 字节;一个人按每天读 9 小时、每分钟 250 词的速度读完,要 40 万年。下栏:四岁儿童在前四年里清醒约 16000 小时,两根视神经共约 200 万根纤维、每根每秒传递约 1 字节,合计 1.1E14 字节。结论是「A four year-old child has seen more data than an LLM !」(一个四岁儿童看过的数据比大模型还多。)35
算式能复现。3.0E13 乘 3 等于 9.0E13,即 0.9E14;2E13 个词按每分钟 250 词、每天 9 小时算下来是 405885 年,讲稿写成 40 万年是取整;200 万乘每秒 1 字节、再乘 16000 小时折成的秒数,得到 1.152E14,约 1.1E14。35
但整条论证压在一个取值上:每个 token 3 字节。 英文文本里一个 token 平均约 4 个字符,按 UTF-8 编码约合 4 字节。换成 4 字节,大模型一侧变成 1.2E14 字节,结论就翻过来。儿童那一侧的两个量——200 万根视神经纤维、每根每秒 1 字节——同样取的是低端估计,讲稿没有给出处。35
这条论证想说的是:文字语料的数量级并不比一个人前四年获得的感官数据大,而后者的绝大部分不是文字。按讲稿的路线,处理这类数据要靠自监督学习,而不是靠预测下一个 token。
讲稿的最后两页交代了这套东西要落到哪里。第 67 页写,AMI Labs 的长期目标是成为智能系统的主要提供者,列举的领域从医疗、制造、汽车、航天一直排到金融;举的例子是一台现代涡扇发动机有 1000 个以上传感器,一架空客 A380 一共有 25000 个传感器、每秒测量 5000 次。35 官网自述的方向更窄一些:工业过程控制、自动化、可穿戴设备、机器人、医疗,技术主张是在表征空间里预测真实世界的传感器数据。22
那两处传感器数字需要标注边界。可追溯的原始表述出自 2014 年 12 月一篇行业稿件,原句把三件事并排放着:「GE jet engines collect information at 5,000 data points per second; a Boeing 787 generates an average of 500GB of system data a flight; an Airbus A380 is fitted with as many as 25,000 sensors.」(GE 的喷气发动机每秒采集 5000 个数据点;一架波音 787 每趟航班平均产生 500GB 系统数据;一架空客 A380 最多装有 25000 个传感器。)23 也就是说,「每秒 5000 次」在这句原始表述里属于 GE 的发动机,而不是 A380;「as many as 25,000」本意是「最多可达」,被讲稿写成了确定值。这两个数字都没有找到空客、GE 或罗尔斯·罗伊斯的一手声明。2438
06 同一批问题上,同行站在哪一边
ECCV 2026 一共安排了五场大会报告与圆桌,LeCun 这场是第三场。把同一轴线上的公开材料排在一起,能看出这张清单在同行那里换来了什么。
| 谁 | 时间与场合 | 与这五条建议的关系 |
|---|---|---|
| Jamie Shotton(Wayve 首席科学家) | 9 月 12 日,ECCV 2026 主题演讲「From Visual Recognition to Embodied AI」 | 与第五条相反。官方摘要写他讲的是「learning rather than engineering; betting on data and compute scaling」(学,而不是工程化;押注数据与算力的规模化),并提醒「being careful not to confuse today's constraints with tomorrow's limits」(小心不要把今天的约束当成明天的极限)34 |
| Richard Sutton | 7 月 13 日,宣布创办 Oak Lab | 与第四条相反。整家公司押在强化学习与运行时经验上39 |
| 唐杰(智谱创始人兼首席科学家) | 8 月 19 日,X 长文《Thoughts About Scaling Law》 | 同诊断、异处方。他也认为总参数只在门槛内有用,但出路写成「有效深度与后训练」,结尾是「We are not done scaling.」25 |
| Michael Black(Epic Games 数字人研究副总裁) | 9 月 9 日,X 长帖 | 与第五条相反。他要求论文先尽力用现有大模型解决问题,没试过就等于没做功课26 |
| 李飞飞(World Labs) | 6 月 22 日,经 36kr 转述的世界模型三分类 | 与第一条同向、但更宽。视频生成被她放进「Renderer」这一类,而不是被划掉(此条为二手转述,不是本人原文)27 |
| Alexandre Ramé(研究者) | 9 月 15 日,在 LeCun 的帖下回复 | 唯一一条针对这份讲稿的系统反驳:「this slide ignores the empirical facts: it sells an illusion of stagnation in the LLM+RL paradigm」(这张片子无视经验事实,它兜售的是「大模型加强化学习这一范式已经停滞」的幻觉)32 |
还有一件可以核的事:这份讲稿流出后的一周内,Ilya Sutskever、Demis Hassabis、Dario Amodei、Sam Altman、Andrej Karpathy 的公开账号上都没有出现针对它的评论。Sutskever 最近一次关于路线的公开表述,是 8 月 27 日 TIME 榜单条目里的一句「We have research that is worthy of scaling up.」(我们有值得放大的研究。)这句话指向的方向,与「不要做大模型」正好相反。28
真正有反应的是会场上和场下的人。密歇根大学教授 Jason Corso 公开索要这场演讲的录像,说它是「probably the most sensitive argument for why physical challenges in AI are different than text-alone」(大概是关于「物理挑战为什么不同于纯文本」最有说服力的论证),并说有一批做控制的朋友需要看。29 Google DeepMind 的 Letian Wang 则把 ECCV 现场的气氛写成「a surprising amount of frustration」(多得令人意外的挫败感),来源是传统计算机视觉研究正被基础模型吸收。30
这两条现场反应有个共同点:它们谈的都是这场演讲提出的问题,没有一条谈他给出的替代方案。
07 接下来看什么
有五个可以逐条验收的点。
第一,LeWM 那一类方法能不能在视觉更复杂的环境上追平预训练特征方案。 现在的差距写在图上:OGBench-Cube 上 LeWM 74,DINO-WM 86。36 这个话题有明确的可比口径,谁先把这个差距关掉,谁就替第三条建议补上最缺的一块证据。
第二,LeJEPA 那「大约 50 行代码」会不会被第三方复现出论文里的线性探测成绩。 一个正则项、一个超参、线性复杂度——这是这份讲稿里复现成本最低的一条路。40
第三,「规划为主、强化学习修补」这套分工会不会有人真的做出来并给出对照数字。 LeCun 自己描述的做法是用交叉熵法在潜空间里搜动作序列,而不是训练策略网络。36 这条分工目前只有立场,没有跨系统的对照实验。
第四,AMI Labs 的第一个真实工业部署。 官网把工业过程控制写在方向的第一位,讲稿举的例子是传感器动辄上万的复杂系统。3541 这类系统上的表现,是这套路线能不能走出实验室的出口。
第五,讲稿里那两处传感器数字会不会被修正。 A380 的 25000 个传感器和「每秒 5000 次」在可追溯来源里的归属并不一致。38 这张幻灯片还会被讲很多次,它改不改,是一个可以观察的小信号。
讲稿的最后一页是一行问句:「Could hierarchical JEPA provide us with a way to build universal causal models of any complex system? Including human cells, organs, and bodies?」(分层 JEPA 能否为任何复杂系统建立通用的因果模型,包括人的细胞、器官和身体?)五条建议给了处方,这一页留的是问题。35
References
- 1LeCun 公开讲稿的帖
x.com
- 2Dylan Bowman 的原帖
x.com
- 3LeCun 的回复
x.com
- 4ECCV 2026:LeCun 的受邀报告页
eccv.ecva.net
- 5ECCV 2026 主题演讲与圆桌名单
eccv.ecva.net
- 6LeCun 贴出录像的帖
x.com
- 7ETH Zürich 录像
youtube.com
- 82026 年 8 月 12 日的转述帖
x.com
- 9讲稿 PDF
drive.google.com
- 10
- 11
- 12LeWM 项目页
le-wm.github.io
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20同线程的另一条回复
x.com
- 21
- 22AMI Labs 官网
amilabs.xyz
- 23Millions of data points flying in tight formation
aerospacemanufacturinganddesign.com
- 24Britannica:航空航天工业
britannica.com
- 25
- 26Michael Black 的长帖
x.com
- 27解析李飞飞的世界模型产品三分类
eu.36kr.com
- 28TIME100 AI 2026:Ilya Sutskever
time.com
- 29Jason Corso 索要录像的帖
x.com
- 30Letian Wang 的会议观察
x.com
- 312
- 323
- 334
- 345
- 359
- 3612
- 3714
- 3824
- 3917
- 4010
- 4123
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 扩散会赢下 AI 推理吗:一位奠基者的论证,和同一批模型的另一组读数
- 100 多位评估者回应五家公司:嵌入评估者的五条最低条件,防报复那条没有一家答应
- Claude 已经「领做」26% 的研发工作:Anthropic 第一次公布内部指标
- OpenAI 研究员 Noam Brown:多智能体的功劳被高估,思维链的可监控性正在退化
- 唐杰说 GLM 优化了服务它自己的推理栈:三处修复里,只有一处能在公开仓库里查到
- Hassabis 成立 DeepMind Institute:五篇关于 AGI 的文章,一句「不代表 Google 官方立场」
- LeCun 说让 AI 安全比让涡扇简单:发动机的安全,是跑 150 小时、拆开验过、每月上报一个比率
- LeCun 说限速适得其反:能飞远程的双发客机,是一档一档放出来的