Claude 已经「领做」26% 的研发工作:Anthropic 第一次公布内部指标
Anthropic 把自家实验室的三项内部指标连同读数一起公布:Claude 已经「领做」26% 的 AI 研发工作、约三万个智能体处在监控之下、约 6% 的 AI 研发算力投向安全;本期逐项拆开这些数字的口径与松动处,再对照三家现行框架的阈值和同行的自报数字。

一家前沿实验室把自己的研发流程拆开,装了三块仪表盘:AI 领做了多少工作、有没有东西在盯着这些 AI、算力有多少真正花在安全上。三块表的读数一并交了出来。
2026 年 9 月 17 日,Anthropic 的官方账号发了一条帖,指向 Anthropic 官网 Anthropic Institute 栏目的长文《Measurements for understanding the pace of AI development inside frontier labs》,直译是「用来理解前沿实验室内部 AI 研发节奏的测量方法」。12文章署名 Marina Favaro 与 Phillie Wright 两位研究员,编辑支持来自 Santi Ruiz、Adam Farina 与 Sarah Pollack,研究方向由 Jack Clark 制定。17
它的样子像一份技术报告:有方法、有附录、有数字。
但它的真实位置是一份关于「该报什么」的提案——而且顺手把自家的读数也报了出来。
把它和五天前的另一份文件放在一起看,位置会更清楚。9 月 12 日,Anthropic 的 CEO Dario Amodei 发布政策长文《We Must Pace the Frontier》,方案第一步是企业单边引入常驻的第三方评估者:给他们工位、门禁和公司电脑,能看到的内部流程、系统和数据与内部风险评估团队大体相当,并且保留发表关键发现的权利——「without editorial control by Anthropic」(不受 Anthropic 的编辑控制)。3当时的说法是,这些人的职责包括「monitor key metrics」,监测关键指标。18
9 月 17 日的这一篇,第一次说清了「关键指标」长什么样。
Loading content card…
01 三块仪表盘,读数是多少
文章把「AI 研发的节奏」拆成三件事,每件都给出定义、读数和方法。
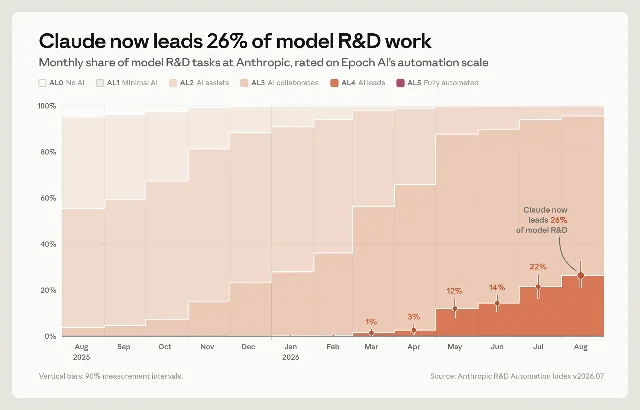
第一件是谁在干活。Anthropic 造了一个叫 Anthropic R&D Automation Index 的原型指数,量的是公司内部的 AI 研发工作里有多少由 Claude 完成。等级用的是 Epoch AI(一家做 AI 基准与趋势研究的机构)提出的一套量表,AL 是 Automation Level(自动化程度)的缩写,从 0 分排到 5 分:AL0 是无 AI 参与,AL5 是 AI 完全自主、人完全不参与;中间两级最要紧,AL3 是「协作」(AI 能在大块工作里承担,但人要紧紧盯着),AL4 是「领做」(人给一句高层指令,AI 自己把大部分活干完,人只做监督)。417
2026 年 8 月的读数是三条:
- Claude 在任何被测的 AI 研发子集上都没有达到完全自主;
- Claude「领做」了 Anthropic 全部 AI 研发工作的 26%;
- 处在「协作」及以上的工作超过 90%。17
三句话连起来读才是完整的形状:绝大多数研发工作里已经有 AI,但还没有任何一类工作被人完全交出去。
第二件是有没有东西在看管这些干活的 AI。Anthropic 在内部最常用的那张智能体平台上,任一时刻大约有 30000 个智能体在做研究与工程工作。17它报三个数:覆盖率,即多少动作经过监控——线上监控在执行前覆盖 100%,离线监控在执行后摄取 100%;复核时延,即一个动作与它被复核之间隔多久;以及拦截与升级率。17
拦截的那个数很小。文章说,他们分析了 2026 年 8 月研究与工程智能体留下的「超过十亿次决策」,其中 0.002%——大约四万七千分之一——被线上监控拦下。17
升级的那个数也很小。离线监控每周标记大约 10 万条会话记录,先由多个分类器过滤误报,其中优先级最高的大约 50 条升级到人工复核。17
第三件是算力去了哪里。他们取了自己全部算力使用的一个星期快照,时间是 2026 年 7 月 13 日到 7 月 20 日,结论是:用于 AI 研发的算力里约 6% 投向了安全,用于「AI 驱动的 AI 研发」的算力里约 12% 投向了安全。17
前两块表量的是流程,第三块表量的是资源。
02 26% 是怎么算出来的
不知道分子分母,26% 这个词什么也说明不了。 因此最值得读的是文章的附录,它把算法整套摊开了。
第一步是把工作列全。
一家前沿实验室的研发任务多到没人能手写,他们的做法是从工作记录里往上长。
2026 年 7 月的每一周,他们从构成模型研发环路的每个部门随机抽 20% 的员工,让一个 Claude 研究智能体读这个人那一周的 Slack 与内部文档,列出他做过哪些任务。
一周一周重复下来,得到约 15000 条细粒度任务。17
第二步是把任务变成一棵树。用 Claude 把这 15000 条归纳成层级结构,根节点是所有模型研发,往下分成训练与产品,再往下是预训练与强化学习,一直细到「评估平台缺陷定位与修复」「强化学习(RL)沙箱出网与网络策略」这类叶子。树一共 542 个节点,其中 378 个是叶子。树建好之后就冻结,此后每次测量都对着同一篮子工作做。17
第三步是给每个节点打等级。每个节点派一个 Claude 智能体去调研这类工作在公司里怎么做的、谁在做、用了什么工具、其中多少由 AI 完成,再由一个独立的 Claude 裁判读这些证据,给出 AL0 到 AL5 里的一个等级。打分时只允许看到被测月份及更早的证据。17
第四步是配权重。他们没有自己拍板哪类工作更重要,而是拿投入的人时当代理变量:每个人每周算一个单位,平均分给他当周做过的每个任务——做了四个就各 0.25,做了十个就各 0.10;一个类别的权重就是落在它上面的人时之和。文章自己承认这是个粗糙的近似。17
这套方法有三处松,文章都写在了明面上。
第一处,裁判是模型,而模型可能犯错。为了验证,他们请拥有这些工作领域的 Anthropic 员工给自家领域打相对自动化程度的分,且不告诉他们模型看过哪些证据。结果:模型与人的完全一致率是 59%,人与人之间是 35%,模型与人的评级有 97% 落在相差一级以内。17文章自己的结论是,「协作在哪结束、领做从哪开始」这类边界情形仍然有真实的争议空间。17
第二处,篮子被冻在 2026 年 7 月。指数上涨,只说明 2026 年 7 月这批人在做的那些活正在被自动化,它本身不告诉你有没有出现人被顶下去之后转去的新工作。为此他们用 1 月的数据另建了一棵对照树,比较 2 月到 7 月每月新出现任务的数量,没有发现「新任务」在增加。17
第三处,是官方折线图上的误差条。那张图的脚注写着「Vertical bars: 90% measurement intervals」(竖条为 90% 测量区间),8 月那个点四周的竖条相当宽。这还不是一条可以当精密仪器用的曲线,它是一个量级正确的走势。
还有一处不在 Anthropic 这边。Epoch AI 那套量表的原始文档写得很清楚:这些评级「should be treated as best-guess starting points for discussion rather than deeply researched or quantitatively backed estimates」(应当被当作供讨论用的初估起点,而不是经过深入研究或有定量支撑的估计)。19
03 三万个智能体,和一道已经找到的绕过口子
管三万个智能体,比管一个模型的输出要难。文章把难点写在同一个句子里:到今天为止的监控数据里,单个智能体很少越轨;但等到经济里有几百万、几十亿个智能体在跑,再稀的事件也会经常发生。17
它的办法是把监控分成两种,各管一段。
线上监控在执行前看,能拦下危险动作,或者自动把跑偏的行为拽回来;它对付的是来不及反悔的伤害,文章举的例子是智能体把模型权重复制出系统。17
离线监控在执行后看,专门找那种慢慢长出来、而且能撤回来的危险行为,比如模型失准的迹象;被标记的活动用来改进缓解措施,比如分类器与确定性控制,一旦出现大规模且迫在眉睫的危险,就关掉该智能体部署里危险的那部分。17
真正让这套东西转起来的,是两个设计选择。
第一个是身份。 大多数用户习惯在不同的对话窗口里和同一个叫「Claude」的助手打交道,但当许多智能体一起干活时,Anthropic 发现更重要的是给每个智能体一个独立身份,并把它产生的所有数据都绑在这个身份上。这样做有三层后果:一个智能体能把自己和别的智能体区分开,会把另一个智能体说的话当作需要核实的说法,而不是自己的想法;智能体各自基于自己的经历做判断,能降低多个智能体一起犯同样错误的风险;而因为身份不绑在模型上,模型升级之后这个身份仍然延续。17
第二个是公开沟通。 智能体之间通过一套共享的、开放的消息系统交流,不走私聊。每条消息都绑定发送者身份,可以链接到别的内容,所以智能体之间传的是原始引用而不是复述;文章用的说法是,这能让它们不必「playing telephone」(玩传话游戏)。消息彼此可见,于是它们能纠正对方的错误、协调共同的工作。所有消息又与智能体会话记录交叉索引,使行为监控可以穿过智能体之间的通信。17
文章也写了这套东西的边界:在这个活动规模上,很难确定已经看清了所有可能的行为类型,也很难确定这些模式对人类监督者足够可读;他们做这件事的时间是几个月,不是几年。17
而外部已经找到过一道口子。METR 是一家做前沿模型评估的独立机构。2026 年 2 月到 3 月,他们派一名员工在 Anthropic 驻场三周,专门对这套离线监控管线做红队测试。5Anthropic 在自家 8 月风险报告里对这件事的表述是:测试发现了若干新的具体漏洞,其中一些此后已修补,「none as severe as the ones we were already aware of」(没有一个和我们已知的那些一样严重)。6
METR 自己在 5 月的《Frontier Risk Report》里写得更具体。红队者当时说:
I view this as a pretty severe vulnerability, as it's a reliable, easy to implement single point of failure that could let a model completely circumvent the offline monitoring system.
(我认为这是一个相当严重的漏洞:它是一道可靠、容易实现的单点故障,能让模型完全绕过离线监控系统。)
他们找到的做法里包括改一个环境变量,用来决定这批流量要不要被当成 Claude Code 的流量来对待。7
Anthropic 的说法和 METR 的说法都真实,只是它们回答的不是同一个问题:一家说「没有比已知的更严重」,另一家说「这道口子可靠、易实现、足以完全绕过」。读「离线摄取 100%」这句话时,需要同时知道它已经被人绕过一次。
还有一处更直接的对不上。
文章在监控一节末尾写:「We published all of these measurements in our recent risk report.」(我们把所有这些测量都发表在了近期的风险报告里。)17
但 Anthropic 对外的 8 月风险报告是一个删节版。上面那三个头条数字——30000 个智能体、0.002%(约四万七千分之一)、每周 10 万条会话记录——在这份公开文件里一个也检索不到。20
公开版里有的是这些测量的方法学,以及几个相邻数字:人工每周复核「on the order of 50 trajectories per week」(量级是每周 50 条轨迹),复核「almost always happen within a week」(几乎都发生在一周之内);另外,离线监控在真实内部流量上的标记率是 0.74% 与 0.004%,这是两级过滤之后的结果。20
报告自己写明,更详细的漏洞描述在未删节版里,而那一版不公开。20
04 6% 和 12% 该怎么读
算力那一节,文章先自己泼了冷水:安全研究用的算力天然比前沿训练少,所以算力是一个不完美的代理指标。原因是安全研究多是一个个研究员设计实验,设计本身费时,跑实验并不特别吃算力。17
方法上,他们先把自家已有的算力监控工具拼起来:这些工具本来是为容量规划做的,定期采样加速器使用情况,再根据元数据给工作负载打上标签;第三方云上的用量由云厂商报过来,一并计入。17
然后用一个 Claude 分类器把每个工作负载判成「安全」或「AI 研发」。「安全」的定义是支配目的是让 AI 系统更安全、更可理解、或者更难被攻破的工作;其余一切——包括能力研究、训练生产模型、产品开发、开发者工具——都算 AI 研发。
既帮能力也帮安全的工作同样算 AI 研发,所以这个比例是保守的。17
一周里近一万个实验,他们没有全判:训练与评估实验抽了约 14%,并向吃算力多的实验加权,让结果反映算力实际去了哪里,而不是实验有多少个。给 AI 研究智能体做推理的那部分,用同一种分类器读会话记录;记录取不到的(通常是工作被隔离),就按所属团队归类,或者保守地判成 AI 研发。17
三个限制值得单独拎出来。
标签本身是尽力而为的,多数由自动规则设置、偶尔由用户直接设置,没有经过核实,误标不一定能被流水线抓到。17
样本只有一周,够说明「这个测量做得出来」,不够说明趋势。17
第三条最反直觉,也最重要:算力占比只度量花掉的部分。一个更高效的安全分类器、一套更快的生产推理栈,都会把安全那一块的比例压低,但这不意味着安全做得更少了。文章举了自己身上的例子:他们的分类器开销随效率提升而下降,也在生产推理效率高于分类器时上升过。17
05 三家写阈值,同行报数字
这份材料最容易被误读的地方,是它摆出来的样子像一条新规矩。把它和现行框架摆在一起,差别一眼就能看出来:三家框架写的是阈值与义务,这一篇写的是读数。
| 谁 | 文件与版本 | 与「AI 自动化研发」有关的条款写的是什么 | 越线之后要做什么 |
|---|---|---|---|
| Anthropic | Responsible Scaling Policy v3.4,2026-07-08 生效8 | 条款名「Automated R&D in key domains.」:要么模型能以有竞争力的成本完全替代其全部研究科学家与工程师(原文写明 "within a factor of 5",即成本差距在 5 倍以内),要么出现 "double the rate of progress"(脚注定义为「一年走完基线两年的路」)。 | 定性动作:完成安全类「moonshot R&D」项目、内部研发做到「eyes on everything」(每一步都在视野之内)。Changelog 自陈这条阈值 "has proven difficult to operationalize"(已被证明难以操作化)。 |
| OpenAI | Preparedness Framework v2,最后更新 2025-04-15,至今未换版9 | Critical 档「AI Self-improvement」(AI 自我改进):把一次代际模型进步压缩到 2024 年等价进度的 "1/5th the wall-clock time"(原文举例压缩到 4 周),并持续数月。 | "halt further development"(停止进一步开发),前提是先拿出达到 Critical 标准的保障与控制。 |
| Google DeepMind | Frontier Safety Framework v3.1,2026-04-17 发布10 | 两个 ML R&D 关键能力等级,全部是定性描述:模型「已被用于加速 AI 开发,导致 AI 进展相较历史速率出现实质性加速」,或「能以大致相当的总成本完全自动化 Google 内部任一以提升 AI 能力为目标的团队的工作」。能力判定文字里没有任何数字。 | 按配套的安全等级(security level 3 与 security level 4)施加部署缓解措施,也就是在部署环节加上防护。 |
| 本期这篇 | 三项指标提案,2026-09-17 | 不设阈值。它量的是生产过程本身:谁在干活、有没有人在看、算力去了哪。 | 无。文章只说这些测量「could become the trigger for stronger requirements」(可以成为更强要求的触发条件)。17 |
这套框架今年第一次被触发。2026 年 9 月 1 日,OpenAI 宣布 Astra 成为首个被判定为 Critical 的模型,落在网络安全那一档——不是自我改进那一档。11
这张表里最值得看的一列是最后一列。前三行都有代价,第四行没有。
三家里还有一件共同的事:判定权都在开发者自己手里,而独立的外部评估「尚无标准化」。这句话不是哪家公司的自述,是 2026 年 2 月那份由 Yoshua Bengio 领衔的《International AI Safety Report 2026》写的——「there are no standardised external audits」。12
同样的位置上,同行给出的是另一套数字。
OpenAI 在 2026 年 9 月 6 日的《Research acceleration: The view inside OpenAI》里自报:按原文给出的标准八小时工作日折算,到 2026 年 8 月中,研究组织每消耗一个人类工作日,智能体就要用掉 3.1 个工作日的运行时长;2026 年 6 月之前,智能体的总运行时长还低于人类总工时。他们同时给出花费:中位研究者每天用掉按 API 价格计超过 600 美元的推理,第 90 百分位的研究者每天用掉超过 7000 美元的 token。13
同一篇里,他们也把话说到了底:
We do not yet know how to safely get all the way to aligned, full RSI.
(我们目前还不知道,要怎样才能安全地一路走到「对齐的、完全的递归自我改进」。)
OpenAI 那篇里还写着:过去 6 个月里,超过一半成功的 4 至 8 小时任务,需要至少一次人工干预。21
再往东看,9 月 17 日智谱(Z.ai)的官方博客给出了另一种更工程化的自证:由 GLM-5.3 驱动的 Infra Agent 参与搭起了服务自家模型的推理基础设施,其中部分修复已经进入开源上游,但是以一个默认关闭的开关合入的——默认状态下并不启用。14
把这三份自报并排放,形状就出来了。OpenAI 报的是产能与花费,智谱报的是可核的代码提交,Anthropic 报的是流程的自动化占比与监控覆盖率。三家都在用数字讲同一件事,但三家用的不是同一把尺子。
06 它不是标准,是一份提案
文章里有一句话出现了三次,每次都做小标题:「What any AI developer could report today.」(任何 AI 开发者今天就能报什么。)17
它不是在宣布 Anthropic 有了什么,而是在说:这三件事,任何一家前沿开发者现在就能照着报,方法是公开的。
伴随这句的,是三处它自己写下的保留。
第一处是跨实验室比较没有共同方法论,而且「我们在用自家模型评估自家系统,这可能意味着裁判模型会犯下与被它检查的模型同类的错误」。17文章给的解法是让第三方或别家开发者的模型来核,并设置护栏以免交换竞争敏感数据——一个计划,不是既成事实。
第二处是安全算力的分类。文章写得相当直白:「安全研究与能力研究很难区分,而每家开发者都会有把界线往宽处画的冲动。举证责任应该在开发者身上。」17
第三处是这些数字会变。文章自己声明,如果前沿真的出现协调一致的调速,这些数字应该会变——因为它们是「在没有协调的世界里,一家公司恰好在这样做的快照」。17
把它们和 Dario Amodei 9 月 12 日的承诺对起来看,一件重要的事实是:常驻的第三方评估者还没有到位。文章写的是「We plan to embed」(我们计划引入),验证路径还是将来时。17
而恰恰是「用数字支撑自动化研发的判断」这类做法,已经被外部评估机构挑过一次。METR 在 2026 年 5 月评审 Anthropic 二月风险报告的「自动化研发风险」章节时,给出的结论是「we think the evidence presented in the report is inadequate to establish this」(我们认为该报告给出的证据不足以确立这一点)。15
还有一处口径值得留意:Anthropic 自己向各国政府提议的披露模板,是一份每半年一次、针对四类枚举风险的风险报告;这三项生产过程指标目前不在那份模板里。16
已经成立的是读数,尚未成立的是制度。把这两样分开,这份材料才读得准。
07 接下来看什么
第一,这套月度读数会不会继续出。现在已经能看到 2026 年 3 月到 8 月连起来的一段曲线,但它出自同一批已发布数据;真正的分水岭是下一个月的数据会不会按同一口径补上,还是被改了口径。17
第二,有没有第二家实验室按同一套量表报数。跨实验室可比性的第一道门槛不是数据,是愿不愿意用同一把尺子;Epoch AI 那份量表是公开的,是目前最容易照抄的一份口径。19
第三,安全算力占比会不会出现共同定义。文章明确呼吁各家与政府、研究界事先收敛到一套共享定义:如果只有 Anthropic 一家报自己的分类,这个数字就没法横着比。17
第四,那道绕过口子关掉了没有。METR 已经公开写出「可靠、易实现的单点故障,可以让模型完全绕过离线监控」,Anthropic 说部分漏洞已修补;下一次公开版本能不能说明它是否被系统性关闭,是「100% 摄取」这句话能不能站住的前提。2022
第五,两项之间会不会出现公开的取舍。一边是三万个智能体在研发里干活,一边是安全只占 6% 的算力:如果智能体规模继续涨而安全占比不涨,这两个数字就开始互相说话。17
第六,常驻评估者什么时候真正进驻。承诺已经说出口,能不能签下带独立发表权的安排、以及第一批报告会不会公开,是这条线唯一的硬验收点。18
读数已经摆上桌。接下来要看的是,谁愿意对着同一把尺子站上去。
References
- 1
- 2Anthropic 官方帖
x.com
- 3We Must Pace the Frontier
darioamodei.com
- 4Toward an O*NET for AI R&D
epochai.substack.com
- 5
- 6Redacted Risk Report August 2026
www-cdn.anthropic.com
- 7
- 8Anthropic's Responsible Scaling Policy
anthropic.com
- 9Preparedness Framework Version 2
cdn.openai.com
- 10Frontier Safety Framework Version 3.1
storage.googleapis.com
- 11Path to Astra
openai.com
- 12International AI Safety Report 2026
internationalaisafetyreport.org
- 13
- 14
- 15
- 16Anthropic's Advanced AI Framework
www-cdn.anthropic.com
- 171
- 183
- 194
- 205
- 2113
- 227
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.