用一组可滑动的中文图片笔记,持续拆解 SGLang 推理框架的核心原理、部署用法,并跟进值得关注的版本与社区动态。
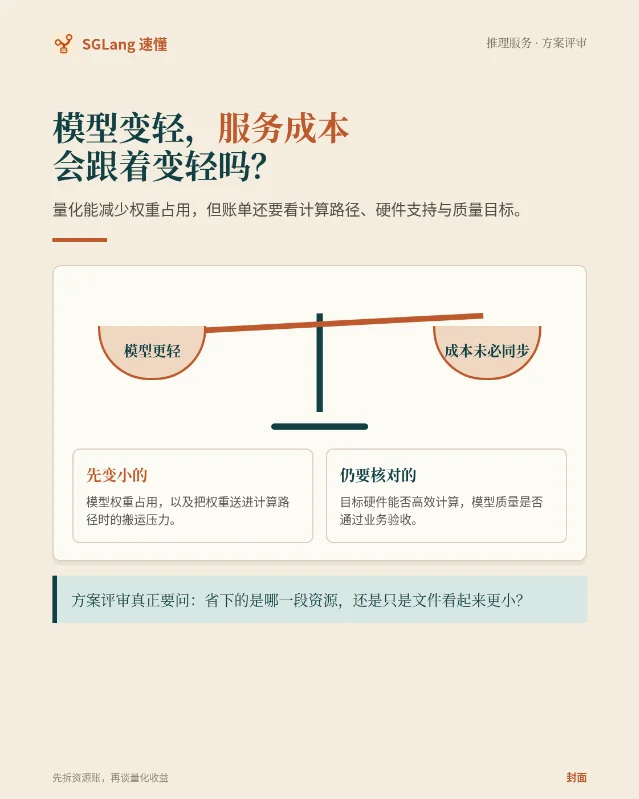
SGLang 速懂:模型变轻,服务成本会跟着变轻吗?
SGLang 速懂:多个客户定制,为什么不必复制整份模型?
SGLang 速懂:长文一进来,短请求就排队?
SGLang 速懂:多副本,不只是轮流分发
SGLang 速懂:Speculative Decoding 如何让小模型先猜、大模型并行验
SGLang 速懂:HiCache 如何把 KV Cache 扩到 GPU 之外
SGLang 速懂:为什么要把 Prefill 和 Decode 分开跑
SGLang 速懂:结构化输出如何让 JSON 先过语法门
SGLang 速懂:RadixAttention 如何复用 KV Cache