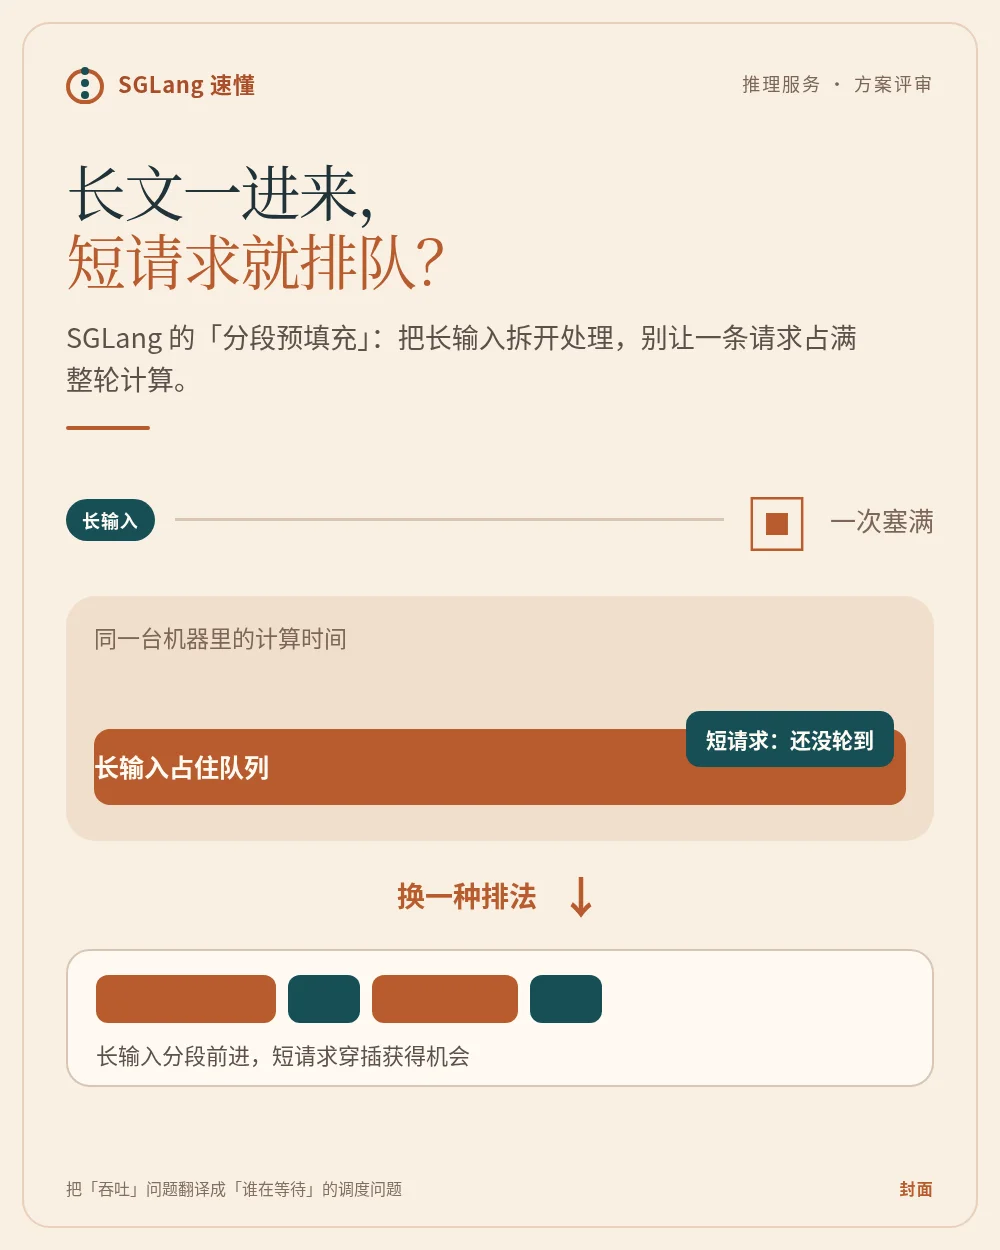

如果同一套推理服务同时接长上下文与短问答,单条长输入的处理方式会改变短请求的等待体验。SGLang 的「分段预填充」把长输入拆成片段,允许它和已有请求交错推进。它主要改善混合负载下的等待关系,不等于所有请求都会更快。
旧排法为什么会卡住
「预填充」可以理解为把用户输入先算进上下文,「生成」则是模型逐步给出回复。长输入如果一次处理完整段,就可能打断已经开始生成的请求。SGLang 官方文档把这个现象说得很直白:新到的预填充工作会频繁打断正在进行的生成工作,带来明显的生成延迟。1
相关论文把这种现象称为「生成停顿」:优先处理长输入,通常更有利于整体处理量,却会牺牲正在生成请求的响应节奏;优先照顾生成请求,又会让新来的长输入排队。2
SGLang 选择了什么思路
分段预填充的做法,是把一条长输入拆成可交错处理的片段,每一轮只推进其中一部分,同时给已经开始生成的请求留下继续前进的机会。论文将它概括为:把预填充请求切成大小接近的片段,在不暂停已有生成的情况下接纳新请求。2
用方案评审的话说,它改变的是计算时间的排法:从「一条大请求先做完」,改成「长请求分段前进,短请求穿插获得机会」。
实际效果,应该怎样说
它最值得看的收益,是短请求的首个反馈不容易被一条长输入整段挡住;长上下文请求也不必完全退出队列,整体服务仍有机会保持较高的并行度。SGLang 官方博客在流水线并行场景中也说明,分段让工作可以在不同阶段交错推进,减少长输入带来的空转。3
但收益有前提。片段越小,短请求的等待越容易控制,长输入本身的处理效率却可能下降;片段越大,长输入更有效率,单轮工作又更容易变重。LMSYS 的相关技术博客明确提醒,严格的交互延迟目标会迫使分段更细,从而牺牲预填充效率。4
所以别把它讲成「一开就加速」。更准确的说法是:它在混合负载里,用更细的调度换取更稳定的短请求体验,最终结果要看请求长度、到达节奏、并行形态和延迟目标。
谁会关心
- 平台团队:关心长文检索、普通问答、工具调用是否互相拖慢,尤其是短请求的尾部等待。
- SaaS 与 AI 应用团队:关心长上下文和短对话能否共用一套服务,而不用过早拆成两套资源。
- 采购与架构团队:关心先用调度改善共存,还是直接为不同负载分池。
客户如果抱怨的是「短问题总在等长文」,分段预填充才有明确的评估入口。
边界与选型提示
值得把它放进对照实验的场景,是长短请求混跑、长文输入是常态、又在乎普通问答的快速反馈。先用真实请求队列比较短请求等待、长请求完成和整体处理量,再决定是否继续投入。
如果负载几乎同质、请求都很短,收益未必在这里。如果瓶颈在检索、网络、模型生成阶段或外部系统,分段预填充也不会替你修好。遇到极端长输入或极严格的交互延迟目标,单机内的分段排法可能不够,还要评估「预填充与生成分离」,也就是把输入处理和逐步生成拆到不同资源。相关研究对这种取舍有明确讨论。4
延伸阅读
References
- 1PD Disaggregation - SGLang Documentation
docs.sglang.ai
- 2
- 3
- 4
Comments