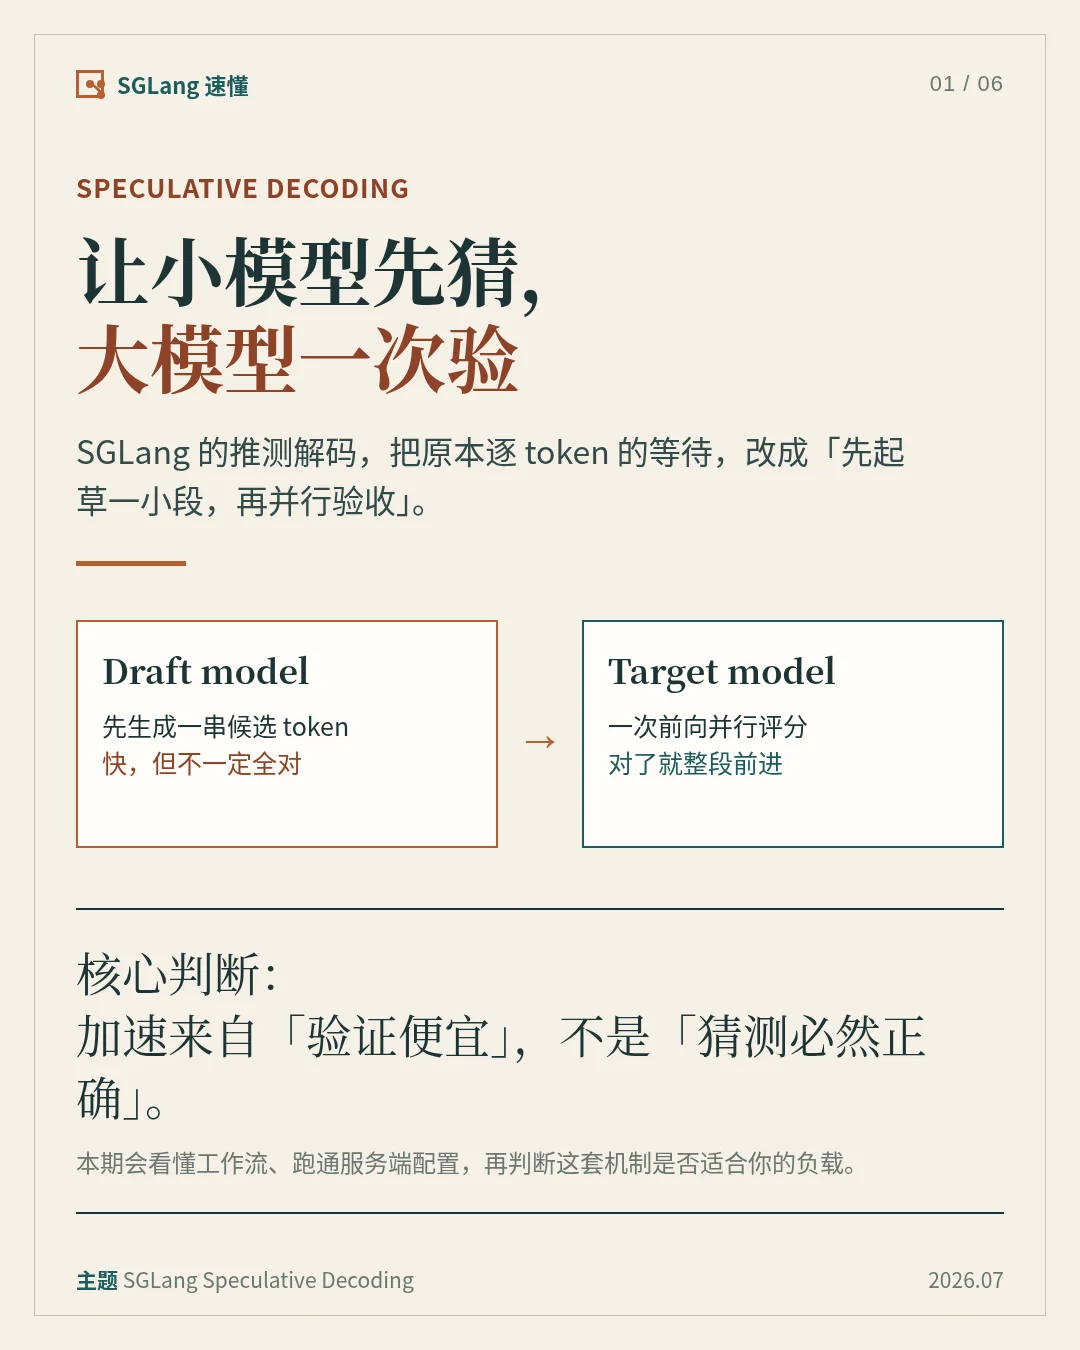

小模型先写草稿,大模型一次检查一串 token。SGLang 的 Speculative Decoding 试图把 decode 阶段的串行等待,换成「起草 + 并行验收」;它的收益来自 target model 能以接近单 token 的代价评分多个候选,不代表每次都能加速。1
先看懂这条链路
- Draft model 自回归生成候选 token。
- Target model 一次前向并行评分。
- 接受连续的候选;遇到不匹配的位置,按 modified rejection sampling 拒绝并重采样。
正确实现时,输出分布可以保持与 target model 单独采样一致,所以 draft model 负责提速,不负责改答案。2
在 SGLang 里怎么开
图 4 使用 SGLang 官方文档的 STANDALONE 示例:target 是
Qwen/Qwen2.5-7B-Instruct,draft 是 Qwen/Qwen2.5-1.5B-Instruct。推测解码由服务端启动参数决定,客户端仍可使用 OpenAI 兼容的 /v1 接口。3官方当前文档还提供 EAGLE-2、EAGLE-3、DFLASH、NGRAM 与 MTP 等路径:EAGLE-3 偏向速度/质量优先,EAGLE-2 偏向更广泛兼容;不同算法的约束不能混用。3
调参只盯三个数字还不够
--speculative-num-steps 控制 draft 深度,--speculative-eagle-topk 控制分支宽度,--speculative-num-draft-tokens 控制验证窗口。官方要求这三个参数要么全部交给自动调优,要么一起显式设置。树更大可能提高候选覆盖,也会增加起草开销和显存压力。4收益小的常见原因是 draft 太慢、和 target 不匹配、target 本身已经很小,或者 batch 已把内存带宽吃满。研究也发现,实际加速更依赖 draft 的延迟,而不只是它的语言建模能力。5
跑实验时的检查单
先用自动参数做一条无推测基线,再对比端到端延迟、吞吐、接受长度和显存。遇到 OOM,SGLang 文档建议依次考虑降低
--mem-fraction-static、减小 CUDA graph decode batch、缩小 draft tree、限制并发;STANDALONE 还不支持 --enable-dp-attention。3这套机制值得开的前提很具体:draft 足够快,猜测和 target 足够接近,显存也留有余量。先测接受率和真实延迟,再决定是否保留。
References
- 1
- 2
- 3Speculative Decoding - SGLang Documentation
docs.sglang.ai
- 4Server Arguments - SGLang Documentation
docs.sglang.io
- 5Decoding Speculative Decoding
arxiv.org
Comments