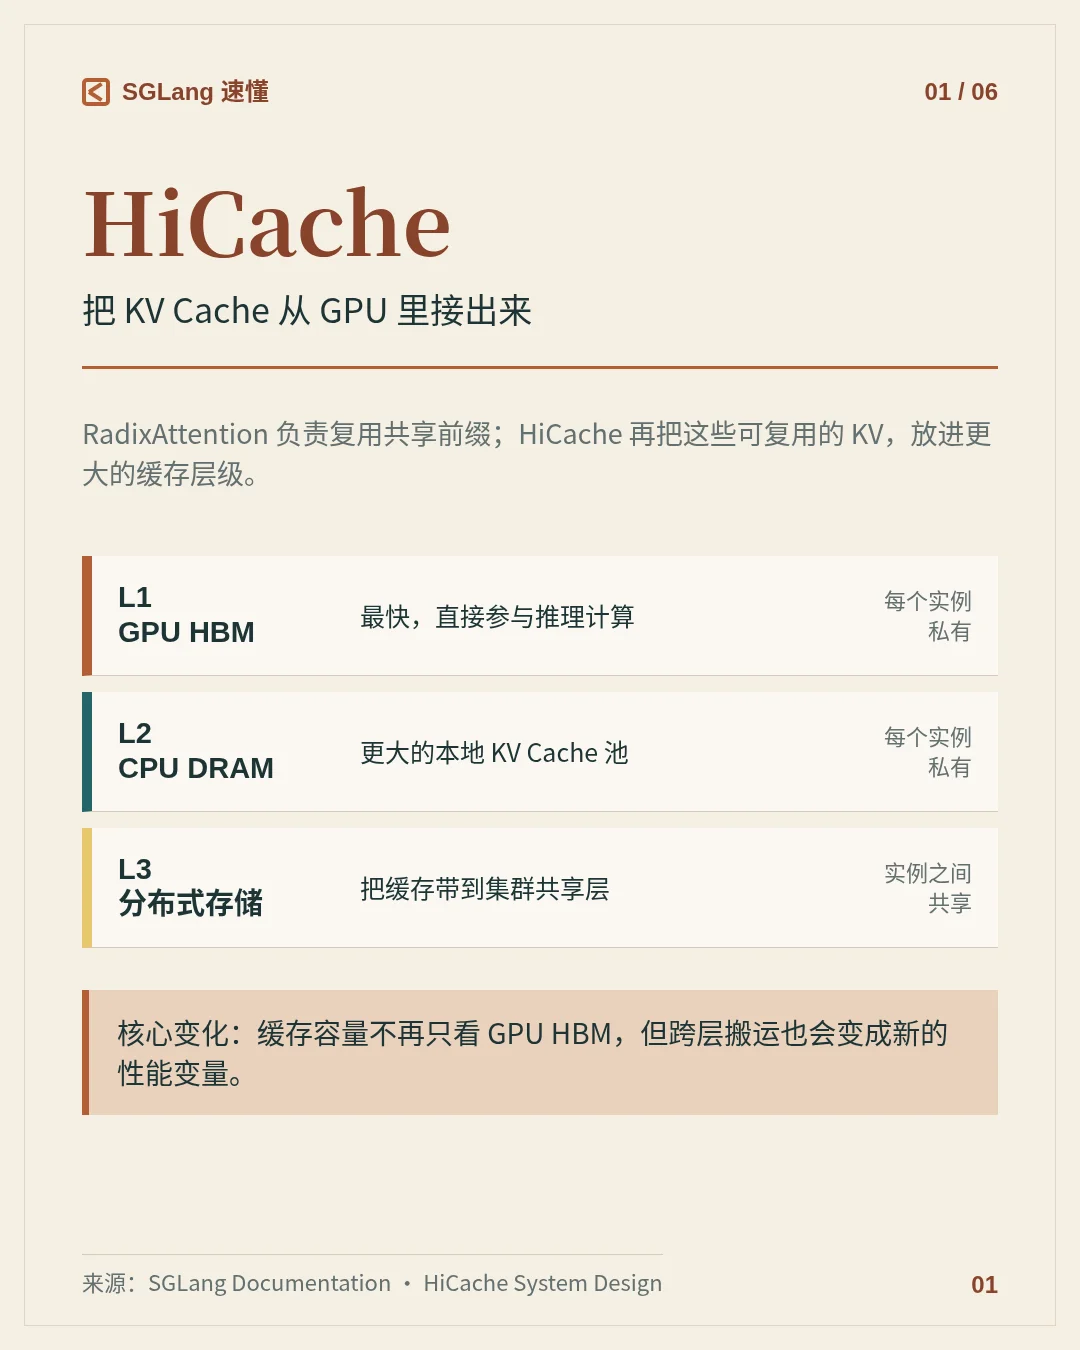

RadixAttention 解决的是「同一段前缀别重复算」。HiCache 继续追问:这段 KV 不在 GPU 里了,还能不能复用?SGLang 的答案是,把缓存从单一 GPU 层扩成三级:L1 是 GPU HBM,L2 是 CPU DRAM,L3 是分布式存储。L1、L2 属于单个推理实例,L3 可以在集群实例之间共享。1
它沿用了 RadixTree 的前缀匹配,又增加了 HiRadixTree。树节点除了记录连续 token span,还记录 KV 位于 GPU、CPU、L3 的哪一层;L3 的元数据不持续同步,而是在访问时查询后端。1
一条请求路径可以记成:
local match → prefetch → compute → write-back先查本地 L1/L2,未命中的部分再看 L3。L3 命中长度超过默认 256 tokens 才触发预取;
best_effort 更偏向低延迟,wait_complete 更偏向缓存命中,timeout 用等待上限把两者放进同一个 SLO 里。1最小配置可以先只开 GPU + CPU 两层:
python -m sglang.launch_server \
  --model-path MODEL \
  --enable-hierarchical-cache \
  --hicache-ratio 2
--hicache-ratio 必须大于 1;如果改用 --hicache-size,它会覆盖 ratio,并且容量按每个 rank 计算。先观察命中率、TTFT 和吞吐,再接入 file、Mooncake、3FS 或 NIXL 等 L3 后端。1调参时,
kernel I/O、page_first 布局、存储预取策略和写回策略要一起看。官方博客报告 GPU-assisted I/O 最高可达 3 倍传输吞吐,典型部署里 page-first 加零拷贝最高可达 2 倍,但这些是实现与负载相关的上限,不是服务的固定收益。2HiCache 最适合长上下文、多轮对话、多 QA 共享前缀这类「可复用 token 多、GPU 容量偏紧」的负载。短上下文、几乎没有共享前缀的请求流,或者 L3 后端本身很慢时,层级缓存可能只是增加搬运和等待。Strata 论文也把分层缓存的难点归结为两件事:长上下文 KV 会超过 GPU 容量,而搬回 GPU 的碎片化 I/O 又会成为新瓶颈。3
一句话:HiCache 解决的是 KV Cache 的容量瓶颈,不是无条件的加速开关。先用自己的请求流跑对照实验,再决定要不要把 L3 接进生产。
继续阅读:
Comments