Reflection 发布首个开放权重模型 Beam 1.0:501B 总参只激活 23B,Apache-2.0,托管价 $0.25/$1
Reflection 放出首个开放权重模型 Beam 1.0:5010 亿总参每 token 只激活 234 亿,Apache 2.0 可商用、40 多家托管方首日接入,第三方智能指数 30 分,OpenRouter 定价每百万 tokens 输入 0.25 美元、输出 1 美元。

Reflection 在 2026 年 10 月 16 日放出自家第一个开放权重模型 Beam 1.0,总参 5013 亿,每个 token 只激活 234 亿。1 权重当天挂在 Hugging Face,许可是 Apache 2.0,可以直接商用。2
同一天到位的还有模型卡、安全技术报告和一份 40 多家厂商的接入名单,覆盖云平台、推理托管、本地工具与企业私有部署。1 OpenRouter 当天上架,每百万 tokens 输入 0.25 美元、输出 1 美元,上下文 1,048,576 tokens。3
模型在 10 月 5 日先以预告形式露面,官方当时写的是权重、技术报告与开发者材料「本月内」发布。4
10 月 16 日这一步落地的是权重、模型卡、安全报告和托管方。模型卡首页把技术报告标为「coming」,正式报告还没放出。2
先说结论
- 模型与状态:Beam 1.0,2026 年 10 月 16 日发布,BF16、FP8、NVFP4 三档权重当天在 Hugging Face 开放。15
- 参数规模:总参 501.3B,每 token 激活 23.4B,是稀疏 MoE。5
- 架构:52 层里 49 层是 MoE、3 层稠密,每层 256 个专家,门控 GQA 加滑动窗口注意力。5
- 上下文与模态:1M tokens;只处理文本,输入输出都是文本。5
- 许可:Apache 2.0,可商用,官方也明确不禁止蒸馏、微调、量化和用输出训练别的模型。56
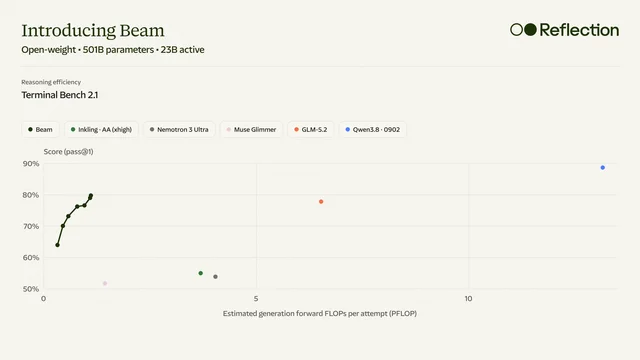
- 官方自测:编码、终端、推理各项基本低于 GLM-5.2、Qwen 3.8 Max 与 Kimi K3,官方自己把卖点写成「同等推理水平下少用 3–4 倍算力」。4
- 第三方:Artificial Analysis 智能指数 30 分,同类开放权重的中位数是 19;评测过程输出 7900 万 tokens,同类中位 1.3 亿。7
- 价格:OpenRouter 每百万 tokens 输入 0.25 美元、输出 1 美元;Reflection 自营 API 还在免费公测,没有公布 token 单价。13
- 什么时候要动:要一个能自托管、可商用、跑长程 agent 的开放权重模型,现在就能下载。1
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | Beam 1.0,2026 年 10 月 16 日发布,权重当天开放 | 官方公告 |
| 发布方 | Reflection | 模型卡 |
| 参数规模 | 总参 501.3B,每 token 激活 23.4B | 模型卡 |
| 架构 | 52 层(3 稠密 + 49 MoE)、256 专家、门控 GQA + 滑动窗口注意力 | 模型卡 |
| 上下文 | 1M tokens | 模型卡 |
| 模态 | 输入文本、输出文本 | 模型卡 |
| 词表与训练数据 | 152k tokens;预训练 23.8 万亿 tokens | 模型卡 |
| 知识截止 | 2026 年 6 月 30 日 | 模型卡 |
| 许可 | Apache 2.0,可商用 | 许可全文 |
| 部署 | BF16、FP8、NVFP4 三档权重,另附投机解码草稿模型 | 官方公告 |
| 托管方 | 40 多家,含 AWS、Azure、Google Cloud、Oracle、Together AI、Fireworks AI、Nebius、Modal、Baseten、OpenRouter;私有部署走 Dell 与 HPE | 官方公告 |
| 价格 | OpenRouter 输入 0.25 美元 / 输出 1 美元每百万 tokens | OpenRouter |
| 何时要动 | 要可商用、可自托管的长程 agent 开放权重模型 | 官方公告 |
规格:52 层里 49 层是 MoE
主干是稀疏 MoE,注意力用门控 GQA 搭配滑动窗口。5
官方把这一层设计写成「给后续强化学习留一个数值上健康的地基」。5
预训练用了 23.8 万亿 tokens,来源是公开网页、公开代码与商业授权数据。4
这一轮预训练在一套 6144 卡 NVIDIA GB300 NVL72 集群上跑完,前后不到四周。4
强化学习是官方强调的另一条轴:10500 卡 GB300 跑四周,生成超过 1 亿条 rollout,最长上下文 256K。4
训练与判分合计用了约 13 亿个沙箱,中训练阶段把有效上下文拉到 1M tokens。4
官方自测:原始能力落后,省算力是主张
官方给了两张表。模型卡上是最终值,按 BF16、FP8、NVFP4 三档精度分别列。5
下表里 Beam 一列取模型卡最终值,对手列只出现在博客表里。4
| 基准 | Beam 1.0(模型卡 BF16) | GLM-5.2 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|---|---|
| DeepSWE v1.1 | 43.3 | 44.0 | 51.0 | 68.0 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 86.6 | 88.3 |
| HLE 无工具 | 36.0 | 40.5 | 43.6 | 46.9 |
| GPQA Diamond | 90.6 | 91.2 | 92.6 | 93.5 |
| CriPT AA | 16.3 | 20.9 | 20.0 | 23.4 |
| MCP Atlas | 80.8 | 77.8 | 84.5 | 82.3 |
| tau3 banking | 36.1 | 37.1 | 55.2 | 37.1 |
| AA-LCR | 78.2 | 78.3 | 80.3 | 88.7 |
八行里 Beam 只在 MCP Atlas 一项超过 GLM-5.2(80.8 对 77.8),其余七行都排在后面。4
官方自己的说法也一致:在原始能力上 Kimi K3 这类前沿开放模型仍然领先,Beam 的优势在推理时的效率。4
模型卡另一张表按精度分档,三档之间的差距大多在一个百分点以内。5
选哪一档部署主要看显存和吞吐,精度上的取舍很小。5
第三方:智能指数 30,输出 token 明显少于同类
同一页还有一条更贴近官方主张的数字:跑完整个智能指数,Beam 输出 7900 万 tokens,同类中位 1.3 亿,独立侧把它标为「简洁」。7
| 第三方指标 | 数值 | 来源 |
|---|---|---|
| Artificial Analysis 智能指数 v4.3.2 | 30(同类开放权重中位 19) | Artificial Analysis |
| 智能指数评测输出 tokens | 7900 万(同类中位 1.3 亿) | Artificial Analysis |
| 输出速度 | 未公布 | Artificial Analysis |
| 每次任务成本 | 未公布 | Artificial Analysis |
| 托管实测吞吐 | 159 tokens/s(P50,最快一家) | OpenRouter |
| 托管实测延迟 | 0.63 秒(P50,最快一家) | OpenRouter |
AA 的速度栏与成本栏都是空的,页面注明它的图表基于「无公开可用 API」。7
托管侧能给一个量级参考:OpenRouter 上目前只有一家 provider,吞吐 159 tokens/s、延迟 0.63 秒,三天可用率 99.59%。3
价格与可用范围
OpenRouter 的价格是每百万 tokens 输入 0.25 美元、输出 1 美元,上下文 1,048,576 tokens。3 单次最大输出 131,072 tokens,支持函数调用与结构化输出。3
自托管这条路官方铺得比较宽:BF16、FP8、NVFP4 三档权重之外还附了一个投机解码用的草稿模型。1
Transformers、vLLM、SGLang、Unsloth、Axolotl、TokenSpeed 和 NVIDIA Dynamo 都标了首日支持。1
托管名单覆盖 AWS、Azure、Google Cloud、Oracle 与 Databricks 等 40 多家。1
推理托管侧有 Together AI、Fireworks AI、Nebius、Baseten、Modal 和 OpenRouter,本地工具有 Ollama 与 LM Studio。1 私有与气隙环境走 Dell 和 HPE。1
Reflection 自营 API 还在公开测试阶段,官方措辞是「free to start」,没有给出 token 单价。1
安全与限制
Reflection 在自家的开放安全框架(OSF)下把 Beam 评了四个系统性风险类别:生物武器、化学武器、失控、网络攻击,全部是「Limited」。9
这个等级的含义是对攻击与防御的平衡没有实质改变,相比同类开放权重模型也没有扩大威胁面。9
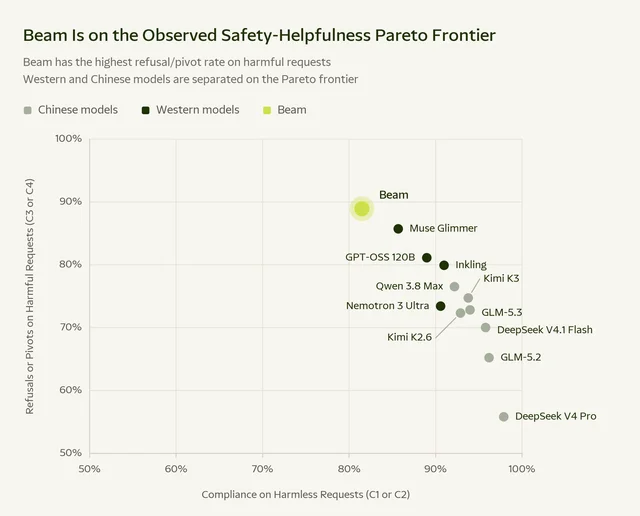
官方在图注里写它超过所有西方开源模型,但没有追上前沿开源模型的网络攻击能力。9
失控一项除了构造场景,还接了一个真实部署。9
Beam 在与 Andon Labs 合作的项目里,到 Reflection 纽约办公室的餐厅经营一台自动售货机,自主决定定价、进货和供应商沟通。9 Andon Labs 在模型之外设了支出上限与转账人工审批。9
官方给的行为指标是对话场景下有害请求拒答或转向率 88.9%、无害请求合规率 81.5%(BF16 档)。9
第三方评估的名单包括 Gray Swan 的自动化红队、间接提示注入竞技场与奖励作弊榜,以及 Irregular 的网络能力评估。9
间接提示注入这项官方给了两套数字:不加防护时攻击成功率 3.10% 与 3.60%(两套 agent 任务)。9
加上 Mirror 里的注入防护提示后降到 0.3% 与 0,代价是干净的 MirrorDojo 得分掉 1.0 分。9
边界也很清楚:夺旗题只是网络攻击能力的近似,题目隔离且没有外网。9
该不该试
- 要一个便宜的高分开放权重模型:AA 智能指数 30、同类中位 19,托管价每百万 tokens 输入 0.25 美元、输出 1 美元,价格档位接近更小的模型。37
- 要自托管或进私有环境:Apache 2.0 可商用,三档精度权重加草稿模型直接放,Dell 与 HPE 提供防火墙内交付。16
- 要长上下文 agent:1M 上下文、单次输出上限 131,072 tokens,支持函数调用、结构化输出与 MCP 工具接入。35
- 要把 token 账单压下来:官方主张同等推理水平少用 3–4 倍算力,AA 独立测得它跑完整套智能指数只用 7900 万输出 tokens,同类中位 1.3 亿。47
- 要非文本模态:它只吃文本、也只吐文本,图像与音频得先转成文字再喂进去。5
- 要买官方 API 并提前算成本:官方目前只写 free to start,没有 token 价目,先用 OpenRouter 那一档价做预算。13
- 要独立逐项复跑再决定:现在只有 AA 的综合分,逐项评测与速度、成本三栏都还空着。7
还没有的数字
References
- 1Beam is now available
reflection.ai
- 2reflection/Beam-1.0-501B-A23B
huggingface.co
- 3Reflection: Beam 1.0 501B A23B — OpenRouter
openrouter.ai
- 4Introducing Beam
reflection.ai
- 5Beam 模型卡
reflection.ai
- 6Apache License 2.0
apache.org
- 7Beam 1.0 — Artificial Analysis
artificialanalysis.ai
- 8Quickstart — Reflection Developer Docs
developers.reflection.ai
- 9Beam 安全技术报告
reflection.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 腾讯混元开源 Hy-Memory 2.0:只换掉记忆框架里的写入模型,30B-A3B 四套系统均分 55.49,比 Opus 5 高 0.87 分
- Grok Voice 3.0 发布:语音指数 86.9 排第一,价格仍是 $0.08 一分钟,别名已经自动换了模型
- DeepSeek-V4.1-Flash-1017 发布:deepseek-flash 没改名没涨价,Terminal-Bench 4.0 从 31.2 涨到 42.3
- NVIDIA 发布 Nemotron Labs Dory 1.0 4B:同一组层循环 1–4 遍换推理算力,权重开放、可商用
- NVIDIA 发布 Nemotron 3.5 Super VL:120B 只激活 12B,官方称吞吐高达同类 5 倍
- Meta 放出 816B 开放权重模型 Muse Spark Open:42B 激活、1M 上下文,两台 Mac Studio 可本地跑
- Liquid AI 发布 LFM2.5-24B-A2B:24B 参数只激活 2.45B,笔记本上解码 184 tokens/s,权重开放
- Gemini 4 Argon 向所有开发者开放:$2/$10 首发价到 11 月底,模型卡与安全报告同日上线