NVIDIA 发布 Nemotron Labs Dory 1.0 4B:同一组层循环 1–4 遍换推理算力,权重开放、可商用
NVIDIA 放出 4B 的开放权重模型 Nemotron Labs Dory 1.0:同一组层可以循环 1、2 或 4 遍,用一份权重换算力与分数,最小的 NVFP4 版约 3.20 GB,OpenMDW-1.1 可商用。

NVIDIA 在 2026 年 10 月 16 日放出一个 4B 的小模型,名字叫 Dory 1.0。1
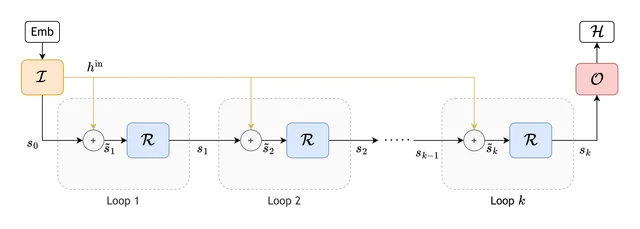
它和常见小模型不同的地方只有一处:层被切成输入、循环、输出三组,中间那 20 层是共享的,同一个 token 可以在里面走 1 遍、2 遍或 4 遍。1
走几遍由部署时的一个参数决定,同一份权重既能当普通的 4B 用,也能当更贵、更准的模型用。1
官方材料目前只有一处:Hugging Face 上的模型卡和四个权重仓库,NVIDIA 官方博客和开发者站都还没挂这个模型。1
先说结论
- 模型与状态:NVIDIA Nemotron Labs Dory 1.0 4B,2026 年 10 月 16 日发布,BF16、MXFP8、NVFP4 与 Q5_K_M 四种权重当天挂上 Hugging Face。1
- 参数规模:总参 4B,权重元数据记 39.75 亿。1
- 架构:循环式(looped,官方也叫 latent-recurrent)的 normalized-GPT,滑动窗口注意力与全注意力交错。1
- 循环旋钮:输入块 8 层、循环块 20 层、输出块 8 层,共享的循环块可重复应用 1、2 或 4 次,官方建议从 2 次起步。1
- 上下文与模态:最长 256K tokens;输入输出都是文本,只支持英文。1
- 许可:OpenMDW-1.1,官方写明可商用。12
- benchmark:十项全部由 NVIDIA 在同一套跑分环境下自测,4 循环时 SWE-bench Verified 61.8、Terminal-Bench 2.1 22.2、IFBench 79;第三方复跑还没有。1
- 成本:权重免费下载,最小的一档 NVFP4 约 3.20 GB,Q5_K_M 的 GGUF 是 3.42 GiB,单卡或笔记本就能跑;没有托管 API,也没有 token 价目。134
- 什么时候要动:要一个本地能跑、可商用、能扛 256K 上下文的小模型,现在就能下载;要等第三方独立评分再决定,得看 Artificial Analysis 或 Vals 什么时候给它建档。56
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | Dory 1.0 4B,2026 年 10 月 16 日发布,四种权重当天开放 | 模型卡 |
| 发布方 | NVIDIA,Nemotron Labs 研究线 | 模型卡 |
| 参数规模 | 总参 4B,权重元数据记 39.75 亿 | 模型卡 |
| 架构 | 循环式 normalized-GPT,滑动窗口注意力与全注意力交错 | 模型卡 |
| 层结构 | 输入 8 层 + 循环 20 层 + 输出 8 层,合计 36 层 | 模型卡 |
| 循环次数 | 可设 1、2 或 4 次,默认 2 次 | 模型卡 |
| 注意力与词表 | 滑动窗口 1024 tokens,每 4 层插 1 层全注意力;词表 131,072 | config.json |
| 上下文 | 最长 262,144 tokens | 模型卡 |
| 输入输出与语言 | 文本进、文本出,仅英文 | 模型卡 |
| 预训练 | 6 万亿 tokens,前约 4.5 万亿用 NVFP4、其余转 BF16,另用 3000 亿 tokens 扩上下文 | 模型卡 |
| 训练数据期 | 2013 年至 2025 年 12 月 | 模型卡 |
| 后训练 | 监督微调,再用 GRPO 做多环境强化学习 | 模型卡 |
| 许可 | OpenMDW-1.1,可商用 | 许可全文 |
| 权重格式与体积 | BF16 7.95 GB、MXFP8 4.75 GB、NVFP4 3.20 GB、GGUF Q5_K_M 3.67 GB(3.42 GiB) | BF1637 |
| 本地运行 | vLLM 走第 60149 号 PR、llama.cpp 走第 30306 号 PR,两者都还没进正式发版 | vLLM8 |
| 价格与 API | 权重免费,没有托管 API,也没有 token 价目 | 模型卡 |
「循环」多出来的算力花在哪
官方把这件事写成「在隐空间里想得更久」:多出来的算力落在每个 token 上,输出长度反而更短。1
规格与训练
预训练用了 6 万亿 tokens,前约 4.5 万亿直接以 NVFP4(NVIDIA 的 4 位浮点格式)训练,剩下的转到 BF16,再用 3000 亿 tokens 把上下文拉长到 256K。1
训练数据的采集期是 2013 年到 2025 年 12 月。1
后训练分两步:先做监督微调,再用 GRPO 在数学、代码、科学、指令遵循、多步工具调用、多轮对话和结构化输出这些环境里做强化学习。1
官方标出的推理硬件是 H100、B200、B300 和 DGX Spark。1
官方自测:赢在哪,输在哪
下表每一列都由 NVIDIA 自己跑,用的是同一套跑分环境(NeMo Gym / Nemo Evaluator SDK),Terminal-Bench 2.1 对所有模型都换成 Terminus-2 这个执行框架,所以这些数字是厂商自测。1
| 基准 | Dory 1 循环 | Dory 2 循环 | Dory 4 循环 | Qwen3.5-4B | Qwen3.5-9B | Qwen3.6-35B-A3B |
|---|---|---|---|---|---|---|
| SciCode | 27.3 | 34.94 | 35.11 | 25.82 | 28.21 | 37.24 |
| SWE-bench Verified | 50.3 | 59.5 | 61.8 | 54.7 | 61 | 73.4† |
| Terminal-Bench 2.1 | 12.5 | 18.1 | 22.2 | 15 | 24 | 43 |
| τ³-bench 银行 | 11.6 | 12.89 | 14.69 | 5.03 | 7.22 | 9.54 |
| GDPval-AA v2(Elo) | 815 | 946 | 967 | 424 | 546 | 987 |
| GPQA Diamond 无工具 | 69.19 | 72.41 | 72.16 | 77.71 | 80.93 | 85.35 |
| HLE 纯文本无工具 | 8.25 | 10.89 | 10.43 | 11.31 | 15.43 | 19.18 |
| IFBench | 74.29 | 77.94 | 79 | 53.83 | 59 | 57.44 |
| AA-LCR | 63 | 71 | 73 | 64.7 | 68.4 | 68.5 |
| AA-Omniscience 正确率 | 10.03 | 10.08 | 10.03 | 15.02 | 18.05 | 19.95 |
表内数字全部出自 Dory 1.0 模型卡,每行最高分加粗。† 标的是对手模型自己报告的成绩。Qwen3.6-35B-A3B 是 35B 总参、3B 激活的更大模型,列在这里当上限参考。
读法:Dory 四循环在同尺寸的 Qwen3.5-4B 上十项里赢了七项。1 换成 Qwen3.5-9B,胜项掉到五项;对上 35B-A3B,只剩 τ³-bench 银行、IFBench 和 AA-LCR 三项。1
循环的收益集中在第二遍:SWE-bench Verified 从 1 循环的 50.3 涨到 2 循环的 59.5,第 4 循环只再涨 2.3 分。1 Terminal-Bench 2.1 是 12.5、18.1、22.2 逐级上升,GPQA Diamond 则在 2 循环见顶,第 4 循环略回落。1
官方据此建议从 2 循环起步。1
循环还压输出 token
循环换来的除了分数,还有更短的输出。1
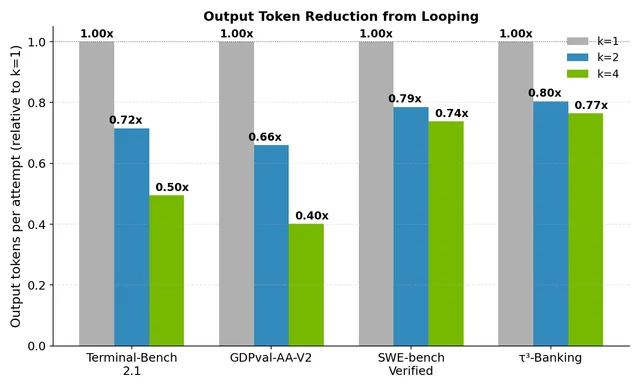
四组任务里,把循环从 1 提到 4,每次尝试的生成 token 都降到原来的四成到七成多。1
官方另给了一份对 Artificial Analysis 智能指数 v4.3.2 的自算估计:1 循环 13.8 分、2 循环 17.7 分、4 循环 18.4 分。1 同一张图上的对照是 Qwen3.5-4B 的 11.0、Qwen3.5-9B 的 12.53 和 Gemma 4 26B A4B 的 16.35。1
这一列由 NVIDIA 自己按 AA 的口径复算,模型卡写明可能与 AA 官方分有出入。1
第三方独立评测:目前还没有
三个常用落点都查过,没有 Dory。
- Artificial Analysis 的模型榜上没有这个条目,榜上最接近的 4B 模型是 Nemotron 3 Nano 4B。5
- Vals Index 在 2026 年 10 月 16 日的 2.1 版里也没有它。6
- OpenRouter 的模型目录里没有 Dory,也就是说暂时没有托管方上线。10
所以本条的分数、速度和成本都只有厂商一侧的数字。1
可用范围与价格
运行方式官方给了两条,都还没进正式发版:vLLM 要装第 60149 号 PR,llama.cpp 要按指定版本自己编译。811 Apple Silicon 上官方给了原生 arm64 的编译步骤,量化版走 GGUF。1
官方在 DGX Spark 上给了量化提速的对照:输入 2560 tokens、输出 300 tokens 时,MXFP8 是 BF16 的 1.69 倍、NVFP4 是 2.17 倍。1 输入 128 tokens、输出 1024 tokens 时,两者分别是 1.84 倍和 2.44 倍。1
该不该试
- 要在本地跑一个能商用的 4B:NVFP4 约 3.20 GB、GGUF Q5_K_M 约 3.42 GiB,许可允许商用,vLLM 与 llama.cpp 都给了部署步骤。134
- 要长上下文:最长 256K tokens,多数层用 1024 tokens 的滑动窗口,每 4 层才有一层全注意力。19
- 要指令遵循和工具调用:IFBench 79 和 τ³-bench 银行项的 14.69 是它相对同类最有优势的两项。1
- 要压生成 token 的账单:官方口径下,4 循环把每次尝试的输出 token 压到 0.4 至 0.8 倍。1
- 做知识密集型任务:GPQA Diamond 72.16、HLE 10.43、AA-Omniscience 10.03,三项都低于 9B 与 35B 的对照模型。1
- 要用中文或非文本能力:它只支持英文,输入输出都是文本。1
- 要现成 API 直接调用:还没有托管方上线,得自己部署。10
- 要第三方独立评分:Artificial Analysis 与 Vals Index 都还没给它建档。56
还没有的数字
- 独立评测:Artificial Analysis、Vals Index、OpenRouter 三处都没有它,所有分数只有厂商自测。5610
- 托管 API 与价目:没有托管方上线,也没有官方 token 价目。10
- 官方博客与技术报告:到发稿为止,NVIDIA 官方博客和开发者站的 Nemotron 页面都没有 Dory 条目,材料只有模型卡和四个权重仓库。1
- 官方安全评估:模型卡里没有随发布给出的安全评测或风险分级,只有通用的负责任 AI 说明;它提到的偏差、隐私等子卡片在仓库里没有对应文件。1
- last-loop KV caching 的实测数字:官方称开启后 KV 缓存不随循环次数增长,但没有公布显存实测量。1
- vLLM 与 llama.cpp 的合并时间:两个支持都停在待审的 PR 里,正式发版日期未定。811
References
- 1NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 模型卡
huggingface.co
- 2OpenMDW License Agreement, version 1.1
openmdw.ai
- 3NVIDIA-Nemotron-Labs-Dory1.0-4B-GGUF
huggingface.co
- 4NVIDIA-Nemotron-Labs-Dory1.0-4B-NVFP4
huggingface.co
- 5LLM Leaderboard — Artificial Analysis
artificialanalysis.ai
- 6Vals Index — Vals AI
vals.ai
- 7MXFP8
huggingface.co
- 8llama.cpp
github.com
- 9config.json
huggingface.co
- 10OpenRouter Models API
openrouter.ai
- 11vLLM PR #60149:Add Dory support
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.