腾讯混元开源 Hy-Memory 2.0:只换掉记忆框架里的写入模型,30B-A3B 四套系统均分 55.49,比 Opus 5 高 0.87 分
腾讯混元把 Hy-Memory 2.0 的模型、框架、应用三层一起开源,核心是一个只做记忆写入的 30B-A3B 模型:四套记忆系统均分 55.49,比 Opus 5 高 0.87 分,但真正站得住的优势在训练没见过的 EverMemOS 那 2.85 分上。

2026 年 10 月 16 日,腾讯混元开源 Hy-Memory 2.0。这次把三层一起开源:一个记忆写入模型 Hy-Memory-30B-A3B,一个记忆框架 Hy-Memory,一个把记忆带进各种 AI 工具的桌面应用 MemHub。三层都是 Apache-2.0。1
三层里最值得看的是模型。它只做一件事:把一段对话、一次操作,变成记忆库里该留下的那几条记录。2
官方给的成绩是 55.49。四套记忆系统、六项指标取均值,Claude Opus 5 是 54.62,高出 0.87 分。2
先说结论
- 模型与状态:Hy-Memory-30B-A3B,2026 年 10 月 16 日发布,权重在 Hugging Face。1
- 参数规模:30B 总参、约 3B 激活;128 个专家每个 token 走 8 个,48 层里 47 层是稀疏层。3
- 它替换的是谁:Mem0、MemOS、Hy-Memory 里那个负责写入的通用大模型,检索与回答环节不动。2
- 官方成绩:四套系统平均 55.49,Opus 5 是 54.62,DeepSeek V4.1 Flash 53.64,同尺寸的 Qwen3-30B-A3B 44.37。2
- 这个第一的边界:MemOS 上领先 0.01 分、Hy-Memory 上领先 0.02 分,报告自己把这种差距算作持平;站得住的优势在训练时没见过的 EverMemOS,高出 2.85 分。4
- 价格与许可:模型、框架、应用全部 Apache-2.0。官方没有托管 API,也没有价目表。1
- 部署门槛:BF16 权重 56 GiB,官方另发的 FP8 版 28.5 GiB;跑法是 vLLM 加一个 OpenAI 兼容端点。25
- 什么时候要动:正用 Mem0 或 MemOS、写入交给通用大模型跑的团队,值得拿自己的会话日志复跑一次;只想给产品加聊天记忆的,先看框架。6
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | Hy-Memory 2.0,模型 + 框架 + 应用三层开源 | 发布页 |
| 发布时间 | 官方标注 2026 年 10 月 16 日;权重仓与技术报告 10 月 15 日已上线 | 发布页 |
| 发布方 | 腾讯混元(Tencent Hunyuan) | 发布页 |
| 模型定位 | 记忆写入模型,替换记忆框架内部的通用大模型 | 模型卡 |
| 参数规模 | 30B 总参 / 约 3B 激活 | 模型卡 |
| 结构 | 128 专家 top-8;48 层,1 层稠密 + 47 层稀疏;隐层 2048;GQA 32 头 / 4 组 KV | config.json |
| 上下文 | 位置编码开到 262,144;RL 训练用 28,672 输入 + 4,096 输出 | config.json |
| 输入输出 | 文本进、文本出,输出是记忆记录 | 模型卡 |
| 许可 | Apache-2.0 | 模型卡 |
| 权重体积 | BF16 56.0 GiB;官方 FP8 28.5 GiB | 模型仓 |
| 部署方式 | vLLM 0.31.0,--served-model-name hy-memory,OpenAI 兼容 | 模型卡 |
| 思考开关 | chat_template_kwargs 里设 reasoning_effort: no_think | 模型卡 |
| 兼容范围 | Mem0、MemOS、Hy-Memory(参与训练);EverMemOS(训练未见,直接迁移) | 模型卡 |
| 价格 | 无官方 API 与价目;权重与代码免费下载 | 发布页 |
| 成绩口径 | 厂商自测,固定 20% 基准子样本,四套系统等权平均 | 技术报告 |
| 第三方复跑 | 未见:Artificial Analysis 的榜单里没有它,OpenRouter 也没上架 | AA 榜单 |
| 需要动作 | 现在用通用模型做写入的,要改的是这一步的模型名与端点 | 模型卡 |
它换掉的是框架里的哪一个模型
一个有长期记忆的 agent,内部通常分三段:写入、检索、回答。写入把新发生的对话或操作转成记忆记录,检索在提问时挑出相关的几条,回答模型只看挑出来的那一块。4
写入这一步通常由一句很长的提示词加一个通用大模型完成。这个位置决定了两件事:什么被留下,以及新信息和旧记录冲突时以谁为准。4
论文里有一句话把这个位置的分量讲清楚了:框架找不回写入时被省略掉的信息,下游模型再强也推不出来。4
Hy-Memory-30B-A3B 换的就是这一个位置。记忆系统的规则、数据结构、检索逻辑都留在原处,只换执行写入协议的那个模型。2
训练覆盖五种配置:Mem0、MemOS,以及 Hy-Memory 的聊天、工作、代码三个场景。4
这五种配置上的写入协议它都练过。换到别的记忆框架,效果能剩下多少要自己测;EverMemOS 就是这种迁移的样例,它没进训练,直接跑了 56.89。4
55.49 是怎么算出来的
评测只换写入模型。harness(承载写入流程的那套框架配置)的版本、提示词、检索配置、回答模型、判分模型全部固定,每个写入模型都从空记忆库开始自己建库。2
考六项。前三项是 LoCoMo 判分、LongMemEval 和 PersonaMem v2,考聊天记忆的常规问法。2
后三项是 Travel SPS(旅行规划)、Shopping PS(组合购物)和 CMB。CMB 指代码记忆,本身是两项仓库问答的平均。2
每套系统里六项等权平均得到一个 harness 分,四套 harness 再等权平均,就是那个 55.49。2
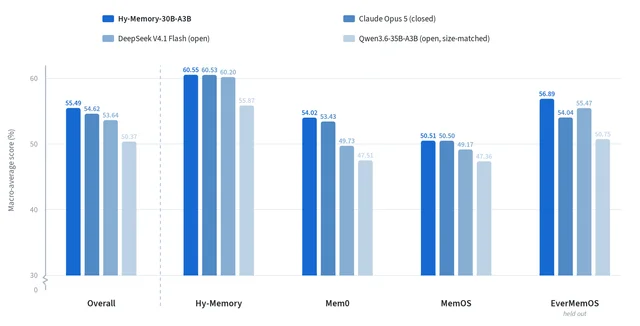
四套系统里每一套都是它第一,但四套的差距大小差得很远。2
Mem0 上 54.02 对 53.43,差 0.59 分。Hy-Memory 上 60.55 对 60.53,MemOS 上 50.51 对 50.50,差距分别是 0.02 与 0.01 分。2
技术报告对此写得很直白:MemOS 与 Hy-Memory 上这 0.01 到 0.02 分的差距,在确定性抽样评测下算持平,差不出统计显著性。4
真正拉开距离的是 EverMemOS,56.89 对 54.04,差 2.85 分。这一套没进训练,所以它测的是迁移能力。4
再往下拆一层,那 0.87 分的总差距落在哪里就清楚了。
| 指标 | Hy-Memory-30B-A3B | Claude Opus 5 | 差值 |
|---|---|---|---|
| LoCoMo | 67.27 | 70.23 | −2.96 |
| LongMemEval | 77.75 | 78.87 | −1.12 |
| PersonaMem v2 | 52.09 | 51.58 | +0.51 |
| Travel SPS | 48.22 | 40.59 | +7.63 |
| Shopping PS | 19.90 | 21.11 | −1.21 |
| CMB | 67.74 | 65.36 | +2.38 |
| 六项均值 | 55.49 | 54.62 | +0.87 |
单位 %,取自官方发布页的六项指标明细表;每一行都是四套 harness 上的均值。
六项里赢三项、输三项。旅行规划一项多出 7.63 分,代码记忆多 2.38 分,PersonaMem 多 0.51 分。1
旅行规划这一项的贡献摊到六项均值上是 1.27 分。它先被其余几项的小幅落后抵掉一部分,剩下的才是 0.87 分。1
落后的是长期记忆那几项常规指标:LoCoMo 低 2.96 分,LongMemEval 低 1.12 分,组合购物低 1.21 分。1
这个分布和技术报告自己的总结对得上。它反复拿到增益的是 Travel SPS 与 CMB;在留出的 EverMemOS 上,增益主要也来自这两项,Travel 涨 10.65 分、CMB 涨 13.66 分。4
对照组的身份也得交代。Opus 5 是闭源通用模型,DeepSeek V4.1 Flash 也是通用模型,Qwen3-30B-A3B 是同尺寸开源模型,Hy3-A3B Base 是它自己的起点。2
更值得看的是它和同门通用模型的对比。Hy3 在这套评测上是 51.63,比这个专用小模型低 3.86 分;相对那个基座,训练一共换来 7.84 分。1
训练分两步:先学会按协议写,再学会写得有用
第一步解决格式。通用模型放进记忆框架,最先出问题的是协议:JSON 格式错、操作名写错、字段缺、多阶段流程走不通。这些错误让强化学习把样本浪费在无意义的试错上。4
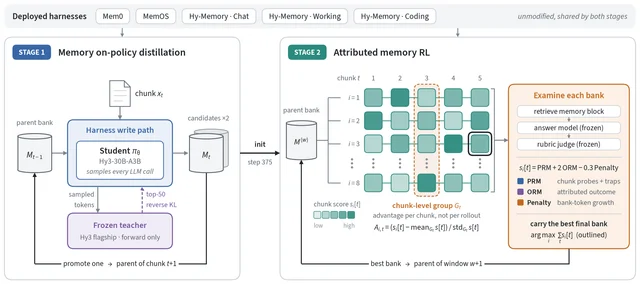
蒸馏这一步让学生模型在真实的框架写路径里,学会每种 harness 该怎么写。4
学生是 Hy3-30B-A3B 的指令版,老师是同门的 Hy3 旗舰。老师只做前向、给出 top-50 的概率分布,在学生自己写出的 token 上打分。4
这一点是整套训练里最容易忽略的设计。老师拿到的是学生实际走过的轨迹,在那些位置上纠正;学生往前走时看到的记忆库,也是它自己前面写出来的。4
第二步才是强化学习,考的是「这样写有没有用」。每个窗口最多五块,一块约十轮对话、不跨会话。同一个起点出发跑 8 条 rollout(每条把整窗写一遍,各建一个记忆库),写完之后再考。4
考法有两路。逐块探针看这一块有没有被精确写下来:人名、数字、版本、路径是否保留,否定和范围有没有被写反,该丢的寒暄有没有被存进库。4
跨块的结果题看后面能不能答出来,并按金标事实把得分归因回提供证据的那一块。4
还有两件东西专治「全都存」。一类是陷阱题,正确答案是「库里没有这条记录」,比如助手随口一句鼓励;另一项是记忆库增长惩罚,按记忆库的 token 数相对输入 token 数的增长扣分。合起来的打分是「逐块探针分 + 2 × 跨块结果分 − 0.3 × 增长惩罚」。4
优化用块级 GRPO。优势值在同一块的位置上归一,所以一条 rollout 可能在第 2 块拿最高分、在第 4 块拿最低分,各块按自己的表现被强化。4
奖励数据的制备是这套方法最重的一块工作量。生成 47.8 万条探针,结构校验留下约 41 万条;7.2 万道跨块题留下 6.1 万道。4
最终产物是 164,576 条正探针、8,599 条陷阱、约 6.08 万道结果题,以及 222,395 条块级金标引用。4
训练用了 128 张 H20,batch 是 64 个窗口 × 8 条 rollout,学习率 5e-6,不加 KL 惩罚。4
报告自己列了这套方法的软处。归因是证据式的,找回了金标事实,也证明不了是某一次写入导致了那个答案;信用在优化步之间被截断,早先记忆库里的错误拿不到追溯梯度。4
框架层和 MemHub 各自开源了什么
框架的项目名同样是 Hy-Memory,PyPI 上叫
hy-memory,与模型名只差一个后缀。它分三类场景,记忆的形状各不相同。6聊天场景是八层结构。L0 基本信息、L1 原始对话、L2 原子事实、L3 会话摘要,L4 与 L5 留作预留,L6 是心智模型,L7 是带失效期的前瞻意图。6
工作场景是两层。每个会话恰好一条事实记录,说明这一步做了什么、怎么做的、结果如何;外面一层是 0 到 N 条可复用经验,要过价值阈值才存。6
代码场景沿用同一套两层结构,另加一条版本演化链,把每次改动的真实 diff 挂到对应事实下面。6
加这条链的理由很实在:事实层刻意只记坐标、不贴代码,被回滚掉的版本会从事实里消失,而它通常也不在工作区里。6
框架的四项基准都在开源框架里排第一,对照的是 Mem0、MemOS、EverOS、OpenViking、RepoMemory 与 Simple RAG。1
分数依次是:LoCoMo 准确率 72.6%,MemoryArena 平均分 55.31%。代码记忆这边,CodeMemoryBench 问答 64.2%、解决率 35.6%,SWE-ContextBench 解决率 28.3%。1
媒体转述里还有两个数字。LoCoMo 上每题消耗的 token 从 1,159 降到 703,少了 39.3%。SWE-ContextBench 的 28.3% 高于 MemOS 与 Mem0 的 25.3%。7
腾讯自称这是「业界首个提出工作记忆与代码记忆的记忆框架」。这句话是厂商表述,首创一事没有第三方核对。1
SDK 发在 PyPI 上,节奏很快:2.0.1 到 2.0.4 四个版本,都落在 10 月 16 日与 17 日这两天。8
MemHub 是应用层,把用户授权过的 AI 工具会话汇成一份本地记忆,目前覆盖 10 种工具。已接入的包括 Cursor、Codex、Claude Code、OpenCode、OpenClaw、Qwen Code 与 DeepSeek Harness 等。1
它现在是 preview 状态,源码版本 1.0.3(build 7),发行目标只有 Linux x64/arm64 与 macOS arm64/x64,Windows 不支持。数据默认落在
~/.one-memory。9想装的人会先撞上一处:发布页的「获取 MemHub」指向
github.com/Tencent-Hunyuan/MemHub,打开是 404。1MemHub 的说明、安装流程和发行制品都在 Hy-Memory 主仓的
memhub/ 目录里,走那条路才装得上。9MemHub 给自己划了隐私边界:不采集屏幕、无障碍树、OCR 与剪贴板,也不做后台录音;来源读取、模型处理、宿主读取是三道互相独立的授权。9
腾讯内部已经接入的案例里,自选股的 AI 助手在 A 股投研记忆专项评测上综合得分从 64.3 升到 79.6,多跳召回从 50% 升到 90%。1
iWiki 的 CTX 插件在 251 道题上,只用记忆回答的正确率是 36.7,高于把全部原始对话塞进去的 24.7。这些数字都由腾讯自己给出。1
许可、价格与部署
三层全部 Apache-2.0,商用没有额外门槛。1
官方没有发布托管 API 和价目。发布页给的三条上手路径是 MemHub、SDK 和 Hugging Face 权重,都指向自己跑。1
按这两个体积算,FP8 版能装进单张 48 GB 的卡并留出 KV 缓存,BF16 版要 80 GB 级别的卡。官方没有给硬件要求,这里是按权重体积做的推算。5
跑法在模型卡里写好了:vLLM 0.31.0,
--served-model-name hy-memory,然后按 OpenAI 兼容接口调用。2框架侧的安装可以按需拼:默认装 ChromaDB 与 Kuzu,另有 Qdrant、FAISS、Neo4j、MySQL 缓存、本地重排几个可选组,
[all] 全装。6框架本身还要一个 LLM 端点和一个 embedding 端点,两个都接受任意 OpenAI 兼容服务。6
默认示例填的是 DeepSeek 的对话模型与阿里云百炼的 embedding。6
该不该试
- 已经在用 Mem0 或 MemOS、写入交给通用大模型:这是最贴近的一组,训练就覆盖了这两套。动作落在写入那一步:拿自己的历史会话,在现用模型和它之间各跑一遍,重点看跨会话的更新与冲突。4
- 正从零做带记忆的产品:先看框架。聊天记忆的
lite模式只做原始文本的向量检索,成本近乎为零;要事件脉络再上pro,要心智模型层再上ultra。6 - 只想要一份跨工具的个人记忆:对应的是 MemHub,但它在 preview、Windows 不支持、官网下载入口当前是 404,先按主仓的发行说明走。9
- 要有托管 API、不想碰显卡:现在这条路不存在,三层都只给下载,没有端点可调。1
- 中文为主的场景:模型卡标注了中英双语,官方没有给中文的单独评测,六项指标用的都是现成的公开记忆基准。中文效果要自己测。2
还没有的数字
References
- 1Hy-Memory 2.0 官方发布页
memory.hunyuan.tencent.com
- 2Hy-Memory-30B-A3B 模型卡
huggingface.co
- 3config.json
huggingface.co
- 4技术报告
arxiv.org
- 5FP8 权重仓
huggingface.co
- 6Hy-Memory 仓库
github.com
- 7IT之家报道
finance.sina.com.cn
- 8PyPI hy-memory
pypi.org
- 9MemHub 说明
github.com
- 10AA LLM 榜单
artificialanalysis.ai
- 11OpenRouter 模型目录
openrouter.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.