NVIDIA 发布 Nemotron 3.5 Super VL:120B 只激活 12B,官方称吞吐高达同类 5 倍
NVIDIA 发布 120B 总参、12B 激活的开放多模态模型 Nemotron 3.5 Super VL:1M 上下文、原生 MTP 投机解码,官方称吞吐达同类 5 倍,OpenRouter 上输入每百万 tokens 最低 0.10 美元。

NVIDIA 在 2026 年 10 月 15 日发布 Nemotron 3.5 Super VL,一个 1200 亿参数的开放视觉语言模型,每个 token 只激活 120 亿。1
同一批还放出两款边缘模型:Nemotron 3.5 Bolt 74B-A9B 24GB 当天可用,更小的 Bolt E4B 4GB 定在 10 月 23 日。1
官方给 Super VL 的说法是「同类里最快的开放 agent 模型,比第二名快 5 倍」,精度对标自家 550B 的 Nemotron 3 Ultra,参数量只有后者约五分之一。1
先说结论
- 模型与状态:Nemotron 3.5 Super VL,2026 年 10 月 15 日发布,BF16 与 NVFP4 权重已在 Hugging Face 开放。12
- 参数规模:总参 120B,每 token 激活 12B。2
- 架构:Mamba-2、MoE 与注意力交错的混合结构,每层 512 个路由专家,外挂 C-RADIO 视觉编码器,原生多 token 预测做投机解码。2
- 上下文与模态:1M tokens;输入文本、图像、视频,输出文本。2
- 许可:OpenMDW-1.1,允许商用;权重、数据集、训练配方一起放。2
- 官方自测:知识、编码与多数多模态项落后于更大的对手,官方主张的是同精度下的速度。2
- 吞吐:官方引用 Artificial Analysis 榜单称最高到同类 5 倍;OpenRouter 实测最快一家 381 tokens/s。13
- 第三方:Artificial Analysis 智能指数 26,同类开放权重的中位数是 8;它的速度栏与成本栏都是空的。4
- 价格:OpenRouter 四家托管方,每百万 tokens 输入 0.10 至 0.25 美元、输出 0.40 至 1.50 美元,另有免费路由。3
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | Nemotron 3.5 Super VL,2026 年 10 月 15 日发布,权重当天开放 | 官方博客 |
| 发布方 | NVIDIA | 模型卡 |
| 参数规模 | 总参 120B,每 token 激活 12B | 模型卡 |
| 架构 | Mamba-2 混合 MoE,每层 512 路由专家;C-RADIO 视觉编码器 | 模型卡 |
| 上下文 | 1M tokens | 模型卡 |
| 模态 | 输入文本、图像、视频;输出文本 | 模型卡 |
| 许可 | OpenMDW-1.1,可商用 | 许可全文 |
| 部署 | BF16 走四卡 H100 或两卡 GB200;另有 NVFP4 仓 | 模型卡 |
| 推理引擎 | vLLM、SGLang,均支持原生 MTP 投机解码 | 模型卡 |
| 思考档位 | 关、开(medium)、开三档,通过聊天模板切换 | 模型卡 |
| 价格 | OpenRouter 输入 0.10–0.25 美元、输出 0.40–1.50 美元每百万 tokens | OpenRouter |
| 何时要动 | 要在私有环境跑高吞吐多模态 agent,现在就能下载权重 | 官方博客 |
规格:Mamba-2 加 MoE,每层 512 个路由专家
语言主干是 Mamba-2、稀疏专家与注意力层交错的混合结构,每个 MoE 层配 512 个路由专家。2
视觉一侧用 C-RADIO 编码器加一个视觉语言连接器,把图像、文档页面和视频帧转成主干能处理的表示。2
多 token 预测是被当成部署特性写的:一个共享的 MTP 头递归预测后续 token,模型因此自带投机解码,不用另外下载草稿模型。2 vLLM 上用
num_speculative_tokens 调草稿长度,SGLang 上走 EAGLE。2训练:六个阶段,约 26 万亿 tokens
主干从 Nemotron 3 Super Base 初始化。MTP 头先在主干冻结的状态下训 100B tokens,再从 Nemotron 3 Ultra Base 蒸馏 1T tokens。2
继续预训练与中训练加了几段专门的数据:100B tokens 的印度语种继续预训练、35B tokens 把上下文拉到 1M、67B tokens 在 256K 上下文上做软件工程中训练、最后 9B tokens 的长上下文恢复。2 软件工程数据包含代码仓、issue 与 pull request 配对、提交差异、构建与 CI 日志,以及 agent 轨迹。2
视觉语言训练把 C-RADIO 编码器和连接器接到主干上,之后是两阶段监督微调,打包序列最长 524,288 tokens。2
最后两步是可验证奖励的强化学习、人类反馈强化学习和教师专精,再用多教师同策略蒸馏合并成一个模型,最后单独强化 MTP 头以提高投机解码的接受率。2
官方博客给的训练量口径是:预训练与继续预训练合计约 26 万亿 tokens,后训练用约 380 万条样本加数十个环境的强化学习。1 模型卡记的基础训练数据是「超过 20 万亿 tokens」,采集期从 2013 年到 2025 年 12 月。2
官方自测:速度是卖点,分数不是
模型卡里 Super VL 的对照对象是几个同量级开放权重模型,成绩由 NeMo Gym 统一采集。2
| 基准 | Nemotron 3.5 Super VL | Qwen3.8-Flash-Next | Nemotron 3 Ultra | GLM-5.3-Flash |
|---|---|---|---|---|
| GPQA Diamond | 89.52 | 92.7 | 87.0 | 91.2 |
| HLE(纯文本) | 31.79 | 39.6 | 29.2 | 36.47 |
| MMLU-ProX | 76.91 | 83.0 | 83.1 | 83.0 |
| AA-Omniscience 指数 | 4.03 | -1.9 | 8.8 | 14.3 |
| LiveCodeBench v6 | 88.22 | 94.1 | 89.2 | 80.6 |
| SciCode(子任务) | 47.13 | 46.6 | 42.0 | 50.05 |
| AA-LCR v1.1 | 68.62 | 78.4 | 75.2 | 79.5 |
| GraphWalks | 89.71 | 76.1 | 63.3 | 88.4 |
| IFBench | 70.86 | 75.6 | 82.9 | 57.7 |
| tau2-bench retail | 69.24 | 71.6 | 73.7 | 78.2 |
| tau3-bench banking | 18.88 | 44.5 | 18.4 | 34.8 |
| GDPval-AA v2 | 1211 | 1561 | 1148 | 1563 |
| BrowseComp | 78 | 89.0 | 67.85 | 86.6 |
| SWE-bench Verified | 71.10 | 78.7 | 73.9 | 79.10 |
| Terminal-Bench 2.1 | 60.67 | 85.80 | 54.80 | 82.70 |
| MMLongBench-Doc | 62.82 | 67.9 | — | 65.8 |
| V* | 85.60 | 93.0 | — | 88.1 |
| Video-MME v2 | 32.85 | 45.1 | — | 14.8 |
| OSWorld-Verified | 51.14 | 55.8 | — | 14.78 |
读这张表要看清官方的主张落在哪。19 项里它只在 GraphWalks 一项最高,跟自家 550B 的 Nemotron 3 Ultra 比是各有胜负,跟 Qwen3.8-Flash-Next 和 GLM-5.3-Flash 比则输多赢少。2
官方博客的措辞也是「可比」,不是「更强」:它说 Super VL 在多模态 agent 任务上的准确度与自家最大的推理模型相当,而参数量只有后者的约五分之一。1
另外值得单独看的是 AA-Omniscience 这一行。它是 Artificial Analysis 的第三方方法,衡量知识可靠性并惩罚幻觉,得分越高越好;Super VL 拿 4.03,比 Nemotron 3 Ultra 的 8.8 和 GLM-5.3-Flash 的 14.3 都低。2
速度主张:5 倍从哪来
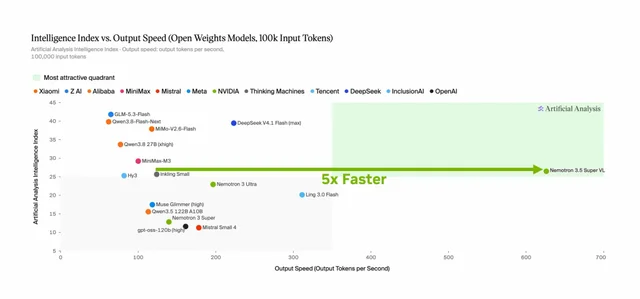
官方博客的说法是:在 Artificial Analysis 智能指数榜单上,它达到同量级其他模型最高 5 倍的吞吐。1
托管侧可以给出一个量级参考。OpenRouter 上四家托管方里最快的一家跑到 381 tokens/s,延迟 0.36 秒,三天可用率 98.61%。3
吞吐之外还有一条与成本有关的数字:官方说模型跑在 NVIDIA Dynamo 上时,同等硬件可以服务多 8 倍的用户,延迟降低 85%。1
同批的 Nemotron 3.5 Bolt:面向本地设备
Bolt 74B-A9B 24GB 总参 740 亿、激活 90 亿,用原生 2-bit 量化把体积压进 24 GB 显存,目标是和别的程序共用一台 RTX 或 DGX Spark。1
它当天已在 Hugging Face 开放,支持 llama.cpp、Ollama、LM Studio、Unsloth 和 vLLM。1 官方称它是同类开放模型里 PinchBench 第一、BrowseComp 第二。1
Bolt E4B 4GB 面向 GeForce RTX、Jetson 和 RTX/DGX Spark 上的对话与物理 agent,10 月 23 日上线。1
第三方:智能指数 26,速度与成本是空的
Artificial Analysis 给 Nemotron 3.5 Super VL 的智能指数是 26 分,同类(40B 到 150B)开放权重模型的中位数是 8。4
| 第三方指标 | Nemotron 3.5 Super VL | 来源 |
|---|---|---|
| Artificial Analysis 智能指数 v4.3.2 | 26(同类开放权重中位 8) | Artificial Analysis |
| 智能指数评测输出 tokens | 1.7 亿(同类中位 1 亿) | Artificial Analysis |
| 输出速度 | 未公布 | Artificial Analysis |
| 每次任务成本 | 未公布 | Artificial Analysis |
| 托管实测吞吐 | 381 tokens/s(最快一家) | OpenRouter |
| 托管实测延迟 | 0.36 秒(最快一家) | OpenRouter |
AA 注明它是推理模型,输入支持文本与图像,上下文 1M,参数 120B / 12B,许可为 OpenMDW-1.1 且允许商用。4
许可与开放范围
开放的边界比一般开放权重更宽。NVIDIA 同时放出 agent 工具调用、金融、指令跟随、长上下文、公平性与视觉语言理解等数据集,以及 NeMo Gym 里的强化学习环境。1
企业侧还有两条配套:NVIDIA NIM 把模型打包成微服务,每两周跟一次安全补丁与性能更新;NeMo 与开放数据集负责定制。1
官方列出的定制方覆盖多个行业。Scale AI 用它做了 Skydance 的供应商信贷金融 agent 和 EY 的并购尽职调查 agent,AI21 与 Alice 用它做网络攻击韧性,Mercor 用 APEX-SWE 做编码 agent,此外还有 Ramp、Dream、Lila Sciences、R1、TrainLoop。1
平台侧的集成名单里有 Atlassian(Jira 与 Confluence 的 agent 检索)、CrowdStrike、Dassault Systèmes、Perplexity、Salesforce 与 Synopsys。1
该不该试
- 要高吞吐的多模态 agent:这是它唯一明确领先的维度,官方给出的 5 倍与托管实测的 381 tokens/s 都指向这一点。13
- 要看榜单分数选模型:AA 智能指数 26,比 GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3 Ultra 都低,用分数做决策的场景可以先看别家。4
- 要文档、表格与图表理解:那是它的设计目标,模型卡里 MMLongBench-Doc、CharXiv、OCRBench v2 都有数。2
- 要在自己的数据上后训练:许可可商用,数据集与训练配方一起放,vLLM 与 SGLang 都支持。1
- 要一台机器跑起来:BF16 要四卡 H100 或两卡 GB200,本地路线看同批的 Bolt 74B-A9B 24GB。12
- 只看价格:OpenRouter 上最便宜一档每百万 tokens 输入 0.10 美元、输出 0.40 美元,还有免费路由可以试。3
- 要等独立复跑:目前只有 AA 的综合分,速度与成本数字还没出。4
还没有的数字
References
- 1
- 2Nemotron 3.5 Super VL 模型卡
huggingface.co
- 3Nemotron 3.5 Super VL — OpenRouter
openrouter.ai
- 4Nemotron 3.5 Super VL — Artificial Analysis
artificialanalysis.ai
- 5OpenMDW License Agreement v1.1
openmdw.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.