
你让 AI 看三份材料、回答一个问题,它答得含糊。回头翻自己发出去的东西:整叠文件都在里面,后面还跟着两百多行历史对话。
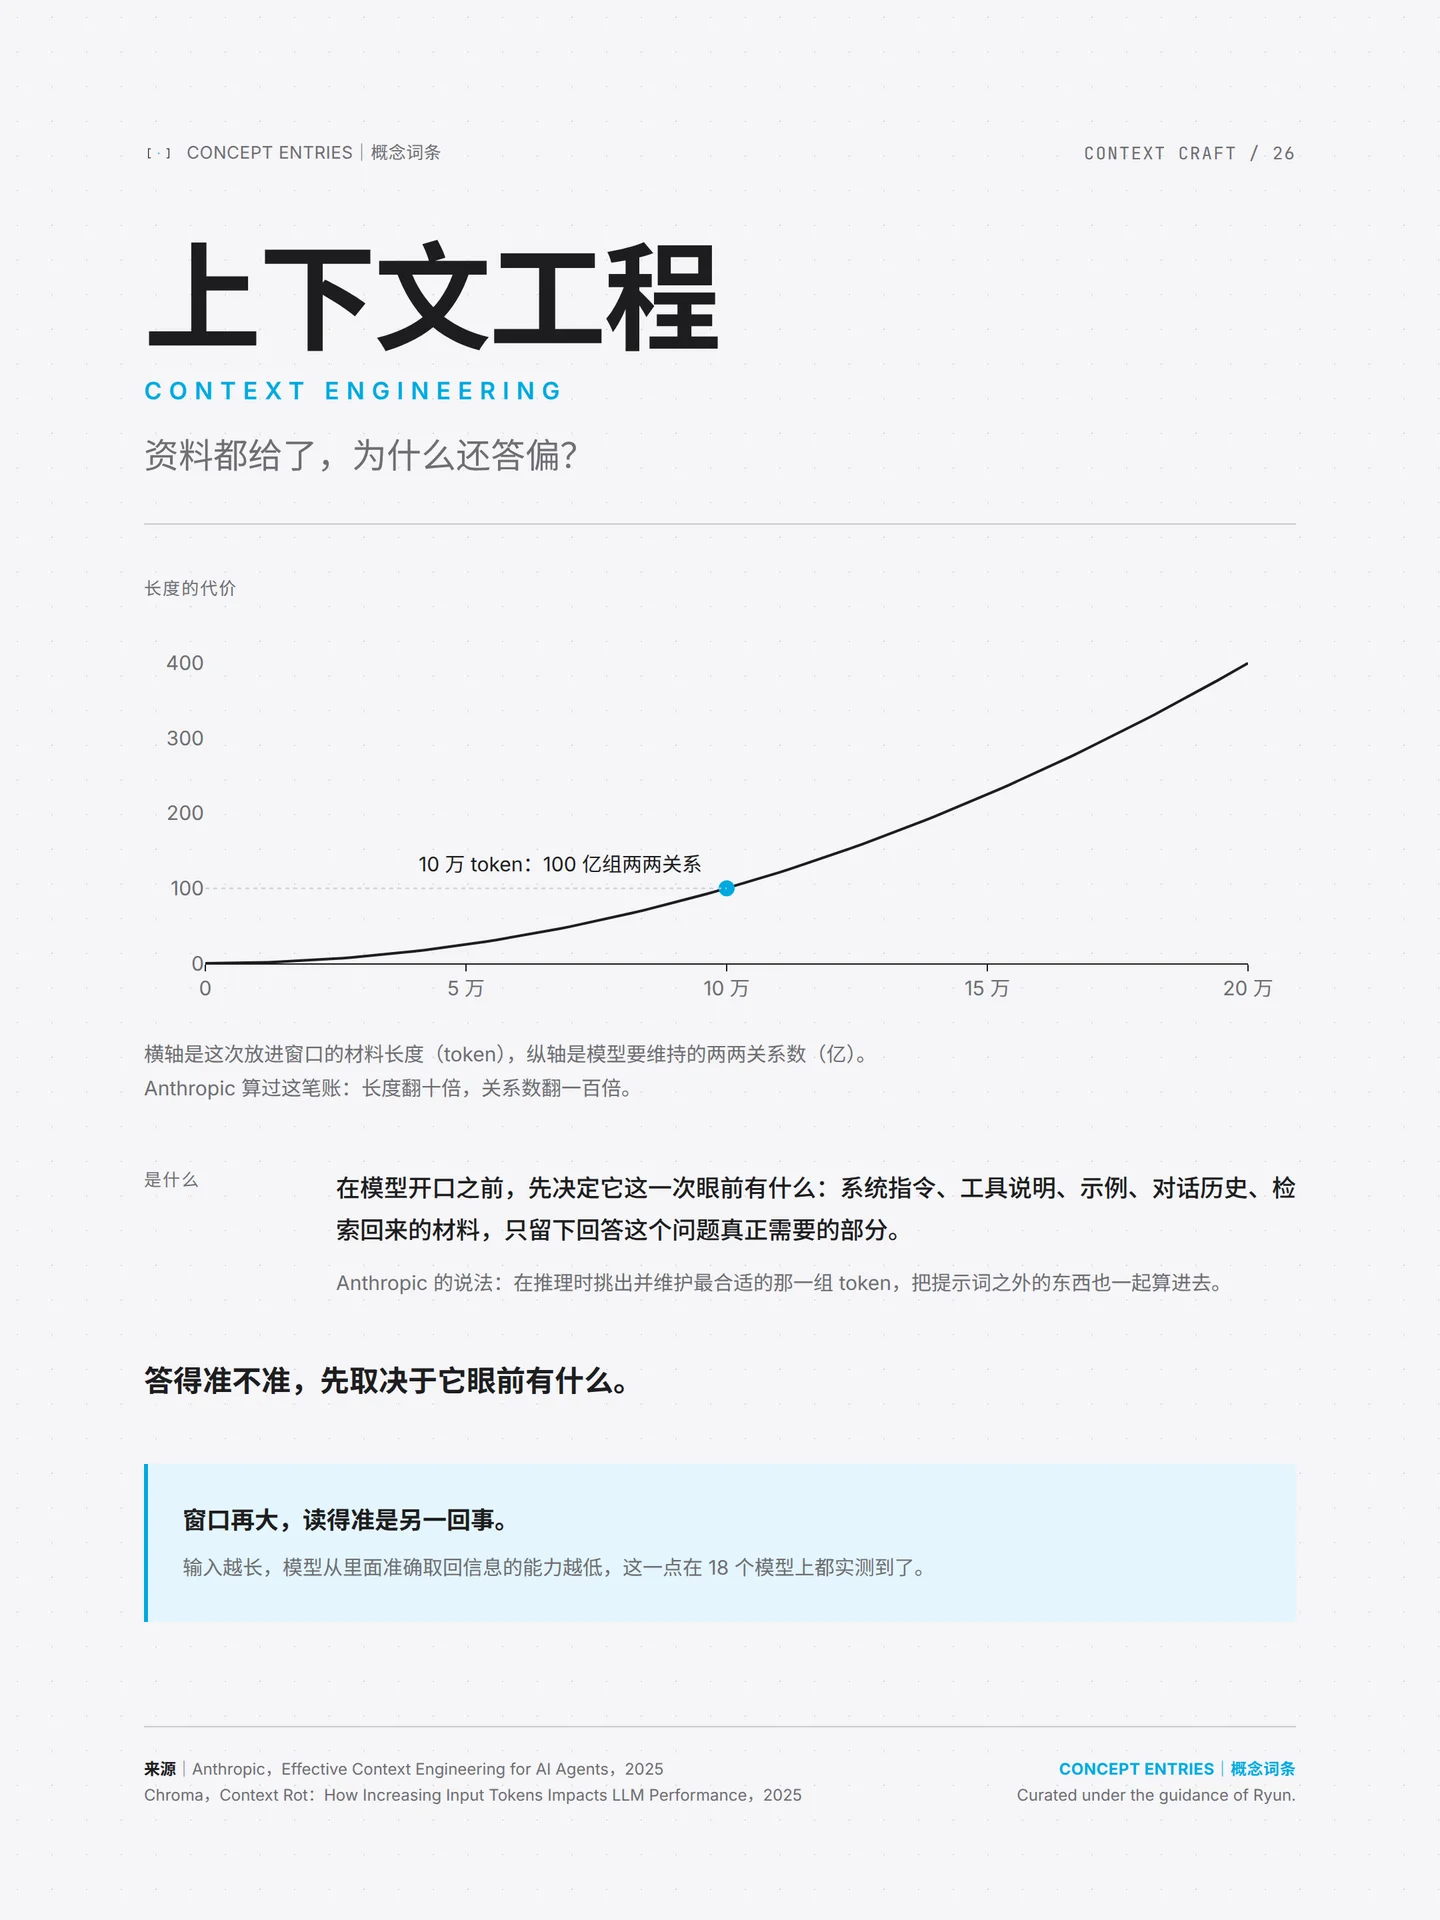
上下文工程(Context Engineering)管的是模型开口之前的那一步:这一次它能看到的那一组 token 里放什么、删什么。提示词之外的东西也算在里面——系统指令、工具说明、示例、对话历史、检索回来的材料,目标是留下最小的一组高信号内容 1。窗口是一笔要花掉的预算:n 个 token 意味着 n² 组两两关系,放进去的越长,注意力摊得越薄。
它替换的是那句「资料都发给你了,你自己看着办」。挑选、排序、删减都被这句话推给了模型,而模型只看得到你放进窗口的东西。
调用:用「上下文工程」整理这次的输入:只留下回答这个问题真正需要的部分。先把这次要回答的问题写成一句话,再按这句话挑材料、删掉沾边却不回答的段落。
边界有两处。一是长度换不来准确:输入越长,模型从里面准确取回信息的能力越低,话题沾边却不回答问题的段落最拖后腿,Chroma 在 18 个模型上都测到了这一点 2。另一处是删得太狠会丢东西:压缩会清掉当时看不出重要、后来才知道关键的细节,重要材料自己留一份原文。
References
- 1
- 2
Comments