124B 装进一台桌面盒子、2B 反超 8B、49 分 20 秒对 8 分 21 秒
本期覆盖 9 月 15 日至 16 日的六组实测与一条平台动态:124B 的 MoE 在单台桌面机上的吞吐和二十分钟后的显存溢出、1M 上下文的本地配置与社区的 550K 经验线、Mac 上十六路会话的批量解码、豆包 Seed-2.1-pro 0915 跑完的五组任务、小视觉模型参数越大准确率反而更低、仿真里通用模型与具身模型的用时与成本差,以及 B 站新上线的大模型竞技场。

过去二十四小时里,六组实测给出的数字都挂在同一件事上:跑在什么引擎、什么量化、多少并发、由谁出题。四张卡上把上下文开到 1M 之后,社区的结论落在 550K 这条线上;一块 Mac 的显卡上把批处理补起来,并发吞吐涨了近三倍,同一份提交里另一次优化实测收益为零;一台 128GB 的桌面盒子里,124B 参数的 MoE 确实跑起来了,代价在二十分钟后出现。
模型名字在这几条里只是起点。读者要判断的是这套配置离自己手上的活有多近。
本期覆盖 2026 年 9 月 15 日至 9 月 16 日,来源为 X、Reddit、GitHub、小红书与公众号。
六组实测总览
| 任务 | 测试对象与条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 在一台 DGX Spark 上跑 124B MoE | Ling-3.0-flash,官方 int4 权重,vLLM + MTP,128GB 统一内存 1 | 单流 36.0 至 40.9 tok/s;131K 上下文并发 34 路;约 20 分钟后 OOM | 数字来自论坛多位用户的不同配置;发帖人自评被自己作废 |
| 给 27B 模型开 1M 上下文 | Qwen3.8-27B NVFP4,vLLM 四路张量并行,fp8 KV Cache,yarn 四倍外推 2 | 每批最多 16,384 token;社区经验线在 550K 与 200K | 发帖人自称初学者,只跑了很短一段,没有质量对照 |
| Mac 上并发服务 16 路会话 | ds4 推理引擎的一个提交,Qwen3.8 Flash Next,M5 Max 128GB,Metal 批处理 3 | C=16、上下文 4,096 时聚合约 50 → 约 143 tok/s,单流 +8% | 单机单模型;提交者本人在征求更大机器的数字 |
| 一条模糊指令做完一个产品 MVP,再改一个 20 万行开源项目 | 豆包 Seed-2.1-pro 0915,豆包办公模式与 Claude Code 4 | 一个多小时拉起十多个子 Agent,交付 14 份文件与 19 张截图;20 万行里挖出 19 个问题、修好 8 项 | 作者自测;图推只有 4 道题;过程主要靠录屏呈现 |
| 扶手电梯跌倒的二分类视觉判断 | 七个约 2B 的开源视觉模型,Qwen3VL 与 Qwen3.5 多参数横评 5 | 2B 准确率 0.955,8B 0.929,4B 0.902;112 张样本微调 5 至 10 个 epoch | 单一任务与单份数据;最新一代只出了 27B,未参与 |
| 通用模型能不能顶替具身模型 | RoboDojo 仿真,π0.5 对 GPT-6 Astra + IK 对 GPT-6 Astra + cuRobo 6 | 单回合 8 分 21 秒 / 0.14 美元,49 分 20 秒 / 12.76 美元,34 分 44 秒 / 10.63 美元 | 单回合、仿真环境;两侧每段动作步数不同 |
124B 的 MoE,装进一台桌面盒子
9 月 16 日凌晨,X 用户 @sudoingX 读完 NVIDIA 开发者论坛上一个七十帖的长帖,把里面各人自报的数字和自己的实测写进了一条长帖。他的起手就问了一句很具体的话:一个 124B、每 token 激活 5B 的模型,放在 128GB 的桌面盒子上到底有没有用 1。
Loading content card…
讨论的对象是蚂蚁集团开源的 Ling-3.0-flash。模型官方页面写的是 KDA 与 MLA 两种注意力层按 5:1 堆叠、1/64 的专家激活、原生 256K 上下文并可外推到 1M 7。这套结构给了社区一个共同的前提:显存占用不再是唯一的门槛。
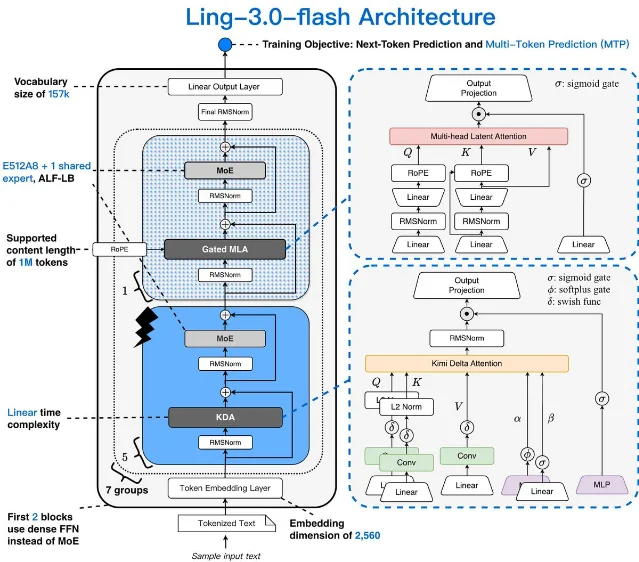
社区里跑得最顺的一份配方,来自一位开场就写「我不是开发者,也不是程序员」的用户,他借助 AI 助手搭好环境,用官方 int4 权重跑 vLLM,打开 MTP,单流 36.0 tok/s,在 9,021 token 的提示上预填达到 3,016 至 3,070 tok/s,131K 上下文下并发 34 路 1。@sudoingX 按同一套配置自己跑了一遍,拿到 40.9 tok/s。
真正的麻烦在后面。更长的编码会话里显存一路涨,大约二十分钟后 OOM;上下文填满之后解码速度往下掉;一位用户把自己那条成功运行标注成「不适合比较」——他原先打出 93/100,后来亲手把结论作废。社区顺着 MTP、bf16 投影层、sm_121 内核和 KV 分配四个方向往下查,修复以 vLLM 的 PR 形式提交出来 1。
到帖子结尾,有人把社区混合出来的 NVFP4 W4A16 量化跑通:单流 55.9 tok/s,打开 MTP 后 66.9 tok/s,按这位作者自己的测试,这个版本与 OpenRouter 上的 bf16 版本接近持平;一位把模型压得最狠的贡献者说,Ling 是他用过最省内存的模型之一 1。
这些数字的来路要一并交代:它们出自论坛里不同人的不同引擎版本与量化配置,@sudoingX 做的是汇总,加上自己的一次运行;论坛从 7 月下旬开帖,两个多月里内核、权重格式和引擎都换过好几轮 7。这份材料能回答「一台桌面盒子能不能跑 124B」和「跑起来之后会遇到什么」,回答「两种量化哪个更好」还需要自己复跑。
1M 上下文能开出来,拦路的是每批处理的量
Reddit 的 r/LocalLLaMA 上,一位自称初学者的用户贴出了他的服务配置:unsloth 的 Qwen3.8-27B NVFP4 权重,vLLM,四路张量并行,KV Cache 用 fp8,投机解码挂 MTP 且每次猜三个 token,位置编码用 yarn 做四倍外推,最大长度直接写 1,000,000 2。他的说明只有一句:刚开始学,配置是自己摸的,还不确定调对了没有。
Loading content card…
十九条回复把判断集中在两处。有人算了一笔账:上下文开到 1M,可每批最多处理 16,384 个 token,等于办了张能借所有书的借书证、每次只准看一页 2。另外两组经验值也留在了评论里:一位说 27B 超过 550K 之后质量会明显下降,550K 是甜点;另一位说他用 fp8 KV Cache 从来不越过 200K。发帖人对这两条经验的回应是「谢谢,我正想确认在 256K 以上哪个位置会崩」。
这份配置能提供的信息到「四张卡上确实起来了」为止。发帖人只跑了很短一段,没有质量对照,也没有吞吐数字;评论里的两条经验线也来自各自的机器和用法,不是同一套测试的结果。
把并发当成测试对象:一块 Mac 上 16 路会话
同一天,X 用户 @p0ly 说明了自己向开源推理引擎 ds4 提交的一份改动:Qwen3.8 Flash Next 现在把十六个会话放进一次 Metal 前向里解码,在 128GB 内存的 M5 Max 上合计到 203 tok/s,单流相比上游提升 8%,他还向两位更大型机器的使用者征求数字 8。
Loading content card…
提交记录里写清了原因:Qwen3.8 的会话原先被排除在原生批处理之外,每一个解码步都要把整张图按会话各跑一遍,十六个会话就是十六倍的权重流量。新的批处理编码器把稠密计算(超连接混合、投影、MoE、输出头)在堆叠后的行上跑一次,只把循环状态、缓存和 PLE 历史按会话保留;会话的临时缓冲搬进一块按最大会话尺寸分配的共享区,于是每多一个会话只多出它的缓存,上下文 4,096 时单会话内存降到原来的约三分之一 3。在 C=16、上下文 4,096 这一格上,聚合解码从约 50 tok/s 提到约 143 tok/s。
这份提交里还有两条对复现的人更有用的记录。一条是校验:批处理路径每一步都要吐出与顺序路径相同的 token,浮点归约顺序变化导致的差异会被单独测出来,失败时报告 logit 距离,用来分辨「换了归约顺序之后几乎打平」和「算错了」。另一条是一次没有收益的优化:把注意力的行批进单次派发,实测是 1.00 倍,那些网格本来就卡不到延迟上,注意力各阶段只占 110 毫秒一步里的约 6.5 毫秒;这段代码通过环境变量保留了回退开关 3。
这份数字的边界在机器上:全部结果来自单台 M5 Max、单个模型,203 tok/s 与 143 tok/s 分别出现在提交标题和批量编码那一步的记录里,测的是不同阶段的聚合口径;提交者自己也在帖子里向更大的机器征求数据。
一条模糊指令,一个多小时,十多个子 Agent
公众号「莫理」在 9 月 16 日发了对豆包 Seed-2.1-pro 0915 的实测,模型 ID 是
doubao-seed-2-1-pro-260915,走豆包的办公模式,代码那段接进 Claude Code 4。第一组任务只给了一句很模糊的需求:做一个将来能落地、面向普通用户的小型产品调研并实现 MVP。模型先拆任务,然后以负责人的身份并行开出两个子智能体,一个做需求调研,一个做竞品对比,同时启用浏览器测试能力。两个子 Agent 交回来的调研结论并不一致,模型把两份报告放在一起,从需求强度、竞品情况和产品可行性重新判断了一遍才定方向。整件事从头到尾跑了一个多小时,期间拉起十多个子 Agent,作者自称主动介入 0 次,最后拿到 14 份文档与代码文件,以及 19 张浏览器实测截图 4。
第二组换成一个真实的开源项目:Excalidraw,TypeScript 约二十多万行,其中生产代码 14 万行、测试代码 6.1 万行,核心的
App.tsx 一个文件有 14,297 行。任务按工程师接手陌生项目的顺序分三步。审查阶段明确只读不改,模型派出四个并行 Agent,从二十万行里挖出 19 个可修复的问题,其中 8 个中危以上,集中在边界归一化和异步竞态上;修复阶段八项改动全部验证通过,tsc 类型检查零错误,相关八百多项测试全部通过;新增功能分两批,先是 Frame 的批量创建与批量重命名等四个功能,再补六种基础图形。第一版的图形边缘太标准,缺了 Excalidraw 原本的手绘感,作者指出之后模型自己定位、修改、运行并验证。整轮下来新增约两千多行代码,没有新增依赖,也没有改动原有协议,全量回归跑过一百多个测试文件、两千多个用例 4。多模态那组更有意思。公考图形推理最新四道题,模型在做题时关闭联网,四道全对;题目图片只是 640×480 的翻拍照片,它先写了一段代码把题干和选项放大 3 到 5 倍,再逐格看位置、逐条数边,然后推规律。作者也写明这只有四道题,样本太少 4。UI 复刻那组给的是录屏:模型抽帧分析交互规则后,为标题里每个字符生成独立材质的贴纸,一共做了 24 张素材,再写代码把这套交互做成网页,并在内置浏览器里自己模拟鼠标慢扫、回扫和停留,截图返工。
另外两组分别是数据处理与内容复盘。前者用 5 张表、250 个客户、80 个 SKU、1,000 笔订单的模拟电商数据,模型先检查数据质量,再写 10 个编号脚本做清洗、指标计算与关联分析,交付一个含二十多张图表的可交互 HTML 仪表盘;自查时发现 CDN 资源在本地加载失败导致图表空白,它把图表库下载到本地重新引用。后者把作者过去 50 篇文章(跨度 70 天、10.4 万汉字、一千多张素材图)交给同一个模型,模型主动沿用了账号的配色做了分析页,并给出内容价值密度与流量表现的分布 4。
这几组结果出自作者一个人从 9 月 16 日开始的实测,工具链里混着豆包办公模式和一个第三方编码客户端。作者自己把第一组定位成 MVP 原型,也把图推那四道题点成样本不足;过程细节多以截图与录屏呈现,外部读者复跑不了同一条链路。
视觉模型:参数更大,准确率反而更低
公众号「GIS 小丸子」在 9 月 16 日发了二分类空间推理的第二篇实测,任务很具体:判断扶手电梯上是否有人跌倒,并且要实时出结果,所以输出必须短,模型不能长篇推理,方案落在小模型加 SFT 微调上 5。视频推理跑在 RTX 3060 上,多实例并行、跳帧检测,识别到跌倒就触发告警和画面红色闪烁,测试片段覆盖逆行、轮椅、老人、携带多件行李和推车等场景。
第一轮横评选了七个约 2B 规模的开源视觉模型:Qwen3VL-2B-Instruct、Qwen3.5 2B、MiniCPM V2.6、InternVL2 2B、MoonDream2、Gemma4 E2B it 与 DeepSeek VL2 Tiny。准确率和推理速度两项上,Qwen3VL 2B 和 Qwen3.5 2B 排在最前,其余模型在这份任务上的表现明显靠后 5。
第二轮把同一族的参数拉开。Qwen3VL 的 2B、4B、8B 三档里,2B 的准确率最高,8B 次之,4B 最低;Qwen3.5 的 0.8B、2B、4B、9B 四档里,2B 的精度同样是最好的,更大参数没有换来更高准确率,速度则随参数减小而变快。
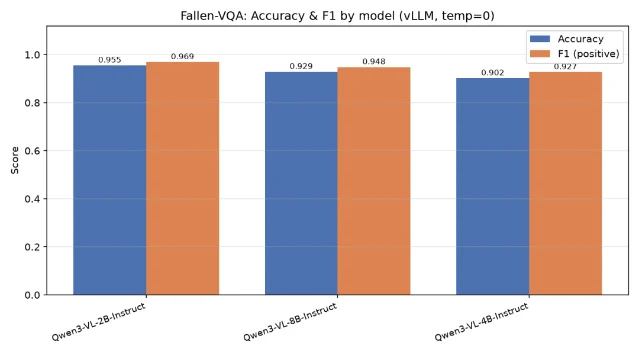
数据集本身分了三类子集,作者把它们打开逐个统计之后发现两族模型各有盲区:Qwen3VL 在负样本上认得很准,在数量更多的正样本上表现一般;Qwen3.5 在正样本上更好,而负样本几乎全错 5。
微调那组用了作者手工收集的 112 张样本。Qwen3.5 0.8B 在训练到 10 个 epoch 之后准确率开始下降,2B 在第 5 个 epoch 就达到了 1.0,这个规模的任务配这个量级的样本,5 到 10 个 epoch 就够了。作者也写下这轮的缺口:Qwen3.8 这一代只出了 27B,没有更小的尺寸,最新的模型反而缺席;数据集只有一份,任务只有一个,换到别的场景结论要重新测。
通用模型对具身模型:仿真里的三套方案
小红书用户 ooopsnini 在 9 月 16 日凌晨贴出一组仿真实验,题目是通用大模型加上传统机器人工具之后,能不能承担原本交给具身大模型的任务。实验在 RoboDojo 仿真环境里做,同一台双臂机器人、固定初始场景,本地硬件是一张 RTX 5090;输入是三路 RGB 图像、机器人状态和任务指令,GPT 不读取物体的真实坐标或模拟器的隐藏状态,也没有对基座模型做额外训练 6。
三套方案分别是:π0.5,用 RoboDojo 配套的检查点直接预测动作序列,一次预测 50 步双臂动作;GPT-6 Astra(xhigh 档)加逆运动学求解器,由模型看图理解场景、规划目标位置和姿态,逆运动学把目标转成关节动作,每段最多执行 15 步且每段只动一条机械臂;GPT-6 Astra(xhigh)加 cuRobo,由模型提出动作目标,cuRobo 计算关节轨迹并做避障检查,再交给执行层。
| 方案 | 单回合用时 | 成本估算 | 该回合结果 |
|---|---|---|---|
| π0.5 | 8 分 21 秒 | 约 0.14 美元 | 未通过完整成功判定 |
| GPT-6 + 逆运动学 | 49 分 20 秒 | 约 12.76 美元 | 三组中推进最充分,仍未通过 |
| GPT-6 + cuRobo | 34 分 44 秒 | 约 10.63 美元 | 换上 cuRobo 后完成度没有变好 |
三组计时都包含启动、执行和等待 6。桌面整理这个回合,三套系统都停在完整成功判定的门外,作者说 GPT 加逆运动学这一组推进得最充分。
视频之外作者补了一条最新结果:同一个收拾瓶子的场景里,GPT 加逆运动学和 π0.5 都完成了任务并通过审计,用时分别约 23 分 34 秒和 6 分 26 秒;叠碗等任务仍有失败记录,更多场景还在验证。
评论区的追问落在那个时间差上:四十分钟的差距究竟卡在模型推理,还是卡在每段 15 步、单臂执行带来的往返开销。作者对 cuRobo 那组的解释是,模型对 cuRobo 的了解不够、没有加约束,所以系统在任一关节超过约 0.05 的阈值时就开启关节保护 6。
作者在正文里自己交代了两处不对称:两侧的动作接口本来就不同,π0.5 每次预测 50 步双臂动作,两组 GPT 每段最多 15 步且只动一条臂,所以这里比的是整套系统;实验在仿真里完成,场景与回合数都有限。他把结论收在「通用模型已经能承担一部分场景理解和决策工作」这一层。
出题权换个地方:B 站的竞技场
9 月 16 日,B 站上线「AI 无限竞技场」,首期大模型测评榜单同步公布。玩法是规定统一考试科目之外的另一条路:由 UP 主自己出题,把不同模型放进真实场景里比 9。
已经出现的题目包括:UP 主 @Token 就是词元 用「屎山代码」当战场,让 GPT6、Fable 5.1、DeepSeek V4 Pro、GLM 5.3、Kimi K3、Grok 4.6、Gemini 3.7 Flash 等十多个模型同台修代码;UP 主 @吃蛋挞的折棒 用《新三国》的台词、人物、剧情和 emoji 考六个模型接梗;UP 主 @公与山河 把七个模型放进囚徒困境做博弈。首期榜单收录了 DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、Hy 与 MiniMax,排名会实时更新,也持续向全站 UP 主开放报名 9。小红书用户小互在同一天转述了这条消息,写下的理由是「榜上很强,轮到自己的活儿却未必顺手」 10。
今天能核实的只是机制与参与名单:题目由各 UP 主自设,跨题不可比,各场对战的具体结果还没有逐条落在可查的公开记录上。等这些场次的原始材料公开之后,它们才有资格像上面六组一样进入正文。
References
- 1
- 2r/LocalLLaMA:Qwen3.8-27B-NVFP4 开 1M 上下文\
reddit.com
- 3antirez/ds4 提交 1062:跨会话批量解码\
github.com
- 4莫理:实测 Seed-2.1-pro 最新版\
mp.weixin.qq.com
- 5GIS小丸子:视觉模型参数更大反而效果更差\
mp.weixin.qq.com
- 6ooopsnini:GPT6 能取代具身大模型吗\
xiaohongshu.com
- 7NVIDIA 开发者论坛:Ant Ling-3.0-Flash 124B-A5B
forums.developer.nvidia.com
- 8poly:ds4 的跨会话批量解码提交
x.com
- 9哔哩哔哩:B站组了个AI厮杀局,测评题目却越来越离谱
mp.weixin.qq.com
- 10小互:B站推出大模型竞技场排名
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 换掉一个动词机械臂就照做了、43,261 次调用里 39.2% 没思考、65 个免费模型今天只剩 27 个
- 官宣 90.6 实测 77.5、同一个 27B 跑出 121 和 17.9、同一张图 0.006 到 0.211 美元
- Jev 便宜十倍、ZCode 把完整 Git 历史传上云、6 GB 的三元模型跑成死循环
- 15 个版本送同一杯咖啡、3500 人账单涨 60%、一个匿名模型三种出身
- 机械臂涂色盲评、思考 token 砍 58%、“最便宜推理”被扒转包:实测开始核对交付本身
- 从 370 年历史密码到 18 亿 Token 手搓系统:大模型实测跨入底层工程深水区
- 3D 依赖膨胀、HLE 偷翻答案与投机解码虚假提速:大模型实测迎来真实工程大考
- 同题 GTA 较量、双卡推测解码翻转与过度思考代价:大模型实测迎来端到端检验