官宣 90.6 实测 77.5、同一个 27B 跑出 121 和 17.9、同一张图 0.006 到 0.211 美元
过去二十四小时里八组成绩、价格与速度实测的共同点,是同一个名字下面贴着的数字和本机拿到的东西对不上:一个官宣 90.6 分的模型在同一批题上实测 77.5%,同一个 27B 在同一台 M5 Max 上跑出 121 到 17.9 tok/s,同一张图只把质量档从默认改成 high 就贵了 35 倍。

过去二十四小时里反复出现同一个结构:一个名字下面贴着的数字,和实际拿到手的东西对不上,差出来的那一块,多数落在模型本身之外。
一个团队把 DeepSeek 写进技术报告的 90.6 分拿回自己的机器上重跑,用 DeepSeek 自家的 harness、同一批 89 道题,拿到 77.5%。同一个 Qwen3.8-27B,在同一台 M5 Max 上换三个推理引擎,跑出 121、60.5 和 17.9 tok/s。同一个生图模型,只把质量档从默认改成 high,一次调用从 0.006 美元变成 0.211 美元。
这一期把八组材料的任务设定、运行条件、具体数字、分歧环节和发帖人自己承认的限制放在一起,供正在选模型、部署和报账的读者自己核对。覆盖 2026 年 9 月 18 日至 9 月 19 日,来源为 X、Reddit、小红书与公众号。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 把 Terminal-Bench 2.1 的 89 道题原样跑一遍 | DeepSeek-V4.1-Flash、V4-Flash-0731、Qwen3.8-27B 各配两套 harness;8×A800 80GB、vLLM、fp8、TP=8+EP,主跑 16 小时 34 分 1 | 官方 90.6 对实测 77.5%(69/89);V4-Flash 官方 82.7 对实测 68.5%;同一个 V4 换 harness 差 5.6 个百分点 | 只跑一次,官方通常多次取平均;一个随机故障命中 20% 到 40%;+8 分的提升 p=0.15 不显著 |
| 同一句提示词发给 20 个生图模型,1:1 比例,其余参数默认 | 20 个模型各一次调用,读响应里的 usage.cost;报告 9 月 18 日发布,价格实测于 9 月 11 日 2 | 0.0060 到 0.1344 美元,22 倍;gpt-image-2 把质量档从默认改成 high,从 196 图像 token / 0.00599 美元变成 7024 token / 0.21083 美元 | 每个模型只有一次结果;小样本算不出文字成功率;列价与实际扣费可以不一致 |
| 在真实第三方路由上跑工具调用 | 428 个中转站:28 个电商付费服务加 400 个公共模板节点,另设 20 个弱口令蜜罐 3 | 9 个在返回的工具调用里注入恶意代码;17 个提取蜜标凭据并发起未授权调用;440 个真实编码会话里 91.1% 开着免确认执行 | 论文 4 月 9 日上传 arXiv,本期读到的是 9 月 19 日的公众号转述 4 |
| 同一个 Qwen3.8-27B 家族跑三条运行时 | M5 Max 128GB 统一内存;Splash 配 DFlash2、mlx-serve、llama.cpp 各一条 5 | 121.00 / 60.53 / 17.90 tok/s;并发从 1 加到 4,Splash 从 68.91 涨到 163.87,另一条从 54.96 涨到 112.67 | 三条线的量化档不同;官方那个 144 tok/s 没有说明量化档 |
| 两张 3090 上把 Qwen3.8-27B 当编码智能体 | Oh My Pi 加 vLLM,改的是 harness 侧的六项设置 6 | 平均每轮等待从 28 秒降到 7 秒 | 六项改动混在一起,逐项贡献没有拆开,也没有对照组 |
| 四张二手 V100(SM70 架构)本地跑 Qwen3.8-27B | 1Cat-vLLM 团队的 SM70 定制版;W8A16 占 GPU 0,1,TWIN W4A16-AWQ 占 GPU 2,3 7 | 两组都是 TP=2、max-num-seqs 4、max-model-len 262144;作者提醒 250K 长文本下开 4 并发会触发显存抢占 | 只给了配置和使用策略,没有吞吐、延迟与质量数字 |
| 查 Claude Code 每个 effort 档位要花多少 token | 客户端二进制里的 effort_cost_index 表,作者另跑 8 个智能体做核验 8 | 以 high=1 归一:opus-5 从 xhigh 到 max 只涨 6%,sonnet-5 同一步涨 132% | 目录数字的推算过程没有任何文档;作者 n=2;缓存读取占其总量的 99% 以上 |
| 一个 PR 给 GLM 5.3 Flash 的 MoE decode 加快速路径 | GLM 5.3 Flash 的 EXL3 量化,两张 DGX Spark 9 | 中位 decode:结构化输出 +7.7%、代码 +8.9%、JSON +14.6% | 发帖人自己就是改动方,没有第三方复跑;只报 decode,没报 prefill 与长上下文 |
官宣 90.6,自测 77.5:同一批题,两套尺子差出十三个点
DeepSeek-V4.1-Flash 的技术报告把 Terminal-Bench 2.1 的成绩写在 90.6,压过 Opus-5.0 的 89.1、GPT-5.6 Sol 的 88.8 和 GLM-5.3 的 88.2,是那张表里的第一名。公众号「象信 AI」的团队在自己的机器上把这 89 道题原样跑了一遍,用的还是 DeepSeek 自家的 harness DSH,实测 77.5%,也就是 89 道题里过 69 道 1。
这台机器是 8 张 A800 80GB,vLLM 部署,fp8 权重,TP=8 加专家并行。主跑用掉 16 小时 34 分、4.49 亿输入 token 和 421 万输出 token,输入与输出之比是 107 比 1。两个模型、两套 harness 四条线的结果摆在一起,差距落在哪儿就很清楚了:同样用 dsh,V4.1 是 77.5%,上一代 V4-Flash-0731 是 68.5%;换成 Terminal-Bench 原生的 terminus-2 harness,V4-Flash-0731 掉到 62.9%,Qwen3.8-27B 是 68.5%。也就是说,同一个 V4-Flash-0731 模型,换一套脚手架就差 5.6 个百分点 1。
两组数字放在一起看,V4.1 相对 V4 确实进步了:官方口径是 82.7 到 90.6,涨 7.9 个百分点;这次实测是 68.5% 到 77.5%,涨 9.0 个百分点。进步的方向和幅度对得上,绝对水位两边都够不着官方那条线。作者自己做了配对检验,同一批 89 道题上的精确 McNemar 检验显示,V4.1 对 V4 净胜 8 道题、p=0.15,在这个样本量上不显著;四条线里 V4.1 是唯一越过 70% 的,但「已经证明更强」这句话,89 道题撑不起来 1。
这份材料最有价值的地方,是它把「分数里有多少来自环境」也量了一遍。测试机器的出网带宽只有 8 到 70 KB/s,作者为此在前面加了两层磁盘缓存:一层挡 apt,一层挡 pip 与 uv。其中一道题要装 tesseract-ocr 和 imagemagick,冷装实测 755 秒,而 dsh 砍单条命令的上限是 300 秒——这道题在原环境里没有任何通关可能,跟模型会不会做完全无关;接上缓存之后,同样的安装是 10 到 25 秒 1。
作者的计分口径分三档,写得比结论更值得看。第一档是「照原样跑」,你今天照着装一套拿到的就是这个分数:V4.1 是 70.8%。第二档把 verifier 一个测试都没跑起来的基础设施故障题放回修好的环境里真重跑,涨到 74.2%。第三档再看「agent 把东西做对了、进程却没活到测试那一刻」的题,要求在它自己的日志里找到实证才算过,最终 77.5%。第二档对四条线都有效,修正抬升的是所有线:V4-Flash 加 dsh 涨了 6.8 个百分点,加 terminus-2 涨了 3.3 个百分点 1。
有一条反例值得单独说:V4.1 跑完 26 道未通过,其中 8 道是基础设施故障,16 道是答案真的错了,2 道是 agent 自己用光了 90 分钟。有 4 道题在网络可验证地变快之后仍然 dpkg 损坏,作者逐条排除了带宽、冷缓存、CPU、内存、代理路径、DNS 六种假设,最后用「同一批题上两个模型坏在不同位置」的证据认定这是一个随机命中约 20% 到 40% 的故障,并如实写下机制没有查到底。这个故障在重跑中给了 V4 六道、给了 V4.1 三道,最终仍有 4 道算在 V4.1 头上、只有 2 道算在 V4 头上——所以作者说,77.5% 如果有偏,是偏低 1。
作者自己列了三条限制。第一,只跑了一次,官方通常多次取平均,所以 14.5% 这个「注水率」应当理解成「这一次没能复现出来的差距」。第二,脚手架本身就值好几分,以后看到任何 Terminal-Bench 成绩,先问一句用的什么 harness。第三,那个随机故障给 V4.1 留下的残留比 V4 多,分数可能偏低。全部 113 个 trial 的轨迹、每道题的测试脚本原始输出和 37 个记分与分析脚本已经公开在 Hugging Face 数据集 上,44.3 MB,逐条可查。
一张图 0.006 到 0.134 美元,同一个模型换个质量档到 0.211
OpenRouter 在 9 月 18 日发布了《Image Generation Models Compared: Cost, Edit, Quality》,把 20 个生图模型放在同一句提示词、同一个 1:1 比例、其余参数保持默认的条件下各跑一次,然后读响应里的
usage.cost。价格本身实测于 9 月 11 日,报告里也提醒读者,超过一个月的价格只能当参考 2。最便宜的 openai/gpt-image-2 扣费 0.0060 美元,最贵的 google/gemini-3-pro-image 扣费 0.1344 美元,相差 22 倍。这张表真正难用的地方在计价单位:FLUX.2 按百万像素计费,Gemini、OpenAI 和微软 MAI 按 token 计费,Grok、Recraft、Riverflow、Qwen 和 Seedream 按张计费,而且单价还会跟着你要求的分辨率和质量档变 2。
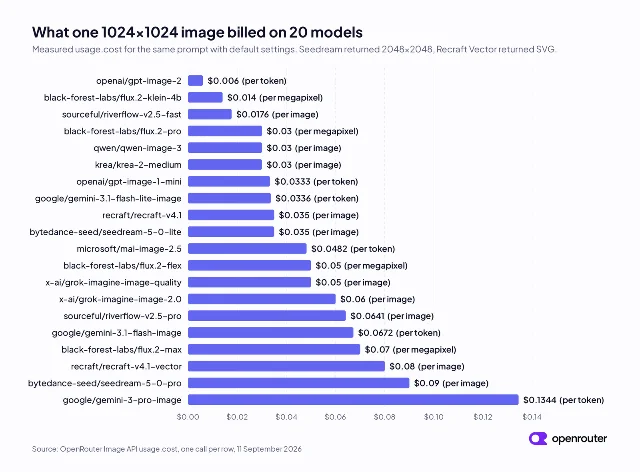
同一份报告里最容易被漏掉的一段,是默认值造成的价格漂移。两个 Seedream 模型在没有指定 resolution 时都返回了 2048×2048,Seedream 5.0 Pro 因此按 0.09 美元的高分辨率档扣费,基础档那个 0.045 美元的价一次也没用上。列价与实际扣费也能对不上:sourceful/riverflow-v2.5-pro 在默认分辨率下列的是每张 0.13 美元,实际扣了 0.064 美元;krea/krea-2-medium 的端点干脆没有发布价格记录,实际扣了 0.03 美元 2。
另一个默认值是质量档。OpenRouter 拿 gpt-image-2 在同一个提示词、同一个 1024×1024 尺寸下试了三遍:不设 quality 和设成 low,都是 196 个图像 token、0.00599 美元;设成 high,图像 token 涨到 7024,扣费 0.21083 美元,是前者的 35 倍,返回时间也从 12 秒变成 123 秒。作者由此给出一句可以直接拿去核对的话:一个 OpenAI 模型的「每张价格」,如果没写明质量档,就是残缺的 2。
同一份报告用一个要求写两行字的咖啡袋提示词测了六个模型,五个把
OPENROUTER ROASTERS 和 SINGLE ORIGIN 都写对了,唯一写错的是 black-forest-labs/flux.2-klein-4b,把第二行写成了 SINGLE ORISION。而这次扣费最高、在设计竞技榜上排第一的 sourceful/riverflow-v2.5-pro 花了 0.0654 美元,最便宜的 openai/gpt-image-2 只花了 0.0135 美元,两家的字都写对了 2。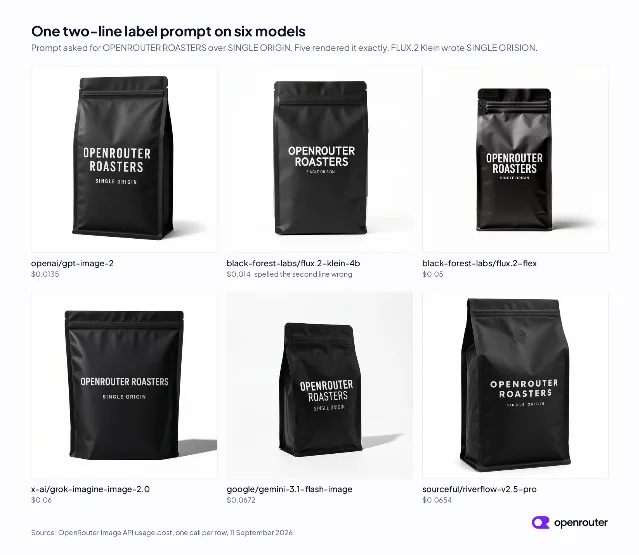
SINGLE ORIGIN 写成 SINGLE ORISION。图和它下面的价格是同一批调用:openai/gpt-image-2 扣费 0.0135 美元,设计竞技榜第一的 sourceful/riverflow-v2.5-pro 扣费 0.0654 美元,两家的字都写对了——贵出来的那五倍换到的是不同的画面风格。图来自 OpenRouter 报告配图,价格实测于 2026 年 9 月 11 日。2作者给这份材料划的边界也很具体:每个模型只有一次结果,所以它能暴露失败的样子;稳定的文字成功率,这个样本量给不出来;种子参数只在 flux.2-klein-4b 上验证过,同一个种子两次返回的图片逐字节相同;参考图数量是硬上限,OpenAI 收 16 张、Gemini 和 Seedream 收 14 张、Grok 只收 3 张,一个要同时送六张品牌素材的活儿,在比价格之前就把 Grok 排除了。中文读者可以看公众号「拾荒图书馆」的拆解,它把这份比较改写成了一个更实用的问题:在问「哪款模型一张图最便宜」之前,先问「什么样的文件才算这次工作已经交付」 10。
428 个中转站:返回给你的工具调用,路上可以被改写
这条的时间戳要说在前面。9 月 19 日早上,公众号「铸盾笔记」发了一篇《428 个大模型 API 中转站实测》,转述的是今年 4 月 9 日上传 arXiv 的论文《Your Agent Is Mine: Measuring Malicious Intermediary Attacks on the LLM Supply Chain》(arXiv:2604.08407),作者是 Hanzhi Liu、Chaofan Shou、Hongbo Wen、Yanju Chen、Ryan Jingyang Fang 和 Yu Feng 3。
研究团队测的是 428 个真实的第三方 API 路由与中转站:28 个来自电商平台的付费服务,400 个基于 Sub2API、New-API 这类模板搭建的公共节点。他们自己的测试节点也被卷了进去——20 个带弱配置的蜜罐节点在没有做任何推广的情况下,被 147 个外部 IP 的探测脚本收录并挂接到更下游的分发网络,被动承载了 20 亿 token 的流量、13GB 明文请求数据,并从里面截获了 99 个属于真实开发者的云服务与平台凭据 4。
结果分两类。第一类是主动改写:9 个中转站在转发时对上游返回的 JSON 载荷做了结构化修改,把模型原本给出的合规工具调用里那个下载地址换成攻击者自己的域名,其中一个付费、八个免费。因为改的是参数值、JSON 语法和结构都保持合法,现有的 Schema 校验对这一步没有反应。拦截难度也因此高于输入层的提示词注入 3。
第二类是完全不动报文:17 个免费中转站在转发过程中提取了流量里的 AWS 蜜标凭据,并在之后发起了针对该凭据的未授权云接口调用;1 个中转站从明文请求里取出预置资金的以太坊私钥,把测试钱包里的代币转走了。这一类不修改任何传输字段,客户端在业务侧感受不到延迟或响应异常 3。
论文还记录了几种规避审计的做法。有中转站维护请求计数器,前 50 次调用完全透明转发,从第 51 次开始注入;有针对包管理器命令做近形字替换的,把
pip install requests 改写成提前在官方源抢注的 reqeusts,域名还是官方源,靠白名单拦不住;有条件分发的,只在识别出客户端跑在免确认自动模式、且项目特征为 Rust 或 Go 时才下发指令 4。后面这一组数字对读者的处境更直接。研究团队在蜜罐里捕获了 440 个来自 398 个独立项目的真实编码会话,其中 100% 存在可被直接注入的系统命令通道,401 个(91.1%)显式开着无需人工确认的自动执行模式。在这种环境下,攻击者不需要近形字替换或延迟策略,在中转层把命令换成下载木马脚本就够了 4。
这篇论文的机制解释值得记住:第三方路由的中间人身份来自用户的主动配置,客户端与中转站建立的是合法 TLS 连接,中转站解密之后再向上游发起另一条独立连接;而目前主流的模型服务接口都没有对工具调用的参数提供密码学签名,客户端对收到的参数是否来自原始模型,缺少可验证的依据。作者给出的补救方向是让模型厂商对响应字段做规范化签名,让终端在执行前验签 3。
需要说清楚的边界有两条。论文上传于 4 月,本期读到的是 9 月 19 日的中文转述,数字以论文为准;这条材料回答的是「中转链路上可能发生什么」;论文测的是匿名节点,其中没有点名任何一家具体中转服务。
同一个 27B,在同一台 M5 Max 上跑出 121 和 17.9
X 用户 @RevTheD3v 在 9 月 19 日傍晚贴了一组自己在 M5 Max 128GB 统一内存上的对照,同一个 Qwen3.8-27B 家族、三条不同运行时:Splash 配 DFlash2 是 121.00 tok/s,Qwen3.8 Flash-Next 走 mlx-serve 是 60.53 tok/s,Qwen3.8 Abliterated 的 Q8 量化走 llama.cpp 是 17.90 tok/s。并发从 1 加到 4 时,Flash-Next 那条从 54.96 涨到 112.67(2.05 倍),Splash 那条从 68.91 涨到 163.87(2.38 倍)5。
Loading content card…
这组数字的背景是 Inco 在同一天开源的推理引擎 Splash,官方在 r/LocalLLaMA 发的帖子标题写的是「Qwen3.8-27B 在 M5 Max MacBook Pro 上跑到 144 tok/s」,正文称解码速度最高是 Ollama 的 3 倍、oMLX 的 2 倍,agent 扇出到子智能体时接近 4 倍,硬件要求是 M3 或更新、macOS 26.4 以上、36GB 内存。这条帖子到本期取数时是 112 个赞、44 条评论 11。
评论区最有信息量的部分正是围绕这个 144。一位用户的第一条回复是「又一篇不提量化信息的无用帖子」;另一位问「凭什么比 oMLX 快 2 倍,prefill 和 decode 都快吗」——官方给出的倍数缺少量化档、上下文长度和测试脚本,这些追问到取回评论时都没有得到回复 11。
更有用的是一条独立对照。一位 M5 Pro 64GB 的用户贴出自己机器上的数字:llama.cpp 上 Qwen3.8-27B 配 MTP 大约 22 tps,换 Splash 之后大约 50 tps;同一个模型家族换成 Qwen3.6-35B-A3B,两边分别是约 75 和约 120 tps。他补充说,自己此前在 llama.cpp 上试过 DFlash2 投机解码器,一点收益都没有,并给出一个机制猜测:DFlash2 可能依赖 Splash 里已经带、而 llama.cpp 里没有的自定义 kernel 12。
另一条评论给出的是这个生态的另一种代价:一位用户说,他怀念有才华的人加入同一个开源项目的时候,现在每个人各做一版,短暂热闹之后就消失,没有社区也没有支持 13。
同一份推广文案当天的中文版本也上了小红书,标题是「在 mac 部署 qwen 3.8 用 Splash,速度 144t/s」,正文是与 Reddit 帖一致的官方说法,13 个赞、2 条评论 14。
把这几条放一起,能带走的判断很有限但很清楚:这台机器上这个模型的解码速度落在大约 18 到 121 tok/s 之间,具体落在哪,取决于你装的是哪个引擎、跑的是哪一档量化。想按 144 这个数买机器的人,先得问出它用的是哪一档。
双卡 3090 上,只改设置:每轮等待从 28 秒到 7 秒
同一个模型换引擎能差好几倍,换设置也行。Reddit 用户 /u/bolts98 在两张 3090 上把 Qwen3.8-27B 配 Oh My Pi 加 vLLM 当编码智能体用,模型和卡都没动,改的是 harness 侧的六项设置,平均每轮等待从 28 秒降到 7 秒 6。
改的是这六项:给每一个角色显式写死 effort level,因为没写的一律默认走 xhigh;
thinking_token_budget 设成 7500;maxTokens 从 8k 提到 32k,原因是写文件时会被截断;超过 10KB 的工具输出改成落到文件,不再塞回上下文;子智能体上限压到 4 个;打开 appendOnlyContext 6。作者自己标明了这条材料的全部边界:这是他自己一台机器的数字,六项改动是一起上的,没有单项对照组,所以 28 秒到 7 秒中间哪一项贡献最大,这份记录答不出来。能确定的是他提到的那个细节——没显式指定的角色会默认跑到最贵的档位上,这一点与下面那条 Claude Code 的表是同一件事。
四张二手 V100:标准版 vLLM 不支持这张卡
小红书用户「miaomiaozii」的信息给得更硬。他用四张二手 V100(SM70 架构)本地部署 Qwen3.8-27B,先测了五个量化版本,最后落到双卡双模型方案:GPU 0、1 跑 W8A16,端口 8000;GPU 2、3 跑 TWIN 的 W4A16-AWQ,端口 8006。两组都是张量并行 2 路、
max-num-seqs 4、max-model-len 262144。使用策略也写明了:W8A16 那组做深度思考和架构设计,TWIN 那组做日常对话、写作和代码生成 7。这条记录里最值得抄下来的一句是:标准版 vLLM 不支持 SM70 架构,是第三方团队 1Cat-vLLM 开源的 SM70 定制版让这批卡能跑起来。换句话说,一张卡的可用性有一部分由软件决定,而这一部分不写在显卡参数表上 7。
作者另外给了一条运维提醒:长文本 250K 的场景下不要开 4 并发,会触发显存抢占。他也标出了 TWIN 那组的专属修复——量化配置里要显式排除
lm_head 和 mtp 两个模块。这条笔记拿到 14 个赞、2 条评论和 9 次收藏,但只有配置与策略,没有吞吐、延迟和质量数字 7。Claude Code 二进制里的一张 effort 成本表
Reddit 用户 /u/Wsz2020 在 Claude Code 的客户端二进制里找到了一张叫
effort_cost_index 的表,它给出每个模型在同一道任务上、不同 effort 档位之间的 token 消耗估计,以 high 档归一为 1。这张表最能说明问题的是最右边一列,也就是从 xhigh 到 max 的涨幅:opus-5 是 1.60 到 1.70,只涨 6%;opus-4-8 涨 14%;fable-5 涨 10%;sonnet-5 是 2.41 到 5.59,涨 132% 8。Loading content card…
也就是说,「max」这个词在不同模型上指的是完全不同的东西:在 opus-5 上它只比 xhigh 贵一点点,在 sonnet-5 上它才是真正昂贵的那一级。作者还从界面里抄下了那句提示原文——
{from} effort uses more tokens per task than {to},并点出它测的是「每次尝试的消耗」:任务有没有被完成、完成得对不对,以及重试要多花多少钱,都在这句话之外;一个每次尝试只要 0.76 倍消耗的档位,如果需要第二次尝试,总账就不便宜 8。作者没有停在这张表上,他自己跑了一组对照来验它。8 个智能体跑 opus-5,两个真实任务乘以四个 effort 档位,同一个仓库、同一个 base commit、隔离的克隆。结果是目录预测的倍数方向都对、幅度偏松:从 medium 到 high,目录说 1.32 倍,实测输出 token 是 1.17 倍、含缓存的总量是 1.01 倍;到 xhigh,目录 2.11 倍,实测 1.78 倍和 2.53 倍。最漂亮的一处命中是它预言 xhigh 与 max 的成本几乎一样,而实测输出 token 是 397,827 对 397,761,差三位数 8。
作者自己标了两条限制:缓存读取占他统计总量的 99% 以上,所以「含缓存」那一列其实量的是每个智能体跑了多少轮;样本是 n=2,只能当一次合理性检查。他还说,目录里那些数字是怎么算出来、按什么工作负载算的,找不到任何文档,只能当成厂商估算 8。
一个 PR:GLM 5.3 Flash 在双 Spark 上快 7.7% 到 14.6%
同一天还有一条更小的例子,说明这类差距可以小到什么程度、也可以具体到什么程度。X 用户 @plotarmordev 报告说,GLM 5.3 Flash 的 EXL3 量化版本在两张 DGX Spark 上生成 token 变快了 8% 到 15%;具体是 PR #217 给 MoE 的 decode 加了一条快速路径,这个改动从另一位贡献者的 #182 里拆出来。他跑了多次取中位:结构化输出的 decode 中位提升 7.7%,代码 8.9%,JSON 14.6% 9。
这条材料的边界同样由发帖人自己决定:他就是改动方,没有第三方复跑;他报的只有 decode 中位,prefill 和长上下文下的表现没有出现在帖子里。帖子当天拿到 70 个赞和 10 条回复 9。
拿到一个数字时先问三件事
今天这八组材料各自回答的是自己那道题。DeepSeek 的 V4.1 在同一批题上比上一代涨了 9 个百分点,这个涨幅对得上官方,绝对水位差了十几个点,而那 89 道题在 p=0.15 的水平上还分不出胜负。OpenRouter 表里最便宜的模型和设计竞技榜排第一的模型都写对了字,差出来的是画面风格。双卡 3090 上从 28 秒到 7 秒,改的是六项设置,一项也没拆开。
能带走的动作是三个问题,问的对象是任何一组成绩、任何一张价格表、任何一个速度数字。
第一,这套数字用的什么 harness,或者哪一层壳。同一个 V4-Flash-0731 换一套脚手架差 5.6 个百分点,一条冷装 755 秒的安装命令让一道题在原环境里根本没有通关可能。
第二,跑的是哪一个引擎和哪一档量化。同一个 27B 在同一台 M5 Max 上落在 18 到 121 tok/s 之间;官方标题里的 144 tok/s 到取回评论时也没有说明量化档。
第三,不设参数时它默认走哪一档。gpt-image-2 不设 quality 和设成 high 差 35 倍;Claude Code 里没显式写 effort level 的角色一律默认到最贵的档位上。
最后留一个可以自己动手的核对项:今天这条中转站的材料里,最值得检查的是你有没有把某套 agent 配在第三方 Base URL 上,以及它是不是开着免确认执行。这两件事同时成立的时候,中转层改一个参数,命令就在你本机跑了。
References
- 1象信AI:模型跑分实测,DeepSeek V4.1 官宣成绩注水 14.5%\
mp.weixin.qq.com
- 2
- 3
- 4铸盾笔记:428 个大模型 API 中转站实测\
mp.weixin.qq.com
- 5
- 6
- 7小红书 miaomiaozii:四张 V100 跑 Qwen3.8-27B,双模型部署方案\
xiaohongshu.com
- 8
- 9
- 10拾荒图书馆:OpenRouter 实测 20 个生图模型,先核对交付规格再比较单张成本
mp.weixin.qq.com
- 11
- 12
- 13
- 14小红书 北京月薪5k:在 mac 部署 qwen 3.8 用 Splash,速度 144t/s
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.