机械臂涂色盲评、思考 token 砍 58%、“最便宜推理”被扒转包:实测开始核对交付本身
本期实测覆盖同一台机械臂上 Fable 5.1 与 GPT-6 Astra 的涂色盲评、思考 token 减少 58.3% 的 Qwen3.8-27B 后训练版、DeepSeek-V4.1-Flash 四种硬件组合的部署上限、同一件 PFC 工况跑两条 AI 路径的 90 分钟对 50 分钟,以及“全球最便宜推理”被查出转包到更小模型的始末。

过去 24 小时里,几条跨平台的实测把判断的依据挪到了同一个地方:决定结论的,是模型跑完之后留在地上的东西——纸上真实的笔迹、一份跑了十轮的基准表、四种显卡组合的部署参数、一批在过程中就落盘的中间结果,以及一串能被重新跑一遍的接口指纹。
本期覆盖 2026 年 9 月 14 日至 9 月 15 日,来源为 X、Reddit、小红书与公众号。
五组实测总览
| 任务 | 测试对象与条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 同一台机械臂上的涂色 | Claude Fable 5.1 与 GPT-6 Astra,SO-101 机械臂,把编号方框涂满单色 1 | 122 条评论盲评,社区判 Bot B 胜 | 发帖人未公布 A、B 分别对应哪个模型;每边只跑一次 |
| 思考 token 压缩版 Qwen3.8-27B | Swift-Qwen3.8-27B 对比原版,BF16、xhigh 档,九项基准各跑 5 次 2 | 思考 token 中位数降 41%,速度 ×1.95,多数基准精度损失小于 1% | AIME 2026 回退 4.6%;训练细节部分未公开 |
| DeepSeek-V4.1-Flash 的部署上限 | 8×H20、4×H200、8×H200、8×H100 80GB 四组配置 3 | 4×H200 跑满 1M 上下文;8×H20 下 256K 上下文、理论并发约 89 路 | 部署工具方自测,只给出能跑多大,未给吞吐与延迟 |
| 同一件 PFC 工况跑两条 AI 路径 | Trae + doubao-seed-evolving 对 Claude + deepseek-flash,同一段提示词 4 | 90 分钟、约 1.82 元 对 50 分钟、1.20 元 | 两侧算例规模与接触模量不同,作者声明只作过程对照 |
| “全球最便宜推理”的真实路由 | CrofAI 的二十余个模型被逐个探测 5 | 请求 kimi-k3 实际由 GLM 5.3 Flash 服务,输出侧加价 20 倍 | 依据是 OpenRouter 的工具与响应指纹,属间接证据 |
同一台机械臂上,两种落笔方式
9 月 8 日,X 用户 @cdngdev(简介写着 20 岁、在斯坦福、在 OpenAI 做机器人)把一支画笔和一台摄像头交给 GPT-6 Astra,让它直接控制 SO-101 机械臂,在真实纸张上画金门大桥。他在帖子里说,模型自己摸索出了怎么控制这台机器,一次比一次画得像 6。SO-101 是 Hugging Face LeRobot 项目里那台可以自己打印出来的开源机械臂,套件价格大约 150 美元 7。
Loading content card…
六天里这条帖子被反复复现。9 月 14 日,Hugging Face 的 @mishig25 把同一个实验搬进 MuJoCo 仿真,让 Astra 用 SO-101 画埃菲尔铁塔 8;9 月 15 日,@EricMao06 用 real2sim2real 的方式教同一台机械臂画画,说它从周五画不出连贯图形,到周日已经画得比他本人好 9。
真正把两个模型摆在一起的是 Reddit r/ClaudeAI 上的一条帖子。发帖人 /u/KungRaLeo 把任务从“照着图临摹”改成了“把编号方框涂满同一种颜色”,同一台机械臂、同一套流程,分别交给 Claude Fable 5.1 和 GPT-6 Astra 各跑一次,然后把两张纸并排拍下来,标题只问了一句:哪个画得更好 1。他自己在正文里说,两个模型把方框填满的完成度差不多,真正有得聊的是“哪个做得更好”。
Loading content card…
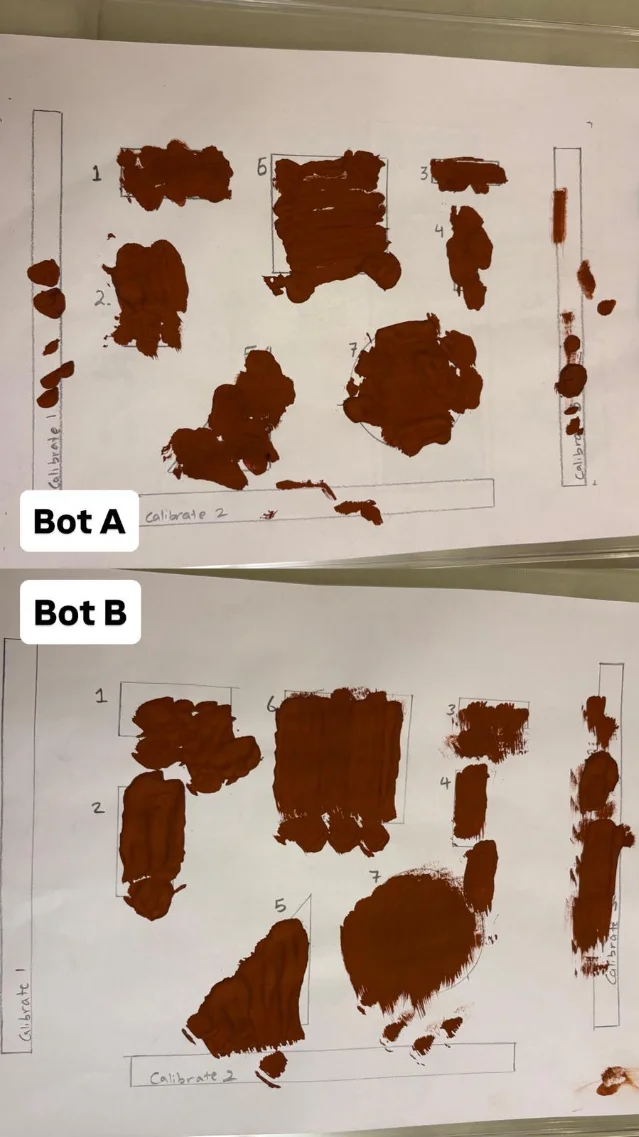
评论给了这场盲评一个具体结论。帖子攒到 122 条评论时,子版的自动小结写道:社区把 Bot B 判为胜者,理由是笔触更干净、边缘更利落、更像人画的,代价是覆盖面更小,还漏掉了一个方框;Bot A 被认可的地方是覆盖更满、更少出界,但它的补法被形容成“戳点”式的,显得笨 1。也有评论注意到,两台机械臂都只会横着涂或竖着涂。
到讨论结束时,发帖人仍然没有揭底哪一台是哪个模型,两种猜测在评论里都有不少人支持。这条实测因此能回答的问题只有一层:这两张纸里哪张更工整。它回答不了哪个模型更强——每边只跑了一次,任务被压成了单色填充,底色还引来了不少吐槽。
思考 token 少了一半上下,精度只丢不到 1%
第二组来自 Reddit 的 r/LocalLLaMA。一个叫 UkisAI 的团队把 Qwen3.8-27B 做了一遍后训练,起点是本地跑量化版本时反复出现的推理打转。他们绕开了直接压缩推理长度的做法,先找出与“想太多”相关的 token 并对它们加惩罚,再用 on-policy distillation 之类的办法把精度补回来 2。模型与评测记录都已公开 10。
作者给出的整体数字是思考 token 减少 58.3%、速度提升到 1.95 倍。逐项看,xhigh 档平均减少 41%,降得最多的一项是 GPQA-Diamond 的 58%。
九项基准的对照如下,两项都在 xhigh 思考档、BF16 精度下各跑 5 次,思考 token 取中位数 2。
| 基准 | Qwen3.8-27B | Swift-27B | 思考 token 变化 |
|---|---|---|---|
| GPQA-Diamond | 88.4% | 88.3% | 减少 58% |
| LiveCodeBench v6 | 76.8% | 81.6% | 减少 46% |
| Terminal-Bench 2.1 | 66.7% | 65.8% | 减少 39% |
| MMLU-Pro | 85.5% | 85.0% | 减少 28% |
| C-Eval | 90.0% | 90.6% | 减少 19% |
| IFBench | 73.5% | 71.8% | 减少 51% |
| AIME 2026 | 98.7% | 94.0% | 减少 50% |
| HMMT(2025 年 11 月) | 99.3% | 96.0% | 减少 46% |
| ERQA(视觉) | 67.5% | 66.3% | 减少 55% |
LiveCodeBench 上那 4.8 个百分点被作者自己标注为默认截断造成的,不算性能提升。再看一个更细的对照:GPQA-Diamond 的 198 道题各跑 5 次,原版在 xhigh 档拿 88.4%,中位数用掉 6,642 个思考 token;压缩版拿 88.3%,中位数只用 2,771 个;而原版降到中档只有 84.1%,也要用 1,753 个。压缩版用不到一半的 token 保住了 xhigh 档的分数,同时比原版中档高出 4 个百分点。
作者点出的问题也很直接:AIME 2026 从 98.7% 掉到 94.0%,他们追到了一个训练 bug——一个与数学推理相关的 token 被误罚,会在下个版本修。中等和低思考档同样省 token(23% 与 26%),但精度掉了 1% 到 4%,还需要更多测试。许可证不是 Apache 2.0,只对年收入 100 万美元以上的公司设限。团队正在做 Flash Next 版本,目前做到减少 30% 思考 token。
DeepSeek-V4.1-Flash:四种硬件组合各自能跑多大
小红书上的 GPUStack 在 DeepSeek-V4.1-Flash 发布当天,用它自己的部署工具在四组真实配置上跑了一遍 3:
- 8 张 H20:256K 上下文,理论并发约 89 路;
- 4 张 H200:跑满 1M 上下文;
- 8 张 H200:1M 上下文,并发余量更充足;
- 8 张 H100 80GB:把 KV Cache 卸载到主机内存,实现 384K 上下文。
除了配置上限,帖子里还留了四条经验:4 张 H200 就能部署这个 552B 的模型;原生多模态开箱可用;DSpark 投机解码能明显提升输出速度;8 卡 H200 高负载下,显存利用率建议从 0.96 降到 0.92。
这份实测的边界同样清楚:它出自部署工具方自己,报告停在“能跑多大”这一层,吞吐与延迟数字缺席;“理论并发约 89 路”是配置推算出来的,不是压测结果。
同一件活跑两遍:90 分钟和 50 分钟
公众号「超级大的 Lobby」做了一次单变量对照。提示词只有两句话,一句描述工况(做一个基坑开挖算例,地基是长方形,顶部再挖一个区域,计算收敛),一句要求交付物(整理一份 HTML 报告,显示相关数据和图像)。同一段提示词交给两条路径各跑一遍:A 是 Trae 加 doubao-seed-evolving,B 是 Claude 加 deepseek-flash,全程无头运行,人只出现在起点和终点 4。PFC 是 Itasca 的颗粒流数值模拟软件,这次两家跑的都是 PFC2D 的基坑开挖。
| 环节 | A:Trae + doubao | B:Claude + deepseek |
|---|---|---|
| 模型生成 | 30 分钟 | 20 分钟 |
| 模型优化 | 20 分钟 | 25 分钟 |
| 报告生成 | 40 分钟 | 5 分钟 |
| 合计耗时 | 90 分钟 | 50 分钟 |
| 折合成本 | 82 积分,约 1.82 元 | 1.20 元 |
差距几乎全落在报告生成那一行:40 分钟对 5 分钟。作者的解释是,B 路径在生成和优化阶段就把颗粒场 CSV、沉降曲线、位移场和收敛曲线都落了盘,最后一步只是把文件读出来套进 HTML 模板;A 路径的报告是收尾时补出来的。这也让交付物的成色跟着分岔:A 侧给的是 8 张 KPI 卡加 7 个章节,把成样、开挖、收敛三个阶段联排;B 侧的结论卡开头就是判据,数字由日志与 CSV 实时解析得出。
排错过程两边也值得对照。A 路径出了两处错——FISH 变量没加中括号、函数被
model restore 冲掉,两处都是它自己定位、自己改对的;B 路径的脚本链一次写对,但仍然在模型优化上花了 25 分钟调参数、看收敛。作者把分界线下在“有没有去掉 worker 层级的人工参与”上,他的判断是:报错属于循环里普通的一圈,人只要在起点定目标、终点验收结果。作者明确声明了这个对比的限制:两侧算例规模不同,A 侧 20×10 米、约 3,200 颗粒子,B 侧 40×20 米、约 9,400 颗粒子,接触模量还差 4 倍,所以时间与成本只作过程对照,不作优劣。
“全球最便宜推理”被扒:卖给你的和跑的不是同一个
9 月 13 日,独立开发者 KTibow 发布了一篇标题直接叫《CrofAI is an OpenRouter wrapper》的博客。他发现 CrofAI 的接口接受 OpenRouter 的 advisor 工具,而 OpenRouter 是一家聚合多家模型接口的中转平台,这类工具出现在一个自称自建推理的服务商身上并不寻常。他顺着这个指纹把 CrofAI 的模型逐个探了一遍,结论是:CrofAI 会把你请求的模型静默换成更便宜或更弱的模型 5。
替换清单很具体:
deepseek-v4-pro-0813、glm-5.3-flash、glm-5.2、qwen3.8-27b、kimi-k2.6、kimi-k2.7-code、mimo-v2.5-pro 等 12 个模型被路由到 DeepSeek V4 Flash 0731;kimi-k3、glm-5.3、glm-5.1 被路由到 GLM 5.3 Flash;号称自研的 greg 家族里,greg-2-ultra 指向 GLM 5.2,greg-1-mini 指向 Qwen3.5 9B,greg-2-super、greg-1、greg-1-super 指向 Kimi K2.7 Code 5。Reddit 上的汇总帖按售价与实跑模型算了一笔账:kimi-k3 按每百万 token 输入 2 美元、输出 10 美元售卖,实际由 GLM 5.3 Flash 服务,输入侧是 13.3 倍,输出侧 20 倍 11。给机会的过程也被完整记录了下来。作者前后留了五次窗口,每次更新之后重新探测,结果都是同一批模型继续走 OpenRouter,变化只发生在 OpenRouter 的指纹被越抹越干净 5。最后一次是在“所有 fallback 已关闭”的前提下,
deepseek-v4-flash-vision-exp 仍然下载了带 OpenRouter 标识的图片,几个模型返回的还是 OpenRouter 的 gen- ID。另外两处说法也对不上。CrofAI 称自己在 Vast 租的 RTX PRO 6000 上跑 Kimi K3,而这个模型即使用 Q2_K 这种极端量化也需要约 802GiB,Vast 上最大的机器是 8 张卡、共 765GiB;它还说过要为了排查问题,把
deepseek-v4-flash-0731 放到本地的 DGX Spark 上运行,而 Spark 只有 128GB 内存,该模型权重 167GB,它宣传的 Q8_0 版本要 323GB 11。三次不同时间的探测记录都以 attestation 的形式留在 GitHub 上,挂在同一个 commit 下,可以自己跑一遍 12。Reddit 帖记录的时间线是:CrofAI 在曝光后宣布关站并承诺退款;9 月 15 日凌晨约 4:30(UTC)出现一篇冒用“团队”口吻的帖子,称创始人的说法是在压力下写的,两周后恢复服务;几小时后
nahcrof.com 与 crof.ai 都返回 404,推特账号被删,子版设为私密 11。这条实测的限制要一起看:探测依据是 OpenRouter 的工具与响应指纹,属于间接证据;CrofAI 的代码库没有公开,外部无法直接查看路由配置。当事人的辩解与作者的结论并不一致,能复核的部分是那些可以重跑的探测记录。
References
- 1r/ClaudeAI 机械臂涂色对比帖\
reddit.com
- 2r/LocalLLaMA Swift-Qwen3.8-27B 发布帖\
reddit.com
- 3小红书 GPUStack:DeepSeek-V4.1-Flash 三套环境实测\
xiaohongshu.com
- 4超级大的Lobby:当 AI 学会驱动 PFC\
mp.weixin.qq.com
- 5CrofAI is an OpenRouter wrapper\
kendell.dev
- 6
- 7
- 8
- 9
- 10ukisai/Swift-Qwen3.8-27b 模型页\
huggingface.co
- 11r/LocalLLaMA:CrofAI 被曝是 OpenRouter 外壳\
reddit.com
- 12KTibow/crof-is-an-openrouter-wrapper\
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 官宣 90.6 实测 77.5、同一个 27B 跑出 121 和 17.9、同一张图 0.006 到 0.211 美元
- Jev 便宜十倍、ZCode 把完整 Git 历史传上云、6 GB 的三元模型跑成死循环
- 15 个版本送同一杯咖啡、3500 人账单涨 60%、一个匿名模型三种出身
- 124B 装进一台桌面盒子、2B 反超 8B、49 分 20 秒对 8 分 21 秒
- 从 370 年历史密码到 18 亿 Token 手搓系统:大模型实测跨入底层工程深水区
- 3D 依赖膨胀、HLE 偷翻答案与投机解码虚假提速:大模型实测迎来真实工程大考
- 同题 GTA 较量、双卡推测解码翻转与过度思考代价:大模型实测迎来端到端检验
- Terminal 基准争论、64 智能体迁移与缓存陷阱:大模型实测走向工程深水区