Jev 便宜十倍、ZCode 把完整 Git 历史传上云、6 GB 的三元模型跑成死循环
过去二十四小时里七组实测的共同点,是同一个数字换一个口径就会翻转:一个决策模型按每千封邮件算便宜十倍、按准确率算输给对手一到两个点;一个编码客户端把完整 Git 历史传上云,界面上所有相关开关都拦不住;一个写着保留 98.2% 智能的 6 GB 模型,第一次同题实测就循环了两个多小时。

过去二十四小时里最值得记的,不是又出现了哪一款新模型,而是几个说出来的数字被实测拆开的过程。
一个号称"选一个选项只要一次前向"的决策模型,在真实业务邮件上确实把成本压到了对手的十分之一,却在准确率上输了一到两个点;一个编码客户端被扒出把整个工作区和完整 Git 提交历史加密传上云端,界面上跟这件事有关的开关全部关掉之后,上传照旧;一个写着"体积只有九分之一、保留 98.2% 智能"的三元模型,第一次被放到同题实测里就循环了两个小时。
这一期能带走的仍然是每组的口径:题是谁出的,跑在什么机器上,样本多少,哪一格输了,发帖人自己承认哪一段不成立。
本期覆盖 2026 年 9 月 17 日至 9 月 18 日,来源为 X、Reddit、小红书与公众号。
七组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 把 1565 封德英商务邮件分到 10 个类别(订单、询价、发票争议等) | Jev、Gemini 3.5 Flash-Lite、Gemini 3.8 Flash 用同一份邮件文本与同一份类别说明 1 | 准确率 96.4% / 97.5% / 98.5%;每 1000 封成本 0.08 / 0.80 / 1.79 美元;Jev 单封从未超过 1.3 秒 | 1565 封里 364 封是 AI 生成的样本;附件被排除,作者称这是进生产的最大阻碍 |
| 13 封客服邮件四分类,四个模型并排跑 | Jev、GPT Luna、Gemini 3.5 Flash、Claude Sonnet 2 | Jev 3.75 秒(每封 288 毫秒),其余三家 13.91 / 14.11 / 25.64 秒;13 封的分类标签四家完全一致 | 判断类任务,是 Jev 的顺风局;生成类任务这一轮没有测 |
| 在一个真实招聘产品里给"简历 × 职位描述"的相关性打分 | HiringCafe(月活 250 万),与人工标注比 Spearman 相关系数 3 | Jev 0.79 / 0.02 美元,DeepSeek V4 Flash 0731-high 0.77 / 0.14,Gemini 3.1 Flash-Lite 0.72 / 0.29 | 成本栏按作者给出的口径;没有公开样本量与置信区间 |
| 让一个决策模型去点浏览器里该点哪个按钮 | Cua 的 jev-use:Jev 负责选一个候选 ID,Cua Driver 负责观察、执行与验证 4 | 在这一次 2048 的实测里,Jev 比 Astra 快 5 倍、便宜约 1000 倍;末帧显示 Jev 用到 44.9 秒 | 结果只属于这一次运行;2048 是键盘操作、状态完全可观察的理想任务,候选集由客户端生成 |
| 从本地日志和反编译里查一个编码客户端到底传走了什么 | ZCode(智谱官方 AI 编码客户端)的 ~/.zcode 目录与 app.asar 包 5 | 一份 313 MB 的加密快照,原始工作区 345 MB;42411 个文件里 .git 占 86.6%;失败重试计数已到 564 次 | 作者自己的取证记录,客户端与上传服务未做第三方复跑;官方随后给出的说法与取证记录多有不一致 |
| 一道可交互 3D 网页:一间有多个生物群系、能走动的迷你星球 | Ternary Bonsai 2(27B),由 Qwen3.8-27B 推导、三元权重、体积小于 6 GB 6 | 模型卡称比 FP16 小 9 倍、保留 98.2% 智能;实测里模型重复同一段话循环了两个多小时 | 单次运行、单一提示词;发帖人引用另一位测评者的视频后认为 98% 的说法"误导" |
| 在四组消费级与单卡配置上跑本地推理 | 单张 R9700 跑 Qwen3.8-27B NVFP4;双 7900 XTX 跑 Qwen3.8 Q8;单张 RTX Pro 6000 用 Ninfer 跑 qwen3.6-35B-A3B;5070 Ti 12 GB 笔记本用 Flyweight 跑三个量化档 7 | R9700 每类任务 decode 中位 67 到 153 tok/s、8 路并发合计 471 tok/s;双 7900 XTX 从 28 涨到 82 tok/s;Ninfer 单请求 600 tok/s | 都是发布者自己的单机数字,未做交叉复跑;量化档与上下文长度各不相同 |
便宜十倍,输在 1.1 到 2.1 分
Jev 是前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 在 9 月 15 日发布的决策模型。它不做聊天,也不生成句子:开发者提交一份状态和一组类型化的问题,模型返回 Choice、Score、Noul 三类原语组成的答案,每个答案都带一个概率。官方给的定价是输入 0.042 美元每百万 token、输出免费,端到端延迟 70 到 500 毫秒,对照的前沿模型区间是 3 到 329 秒 8。
判断它到底行不行,最好的一组数字来自一个真在做邮件分类的人。bryo 的联合创始人兼 CTO Nikhil Mudholkar 拿 1201 封真实商务邮件,补上 364 封为覆盖稀有类别而由 AI 生成的样本,一共 1565 封,分到订单、询价、发票争议等 10 个类别里,三款模型用同一份邮件文本和同一份类别说明。
结果对 Jev 并不全是好消息。总体准确率 Jev 96.4%、Gemini 3.5 Flash-Lite 97.5%、Gemini 3.8 Flash 98.5%;把每个类别等权计算,差距拉成 92.0%、94.6%、96.9%。成本这一栏则完全反过来:每 1000 封邮件 Jev 花 0.08 美元,Gemini 3.5 Flash-Lite 花 0.80 美元,Gemini 3.8 Flash 花 1.79 美元,相差约 10 倍与 22 倍。Jev 的单封耗时在这三家里从头到尾没有超过 1.3 秒 1。
Loading content card…
Mudholkar 自己更看重的不是那两个点,而是模型交回来的概率。这一轮里有 737 条预测的置信度在 99% 以上,它们全部与参考答案一致;置信度低于 70% 的那一档,将近一半是错的;把最自信的 85.5% 的邮件自动放行,错误为零。他还把整批数据重跑了三次:99% 的标签完全相同,所有发生变动的都落在置信度 0.6 以下,模型有把握的部分一次都没有变过。这条性质决定了它能怎么用——高置信度的自动分流,低置信度的转人工,而不是让它把所有邮件都判完 1。
这份材料最该被记住的限制写在作者的补充里:附件被排除在外,因为 Jev 不支持非文本输入。他自己的判断是,这是它进生产环境最大的阻碍。
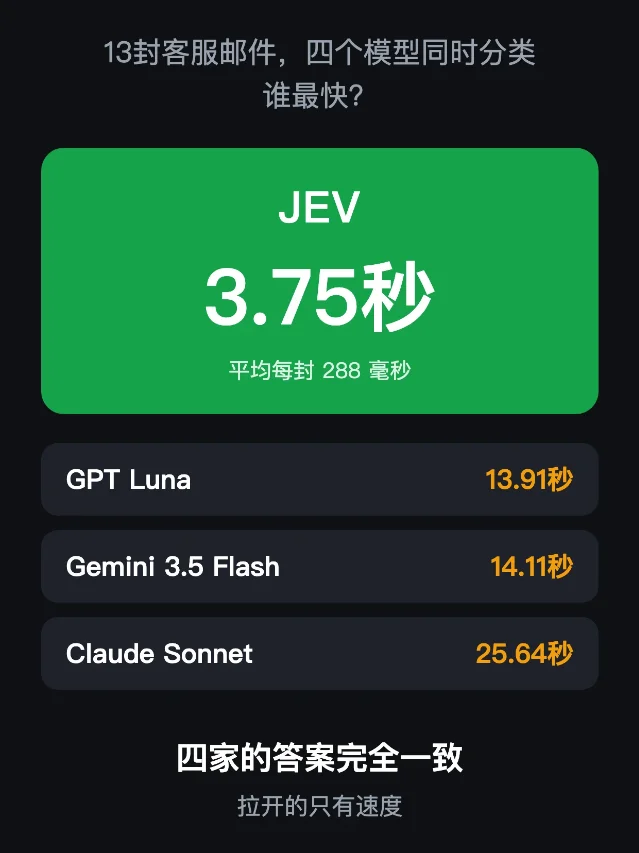
另一组独立实测来自日本的 AI 讲师 usutaku。他把 13 封客服邮件交给四个主打速度的模型,让它们归到"感谢""投诉""咨询""其他"四类里,四列并排跑。Jev 用了 3.75 秒,平均每封 288 毫秒;GPT Luna 13.91 秒,每封 1070 毫秒;Gemini 3.5 Flash 14.11 秒;Claude Sonnet 25.64 秒。比起速度,更值得注意的是四家的分类结果逐行对下来完全一致,13 封邮件没有一条分歧——这一轮拉开的只有速度 2。
小红书用户「村长大棒」当天把这条实验转成了中文笔记,并在结尾写清了它测的是什么:读一段文字、归一个类,是判断类任务,正是 Jev 主打的场景,对它是顺风局;换成生成类任务会不会还是这个排序,这一轮没有测,不能直接外推 9。
第三组数字来自一个真实的招聘产品。斯坦福 CS 博士生、HiringCafe 作者 Hamed Nilforoshan 在服务 250 万月活用户的产品里给"简历 × 职位描述"的相关性打分,与人工标注比 Spearman 相关系数:Jev 0.79、成本栏 0.02;DeepSeek V4 Flash 0731 高推理档 0.77、0.14,低推理档 0.73、0.27;Gemini 3.1 Flash-Lite 0.72、0.29(成本一栏的作者没有写明计价单位)。在这道题上 Jev 的相关系数最高、成本栏最低 3。
另外两组小规模的实测给出了同一方向的边界。英国开发者 Ashley Hindle 在他们判断"新对话需要多强的模型"的路由基准上说,Jev 快了 3 倍、便宜了 65%,并且在安全性这一项上更好 10。一位做机器学习系统的开发者 @identityTorn 报告说,Jev 零样本在他自己的内部基准上,与同精度的人工微调模型相差约 5 个点召回,全量跑下来约 70 美元一个月、延迟在亚秒级;但他同时写明,自己微调的 Qwen 仍然比 Jev 快 3 倍 11。
厂商自己给出的评测表也值得对着看。公众号「海盗 Sharp」在 9 月 17 日的深读里从 TypeSafe 官方评测表中拆出一行:同一个大模型用"一条长 prompt 一次做完"和"拆成工作流分步做",得分差很多,GPT-5.6 Luna 从约 52% 提到 67%,Sol 从约 63.5% 提到 74%。同一份表里,Jev 均值准确率约 68%、单个工作流约 0.0004 美元,GPT-5.6 Luna 约 67%、0.0035 美元,Sol 约 74%、0.085 美元,Claude Opus 5 约 73%、0.17 美元。也就是说 Jev 用对手约九分之一的价格追平了 Luna,想再多拿那 6 个点,仍然要去买 Sol 或 Opus 5 12。
同一份深读还点出了官方那句"不会产生幻觉"的边界。TypeSafe 真正保证的是 schema:不发明未声明的字段、不输出非法类型、不给选项集之外的值——公司自己说这块数学上不可能出错,单个反例就能证伪。它不保证判断正确:Hacker News 上有人指出,模型完全可以给出一个格式合法、内容全错的选择,创始人的账号回复承认了这一点。还有一个坑在选项集本身:当正确答案根本不在你给出的选项里,概率仍然必须落在剩下的选项上,模型不会告诉你"没一个对"。深读因此提醒,缺了"以上都不是"这类出口的 schema,比模型本身更容易出问题 12。
把生成换成打分:快在哪,独立复现差在哪
Jev 在 Computer Use 上的第一份实测来自开源项目 Cua。他们不做端到端的大模型包办,而是把循环拆成两层:Cua Driver 负责跨平台的观察(截屏、无障碍树 AX、DOM)与执行,并负责执行之后的状态验证;Jev 只做一件事,从客户端已经生成好、带 ID 的候选动作里选一个。五步循环是"观察 → 按需解析 → 客户端构建候选 → Jev 选一个 ID → Driver 执行并验证" 4。
他们公布的这一次 2048 实测里,Jev 比 Astra 快 5 倍、便宜约 1000 倍,帖子里同时写明"这个结果只属于这一次运行,不是对任何一方的普遍结论"。把候选动作从"写出来"改成"选一个",省掉的正是生成那一段的延迟——有评论者指出,那 5 倍不来自模型更强,而来自输出空间被压小了:选一个候选 ID 只需要解码几个 token,而把动作完整写出来才是慢的地方 4。中文技术博主 @shao__meng 当天把这条拆成了更细的一版,并提醒 2048 是键盘操作、状态完全可观察的理想任务,恰好最大化了"小决策层 + 确定性执行"的优势,换成开放网页任务或无障碍树稀缺的场景,差距未必如此 13。
这种机制到底能不能自己复现,一天之内就有了答案。GitHub 上一个叫 jevlike 的起步项目(仓库当时只有 3 个提交)并不复制 Jev,只做一件输入输出形状相同的事:每个选项变成一个查询向量,对上下文 token 做注意力,用一个共享的点积加 softmax 得到一组和为 1 的概率,一次前向出结果,而不是逐词写出答案 14。
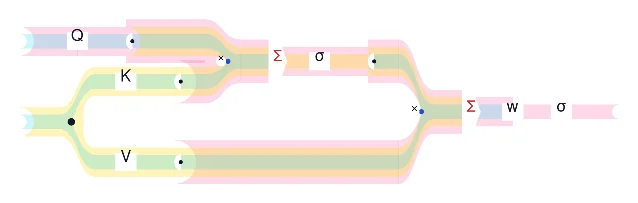
docs/architecture.svg(MIT 许可)。14它公布的数字里,好看的和难看的都在。合成菜单数据上准确率约 98%;在按目标页切分的 Wikispeedia 下一步点击数据上,冻结的 Qwen2.5-0.5B 编码器加评分头做到 26%,从零训练的小模型做到 29%,而把上下文打乱或换成随机编码器的对照组只有 8%。速度这一项是"八个选项时,一次前向比一个被迫写出 400 个 token 的小解码器快约 100 倍"。难看的部分它也没有删:同一个选项注意力头去做国际象棋控制器,对随机走子方 50 局是 4 胜 46 和 0 负,碰上 Stockfish 0 级就是 0 胜 2 和 48 负;用联合检查点跑 Doom,十局平均 0.60 次击杀、回报 -97.50。仓库自己在结尾写明,这是研究性起步项目,没有证明能与 Jev 质量相当,也没有复现对方的私有训练方法,速度对比用的是本地小解码器而不是商用大模型 14。
等不到 Jev 白名单的人走了另一条路。Reddit 用户 /u/Every-Comment5473 把一套 Jev 兼容的开源服务 OpenJev 挂了出来,TypeSafe 官方的 SDK 只改一个 base URL 就能接上,跑在他自己的 RTX PRO 6000 上;他给出的端到端延迟是 p50 约 170 毫秒(GPU 上约 73 毫秒),并注明这是建在一个尚未合并的 vLLM 提交上的 v0.1。更值得注意的是同一个帖子里的另一组对照:Matt Mastracci 用单步去噪把 DiffusionGemma 做成同样形状的模型,在 8 组评测上两者准确率大致持平,DiffusionGemma 以 198/201 略高于 Jev 的 191/201,速度更快 15。
对"概率输出"这件事,也有人给出了更冷的读法。安全工程师 Stanislav Yurin 拿到 API 之后报告说,Jev 返回的置信度就是把最大概率按 1/N 归一化的结果,他看不出这个量有什么物理含义,而且模型是非确定性的。他问的是:当底层分布是 (0.60,0.40,0,0,0) 和 (0.60,0.10,0.10,0.10,0.10) 时,这个置信度能不能区分这两种情况 16。MulticaAI 的 Jiayuan Zhang 研究了一天之后写下的判断也是同一层:新鲜感回落之后,它看起来就是一个更快的通用分类器或决策器,参数规模未知、世界知识可能不如常规大模型全,所以在有限解空间加低延迟的问题上是一个好方向,复杂场景的决策准不准还要打问号 17。
一个编码客户端把完整 Git 历史传上了云
9 月 18 日凌晨,一位开发者在给自己的磁盘腾空间时注意到
~/.zcode 占了 700 多 MB。他把这次排查写成了一篇完整记录:ZCode 是智谱官方的 AI 编码桌面客户端,只要用户处于登录状态,它就会静默地把整个工作区打包——包括完整的 .git 历史、LFS 资产缓存、reflog 和全局应用配置——加密后直接上传到阿里云 OSS 5。证据链条写得很具体。他在
v2/checkpoints/ 里找到一份 313 MB 的 .enc 文件,旁边记录着原始工作区 345 MB、状态为 baseline、失败重试计数 564 次。仓库总共 10 GB,扣掉依赖之后的这 345 MB 几乎全是核心资产。日志里没有上传地址,于是他拆开客户端的 app.asar,还原出两条链路:客户端先向 zcode.z.ai 申请凭据,服务器返回 OSS 表单签名、动态 Object Key、大小限制和一枚 RSA 公钥;随后客户端在本地打包、用临时对称密钥做 AES-256-CTR 加密、再用服务器给的公钥做 RSA-OAEP 封装密钥,把 tar.gz.enc 直接 POST 到 OSS,绕开 ZCode 自己的应用服务器。作者用系统里所有本地私钥去解那个封装密钥都失败了——私钥只在云端,那份密文他自己也打不开 5。打包内容也做了清点:一次 42411 个文件的快照里,
.git/lfs/ 占 196.1 MB(56.8%),.git/objects/ 占 102.2 MB(29.6%),.git/logs/ 占 0.6 MB,源码与文档合计只有约 46.2 MB。也就是说 .git 一个目录就占了载荷的 86.6%,云上拿到的远不只是当前工作树,而是这个仓库从第一天起的整条谱系,包括后续提交里删掉过的历史密钥与配置。作者另外发现,一个名为 repo_snapshot_extra_manifest 的清单会把全局配置一起哈希打包 5。界面上的开关拦不住它。他把每个选项与代码逐一对照:叫"优化体验"的那个开关只控制数据是否被授权用于模型训练,快照的采集与上传照旧;叫"仓库快照索引"的开关只控制服务端是否对已上传的快照做索引,本地的打包与上传不受影响。对应的采集上传模块在启动时无条件实例化,唯一的前提是 token 提供者能返回一个有效的 JWT。他先删掉本地那份待传的快照,半小时内客户端就重新打包了一份,重试计数从 564 变成 565。他最后给出的办法是在文件系统层面把目录锁死(macOS 用
chflags uchg,Linux 用 chattr +i),代价是客户端的"检查点回滚"功能不再可用 5。这篇记录在 9 月 18 日下午被搬到 r/LocalLLaMA,同一天,X 用户「奶昔」补充了一组他自己的实测:团队套餐标准版在关闭"优化体验"之后,也无法阻止数据上传 18。Reddit 那条帖子下有 44 条评论,其中被置顶的一段是以"Dear ZCode Users"开头的公开答复,落款为 ZCode:它把问题归因于"代码库索引"功能,说 Repo Wiki 生成页面时可能触发仓库数据上传,云端生成完即销毁、不再保留,该功能上线早期默认开启,相关问题"现已修复",随后承诺将开源 ZCode 代码库、邀请第三方评测,并给所有用户补发一次每周额度滚动重置 19。这份答复本身在评论里就被追问了出处——一位用户在下面回帖说,他在官方的 X、Reddit 和 Discord 上都找不到这段文字 19。
Loading content card…
到发稿为止,能做的是自己核对而不是接受任何一方的结论:看一眼
~/.zcode 的体积,再决定那个目录要不要锁上。6 GB 的三元模型,第一次同题实测跑成了死循环
同一天在 Hugging Face 上发布的 Ternary Bonsai 2(27B)是另一个方向的尝试。它从 Qwen3.8-27B 推导而来,架构没有改动,权重改成三元表示,体积压到 6 GB 以下;模型卡的说法是比 FP16 小 9 倍,同时保留 98.2% 的智能,并提供一个能在浏览器里通过 WebGPU 直接跑的演示 20。
第一次把它放到真实任务上的人给出的反馈很短。Reddit 用户 /u/notadithyabhat 给它的是这样一段提示词:
create a 3d little planet globe where I (player can walk around) and it has all these biomes to explore, the globe doesn't have to be too big, but still fun to go around. It's about a boy scout who is camping and goes around exploring.
他的记录是:模型像无头苍蝇一样重复同一段话,一直循环了两个多小时。评论区有人提醒提示词太模糊、参数需要调,他随后在编辑里补了一句:另一位测评者 Bijan 的视频当天也出来了,结论是这个模型表现就是不行——"对 6B 模型来说已经不错,但说它有 Qwen 的 98% 好,是彻底的误导" 6。
同一天另一条帖子给出了这类小模型合适的用法:有人把 Bonsai 1.7B 放在一颗 12 瓦的 Intel N97 上,能解出简单的物理题,速度约 9.1 tok/s 21。两条放在一起看,边界很清楚:这个系列确实把模型塞进了以前放不下它的设备,但"体积小 9 倍"与"能力保留 98.2%"是两件事,后者需要在具体任务上自己验。
同一天的四组本地推理数字
这一天 r/LocalLLaMA 上有四组配置实测,覆盖了从单张消费级卡到单张专业卡的区间。它们回答的是同一个问题:这台机器上,同一个模型能跑多快。
单张 AMD Radeon R9700 那一组最完整。发布者跑了 Qwen3.8-27B 的 NVFP4 量化版,按任务类别给 decode 中位数:chat 67.1、prose 69.2、code 120.5、reasoning 123.9、file_edit 138.0、math 140.0、summarization 141.7、json 153.1 tok/s;预填充在 2000 到 64000 的深度上稳定在 3192 到 3619 tok/s;并发 1 路 120、2 路 215、4 路 322、8 路合计 471 tok/s。作者写明这一版相比之前把单卡性能整体翻了一倍 7。
双 7900 XTX 那一组讲的是软件的作用。发布者原本用原版 llama.cpp 加 Vulkan 跑 Qwen3.8 的 Q8 量化,decode 约 28 tok/s;换上一个专为这套 RDNA3 组合优化的 fork 之后,在 60k 上下文加载下变成约 82 tok/s 22。
单张 RTX Pro 6000 那一组的数字最大:有人在 Ninfer 上跑 qwen3.6-35B-A3B,单请求做到 600 tok/s。他自己给这个模型的定位是"不算最聪明,但愿意让它暴力搜"的杂活模型,代价是可能多花 20 倍 token,算下来仍然比很多本地模型快 23。
第四组是关于显存不够怎么办。一个叫 Flyweight 的开源 C++/CUDA 推理运行时,目标是一张消费级 NVIDIA 卡加系统内存跑比显存大的 MoE 模型:专家权重放 CPU,或者拆开一部分常驻显卡。作者在一台 5070 Ti 12 GB 加 60 GB 内存的笔记本上量到:Qwen3.8-Flash-Next 的 IQ1_S 量化 decode 约 35 tok/s、预填充约 475 tok/s;Qwen3.8-27B 的 IQ2_XXS 约 40 tok/s;DeepSeek-V4-Flash 只有 6 到 7 tok/s,他直接注明这基本就是 DRAM 带宽的上限。同一台机器上还有一个容易被忽略的变量:把 KV Cache 从 f16 换成 4-bit,dense 27B 在 32K 上下文下从 10.8 变成 22.9 tok/s,原因是这样做才把权重留在卡上 24。
四组数字的边界是一样的:都是发布者在自己的机器上量出来的单点结果,没有人做过交叉复跑,量化档、上下文长度和运行时版本各不相同,横向直接比大小并不成立。它们能提供的是同类配置的量级——你要买的那张卡,大致落在这个区间里。
Claude Code 的两条 harness 事实
9 月 17 日 r/ClaudeAI 上出现了两条对自己会话记录做的统计,都不涉及模型能力,只涉及工具链怎么花钱、规则有没有生效。
第一条讲的是子智能体为什么会吃掉整个五小时窗口。作者在订阅版上跑一套编排流程:一个长期存在的编排会话负责规划、派发和合并,几个子智能体各自拿到一个 git worktree 去做构建、评审或定位。他发现主会话的 prompt cache 存活 1 小时,而每个子智能体的 cache 只活 5 分钟;只要子智能体执行的任何一次工具调用超过 5 分钟(比如一次测试、一次构建、一个 git hook),cache 就过期,下一次请求会按昂贵的 cache 写入价把整个上下文重写一遍。他给出的一天记录里,一个子智能体把约 59 万 token 的上下文重写了 8 次,折合约 540 万 token 的 cache 写入;当天五个子智能体合计 26 次完整重写、1220 万 token 写入,而最大的那个子智能体的 cache 读取是 8100 万 token,几乎没动窗口。修复是加一行
"subagentPromptCacheTtl": "1h",或者在环境变量里设 CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL=1h(需要 v2.1.242 以上)。他在下午改完之后重新统计:五个可比的子智能体跑了约 530 轮、300 万 token 写入,大部分写入只发生在每个智能体的第一轮,其中一个评审子智能体跑了 147 轮、八十分钟零重写;同样四个子智能体消耗的五小时窗口,从修复前的 2% 涨到 100%,变成修复后的 0% 涨到 22% 25。他同时写清了代价:1 小时的 cache 写入按 2 倍计价,而 5 分钟档是 1.25 倍,所以一个本来就不会重写的短子智能体会多付约四分之三个上下文;会重写两次以上的,就一定赚回来。第二条讲的是一个静默的失效:嵌套的
CLAUDE.md 可能根本没被加载。作者对一个月的会话记录做了统计——480 个主会话、约 1200 个子智能体会话。结论是嵌套的 CLAUDE.md 只在 Claude 使用原生 Read 工具读取该目录下的文件时才加载,Bash 不触发它,cat、sed -n、grep 和 Python heredoc 都不加载任何东西。而在 8 月 18 日(v2.1.229)之后,auto 模式与 bypass-permissions 模式会给会话加一条指令,让 Claude 尽量用 Bash 工具读文件,也就是这个 harness 主动让模型避开了唯一能加载嵌套规则的工具。他把会话分三组统计"在该目录第一次编辑之前,嵌套 CLAUDE.md 是否被加载":Bash-first 开启的 271 个会话是 10%,关闭的 24 个会话是 79%,更早的 185 个会话是 80%。另外,infra/ 目录那三条规则(比如"只允许从 main 跑 terraform apply")在 30 个碰过 infra/ 的会话里只加载了 3 次;他还找到 409 次"没有原生 Read 却成功写入"的编辑;匹配 Edit|Write 的 PostToolUse 钩子在约三分之二的编辑上没有运行。他的补救办法是把每个嵌套规则文件从根 CLAUDE.md 里用 @ 导入,代价是每个会话多约 3000 token,但规则一定会加载 26。他给出的自查路径也很直接:看 ~/.claude/projects/<project>/*.jsonl 里有没有 "type":"auto_mode" 且 "bashFirst":true 的附件,以及有没有 "type":"nested_memory" 的附件。这两条统计都来自同一个人、同一个仓库,作者自己写明了这一点,你的数字可能不一样。
两条来自小红书的配置实测
国内平台这一天值得记的是两条动手记录。
小红书用户「硅基饲养员」的团队用一台闲置机器人做了一次精细操作:没有任何与插拔插座相关的 harness,只用一句话,让模型把插座拔下来插到第三个插座上,直接控制机器人完成毫米级的操作。他把这条放在"具身模型也许会有新思路"的讨论里,配的是现场视频 27。这条材料的边界在它没有给数字:任务设定和"毫米级"都是作者的描述,没有失败率、没有用时、没有成本,也没有写明用的是哪一版模型与哪套接口。
第二条是关于四台 Spark 该怎么用。用户「一个粗工」转述了公开评测数据——四台 Spark 并联并不会让 Qwen3.8 Flash Next 跑得更快,并说明自己并没有实测并联方案,光是 200G 交换机的价格就让他否掉了这条路。他自己的改动在 agent 侧:不是把两组 Spark 平均分配负载,而是把主循环任务和非主循环的工具调用拆开——主循环是长输出、decode 本来就慢,非主循环的请求输出短但频率高,混在同一组上会把 decode 速度压掉一半以上。拆开之后,同一个重任务从过去跑 700 秒变成 300 秒 28。这条的边界同样由作者自己标注:并联不可取来自公开数据,700 秒到 300 秒来自他自己那套 agent,没有说明任务规模与模型版本。
看数字之前先问两件事
今天这七组材料里,没有一组能回答"谁第一"。Jev 在 1565 封邮件的准确率上输了两个点,在同一批数据的成本和延迟上赢了一个数量级;一个把开源复现做出来的项目,把 0 胜 2 和 48 负的战绩也一起贴了出来;一份 313 MB 的密文躺在作者自己的硬盘上,而他和客户端都打不开它。
能带走的动作是两件。看到"快 N 倍、便宜 N 倍"时,先问它比的是哪一类任务、比的是单次调用还是整月账单——今天这两者给出过方向相反的结果。看到"保留 98% 能力"或"彻底不会幻觉"时,先问这句话约束的是输出的形状还是判断本身——今天这两件事分别在不同的地方被戳破过。
最后留一个可以自己动手的核对项:打开
~/.zcode,看一眼它有多大。References
- 1
- 2
- 3
- 4
- 5Code is cheap, let's talk:ZCode 把你的完整 Git 历史静默传上云\
blog.ferstar.org
- 6r/LocalLLaMA:Ternary Bonsai 是个无头苍蝇\
reddit.com
- 7
- 8
- 9村长大棒:Jev 有多快?4 个模型分 13 封邮件实测
xiaohongshu.com
- 10
- 11
- 12海盗Sharp:444 倍便宜却只追平 1/9 成本的对手
mp.weixin.qq.com
- 13
- 14GitHub:vinnylarouge/jevlike
github.com
- 15
- 16
- 17
- 18
- 19
- 20r/LocalLLaMA:Ternary Bonsai 2(27B)发布
reddit.com
- 21
- 22
- 23
- 24r/LocalLLaMA:Flyweight,单卡加系统内存跑超出显存的 MoE
reddit.com
- 25
- 26
- 27硅基饲养员:Astra 上限探索日记,一句话控制机械臂插拔插座
xiaohongshu.com
- 28一个粗工:四台 Spark 的正确用法不是并联,而是分流
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.