CQTR:冻结的检测器真不懂小目标吗?反事实尺度干预与解码器轨迹可靠性诊断
北京理工大学团队提出无训练框架 CQTR,通过反事实尺度干预唤醒冻结检测器的小目标潜在表征,并用解码器内部空间收敛与语义持久轨迹评估候选可靠性,在 27 组实验中全面提升 AP 与 APs。

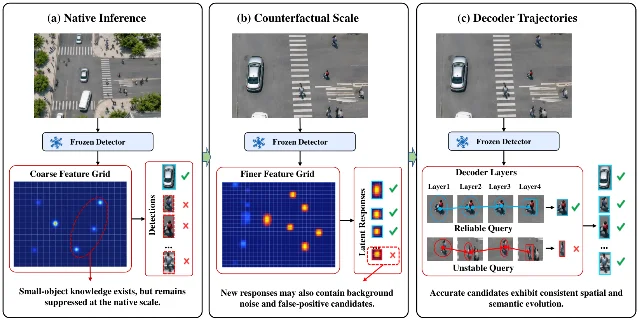
通用目标检测器在小目标场景下的性能瓶颈,常被归因于小目标有效像素过少以及下采样过程中的特征破坏。学术界过去普遍采取的应对手段,主要是设计多尺度训练、切图切片推理、增加高分辨率特征金字塔分支,或者针对目标域微调网络参数。北京理工大学团队在 2026 年 9 月提出的预印本工作 CQTR(Counterfactual Query-Trajectory Reliability)对这一基础假设提出了不同解释:冻结的预训练检测器内部已经具备小目标的尺度表征知识,只是在原生输入尺寸的标准推理流程中,这些知识往往处于欠激活状态,且查询演化过程不够稳定。1
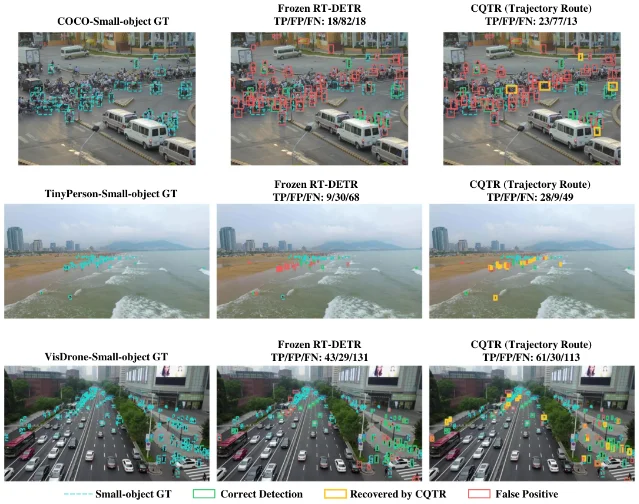
通过引入无训练的反事实尺度干预,并在 Transformer 解码器内部追踪查询在最后几层的空间收敛度与语义持久度,CQTR 构建了一套完整的可靠性评估与分流校准机制。在 COCO2017、TinyPerson 与 VisDrone2019 三套基准的 27 组模型与数据组合中,该方法在完全不更新模型参数、不访问目标域标注的条件下,使全部冻结检测器的 AP 与小目标指标 APs 均实现稳定增长。2
反事实尺度干预:自适应唤醒潜在尺度表征
标准推理流程中,检测器通常将输入图像缩放到固定尺寸 (例如 640 像素)。这种空间下采样操作把原本只有数个像素的弱小目标压缩进极少数特征网格中,导致深层特征难以形成稳定的查询假设。若对所有图像统一采取过大的分辨率放大,又会引入大量插值冗余,同时放大复杂的背景纹理。
CQTR 提出根据输入图像的相对压缩程度自适应选择反事实尺寸。对于原始高宽为 和 的图像,论文定义空间压缩比:
压缩比数值越大,说明图像在原生尺寸缩放下经历的信息压缩越剧烈。反事实尺度分支按照预设阈值 切换放大尺寸:
在模型参数完全冻结的前提下,检测器接收放大后的图像执行前向推理。对于动态根据特征图形状构建空间编码的检测器,可以直接运行原生前向流程;对于依赖固定推理尺寸的检测器,算法在推理前临时暂存并清空预设尺寸,促使模型依据实际特征图尺寸重新构建位置编码、解码器锚框与有效掩码,并在该次前向完成后立即复原原生设置。1
解码器内部轨迹:空间收敛度与语义持久度
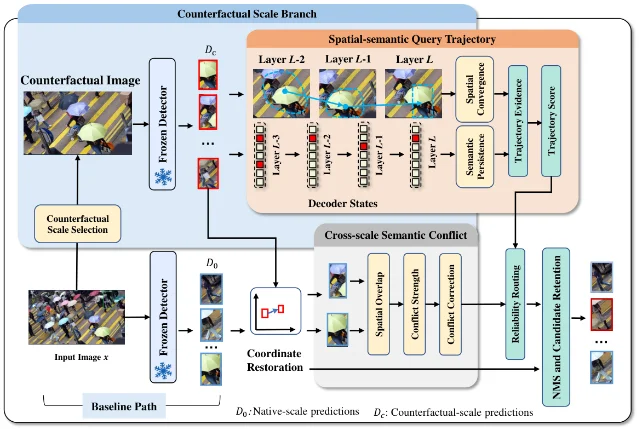
仅凭模型最终输出的分类置信度,无法反映检测假设在多层解码器中的形成过程。许多因图像放大而被激活的背景噪点在最后一层也能输出偏高置信度。CQTR 转向模型内部,提取最后几层解码器的中间预测状态,从空间位置和分类语义两个维度评估候选的可靠性。
对于包含 层解码器的反事实分支,每个候选查询 在第 层拥有预测框 与类别分布 。空间收敛度指标 考察最后 3 次预测框过渡的交并比(IoU):
当查询在解码后期平稳收敛到确定区域时, 接近 1;如果查询框在相邻层间出现剧烈漂移, 会显著下降。
在空间收敛的基础上,语义持久度指标 考察候选的最终预测类别 是否在最后 4 层解码器中持续占据优势:
如果候选类别在多层中频繁摇摆, 便会迅速衰减。综合轨迹证据定义为二者的几何平均值:
为了保护本就置信度微弱的小目标,算法放弃了全局固定截断阈值,改为将候选证据与当前图像内部所有候选证据的中位数 进行相对比较,计算连续重校准权重:
其中修正强度系数 设为 0.05。高于当前图像中位稳定性的候选得到置信度提振,演化不稳定的候选则被相应压制。1
跨尺度语义冲突抑制与无标注流级路由
尺度变换不仅能带来更多像素细节,也可能改变局部的上下文环境,诱发类别竞争。例如,远距离小物体在放大后可能被局部特征误判为大型物体的部件。针对这种失效模式,CQTR 设计了跨尺度语义冲突抑制机制。
算法首先将反事实分支与原生尺度分支的所有预测候选统一映射回原始输入坐标系。对于反事实候选 与原生候选 ,两者在空间重叠度与原生置信度共同作用下的冲突强度定义为:
当反事实候选与原生分支的高置信预测框高度重叠、却给出了相互矛盾的类别预测时,系统判定该反事实候选存在语义漂移,并使用抑制系数 对其置信度执行连续软打折:
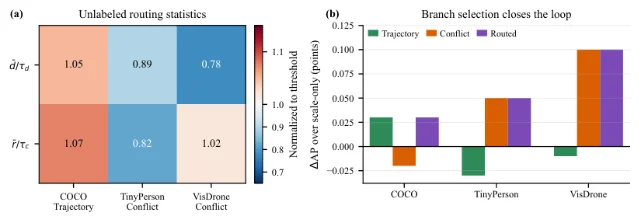
由于轨迹重校准与冲突抑制分别针对不同维度的失效,若在所有场景下机械串联叠加,容易过度惩罚有效目标。CQTR 设计了一套无标注流级可靠性路由。在测试前,针对特定的模型与数据集组合,系统使用固定随机种子在对应训练集中抽取 100 张无标注图像,计算该模型数据流的平均轨迹离散度 与平均最大冲突强度 :
当 且 时,说明该流内部轨迹方差充足、能够清晰分辨可靠度,系统激活轨迹重校准分支;否则,系统选择跨尺度语义冲突抑制分支。校准完成后,路由选择在整个评估期间保持固定。最后,根据输入图像的压缩比 决定是否保留原生分支候选,并在两路候选集合上执行类别感知 NMS 融合。1
跨模型与跨数据集评测
论文在 COCO val2017(5,000 张图像)、TinyPerson test(786 张图像)与 VisDrone2019-DET val(548 张图像)上展开了系统测试。评估模型覆盖 9 种代表性检测器:DETR-R50、Deformable-DETR-R50、DAB-DETR-R50、DINO-R50、RT-DETR-R50、RT-DETRv2-R50、RT-DETRv3-R50、D-FINE-S 以及 DEIM-D-FINE-S。在 TinyPerson 与 VisDrone 跨域场景中,所有模型直接采用 COCO 预训练权重,不访问任何目标域训练标注,不执行微调。
实验统一采用 COCO 评测协议(VisDrone 遵循 maxDets=100 限制,TinyPerson 不采用官方 miss-rate 协议),所有对比均严格限定在同协议下的配对基线之间。
COCO val2017 全量评测结果
| 基础检测器 | 原生基线 AP | 叠加 CQTR AP | 原生 APs | 叠加 CQTR APs | 路由分支 |
|---|---|---|---|---|---|
| DETR-R50 | 36.51 | 38.16 (+1.65) | 13.65 | 15.77 (+2.12) | 冲突抑制 1 |
| Deformable-DETR-R50 | 40.45 | 41.98 (+1.53) | 19.44 | 22.08 (+2.64) | 冲突抑制 1 |
| DAB-DETR-R50 | 36.35 | 37.94 (+1.59) | 13.61 | 15.74 (+2.13) | 冲突抑制 1 |
| DINO-R50 | 44.62 | 46.23 (+1.61) | 24.03 | 26.51 (+2.48) | 冲突抑制 1 |
| RT-DETR-R50 | 53.09 | 54.21 (+1.12) | 34.74 | 38.55 (+3.81) | 轨迹重校准 1 |
| RT-DETRv2-R50 | 53.40 | 54.32 (+0.92) | 36.06 | 38.01 (+1.95) | 冲突抑制 1 |
| RT-DETRv3-R50 | 52.72 | 53.72 (+1.00) | 35.15 | 38.15 (+3.00) | 轨迹重校准 1 |
| D-FINE-S | 48.49 | 49.58 (+1.09) | 29.30 | 31.70 (+2.40) | 冲突抑制 1 |
| DEIM-D-FINE-S | 48.96 | 49.71 (+0.75) | 30.38 | 32.57 (+2.19) | 轨迹重校准 1 |
在 COCO 上,CQTR 使全部检测器的 AP 提升了 0.75 至 1.65 个百分点,小目标指标 APs 的提升幅度更为显著,达到 1.95 至 3.81 个百分点。其中 RT-DETR-R50 的小目标 AP 从 34.74% 跃升至 38.55%,RT-DETRv2-R50 取得了 54.32% 的最高整体 AP。
跨域场景(TinyPerson 与 VisDrone2019)评测结果
在完全未见过的真实微小目标海面场景与无人机高空航拍场景下,未微调的冻结检测器表现出了显著的跨域泛化收益。在 TinyPerson 和 VisDrone 上,无标注路由机制将所有 9 个检测器均自动导向了跨尺度语义冲突抑制分支:
| 数据集 | 代表性检测器 | 原生基线 AP / APs | 叠加 CQTR AP / APs | 绝对增益 |
|---|---|---|---|---|
| TinyPerson | RT-DETR-R50 | 9.19 / 5.89 | 13.04 / 9.60 | +3.85 / +3.71 1 |
| TinyPerson | RT-DETRv3-R50 | 9.12 / 5.80 | 12.82 / 9.15 | +3.70 / +3.35 1 |
| TinyPerson | D-FINE-S | 7.24 / 4.37 | 9.80 / 6.77 | +2.56 / +2.40 1 |
| VisDrone | DEIM-D-FINE-S | 14.50 / 6.22 | 17.16 / 8.61 | +2.66 / +2.39 1 |
| VisDrone | RT-DETRv2-R50 | 15.68 / 6.64 | 17.49 / 8.52 | +1.81 / +1.88 1 |
| VisDrone | RT-DETR-R50 | 15.11 / 6.16 | 17.23 / 7.85 | +2.12 / +1.69 1 |
在 TinyPerson 上,RT-DETR-R50 的 AP 增幅高达 3.85 个百分点,APs 增幅达 3.71 个百分点;在密集航拍的 VisDrone 上,DEIM-D-FINE-S 取得了 2.66 个百分点的 AP 增幅。全部 27 组实验均取得了正向提升,证实了该机制在多种网络结构与数据分布下的通用性。
模块消融与机制证据链
为了搞清具体增益究竟来自哪项模块,论文对 RT-DETR-R50 在三大数据集上展开了组件级消融实验:
| 实验配置 | COCO AP | COCO APs | TinyPerson AP | TinyPerson APs | VisDrone AP | VisDrone APs |
|---|---|---|---|---|---|---|
| 冻结基线 | 53.09 | 34.74 | 9.19 | 5.89 | 15.11 | 6.16 |
| 仅反事实尺度分支 | 54.18 | 38.51 | 12.99 | 9.41 | 17.13 | 7.88 |
| + 轨迹重校准 | 54.21 | 38.55 | 12.96 | 9.39 | 17.12 | 7.86 |
| + 冲突抑制 | 54.16 | 38.44 | 13.04 | 9.60 | 17.23 | 7.85 |
| CQTR 流级路由 | 54.21 | 38.55 | 13.04 | 9.60 | 17.23 | 7.85 |
数据清晰展现了两个关键结论:
其一,主要精度跃升来自反事实尺度干预。例如在 COCO 上,仅尺度干预就贡献了 1.09 个百分点的 AP 增益(53.09 到 54.18)和 3.77 个百分点的 APs 增益(34.74 到 38.51);在 TinyPerson 上贡献了 3.80 个百分点。这一事实有力支持了作者的立论:预训练参数早已具备感知小目标的能力,无需重新学习参数。
其二,后续的轨迹校准与冲突抑制属于微弱的精细排序修正。它们在不同数据集上各自带来 0.03 到 0.10 个百分点的 AP 增量。若在跨域数据上盲目使用轨迹校准,性能反而会轻微回落(例如 TinyPerson 从 12.99 回落到 12.96);而无标注流级路由能够准确在两种修正机制间做出正向选择。
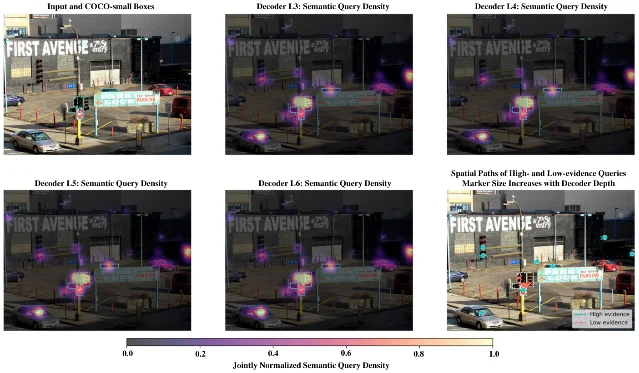
解码器内部查询轨迹的投射分析进一步印证了机制设计的合理性。论文统计了最后 4 层中 80 个小目标候选查询,其在小目标区域与背景区域的响应比值分别为 24.58、26.44、26.14 和 26.06,始终维持对微小物体的聚焦。高轨迹证据查询在最后 4 层的平均位移长度仅占图像对角线的 0.013%,而低证据查询的位移长度达到 0.184%(相差约 14.3 倍)。此外,按照轨迹证据均分五等分区间后,候选获得真实标注支持(IoU 且类别一致)的比例在 COCO 上从最低区间的 1.35% 单调递增到最高区间的 17.62%,在 TinyPerson 上从 0.54% 升至 18.98%,在 VisDrone 上从 4.82% 升至 30.84%。
部署代价与复现指南
从工程应用与后续复现的角度来看,CQTR 展现出鲜明的实用价值与清晰的物理边界:
- 优势与收益来源:无需任何反向传播训练、微调权重或目标域标注,即插即用即可让现有冻结检测器在小目标和无人机场景中获得显著的 AP 与 APs 提升。
- 算力与延迟代价:反事实分支引入了一次额外的放大尺度前向推理,同时需要保留最后数层解码器的中间张量以计算 IoU 和分类熵比值,显存占用与推理耗时相应增加。在严苛实时要求的边缘端部署时,这一开销需要权衡。
- 代码与复现现状:截至 2026 年 9 月,论文作者尚未在 arXiv 或论文正文中提供公开的代码仓库链接。所有实验数据声明在一台单卡 NVIDIA RTX 3060 GPU 上完成。复现该工作时,核心工作量在于挂载预训练 DETR/RT-DETR 模型的解码器前向 hook,提取各层预测框与 logits 计算几何平均指标,并实现基于中位数的置信度重加权逻辑。1
- 选题与延伸思考:该工作证实了解码器内部状态演化包含了大量未被最终输出利用的“置信度元信息”。未来的研究既可以探索单次前向下的内部特征干预,也可以将这种无训练轨迹诊断扩展至开集小目标检测或具身低照度弱小目标感知任务中。2
References
- 1CQTR arXiv HTML 全文
arxiv.org
- 2CQTR arXiv 摘要页
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.