SPARK-SAM:把 SAM 的提示—响应鸿沟改成可学习的图像到掩码闭环
SPARK-SAM 先适应红外目标域的 prompt-to-mask 响应,再用图像条件联合自提示实现自动分割,并量化两部分对精度和定位的贡献。

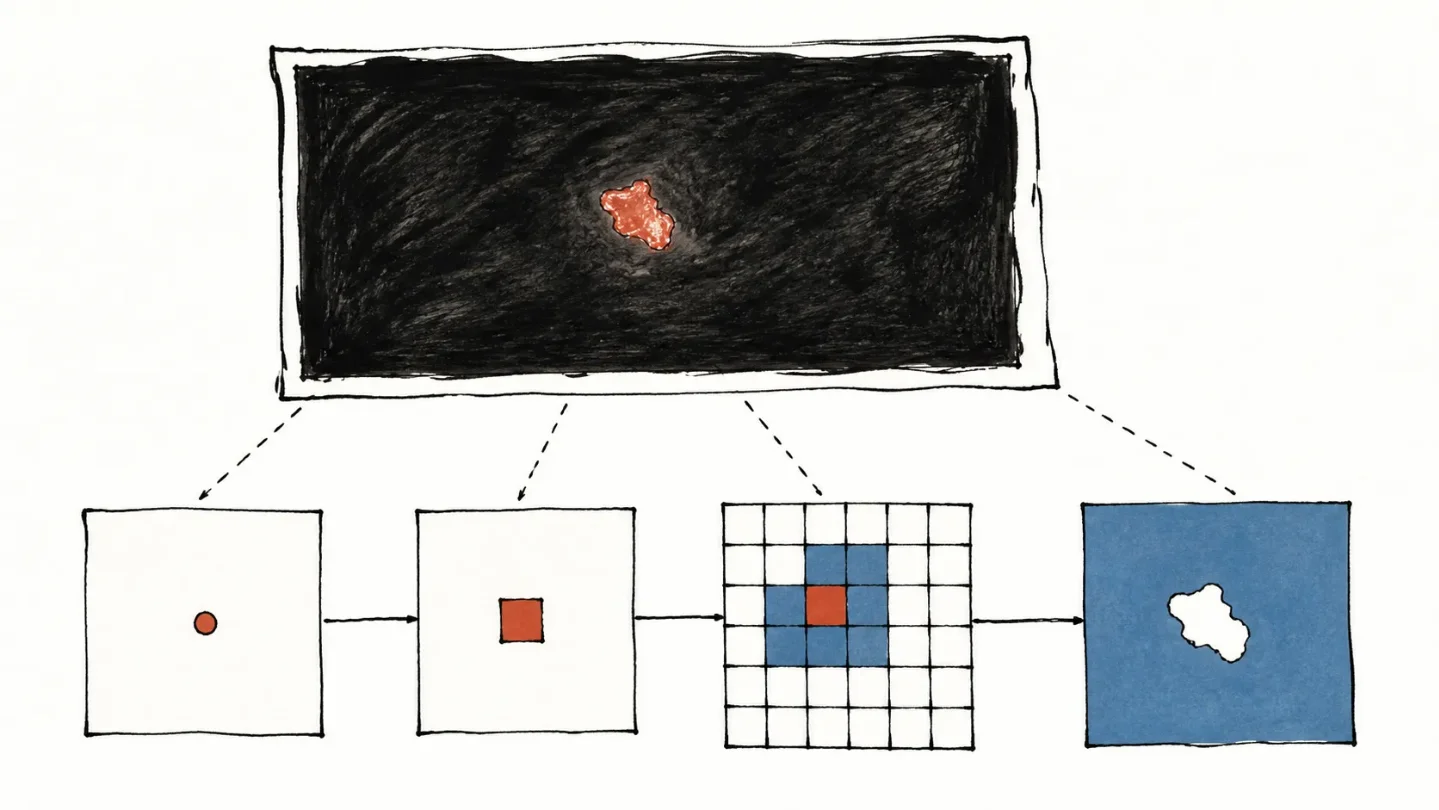
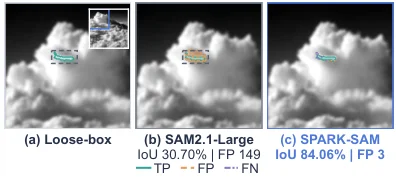
给 SAM2.1 一个覆盖红外目标的框,模型仍可能把整片杂波当成目标。SPARK-SAM 的关键判断是:红外小目标的迁移困难首先出在 prompt–response gap——空间提示已经覆盖目标,SAM 的目标域掩码响应仍然不对。它因此把“学会红外响应”和“从图像生成提示”分开训练,再用联合自提示状态把两者接回 SAM2 decoder。1
覆盖框仍然只有几个点的 IoU
红外小目标分割通常只有像素级 mask,推理时需要图像直接输出 mask。论文先做了一个带有特权信息的诊断:用测试集参考 mask 推导能覆盖所有目标像素的 loose box,再把这个框交给冻结的官方 SAM2.1 模型。NUAA-SIRST、NUDT-SIRST 和 IRSTD-1K 上,最佳 IoU 只有 4.69%、1.64% 和 2.28%;高召回与大量假阳性同时出现。四种官方模型规模都低于 5% IoU,说明增加预训练模型规模也没有修复目标域的 prompt-to-mask 行为。1
这个诊断与自动推理要分开看:测试 mask 推导的框只用于证明覆盖目标仍然不够,SPARK-SAM 的正常推理只接收红外图像。论文 v2 的原始页面把这一差异定义为 prompt–response gap,并把 response knowledge 用来指代适应后的目标域提示到掩码行为。2
先学会响应,再自己找到提示
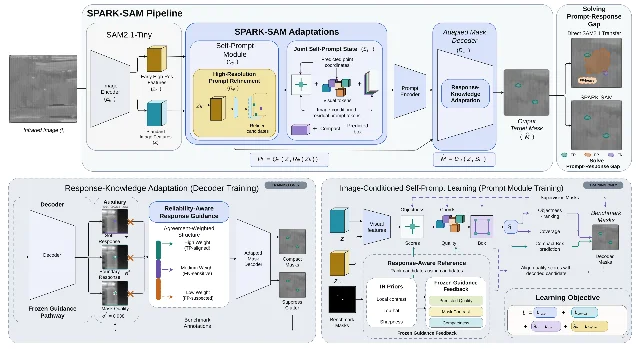
SPARK-SAM 保留 SAM2 的 encoder–prompt encoder–decoder。图像编码器将红外图像变成
Z,自提示模块 Q 从 Z 预测 objectness、候选点偏移、候选分数、掩码质量和紧凑框。它从低分辨率 objectness map 取 Top-K 位置,用偏移修正坐标,再在坐标处双线性采样局部 token。联合自提示状态包含四部分:点和框经 prompt encoder 得到的编码、跨候选共享的残差 token,以及和每个点绑定的局部 token。形式上可以写成
P_I = Q(Z, R(Z_h)) = ({u_j}, b, T_res, {t_j})S_I = [P({u_j}, b), T_res, {t_j}]M_hat = D(Z, S_I)这条链把候选位置与局部外观绑在一起。框提供范围,点提供位置,局部 token 提供该位置的红外证据,残差 token 则让多个候选共享图像条件。
Response knowledge 怎样被训练出来
benchmark mask 通过 BCE、Dice 和前景外 focal 惩罚锚定基础响应。另一个响应引导管线使用冻结的 SAM2.1-Large 与
A_p 产生软 mask、边界分布和质量估计。每个像素按三种关系分配权重:响应与标注对齐时为 ρ_a,背景上出现疑似假阳性时为 ρ_s,其余区域为 ρ_d,并满足 ρ_a > ρ_d > ρ_s。响应损失对像素级 BCE 与概率平方误差做加权平均,再加入边界损失和质量校准损失。这个设计让模型学习“弱红外证据应该如何形成紧凑目标 mask”,同时降低冻结模型在疑似杂波区域给出的错误指导。
自提示训练还需要把候选落到目标附近。
A_p 用 objectness、局部对比度、top-hat 响应、峰值锐度和高频证据生成候选先验;冻结响应再提供 mask contrast、面积兼容性、紧凑性和点—mask 中心一致性。最高候选提供训练点,多尺度框响应选择紧凑框或训练 mask 推导的 fallback。提示损失同时约束 objectness、point、box、ranking、coverage、candidate-mask quality 和 dense prior。1高分辨率精修只负责最后一段定位
低分辨率 objectness 计算便宜,却会把几像素目标定位得过粗。零初始化的高分辨率头从早期特征图
Z_h 预测残差:o_h = Up(o_l) + αR(Z_h)低分辨率候选池保留四个位置,高分辨率池只增加排名最高的一个细粒度候选,候选数从 4 变为 5。这样,精修头的任务集中在补回定位精度,主干响应学习仍由前面的 response adaptation 承担。
阶段诊断把两项收益拆开了。在 IRSTD-1K 上,响应适应阶段达到 68.01% IoU 时,Hit@K 只有 0.005;加入提示监督后 Hit@K 升到 0.540,精度增加 2.89 个百分点,Fa 降低 10.11 px/MP,同时 IoU 下降 0.35 个百分点;高分辨率精修后 IoU 为 68.34%,Hit@K 为 0.955。响应知识先提供主要 mask 能力,提示监督随后改善目标接地和虚警控制。1
decoder 确实在使用联合状态
论文冻结所有模型权重,只改动联合自提示状态。完全移除
S_I 后,NUAA-SIRST、NUDT-SIRST 和 IRSTD-1K 的 mean nIoU 分别下降 28.27、8.84 和 18.68 个百分点。随机或打乱空间分支后,三套数据的 nIoU 都下降;框打乱的下降只有 0.11 到 0.20 个百分点。用测试参考 mask 推导的框替换预测框,IoU 分别增加 1.57、2.48 和 1.77 个百分点。1这个干预结果给出的机制比“框和点都有效”更具体:坐标条件化的局部 token 提供了超出粗框的空间信息,decoder 确实依赖联合状态;预测框仍有少量定位余量,但框分支单独承担的贡献较小。
结果要区分两套比较
与 SAM 变体比较
| 数据集 | SPARK-SAM IoU | 论文内排名 | 额外参数 |
|---|---|---|---|
| NUAA-SIRST | 75.78% | 14 个重训练 SAM 变体中第 2 | 0.726M 1 |
| NUDT-SIRST | 86.49% | 第 1 | 0.726M 1 |
| IRSTD-1K | 68.34% | 第 1 | 0.726M 1 |
表中的排名属于论文定义的自动 image-to-mask 比较。与八个专用 IRSTD 网络比较时,SPARK-SAM 在 NUAA-SIRST、NUDT-SIRST 和 IRSTD-1K 的 IoU 排名分别为第四、第五和第二;SCTransNet 仍在三套数据上拥有最高的专用模型 IoU。SPARK-SAM 的价值在于有效迁移 SAM2 的接口和响应能力,任务专用网络在这三个基准上的精度优势仍然存在。1
| 数据集 | SPARK-SAM IoU | SCTransNet IoU | SPARK-SAM nIoU/F1/FA |
|---|---|---|---|
| NUAA-SIRST | 75.78% | 78.46% | 76.93/86.22/100.88 1 |
| NUDT-SIRST | 86.49% | 94.42% | 87.75/92.75/41.86 1 |
| IRSTD-1K | 68.34% | 69.89% | 64.47/81.19/46.02 1 |
专用网络比较中,SPARK-SAM 并没有成为三套基准的绝对最高者;它把 SAM2 的可提示接口改造成了自动预测路径,代价是仍然落后于最强专用结构。
参数与失败边界
SPARK-SAM 总参数量为 39.688M,相对 SAM2.1-Tiny 增加 0.726M 参数、6.80 MiB 峰值显存和 6.134 GFLOPs。RTX 4090 上 batch-1、FP32、原生
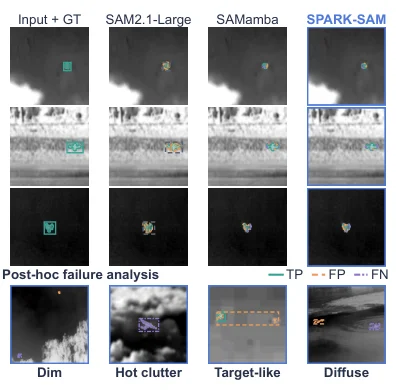
1024² 输入的平均延迟为 31.451ms,中位数 30.716ms,P95 为 37.573ms,约 31.8 FPS;新增模块让平均延迟增加 0.051ms。这个基准保留了各方法的原生输入分辨率,FPS 不能脱离分辨率比较。1定性结果中,SPARK-SAM 对部分弱目标形成了更紧凑的 mask,但热杂波、类目标干扰和扩散边界仍会产生错误响应。论文各数据集分别训练和测试,跨数据集与时序视频场景尚未验证;官方仓库提供 Python 3.10、PyTorch 2.5.1 或更新版本、数据目录要求、训练步骤和 SAM2.1 Tiny/Large 权重要求,README 没有单独测试命令。13
复现顺序
SPARK-SAM 最值得复现的增量是“目标域响应适应 + 图像条件联合自提示”,而非单独增加一个高分辨率头。建议先固定 SAM2.1-Tiny 和三套数据划分,复现 response guidance 的完整消融;再检查点、局部 token、残差 token 和框的冻结干预;最后加入高分辨率 refinement,复现 0.50 到 1.52 个百分点的边际收益。
论文已经把主要精度增益定位到 response guidance:去掉完整引导管线后,三套数据的 IoU 分别下降 14.58、23.87 和 12.35 个百分点;去掉 refinement 后分别下降 0.50、1.05 和 1.52 个百分点。这个分解给出了清晰的研究路线:先验证 decoder 学会怎样响应红外目标,再验证自提示能否把正确证据送到 decoder。1
References
- 1SPARK-SAM arXiv HTML 全文
arxiv.org
- 2SPARK-SAM arXiv 摘要页
arxiv.org
- 3SPARK-SAM 官方 GitHub 仓库
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.