《Sequence to Sequence Learning》:整句话压成 8000 个数,倒着读为什么让翻译变好
从「长度不定的句子怎样喂进只能吃定长向量的网络」讲起,拆开编码器—解码器、整句一个 8000 维向量、束搜索解码与源句倒序,并用 WMT'14 的 BLEU 表与两张曲线读懂 34.81 这个成绩量的是谁、代价落在哪。

2014 年 9 月 10 日,arXiv 上线一篇 9 页的论文,作者是 Ilya Sutskever、Oriol Vinyals 与 Quoc V. Le,三人当时都在 Google。1
到 2026 年 10 月 23 日,OpenAlex 为它计到 17,296 次引用。4
论文接的是一道很硬的约束。深度网络只能吃定长向量,而一句话有几个词,事先不知道。5
机器翻译正是这类问题。当时的强系统是短语统计机器翻译,神经网络在里面做辅助活:给候选译文打分,重排系统给出的 n-best 列表。5
这一篇把辅助的位置换掉了:一套网络直接从源句写出译文,不从别的系统里拿候选。作者报出的成绩是 WMT'14 英译法 34.8 BLEU,同一测试集上那套短语统计系统的成绩是 33.3。1
下面的事实、公式、三张表与两张图,都按 arXiv v3 的排版版读。5
网络缺的那一格:长度不定的输入怎么进去
2014 年之前,神经网络进机器翻译主要走三条路。
最常见的一条是当特征。把一对句子丢进网络算一个条件概率,再喂进统计系统的对数线性模型。6
Cho 等人在同年的 RNN Encoder–Decoder 里做的就是这个。模型负责给短语对打分,最终译文仍由统计系统产出。6
另两条路各带一个强假设。Kalchbrenner 与 Blunsom 是最先把整句话映射成一个向量的,但他们用卷积,词序在压缩时丢掉了;CTC 那一支要求输入与输出单调对齐。5
这一篇把这两个假设一起放掉。源句里哪个词对应译文里哪个词,交给网络自己学,代价是它必须先把整句读成一个向量。
编码器:一句话压成 8000 个数
公式 (1) 只写了一行,整个模型就在里面:
左边是给定源句、生成整句译文的概率。右边把它拆成逐词的条件概率,每一项只看三样东西:向量 v、已经写出的词、当前这一步。5
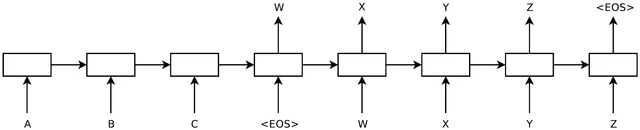
v 在这里第一次出场。它是编码器 LSTM 读完源句最后一个符号之后的状态,被直接填成解码器四层的初始状态。5
句末符号是这个设计的一部分。每句话末尾加一个
论文对这个向量只说了一句:深层 LSTM 用 8000 个实数表示一句话。5
这个数拆开正好对得上。每层 1000 个单元,四层是 4000;每个 LSTM 单元有两份状态,隐藏状态与记忆单元;解码器要把四层的两份都填上,一共 8000。5
一句话的全部信息就压在这 8000 个数里。源句多长、语序如何、哪个词修饰哪个词,解码时都只能从这个向量里取。
模型与文中那段简单描述有四处差别。编码器与解码器是两个独立的 LSTM,为的是在几乎不增加计算量的前提下多出参数。层数取四层,每加一层困惑度降近 10%。输入句倒序,句子以
图 1 画的是这条管线从头到尾的样子。
解码器:一个被句子启动的语言模型
解码器的身份,论文用一句话交代:它就是一个循环神经网络语言模型,只是多了一个条件 v。5
要生成的句子,形式上是这个最大化问题:
把候选句子全部穷举一遍,代价随句长指数增长,实际算不完。5
实际用的是从左到右的束搜索:保留 B 条前缀,每一步用词表里每个词把它们延长,再按对数概率只留最可能的 B 条;某条前缀接上
束宽的开销比想象中小。B=1 时系统已经可用,B=2 就拿到了束搜索的大部分收益。5
表 1 把这个账算得更细:5 个模型集成配 beam 2 得 34.50,比单个模型配 beam 12 的 30.59 高 3.9 个点,而每次解码只要 10 次扩展,比 12 次还少。5
训练目标是一句译文的对数似然,在全训练集上取平均:1/|S| Σ log p(T|S)。句子无论多长,最后只压成一个标量往回传。5
倒着读:同样的模型,让梯度少走一段
论文最关键的技巧藏在一行预处理里:源句倒着输入,译文正着输出。5
数字很直接。源句倒序之后,测试困惑度从 5.8 降到 4.7,解出的译文 BLEU 从 25.9 升到 30.6。5
表 1 里同一条对比换了两个数字:正序单模型 26.17,倒序单模型 30.59。两处都在原文,论文没交代它们是否用同一套解码设置。5
论文给的解释叫最小时间延迟。源句与译文拼在一起训练时,句首的几个词原本隔得很远;倒过来之后,源句的第一个词紧挨着译文的第一个词,梯度要走的距离一下变短。5
作者的态度值得学。他们写「我们对这个现象没有完整的解释」,只相信是短期依赖变多让优化更容易。5
把两处数字放在一起,判断很清楚:模型部分完全一致。参数、层数、词表、数据都没动,动的只是输入顺序,也就是梯度要走的那条路。
34.81 这个数怎么读
这套系统只在 WMT'14 英译法上做过实验。训练用 1200 万句的子集,法语侧 3.48 亿词、英语侧 3.04 亿词。5
词表是固定的:源语取最常见的 16 万词,目标语 8 万词,表外词一律换成 UNK。5
表 1 每一行只换一个变量:
| 系统 | 解码设置 | BLEU |
|---|---|---|
| Bahdanau 等人的注意力模型 | 未交代 | 28.45 |
| 短语统计基线 | 未交代 | 33.30 |
| 单个正序 LSTM | beam 12 | 26.17 |
| 单个倒序 LSTM | beam 12 | 30.59 |
| 5 个倒序 LSTM 集成 | beam 1 | 33.00 |
| 5 个倒序 LSTM 集成 | beam 2 | 34.50 |
| 5 个倒序 LSTM 集成 | beam 12 | 34.81 |
表里所有数字都出自原论文 Table 1(ntst14 测试集)。5
先把两笔增益拆开。34.81 是 5 个模型集成配 beam 12,单模型只有 30.59;倒序在单模型上值 4.4 个点,集成在倒序模型上值 4.2 个点,两笔账分量相当。5
表 2 记的是另一类成绩:把 LSTM 接到基线系统后面,给它的 1000-best 列表重排,得 36.5,比基线高 3.2 个点。5
另一个是最好系统的 37.0。这个系统在 statmt.org/matrix 上的分数是 35.8,作者用自己的脚本复算得到 37.0,正文把两个数并列写出。5
同表最后的 oracle 重排是约 45。它量的是「1000-best 里已经有好句子的前提下能挑出多好」,衡量的是重排这一步的天花板。5
代价这一侧要一起记:384M 参数,其中 64M 是纯循环连接,编码器与解码器各 32M;8 块 GPU 训练约十天,单 GPU 每秒 1,700 词,8 GPU 每秒 6,300 词。5
两张曲线:长句没坏,稀有词坏了
摘要里那句「LSTM 处理长句没有困难」,靠图 3 的左图撑着。
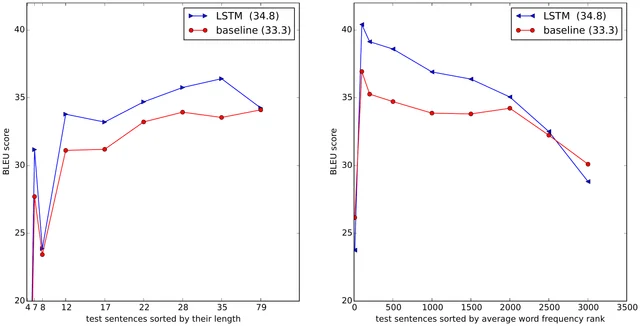
左图先说好消息:35 词以内,LSTM 与基线都不随句长退化,最长一档才略降。5
图注没提的是一处下探。8 词那一档两个系统一起掉到 23–24,之后才回升;最前几档句子少,平均值容易被个别句子带动。5
右图是代价那一侧。同一个模型在常见词上领先基线一大截,越往稀有词走越低,最后一档落到基线之下,约 28.8 对 30.1。5
这条下滑线就是固定词表的价格。表外词只能写成 UNK,参考句里出现表外词,BLEU 也跟着扣分。5
表 3 让这笔价格落到一个具体的名字上。原文的人名是 Ulrich Hackenberg,模型输出的是 Ulrich UNK。5
论文自己写下的局限
第一条是词表。8 万词之外一律 UNK,摘要里那句「BLEU 被表外词罚过」说的就是这件事。1
第二条是信息通路。整句话进,一个定长向量出,解码每一步都只看这一个向量;源句里哪个词对应译文里哪个词,模型只能经由这一个向量去查。5
第三条是覆盖面。一个语向、一个数据集、一对语言,作者在结论里也只用「suggests」这一级口气说它能用到其他序列任务上。5
第四条是成本。34.81 要 5 个模型同时在场,单模型是 30.59;这套配置与当年最好的系统还差 0.5 到 2 个 BLEU,取决于比的是 36.5、37.0 还是 35.8 那一栏。5
第五条是解释。倒序为什么有效,作者写「没有完整的解释」,只给出短期依赖这一个方向。5
第六条是结论的边界。「长句没问题」只到 35 词,而且这个观测是在倒序预处理下取得的;结论的覆盖面仅限英译法。5
还有一条是作者自己标出的未验证判断。结论里写相信标准 RNN 在倒序数据上也能训起来,同时写明没有做实验验证。5
后来被换掉的四件
这套系统可以拆成四格:词怎么变成向量、一句话怎么压成一个向量、一个向量怎么展开成句子、训练信号从哪来。后来的工作各换其中一格。
第一格先被换掉。固定词表加 UNK 的价格,2016 年被 BPE 子词切分顶了下去。8
做法是把罕见词拆成更小的子词单元,模型于是能拼出没见过的词。WMT'15 英德涨 1.1、英俄涨 1.3 个 BLEU。8
第二格的反驳来得更快。Bahdanau、Cho 与 Bengio 的注意力论文 v1 在 2014 年 9 月 1 日上线,比这一篇的 v1 早九天。9
它的摘要直接写「定长向量的使用是瓶颈」。办法是让解码器预测每个词时,对源句做一次软搜索。9
两篇问的是同一个问题,答案落在不同层。这一篇改的是梯度走的路径,也就是倒序;那一篇改的是信息流经的通道,让每一步都能回看源句。
2016 年的 GNMT 把第二格连同工程一起推了一步。8 层编码器、8 层解码器、注意力、残差连接,再把词拆成 wordpiece。10
相对 Google 当时的短语系统,人工并排评测的平均错误率降了 60%。10
2017 年的 Transformer 把第二格与第三格里的循环一起去掉,只用注意力搭编码器与解码器:WMT'14 英德 28.4、英法 41.8,后者用 8 块 GPU 训了 3.5 天。11
把 41.8 与 34.81 相减,得到的差里混着口径。5
读完留下的判断维度
一,先找定长在哪一步。任何「输入输出都是序列」的系统,都要在某个位置把变长压成定长;找到那个位置,就找到了它的瓶颈,也找到了后来者下手的入口。5
二,分清改动发生在模型还是优化路径。倒序不增加任何能力,却值 4.4 个 BLEU;把「改了模型」与「改了让它好学」分开记,才不会把优化技巧读成建模突破。5
三,同一个 BLEU 先问四件事:分词与脚本、词表大小、是否集成、束宽多少。34.81 与 30.59 是同一个系统的两个数,差额全在集成与束宽上。5
四,顺着曲线读代价。最高分说的是天花板,曲线的右端说的是它在哪些输入上会掉下去。5
想自己验一遍,最短的一段是改词表:把目标词表从 8 万缩到 2 万,按图 3 右图的方式分档统计 BLEU,看曲线在哪一档开始低于基线。那条分界线就是 UNK 开始收费的位置。5
References
- 1
- 2
- 3NIPS 2014 论文元数据:页码 3104–3112
papers.nips.cc
- 4OpenAlex 作品记录:被引 17,296 次,2026-10-23 查询
api.openalex.org
- 5原论文 v3 PDF 第 1 节
arxiv.org
- 6
- 7
- 8
- 9
- 10
- 11
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.