《Faster R-CNN》:让网络自己提候选框,检测如何跑到每秒 5 帧
从候选框这一步为什么成为瓶颈讲起,拆解 RPN 的滑窗—中间层—双分支结构、anchor 参考框与式 (1)(2) 的多任务损失,讲清四步交替训练与共享卷积特征如何换来每秒 5 帧,并用 VOC、COCO 的原始表格读懂 mAP 口径、消融顺序,以及这批设计后来被换掉的零件。

2015 年 6 月 4 日,Shaoqing Ren、Kaiming He、Ross Girshick、Jian Sun 把《Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks》挂上 arXiv,编号 arXiv:1506.01497。论文以会议论文的形式发表在 NIPS 2015,收录于 Advances in Neural Information Processing Systems 28;arXiv 上后来更新到第三版,注明是扩展技术报告(Extended tech report),扩展版随后以期刊长文发表在 IEEE TPAMI 第 39 卷第 6 期,1137 至 1149 页。123
四位作者当时的单位是:Ren 为中国科学技术大学的学生,这项工作是他在微软研究院实习期间完成的;He 与 Sun 在微软研究院的视觉计算组;Girshick 当时在 Facebook AI Research,这项工作的大部分是他在微软研究院完成的。4
本期的正文、公式、表格与图按 arXiv v3 这一版读。会议版摘要里那句用简洁交替优化让两个网络共享卷积特征的说法是原文;COCO、ILSVRC 2015 的结果,以及"联合训练可行"的脚注,是扩展版补上的内容。
候选框本来是别人的活
那时的目标检测系统分成两段。第一段产生候选框(region proposal):一批可能装着物体的矩形。第二段给每个候选框判类别,并把它的位置微调得更贴合物体。
第二段已经被卷积网络接手。2014 年的 R-CNN 第一次把卷积网络用进检测,做法是在每张图上先用 Selective Search 抽出约 2000 个候选框,逐个裁出来、缩放到固定尺寸,再各自送进卷积网络提特征,最后用线性分类器判类别。R-CNN 把 VOC 2012 上的 mAP 相对上一代最好结果提高了 30% 以上,代价是每张图要跑 2000 次卷积网络。5
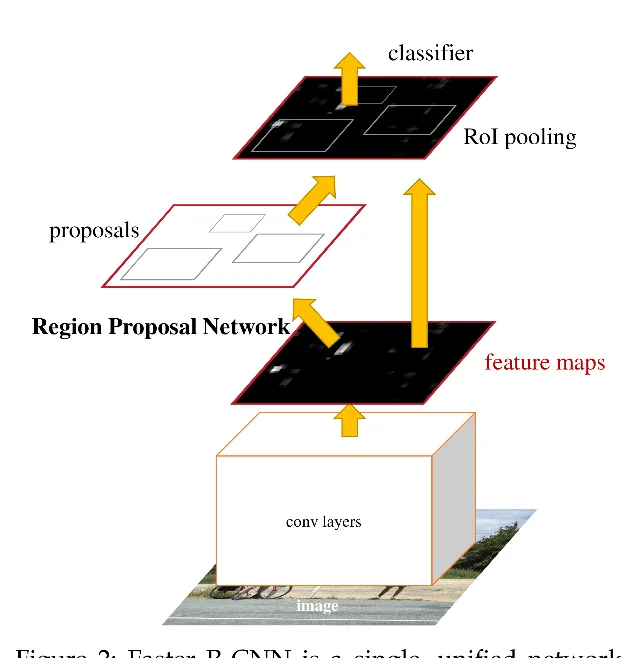
SPPnet 与 Fast R-CNN 把这份计算省下来的办法是共享。整张图只做一次卷积,得到一张卷积特征图;候选框不再各自跑网络,而是按位置在这张特征图上取区域特征(RoI pooling),分类与位置微调都在取出的固定尺寸特征上做。Fast R-CNN 因此宣称比 R-CNN 训练快 9 倍、测试快 213 倍,同时更准。67
检测网络越快,候选框那一段在总时间里的占比就越大。Fast R-CNN 有一句关键的限定语:它在忽略候选框耗时的情况下接近实时。候选框由一套独立的算法产生,最常用的是 Selective Search,它按颜色、纹理这类低层特征贪心合并超像素,一张图的 CPU 实现要两秒左右;EdgeBoxes 快一些,约 0.2 秒。而处理 2000 个候选框的 Fast R-CNN 只要 320 毫秒。4
一个直观的修补办法是把 Selective Search 改写到 GPU 上。论文自己评价这条路:它是有效的工程解,但它绕开了下游的检测网络,放弃了两边共享计算的机会。4
这篇论文要做的事情因此可以一句话说清:让网络自己在共享的卷积特征上产生候选框,把这一段变成网络里的一层,让它的边际代价小到可以忽略。4
成绩单是这样的。VGG-16 配上新结构以后,整条流水线(含候选框在内)一张图 198 毫秒,合每秒 5 帧;VOC 2007 测试集上 73.2% mAP,VOC 2012 上 70.4% mAP,每张图只用 300 个候选框。论文还写明,ILSVRC 与 COCO 2015 竞赛中若干赛道的第一名都建立在这套结构之上。4
把找框变成一次回归
新结构的名字叫区域提议网络(Region Proposal Network,RPN)。它是一个全卷积网络(fully convolutional network):整张特征图上的每个位置都用同一套小网络处理,输出的每个位置都带一组自己的框。
具体到张量,流程是这样的。在最后一个共享卷积层的输出特征图上,滑窗大小取 3×3(论文里写 ;这个窗口在原始图像上的有效感受野,ZF 网络是 171 像素,VGG 是 228 像素)。每个位置先映射成一个中间层的向量,ZF 是 256 维,VGG 是 512 维。这个向量再分给两个兄弟层:分类层(cls)输出 个分数,回归层(reg)输出 个坐标。 是每个位置上的参考框个数。4
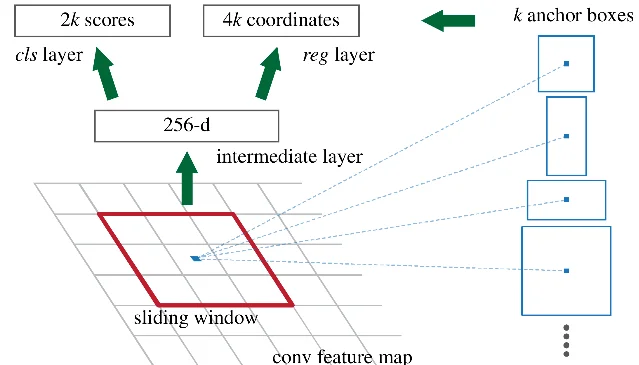
那 个参考框叫 anchor(锚框)。每个 anchor 有自己固定的面积与长宽比,默认 3 个面积(、、 像素)配 3 个长宽比(1:1、1:2、2:1),于是 。一张 1000×600 的图,最后那层特征图约 60×40,总共约 20000 个 anchor。训练时跨出图像边界的 anchor 全部忽略,因为它们该回归到哪里说不清楚,剩下约 6000 个参与训练。4
anchor 最重要的性质是平移不变。物体在图中移动一段距离,正确的候选框也应该移动同样的距离,而算这个框的函数在哪个位置都一样。这条性质让同一套回归器可以在所有位置共用,也让参数账小了两个数量级:VGG-16 下这个输出层是 ,约 2.8 万个参数;相比之下,同样做候选框的 MultiBox 用 k-means 生成 800 个参考框,输出层是 ,约 610 万个参数,而且它的参考框不具平移不变性。把特征投影层也算进来,是 240 万对 2700 万。4
多尺度这件事的处理方式也换了一路。以往有两条路:一条是图像或特征金字塔,把图缩放成多个尺度各算一遍特征;另一条是滤波器金字塔,在特征图上用多种尺寸的滑窗各自扫一遍。本文用的是参考框的金字塔:图像只在一个尺度上算一次特征,滑窗只用一个尺寸,物体的各种大小与长宽比交给"回归到哪个 anchor"来解决。论文把这一点写成设计上的关键——多尺度 anchor 让特征共享不再为尺度额外付账。4
每步在算什么
RPN 的训练目标是一个多任务损失。对一张图,损失写成两项:
第一项管分类。 遍历一个小批量里的 anchor, 是第 个 anchor 属于"物体"的预测概率, 是它的真值标签:正样本记 1,负样本记 0。 是两类的对数损失,判断的是"这里有没有物体",与物体是猫还是狗无关。4
第二项管位置。 是预测框的四个参数化坐标, 是对应真值框的四个量,回归损失用 smooth L1。前面的 是一个开关:这一项只在正样本上生效,负样本的坐标无从谈起。两项分别除以 与 再按 加权;实现里 取小批量大小 256, 取 anchor 位置数约 2400, 取 10,使两项归一化之后量级相当。4
四个坐标的定义是这篇论文里最值得动手算一遍的一行:
、 是框的中心,、 是宽和高,下标 a 表示 anchor,带星号的是真值。网络预测的是相对 anchor 的偏移,而不是框的绝对坐标。中心点偏移被 anchor 的宽高除了一次,于是不同大小的 anchor 给出的偏移量处在同一个量级;宽高比取对数,是因为宽比高在尺度上是乘性的,取对数后变成可加的量。这样回归量的数值范围被压在一个小邻域里,训练更稳。4
正负样本的定法是:与任意一个真值框的 IoU 大于 0.7 的 anchor 记为正,与某个真值框 IoU 最高的那个 anchor 也记为正(这一条保证每个真值框至少有一个正样本);与所有真值框的 IoU 都小于 0.3 的记为负;落在两者之间的 anchor 不参与损失。IoU(intersection over union,交并比)指的是两个框交集面积除以并集面积,取值从 0 到 1,用来衡量两个框重合得有多好。4
每张图随机抽 256 个 anchor 组成一个小批量,正负样本至多各占一半;如果正样本不到 128 个,就用负样本补满。这一步必须做,因为一张图里背景位置的 anchor 远多于压在物体上的 anchor,直接对全部 anchor 求和会让损失被负样本主导。4
测试时的收尾有两步。RPN 输出的框会互相高度重叠,先按分类分数做非极大值抑制(non-maximum suppression,NMS),重叠的框只留分最高的那个,阈值取 IoU 0.7,一张图剩下约 2000 个候选框;再取分数最高的 300 个交给 Fast R-CNN。300 是上限,实际数量往往更少。这个 300 与"零成本"是同一件事的两面:候选框少了,后面逐区域的分类层也就便宜了。4
训练的其他设置一并记下:图像短边缩放到 600 像素,只用单尺度;ZF 与 VGG 在最后一个卷积层的总步长都是 16 像素。学习率 0.001 跑 6 万个小批量,再降到 0.0001 跑 2 万;动量 0.9,权重衰减 0.0005;共享的卷积层用 ImageNet 分类预训练权重初始化。ZF 调全部层,VGG 从 conv3_1 开始调,为的是省显存。4
两个网络怎么共用一份卷积
RPN 与 Fast R-CNN 分开训练时,各自都会去改那份共享的卷积层,改法互相冲突。论文给了三种让两者共享的办法。
第一种是交替训练,本文所有实验用的都是它,一共四步。① 用 ImageNet 预训练权重训 RPN,得到候选框。② 用这些候选框训一个独立的 Fast R-CNN 检测网络。③ 用检测网络的权重去初始化 RPN,固定共享卷积层,只微调 RPN 独有的层,两个网络从此共用同一份卷积。④ 继续固定共享层,只微调 Fast R-CNN 独有的层,得到统一的网络。再做更多轮收益已经可以忽略。4
第二种是近似联合训练:把两个网络合成一个,每次迭代的前向过程里,RPN 产生的候选框被当作已经固定的框来训练 Fast R-CNN,反向传播时两个损失的梯度在共享层上相加。它忽略了对候选框坐标本身的导数,所以是近似的,但实测结果接近,训练时间省 25% 到 50%,并且放进了官方发布的 Python 代码。第三种是严格意义的联合训练,需要 RoI pooling 层能对框坐标求导,这要额外实现一个 RoI warping 层,论文把它排除在范围之外。4
论文还有一条脚注值得单独记:会议版发表之后,作者发现 RPN 可以与 Fast R-CNN 直接联合训练,训练时间更短。这一句是扩展版补上的,也解释了为什么后来的实现大多直接用联合训练。4
实验怎么读(一):同一张表里的三类证据
第一张表(VOC 2007 测试集,ZF 网络)把不同提议方法放进同一个 Fast R-CNN 检测器里比较。Selective Search 用 2000 个框得 58.7% mAP,EdgeBoxes 用 2000 个框得 58.6%,RPN 与检测器共享特征、只用 300 个框得 59.9%。这一行同时说明两件事:提议质量不输外部算法,而且数量少了一个数量级。4
同一张表的下半部分是消融,读之前要知道它换了协议:作者先固定一个用 Selective Search 训好的检测器,此后只改测试时喂进去的候选框。这个设置把"提议好不好"从"检测器好不好"里单独拎出来。换成 RPN 的 300 个框,mAP 掉到 56.8%,掉的原因是训练时用的是 Selective Search 的框,测试时换成了另一种分布;这一行 56.8% 就是后面所有对照的基线。只给 100 个框仍有 55.1%,不做 NMS 直接给 6000 个框是 55.2%——NMS 在这里省下了大量候选框,检测精度没有受损。4
接着拆 RPN 的两个输出。把分类层去掉(也就没有排序和 NMS,只能从没打过分的区域里随机取),取 1000 个框时精度几乎不变(55.8%),取 100 个框时掉到 44.6%。这说明排在前面的那些框之所以准,靠的是分类分数。把回归层去掉,候选框退回成 anchor 本身,精度掉到 52.1%:anchor 虽然覆盖了多个尺度与长宽比,作为一个框它还是太粗,真正的精度来自回归出来的偏移。4
换成 VGG-16,主结果长这样:共享特征时 VOC 2007 上 69.9%,加进 VOC 2012 的训练数据后 73.2%,再加 COCO 数据后 78.8%;不共享特征是 68.5%。共享带来的 1.4 个点在这里可以单独看:论文的解释是第三步用检测网络调过的特征去微调 RPN,候选框质量跟着提高。4
这张表里有一个脚注必须在读数字前看到。第一行 Selective Search 的 66.9% 后面带一个剑号,那是 Fast R-CNN 论文当年报告的数字;用这篇论文自己发布的仓库去跑同一个基线,得到的是 68.1%。同一套方法、两次测量、差 1.2 个点,原因是实现细节与超参。这一行的数字来自别处,其余数字是本文实测,证据等级不同。4
时间账在另一张表里,单位是毫秒,一张 K40 GPU。VGG-16 配 Selective Search 的 Fast R-CNN:卷积 146、提议 1510、逐区域计算 174,合计 1830,约每秒 0.5 帧。换成 RPN:卷积 141、提议 10、逐区域计算 47,合计 198,每秒 5 帧;其中逐区域计算也变便宜了,因为候选框从 2000 个降到 300 个。ZF 网络下合计 59 毫秒,每秒 17 帧。读这张表要记住论文自己的提醒:Selective Search 那一格的提议耗时是在 CPU 上测的,其余都在 GPU 上,这种比较本身并不公平——公平的那一半是"共享特征后,提议的边际代价只有 10 毫秒"。4
实验怎么读(二):超参不敏感与召回曲线
anchor 的设置被单独扫了一遍。一个位置只放一个 anchor,用 时是 65.8%,用 时是 66.7%;一个尺度配三个长宽比, 时 68.8%, 时 67.9%;三个尺度配一个长宽比是 69.8%;默认的三个尺度配三个长宽比是 69.9%。只留一个 anchor 要掉 3 到 4 个点。还有一个反直觉的结果:在这份数据上,三个尺度配一个长宽比(69.8%)与默认设置几乎一样,作者因此写道,尺度与长宽比在这份数据上算不上两个互相独立的维度,保留它们是为了让系统在别的数据上更灵活。4
损失里的权重 扫下来是这样:0.1 得 67.2%,1 得 68.9%,10 得 69.9%,100 得 69.1%。在两个数量级的范围内摆动,结果只动约 1 个百分点。作者据此说结果对这个权重不敏感,同时也承认当前的归一化方式并非必要,可以简化。4
还有一张曲线图值得单独说,因为它最容易被当结论用错。作者算的是不同 IoU 阈值下的召回率:候选框里有多少真值框被盖到。RPN 在候选框从 2000 个降到 300 个时召回下降平缓,Selective Search 与 EdgeBoxes 掉得更快,这解释了为什么 300 个 RPN 候选框还能保住检测精度。论文自己写明了这张图的定位:召回率与最终检测精度只是松散相关,它适合用来诊断提议方法,不适合用来评价它。看到别人拿召回率证明检测器更强时,回到这句话。4
论文还给了一组一阶段与两阶段的对照,做法是模拟 OverFeat:不用提议网络,直接在密集滑窗上做检测,20000 个候选框,配同一个 Fast R-CNN 检测器。两阶段(RPN+ZF,不共享,300 个框)58.7%,一阶段单尺度 53.8%、五尺度 53.9%,差 4.8 个点。作者的结论是级联结构有效。读这一行要两件事一起看:这个一阶段系统是作者为对照而搭的模拟,不是 OverFeat 本来的系统;而 OverFeat 的原始设计正是滑窗加回归的密集预测。48
实验怎么读(三):换数据集、换指标
COCO 上的结果要用两套指标一起读。这套基准的通用指标记作 mAP@[.5,.95],它在从 0.5 到 0.95 的多个 IoU 阈值上取平均,比 VOC 的 mAP@0.5 严格得多。作者重实现的 Fast R-CNN 在 COCO test-dev 上是 39.3% mAP@0.5 / 19.3% mAP@[.5,.95],Faster R-CNN 是 42.1% / 21.5%,用 trainval 训练后是 42.7% / 21.9%。同一个模型的两列数字差一倍多,它们量的不是同一件事,不能混着跟别的论文比。论文由此说 RPN 在提高高 IoU 阈值下的定位精度上表现更好。4
跨数据集的数字里有一个容易误读的 76.1%。只用 COCO 训练的模型,不在 VOC 上微调,直接拿到 VOC 2007 上测,得到 76.1%,比只用 VOC 07+12 训练的 73.2% 还高;再在 VOC 上微调一轮是 78.8%,比 73.2% 高出 5.6 个点。76.1% 能成立,靠的是这套基准的类别设计:COCO 的类别是 VOC 的超集,VOC 那 20 类都能在 COCO 里找到对应,输出的 softmax 只在 20 类加背景上做。这是一次协议允许的跨库评测,读的时候要把它和"没见过的类别也能识别"区分开。4
论文还量了骨干网络换代的收益:把 VGG-16 换成 101 层的残差网络,COCO 验证集上的结果从 41.5% / 21.2% 升到 48.4% / 27.2%。作者随后引用同期工作里更完整的改进,COCO test-dev 上单模型 55.7% / 34.9%,集成 59.0% / 37.4%,拿下 2015 年 COCO 检测第一;同一套系统在 ILSVRC 2015 检测赛道也是第一,比第二名高出 8.5 个绝对百分点。这两行数字来自本文的转述,不是本文自己测的。4
局限:哪几条推不出来
这套结构仍然是两阶段的:RPN 出候选框,Fast R-CNN 再判类别,测试时还要 NMS 去掉重叠框,并靠 300 个候选框这个上限控制代价。4
anchor 的尺度与长宽比是手工选定的超参。论文说这些值没有针对具体数据集精心挑选,同时 Table 8 显示只用一个 anchor 要掉 3 到 4 个点、三个尺度配一个长宽比几乎同样好。既然后者在这份数据上够用,那"三个长宽比是必要的"就推不出来。4
小目标是这套设置的弱处。总步长 16 像素,图像短边只取 600 像素,作者在 COCO 上额外加了一个 的 anchor 尺度,理由就是照顾小物体,并且写明步长再小一些精度还有提升空间。4
训练方案上有取舍。本文实验用的四步交替训练比较麻烦;近似联合训练省时间,但忽略了对候选框坐标的导数,理论上不完整;严格版本需要本文范围之外的实现。用于对比的一阶段系统是作者为对照搭的模拟,它的 4.8 个百分点差距只属于那个配置。4
召回曲线与检测精度只是松散相关,这是论文自己划的界。全文没有定理、引理或收敛性结论,它给出的是一套结构、一组实验和一组经验规律。4
影响与延伸:候选框这一步后来被换掉了几次
把论文的设计拆成四个可替换的位置——候选框由谁产生、一次用多少个、重叠的框怎么去、谁来判类别——后续工作的分工就很清楚。
YOLO(Redmon 等,2015 年 6 月首次提交,arXiv:1506.02640)动的是"由谁产生"。它把检测写成一次回归:整张图过一遍网络,直接输出一堆框和类别概率,候选框这一段整体消失,代价是定位误差偏大、小物体更差。它的基础版本每秒 45 帧,比本文的 5 帧快一个数量级,用精度换速度。9
SSD(Liu 等,arXiv:1512.02325)保留 anchor 的思路,把它铺到多个不同分辨率的特征图上:每个位置有一组不同尺度与长宽比的默认框(default box),小物体靠高分辨率特征图上的框接住。它属于一阶段阵营,却把本文那套"参考框的金字塔"搬了过去。10
FPN(Lin 等,arXiv:1612.03144)动的是多尺度从哪里来。本文用一个尺度上的特征图配多种 anchor;FPN 把卷积网络自带的层级结构做成特征金字塔,用自顶向下的路径与横向连接把高层的语义带到高分辨率层,额外代价很小。它解决的是同一件事的另一种做法。11
RetinaNet(Lin 等,arXiv:1708.02002)回答了本文 Table 10 那个 4.8 个点背后的原因。它指出一阶段检测器落后的主因是训练时前景与背景的类别极端不平衡,并用 focal loss 让大量易分的背景样本的权重降下来。改掉损失之后,一阶段在精度上追平了两阶段。换句话说,那 4.8 个点里有一部分属于当时的损失与采样设计,而不是级联结构本身的功劳。12
Mask R-CNN(He 等,arXiv:1703.06870)在这套骨架上加了一条分支:检测框与类别照旧,同时逐实例预测分割掩码,速度仍是每秒 5 帧,还能顺手做人体关键点。它说明"两阶段 + anchor"这个骨架可以承载检测之外的任务。13
FCOS(Tian 等,arXiv:1904.01355)把 anchor 本身拿掉:每个像素直接回归到物体框四条边的距离,逐像素预测,连 anchor 有关的超参一并去掉。它的摘要把动机写得很直接——当时主流检测器大多依赖预设的 anchor 框,而 anchor 相关的计算与超参都麻烦。14
DETR(Carion 等,arXiv:2005.12872)走得更远:把 anchor 与 NMS 一起去掉,检测变成集合预测,用二分匹配让每个预测对应一个目标。它把检测接回了 Transformer 这条线,也把"用多少个候选框"这个问题彻底换成了"网络直接输出几个目标"。15
这几条线合起来说明的是:被换掉的从来不是某一个模块名,而是"候选框由谁产生、用多少个、冗余怎么去"这一组决定。本文把这一组决定交给了共享特征上的一次回归,此后每一次改动都在重新分配这组决定,而检测框架的整体形状(骨干提特征、再加一个轻量的头部)一直留到了现在。4
读完留下的判断维度
一,先分清系统的每一段由谁产生、代价记在哪一段。本文真正的贡献是把两段并成一段共享计算,而它在标题里承诺的"实时"来自整条流水线的总时间,其中被替换掉的那一段原本记在 CPU 上。
二,读一张表之前,先确认训练与测试用的是不是同一套配置。Table 2 的消融里,检测器是用 Selective Search 的框训的,测试时换成 RPN 的框,56.8% 那个数字量的是这个不一致,而不是 RPN 的上限。
三,指标与它想衡量的东西之间有多紧,要看作者自己怎么写。召回率与检测精度只是松散相关,是本文作者写下的;mAP@0.5 与 mAP@[.5,.95] 量的也不是同一件事。看到一个结论时,先找它挂在哪个指标上。
四,时间表要看硬件与实现口径。同一张表里提议在 CPU 上测、检测在 GPU 上测,作者自己说这种比较不公平;同一个人用同一套代码跑两个版本,也能差出 1.2 个点。看速度结论时,先看这四个字:在什么上。
References
- 1
- 2
- 3
- 4原论文首页的作者单位与致谢脚注
arxiv.org
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.