
逐段要点整理
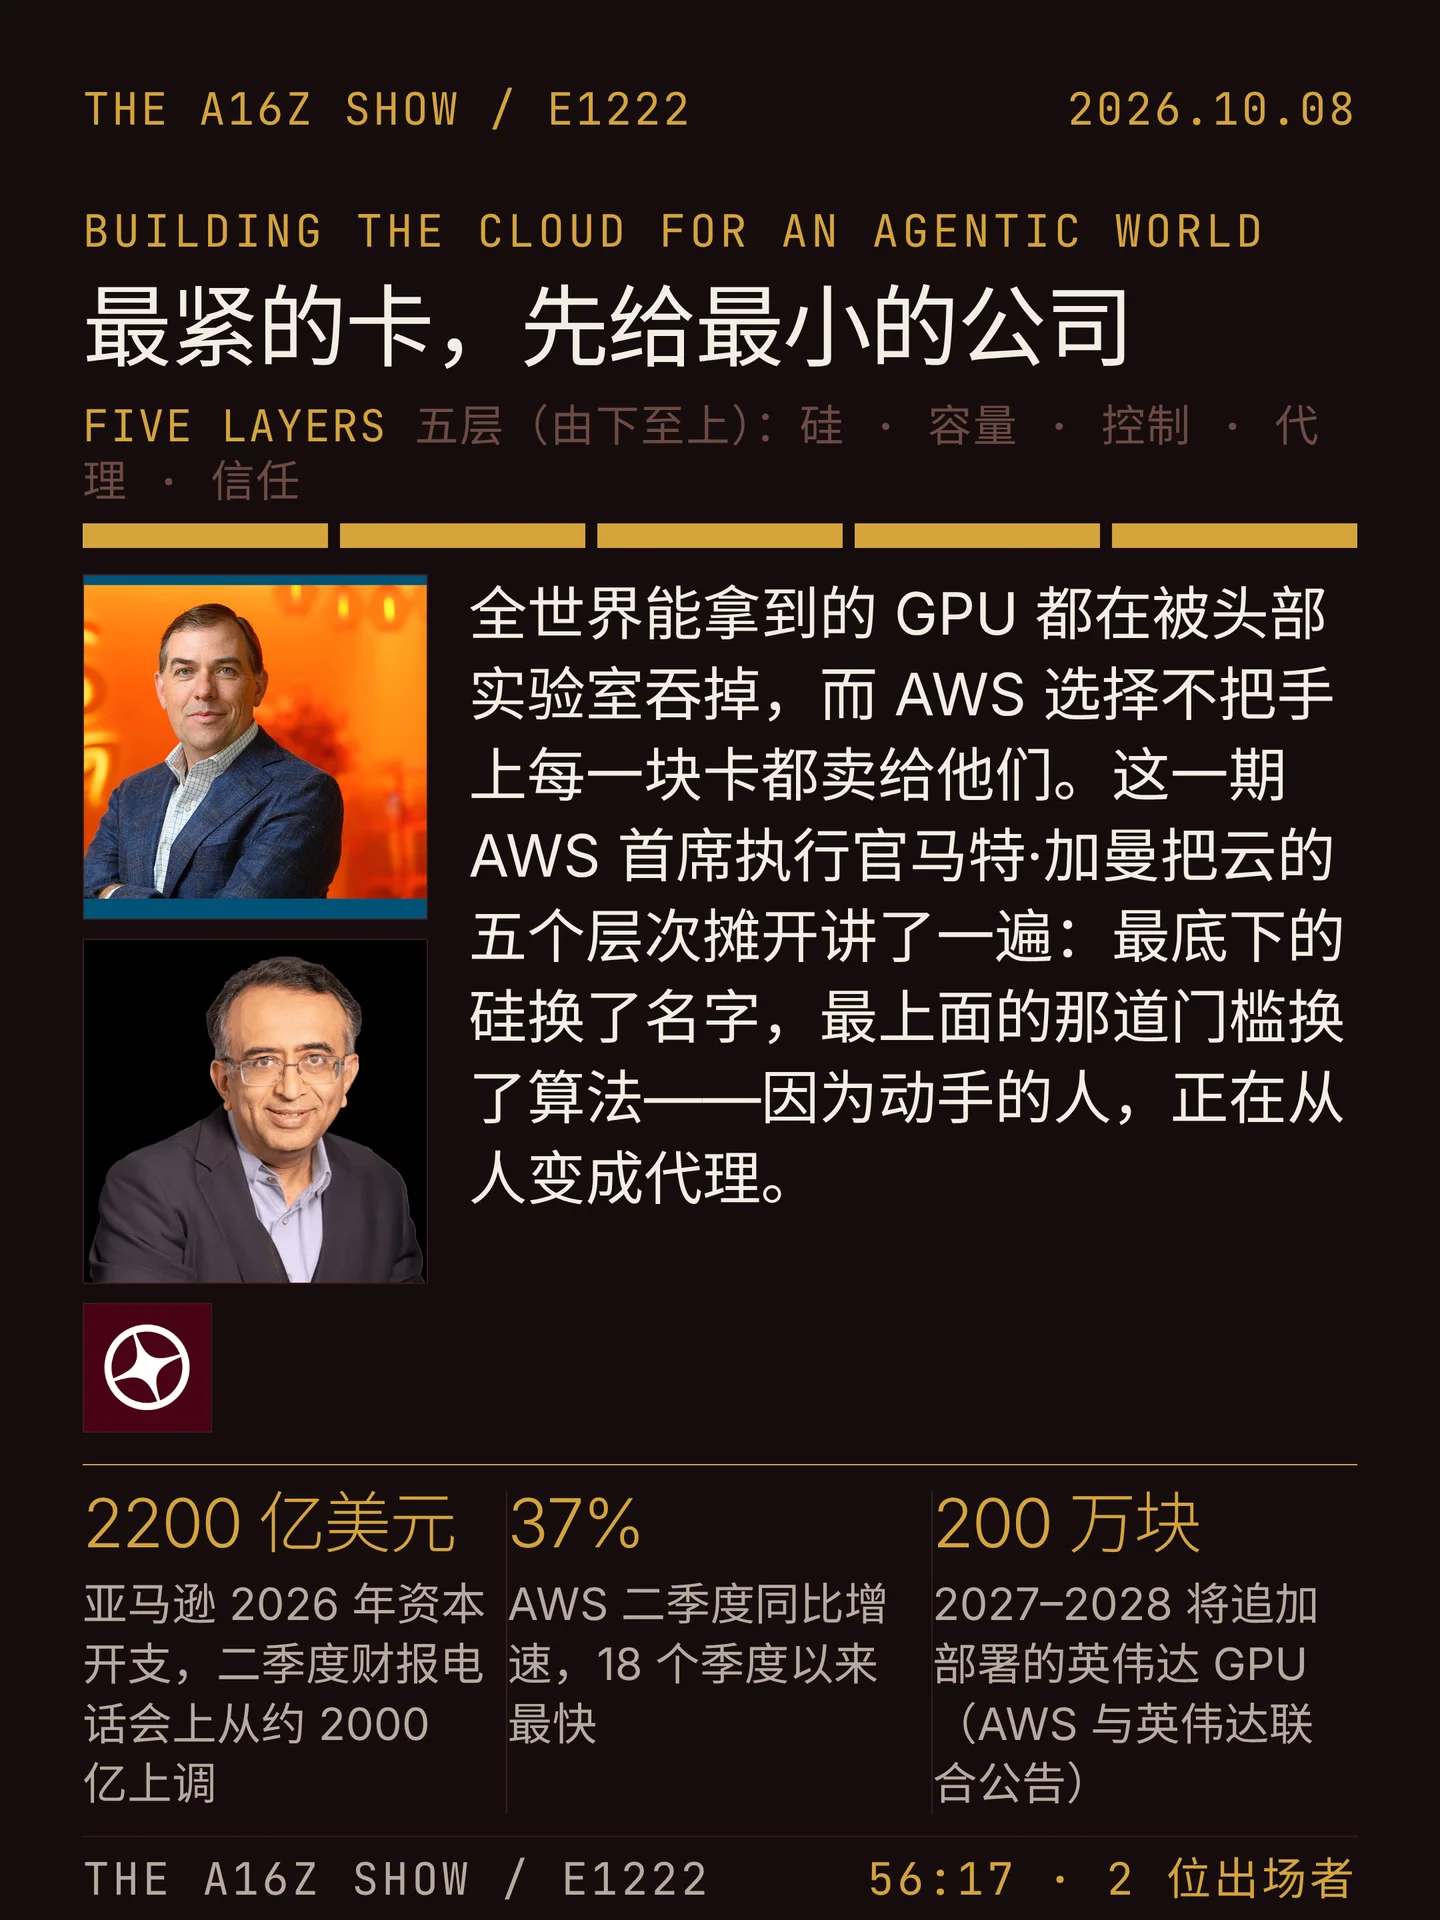
下面按本期音频的实际推进顺序,逐段整理两位出场者讲到的主要论点、数据、案例与金句。本期出场两人:主持拉古·拉古拉姆(a16z 管理合伙人,成长与基础设施投资,此前在 VMware 做到 CEO)、嘉宾马特·加曼(AWS 首席执行官,2024 年 6 月上任,AWS 第一位产品经理)。910
本期官方节目页与 RSS 都没有给出章节表,官方同名视频在本刊截稿时也尚未上线;下面的时间点为音频中的实际播出位置,逐句译文底稿即来自这版整集音频。
01:46 开场:EC2 的第一任总经理,和 1690 亿美元
- 加曼是 EC2 的第一任总经理(2006 年),他报的现状是:年化约 1690 亿美元、同比增长 37%。2
- 他的分寸感很值得记:「我们还是处在这门生意能长成什么样子、对客户的机会有多大的极早期阶段。」理由是今天还有海量工作负载跑在本地机房里,而人们每天做的计算量比前一天更多。
- 拉古插了一句自嘲:「我想聊聊本地那一块——那一块有点让我想不通。我当年显然是尽了最大努力把客户留在本地的。」(他此前在 VMware 二十年。)
03:31 这套生意的起点:2005 年那个没名字的实习项目
- 加曼 2005 年在亚马逊实习,那个项目就是安迪·贾西在推的一个没名字的内部项目——后来的 AWS。他当时的实习题目,是分析「AWS 对谁最有趣」,结论是创业公司。
- 2006 年全职回来做产品经理时,AWS 全球销售团队只有三个人;他亲手带过 EBS。此后带过虚拟化团队、存储团队,也带过销售团队——从带 5000 人变成带 50000 人。
- 他给出的比例是:AWS 大约 30%–40% 的收入,来自那些在 AWS 生命周期里曾经是创业公司的企业。(节目口径,本刊未找到可独立核对的公开数字。)
05:21 创业公司变了什么:第一天就值十亿美元
- 最直观的变化是起步体量:以前可能拿 1000 万美元融资、慢慢迭代一个 App 点子;现在是第一天估值十亿美元、拿了 2 亿美元融资——「一个团队加一个想法,一转眼就值十亿美元了」。
- 没变的是另一件事:他们仍然在想架构、安全、性能和 IAM 怎么配——「好让我从三个人变成更多人的时候,这套东西还能跑。」这正是他们选 AWS 而不是直接找一家新云的原因。
- 加曼点出第三个新要求:越来越多公司想要一朵不只是对人友好、也对代理友好的云。他要的三件东西很朴素——规模、性能,以及「一个定义清晰的 API 接口,让代理能真正轻松地穿行」。
08:59 面向代理的云:AgentCore、Bedrock 与 AWS Context
- 被问到有没有专为代理做的新服务,他的回答分两层:一层是专为构建代理设计的服务(AgentCore、Bedrock);另一层是把已有服务改成人和代理都能用——例如 S3。
- 他给了一个具体例子:一个在预览阶段、叫 AWS Context 的服务,让你搭出一层上下文,让代理能跨过 Aurora、S3 和 AWS 其他存放位置去找到它要的数据——「人类并不一定会那样去访问数据,但代理很乐意。」
- 代理和人真正不同的地方是延迟:「人有时候并不在意 S3 的 P999 延迟,但代理在意,而且会被它卡住。」他把这一点讲成「为什么代理式工作流在 AWS 上表现更好」的原因。
10:17 代理接手之后最难的三件事
- 第一件:数据库的五九个九。 很多代理想创建一个数据库、干一点活、然后让它消失;而 Aurora 是为生产库设计的,「你需要持久性,你想要可用性」。难点是要同时做到「快速创建、随手扔掉」和「长成一个生产数据库」——他不愿意提供一个非持久的选项了事。
- 第二件:创建持久资源的规模、速度和延迟。 这是「代理要用的更短暂的基础设施」与「传统生产系统能力」之间的取舍。
- 第三件:全新的积木。 他点名三样——计算的沙箱、网关、代理的权限。「不是把现有积木换个用法,而是全新的积木。」他给的原则是:你不该把你的权限直接交给代理,而要有时限很短的、细粒度的授权。
15:11 Firecracker:十年前的东西正好合代理的用
- 沙箱那一层,他指出了一个现实细节:「很多做沙箱的公司、很多创业公司都在用 Firecracker。」那是亚马逊大约十年前的微虚拟机技术。
- 它本来不是为代理做的,但「你可以极快地把它拉起来,它有一个很好的安全边界,而且没有传统大虚拟机那种虚拟化开销」——加曼由此说了一句更大的判断:这些就是正在冒出来的全新原语。
15:59 怎么才能拿到 GPU:2200 亿美元与分配策略
- 拉古把问题问得很直:前沿实验室在把所有能拿到的 GPU 吞掉,而你也想扶持明天的大企业,你怎么平衡?
- 加曼先摊资本开支:2026 年是 2200 亿美元,「比我们历史上任何时候都更大的支出,也许是任何一家公司在单一年度里都没有过的」,而且「我们不预期很快慢下来,因为需求实在太大了」。
- 然后是分配原则,也是这一期最像政策的一段:「我们其实可以把手上每一块 GPU 或 AI 加速器都只卖给头部前沿实验室,大概一天就能卖光。我们选择不那么做,因为我们想让整个生态继续长起来。」
18:53 六成请求、两百万块卡,和一道没人能拍的胸口
- 他给了一个很少有人公开的比例:创业公司提出的算力请求里,大约六成最终以某种形式被满足——「有时候晚一点,有时候在另一个区域,有时候配置和客户想要的略有不同」。(节目口径。)
- 供给那一侧:AWS 与英伟达在 2026 年 8 月宣布,2027–2028 年追加部署 200 万块 GPU。4 加曼自己的评语是:「谁知道够不够?我完全不知道。」
22:40 分散度:没有任何一个客户超过个位数百分比
- 被问到「投这么多钱你不怕泡沫吗」,他给的反驳不是需求,而是结构:有些新云或供应商会出现一两个客户占 30%、40%、50% 甚至 60%,而AWS 最高也就是个位数百分比。
- 他承认这是一个「好问题」,但接着说了两句:「不存在一个『他们不再为这件事花钱』的泡沫」;以及关于 VC——「你押十个,一个成了,就把另外十个的钱赚回来。」
24:49 电力:从「跟他们要十兆瓦」,到自带电力
- 十五年前,需要更多电就找电力公司要几十兆瓦;现在亚马逊自己把电力带进来、为电力项目出资本,项目接进电网后再从中拿额度,表后自建也做。
- 规划的时间尺度也变了:从按几个季度跟供应商谈服务器,变成按 26、27、28 三年一起想。他的总结是:「这是客户凭自己确实做不到的事。」
27:19 约束永远是最新的那一个
- 加曼把本科读的《目标》(讲约束理论的那本书)搬了出来:「从来就没有唯一一个约束,永远只是最新的那个。」他随手列了一串:电力、内存、台积电产能、HBM、网络部件、连接器、SSD,还有施工队——「施工人员今天是有溢价的」。
- 他还补了一条容易被忽略的维度:约束出现在哪里也很重要——「我们在印尼有大量电力,但在德国不够。」
- 供应链要往下想四层、五层;他举的两个历史例子是泰国的洪水让所有人没有磁盘驱动器,以及后来的内存危机。
29:38 数据中心的舆论:那个县每人少交 5000 美元的税
- 他同意这个行业没有把「数据中心为什么好」讲清楚,并说「你会在这件事上听到我们说更多」。
- 他给出的辩护包括:可再生能源、水正效益(他特别说「我们的数据中心用水量非常非常小,主要用自然风冷」)、以及社区税基——他提到自己看到一份报告:我们运营所在的某一个县,因为亚马逊带来的税基,当地每人每年少交 5000 美元的税,而「我们没告诉过他们,他们甚至不知道」。(这一处是节目中的说法。)
- 他也批评了同行:「有些被详细报道过的例子,不太在意监管」,而「整个行业会被一起归类」。
32:16 自研芯片:Nitro → Annapurna → Graviton → Trainium
- 这条路的起点是虚拟化税:他们先把网络虚拟化挪到一张卸载卡上,让性能逼近裸金属;然后找到一家在卸载卡上放了 ARM 核心的公司(Annapurna),问它能不能顺手做存储虚拟化。
- 收购后他们让团队做一张更大的卡,把虚拟化从服务器里彻底清掉;再从卡上那些 ARM 核心长出了Graviton——第一代在他嘴里是「一款性能很弱、很小的服务器」。
- Graviton 现在的位置:按节目口径便宜约 20%、性能好约 20%,保持了五六年;前 100 大客户里大约 90% 以上在用。亚马逊官方页的对应口径是服务于前 1000 大 EC2 客户中的 98%、逾 13 万客户在用、超过一半新增算力跑在 Graviton 上。3
- Trainium 是五六年前开始做的,现在是第三代,加曼说产能「大概已经卖到明年年底左右」。
37:08 「我们起名很差」:Trainium 成了推理芯片
- 拉古指出这名字听起来是训练芯片,加曼笑着承认:「对,我们起名很差。」原本是 Inferentia 做推理、Trainium 做训练;模型变大之后,推理也要跑在超大系统上,于是他给出了一句很重的判断:「从绝对性能和性价比的角度看,Trainium 现在可能是市面上最好的推理芯片。」(本刊未找到可独立核对的第三方基准。)
- 他补的横向事实是:Bedrock 上大部分流量跑在 Trainium 上,另外有六到十二家更小的创业公司在它上面做东西。亚马逊官方页的口径与之接近:Bedrock 的大部分推理跑在 Trainium 上。
- 产能的另一面是承诺:Anthropic 承诺使用最多 5 吉瓦的 Trainium 容量(目前跑在 100 万块以上 Trainium2 上);OpenAI 承诺 2027 年起消耗约 2 吉瓦;Meta 签下数千万颗 Graviton 核心;Uber 用 Graviton 做实时匹配并试点 Trainium3。3
39:20 企业采纳代理:拖着他们的两件事
- 现状判断很克制:「大多数企业建出来的代理还相对简单直接,而且大多还不是自主的——还处在有人在环路里的状态。」但他立刻补上:这不等于没价值,客户今天已经从这些简单代理里拿到了很多价值。
- 第一件事是「怎么想」。他批评得很直接:不要让代理照着鲍勃的五步工作流做一遍,最后让鲍勃检查。「它可以试五十种不同的做法然后走到那里。真正的价值在于用一张白纸去想。」
- 第二件事是「怎么敢信」。他列了企业真正在问的:系统安不安全?能不能信任代理做决定?护栏对不对?权限对不对?会不会删生产系统?会不会犯下悲剧性的错误?他认为这种紧张感是恰当的。
43:03 评估、FDE 与 45 天
- 他把「评估」拆成五个企业解不了的子问题:怎么建一个不断测试的回路、怎么想目标导向、怎么把数据标注到评估能近似生产、怎么在生产里衡量并回测以免看到漂移。他的判断是:「我不确定今天有谁真的把这几个问题解得很好。」
- 所以他押的是前向部署工程师(FDE),而且给的是一条反咨询的路线:与客户并肩工作 45 天,教他们建评估、把数据以标注好的形式组织起来,然后离场——「他们不想在未来五年里被一支外部人力队伍绑住。但他们今天需要帮助。」
46:30 开源权重、SageMaker 与 Bedrock 的数据保证
- 对「不该把所有数据都送进大模型」这半句,他完全同意,并给出 Bedrock 的承诺:「你的数据永远不会离开你的 VPC……他们永远看不到你的提示词。」(产品承诺口径,本刊未逐条核对官方条款。)
- 对「用开源权重加自己的数据做后训练」,他的答案是这件事今天主要发生在 SageMaker 上——「SageMaker 正迎来一次新生,因为它一直算是一个模型构建平台」。
47:12 安全:Continuum 与机器速度
- 被问到 CEO 们对安全漏洞、对 Hugging Face 那次攻击的担心,他给了一组并列:「是的,那对客户环境来说是真实的风险;但它同时也是一个真实的机会。」
- 机会那一半是一个叫 Continuum 的服务:扫过客户环境找漏洞、按业务影响排优先级,因为它知道客户环境里的权限与补偿性控制。他的原话是:「到了某个点,客户需要的安全是机器速度的安全,不是人的速度。」7
51:11 AWS 内部:代理已经在写代码
- 他把 Amazon Quick 推给了每一个亚马逊员工,然后讲了两件自己在内部看到的事:HR 团队在建代理做团队规划与资源管理;财务团队在建代理去抓各处的税法、确保合规。「以前一个团队要花几周才能做完的事,现在一个人几个小时就能做完。」8
- 被问到内部最大的收益出现在哪里,答案是软件开发,而且他划清了区别:「它真的是代理优先:代理写所有的代码,你只是在管理一支代理团队。这不是代码补全。」
- 亚马逊官方在 2025 年 12 月把这一类东西命名为前沿代理,并写下了从自己团队里总结的三条:别盯着每个小任务、团队速度取决于能同时跑多少代理任务、代理能独立跑多久价值就有多大。
54:11 组织要变:十个人做的事,三到四个人做完
- 他先承认「我还不知道那个神奇的答案」,然后给了一个正在试的版本:过去一个团队长期拥有一块能力、可能有十个人在做;现在三到四个人就能很快做完,于是你其实想把他们挪到别的项目上去——「怎么既运营和维护已经建好的东西,又保持敏捷和灵活,这些是我们正在实验的。」
- 他给这一层留了一句人味的话:「我们的员工其实很喜欢,因为他们能建得更快、做得更多。但这里面有实打实的功夫。」
- 收尾很干脆:拉古道谢离场,节目照例播报订阅方式与免责声明。
本刊补充:这一期没有聊到的三件事
- 份额:加曼给了自家 +37%,但没有提 Synergy 口径下微软与谷歌更快的增速,以及 AWS 份额停在 28%(微软 20%、谷歌 15%)。5
- 价格:自研芯片能省多少,本期只有相对比例(20% / 40%),没有绝对价格。
- 退出:如果哪天不想再走自研芯片这条路,迁移成本有多大——这一期没有回答。
逐句全文翻译
下面按节目原始顺序,逐句翻译整集对话。只保留中文译文,不保留英文原文;对话部分保留说话人标签:片头/拉古/马特/片尾。
底稿是本期整集音频的完整机器转写(56:17)。这一期官方同名视频在本刊截稿时尚未上线,因此没有官方字幕可用;说话人归属由内容判定——这一期是两人对谈,主持提问、嘉宾作答——不是音频分离结果。转写中有两处按位置处理:一处把英文词误成中文读音的碎片已按上下文还原,一处同时说话造成的断句保留为省略号。其余逐句保留,不压缩、不摘要、不删减。
片头:代理式工作流在 AWS 上的表现,比在任何别的地方都好。计算的沙箱、网关、代理与人的权限划分——这里面很多东西是我们建好的、正在建的,也是我们正在认真想的。头部的那些前沿实验室,把所有能拿到的 GPU 都吞掉了。可与此同时,你也想扶持那些会成为明天大企业的年轻公司。这两头怎么平衡,你是怎么想的?从我们做 AWS 的第一天起,创业公司就是这门生意最核心的命脉。他们是处在技术最前沿的那批创新者,他们知道什么是可能的。我们对「给创业公司留出容量」这件事是非常刻意的。我们最近宣布,未来几年要买两百万块英伟达的 GPU。你们的资本开支是多少来着,两千亿出头?2026 年是 2200 亿美元。而且我们并不预期很快慢下来,因为需求实在太大了。围绕 AI 的这一堆争论、外溢风险,还有 Hugging Face 那次攻击——CEO 们都在问你什么?亚马逊今年计划投入 2200 亿美元资本开支,而 AWS 首席执行官马特·加曼说,他们不打算在短期内放慢。这一期,a16z 的拉古·拉古拉姆与马特坐下来,拆解这轮史上规模最大的基础设施扩建是什么在驱动,以及 AI 如何正在改变云本身。他们谈到 AWS 怎么决定把紧张的 GPU 容量给谁,瓶颈如何从电力与芯片转向内存与施工,以及公司在自研芯片和 Trainium 上的下注。他们还谈到当代理越来越多地写代码、管理基础设施时,什么变了。马特也分享了 AWS 自己团队里正在发生的事:代理已经在写代码,工程师越来越多地在管理一支支代理团队,新产品被做出来的速度因此加快。片头:欢迎来到节目,马特。我们正活在一个不得了的时代。我有很多话题想跟你聊。太好了,谢谢你邀请我,我很期待。那我们就从最开始讲起吧。你是 EC2 的第一任总经理,那是 2006 年,对吧?今天你们是多少收入来着,1600 亿、1700 亿?对,大约 1690 亿、1700 亿美元,增长 37%。1690 亿还增长 37%。是的。马特:这太疯狂了。这里面有太多手艺了。从我们挣到第一块钱那天想起,会觉得很有意思。但有意思的是,我们其实还处在这门生意能长成什么样子、对客户的机会有多大的极早期阶段。今天还有海量的工作负载跑在本地机房里。而人们每天在做的计算量,比前一天更多。所以你看到 AI 带来的顺风,也看到上云迁移带来的顺风,这门生意长得非常快。能参与其中是件特别好玩的事。拉古:是啊,确实是。会有历史书和商业书为这件事写很久。我想聊聊本地那一块。那一块有点让我想不通。我当年显然是尽了最大努力把客户留在本地的。马特:是啊,是啊,想办法把所有这些都搬到 AWS 上来。拉古:这个我们之后再聊。那你想想,早期的 EC2,你最早显然是从卖给创业公司起步的。而今天 AWS 这项云服务——回头看这段演变,什么最让你印象深刻?先说第一部分,第二部分我们再聊你服务创业公司的方式怎么变了。马特:好。其实挺有意思的。我 2005 年就在 AWS 实习过,那时候它还只是一个内部项目,是我商学院期间的实习。我的实习项目,就是做一份分析,判断我们认为 AWS 对谁最有趣。结论是创业公司——还挺让人意外的。所以从 AWS 诞生之初起,创业公司就一直是我们这门生意最核心的命脉,原因有好几个。一是 AWS 给创业公司提供的价值主张本身就太有吸引力了。我们花了很多时间和精力,确保自己是创业公司的好伙伴:不只提供基础设施,还给建议,教你怎么把公司跑起来、怎么设计架构才能最终撑得住规模,以及一大堆我们为创业公司做的事。但我们也认为,这对我们本身就是好生意,因为今天的创业公司就是明天的大企业。这个数字不精确,但今天我们估计,AWS 大约 30% 到 40% 的收入来自那些在 AWS 的生命周期里曾经是创业公司的企业。看着这些公司一天天长大、最后真的变成大企业,对我们来说很好玩。这就是为什么我们在创业公司上投入这么多,也是为什么我们这么关注那种「车库里两个人」的全新公司。不只是因为商业结果,也因为我们是向他们学习的。马特:他们是处在技术最前沿的创新者,明白什么是可能的,也在推着我们的服务往前走——告诉我们他们还想要什么、什么能帮他们更快、什么能帮他们拿到结果。很多时候,他们推得比银行、比医疗公司、比政府都要狠。是创业公司在推这道边界。这对我们变得更好帮助很大,也让我们能走在那道浪前面——银行五年后才想要的能力,创业公司今天就想要了。拉古:是啊,是啊。那从那时候到现在,创业公司变了多少?他们向你提的要求变了多少?显然他们都很想要 GPU,这个我们之后聊。除了这个之外呢。马特:有一点我要说,确实有几件事变了。第一,创业公司的起步规模比我们当年小得多了,对吧?以前他们可能拿了 1000 万美元融资,有一个 App 的点子,慢慢迭代。现在是第一天估值就十亿美元。他们拿了 2 亿美元融资。一个团队加一个想法,一转眼就值十亿美元了。从我们办公室搬到你们办公室。拉古:对,对。马特:而且这些想法的体量、规模和野心,我认为需要更多资本。他们起手就更大了。他们花钱也更多,对吧?要做一个训练、做一个模型,或者做今天很多人在做的那些事。所以第一点就是,他们起步的体量真的很大。但第二点我要说,有些事没变。他们其实还在想:等我规模起来了,架构该怎么设计?安全怎么考虑?性能怎么考虑?我需要的所有能力怎么具备?我的 IAM 怎么配好,好让我从三个人变成更多人的时候,这套东西还能跑、还能撑得住——这往往就是他们选择 AWS,而不是直接去找一家新云(NeoCloud)之类的原因。他们真正需要那些围绕训练而来的安全和其他能力。所以我认为这一点没变,完全一样。变的是今天往上爬的速度肯定不一样了。我还觉得,我们越来越多地看到有公司的团队想要一朵「对代理友好」、而不只是「对人友好」的云。这一点我们花了很多时间。马特:你怎么看规模?你怎么看性能?你怎么看一个定义清晰的 API 接口——让代理能够真正轻松地穿行、在上面工作。这也是我们天生就适合做好的事,但我们其实是加倍下了注,去确保一些具体的东西,比如你怎么在三秒内起一个数据库,真正做到一些代理会兴奋的能力。拉古:你们有没有推出过专门面向代理、或者面向做代理的人的新服务?马特:我会说,我们做的事是优化了一些已有的服务,让它们既能为人工作,也能为代理工作。所以答案是,我们确实有一些专为构建代理而设计的服务,比如 AgentCore、Bedrock 这些东西。但当我们看一个底层组件,比如 S3——绝大多数公司存数据、做数据湖的地方——结果发现,人和代理的很多使用场景是相似的。而我们现在有一个在预览、测试阶段的服务,叫 AWS Context,它让你搭出一层上下文,让代理能更容易地在你的各个数据湖里找到它想要的数据。所以无论你的数据放在 Aurora、放在 S3,还是放在 AWS 的其他什么地方,你都能搭出这样一层上下文;而人类并不一定会那样去访问数据,但代理很乐意跨过这一堆不同的东西去拿数据。所以确实有一些这样的服务在做。但总的来说——马特:你还在意延迟长什么样、吞吐长什么样,你怎么确保底层引擎真的是快、是可扩展的。他们其实非常在意尾延迟,这很有意思。拉古:对。马特:人有时候并不在意 S3 的 P999 延迟,但代理在意,而且会被它卡住。这也是我们长期以来一直在意的东西。从性能的角度看,这是真正能跳出来的一点。这就是为什么代理式工作流在 AWS 上的表现比在任何别的地方都好。拉古:对。我们显然看到很多公司刚起步,最常听到的一句话当然是:代理在替他们写所有的代码。代理在挑数据库、挑邮件服务器,什么都挑,你能想到的都挑。所以这里面的思考多吗——
拉古:所以这里面的思考多吗——显然他们会读文档——AWS 平台上那些陪伴了十年的服务,说它们是「遗留服务」有点好笑,关于怎么把它们重新架构,你们思考得多吗?马特:我想,是的,有一些东西我们想过。其实底层最核心的那些积木,我认为状态非常好。我们思考的是一层「易用性」:怎么让它们更好用——拿你说的那个最简单的场景来说,有人很快地编出一个应用,然后叫它部署。我们发现绝大多数客户会直接告诉他们的编码代理——不管是 Kiro、Claude 还是 Codex——说我想在 AWS 上写代码,这是我的凭据,这是我的东西,这是我想部署的方式。之后代理表现很好,就去做了。不过也有一种场景:你本来不在任何一朵云上,你只是试一试,你说「部署吧」。坦白说,很多时候那会跑到我们那些在顶层加了一层易用性的合作伙伴那里去——顺便说,我们也很喜欢他们,我们也很喜欢这些方向上的伙伴。但我确实认为有些事我们在做:如果你是一个全新用户,你还没有 AWS、还没有配好 IAM,几个月前要开一个账号要难得多,对吧?二十年来一直是这样:你得先定义 VPC,得定义 IAM 角色,等等等等——这些东西在你变大之后其实极其重要。我们从客户那儿听到的是,这是一个很难的取舍,因为他们知道自己几个月或几年之后会需要那些东西,但现在他们只是想用这些服务,不想操心这些。所以我们实际推出的东西是:如果你今天去创建一个新的 AWS 账号——我们在慢慢放量,不知道现在是不是已经完全放开了——你不需要做那些事。你不需要给信用卡,你可以用 Gmail 账号注册。所有那些东西都在后台按默认值处理掉了。不到 30 秒,你就跑起来了,可以操作一个完整的 AWS 账号。对这类系统来说,这更贴近代理想要的能力,因为它们不想去走那一整套设置 VPC 之类的流程。拉古:对,还有诸如此类的东西。马特:所以我们正在给这些加上一些易用性,我们对此挺兴奋,也从客户那里看到了很正面的反馈。以后我们会继续做更多这类事。但好的一点是,它不是一个简化版账号、之后还得迁移。如果你说「好,我现在确实想长大了,我想建一个组织,我想去微调一些东西」,你可以很轻松地——你本来就在一个真实的 AWS 账号里——等你需要的时候再去把这些都做掉。所以后面没有迁移、没有搬家。这是我们真正在思考的那部分硬活儿:怎么让它对客户来说不是一个选择题,而是一条通向那些我们知道客户和创业公司开始上规模时会想要的深层能力的、平缓的上手坡道。拉古:对,明白了。那么,当代理接手之后,最难应付的事情有哪些?你们是靠服务开发者成名的——你们之所以成为一个现象级的东西,靠的是服务开发者,然后是基础设施团队。现在开发者被代理替代了,而且很快基础设施团队也要被代理替代。马特:对。拉古:对你这样全世界最大的服务商来说,最难应付的事情有哪些?马特:嗯,你看,我认为就像我刚说的,我们大部分基础设施其实准备得挺好,能扛住这个规模,这是好事。我觉得有几件事挺有意思,是一些有意思的范式转变。你甚至可以说我们有些系统是——拉古:我不会说是「过度设计」——马特:举个例子:很多代理想创建一个数据库、干一点点活,然后就让那个数据库消失掉。可你真正需要那个数据库有五九个九的持久性。拉古:对。马特:没错。所以有些东西我们要重新想。当你创建一个 Aurora 数据库、把它当生产库用的时候,你确实要五九个九的数据。你需要持久性,你想要可用性,你想要所有这些东西。而对代理的使用场景来说,那可以说是——或者说不难说是——对我们需要的来说过度设计了。所以这很难。我们并不——我们有一种信念,我们也不想提供一个非持久的选项,那同样会带来问题。马特:因为你从来不太确定那个被创建出来的数据库是想长期存在还是短期存在。所以我们在花力气做难的那部分:怎么同时做到这两件事——既能快速创建、随手扔掉、不太浪费资源,又能在你真想要它的时候变得持久、长期存在,并真正长成一个大的生产数据库。这些就是我们在主动权衡的取舍:那些更传统的「这将会是我的生产系统」的能力,怎么去匹配代理想用的那种更短暂的基础设施形态。我认为这是一件。但还有很多。创建持久资源的规模、速度和延迟,是另一个有意思的点。我们还在主动想的另一件事是:有没有一些代理会想要、而我们以前根本不需要的全新积木?比如计算的沙箱、网关、代理的权限——相对人或者服务角色的权限。这里面很多东西是我们已经建好的、正在建的,也是我们正在认真想的,因为它们就是全新的积木。不是把现有积木换个用法,而是全新的积木。很明确的一点是:你想要的代理权限和人是不一样的。你并不想直接把你的权限给出去。拉古:对,完全正确。马特:然后让它拿着你的权限去干你能干的一切。你真正想要的是非常有时限的、短期的权限,只去做某一件事。你甚至可能完全不想把整个工具的权限给出去,而是想要对代理能做什么有非常细粒度的授权。拉古:从一个沙箱来说,你其实想要一个沙箱能……你想要……马特:虚拟化也要出招了。拉古:对,对,正是这样。马特:它们是不一样的,但相似,是同一个思路。问题是,你怎么把那个做得轻量,去考虑……好在我们在 Firecracker 上做了很多工作——那是我们的微虚拟机。事实上,很多做沙箱的公司、很多创业公司都在用 Firecracker。拉古:他们全都用 Firecracker,那是我们大概十年前发明的东西,差不多吧。马特:它其实相当适合代理,因为你可以极快地把它拉起来。它有一个很好的安全边界,而且你没有传统大虚拟机那种虚拟化开销。所以我认为,这些就是我们正在思考的一些全新积木,而且每天都有更多新的冒出来。拉古:对。还有……我往代理这个话题里钻得够多了,一会儿再回来,但这是个迷人的话题。让我换个方向,问一件我们每一家创业公司都要面对、也是我们被问得最多的事:怎么才能拿到 GPU,对吧?显然你们在跑规模巨大的 GPU 农场,而且每天都在加。马特:对。拉古:头部的那些前沿实验室把所有能拿到的 GPU 都吞掉了——祝他们好运。你怎么处理这种内部的矛盾?与此同时,你也想扶持那些会成为明天大企业的年轻公司,就像你刚才说的。你怎么平衡这些要求很高、但没什么信用的小公司?马特:是。这是个好问题。而且有几件事让这件事更难。一是现在要部署大家需要的所有算力,所需的资本开支是巨大的,对吧?所以我们在……你们的资本开支是多少来着,两千亿出头?拉古:2026 年是 2200 亿美元。马特:它——我一度看到,那是一笔比我们历史上任何时候都更大的支出,也许是任何一家公司在单一年度里都没有过的支出。而且我们并不预期很快慢下来,因为需求实在太大了。于是到了某个点上,你会被这样几件事限制住:你建数据中心能有多快、能多快把资本投出去、能多快拿到内存和芯片,以及所有这些。所以它们都是不同时点上的约束——不管是电力、数据中心、资本、内存还是芯片,在不同的时候它们都是约束。搞建筑的施工人员,你知道,施工人员今天是有溢价的。所有这些我们都很努力地去确保能跟上。然后,用我们能够部署出来的容量——那仍然是个巨大的量,而且我们知道还不够——我们真的非常刻意地去想:分配策略是什么?我们和那些大型前沿实验室是很好的伙伴,Anthropic、OpenAI、Meta 和其他大客户。这些人都是我们非常好的客户。拉古:没错。马特:我们想确保对他们有投入。我们也有大型企业客户,不管是 Salesforce、JPMorgan Chase,还是其他对大数量的 GPU 或者加速器有需求的大公司。他们有时想要 Trainium,有时想要——
马特:英伟达 GPU——但我们也想确保能支持他们。在「怎么确保给创业公司留出容量」这件事上,我们是非常刻意的。我们的做法是真的去做分配,基本上就是说:好,我们要留下……拉古:你说得对,我们完全可以把手上每一块 GPU 或 AI 加速器只卖给头部前沿实验室,大概一天就能卖光。马特:我们选择不那么做,因为我们其实想让整个生态继续长起来。他们会拿到很大一部分,但我们想继续支持更广泛的一批客户,因为我们确实认为两边都支持对我们是更健康的:有分散度,而且我们知道这些公司随着时间会变成大公司。所以我们努力支持他们。我最近看到,我们说的是——某种程度上、以某种形式——大概 60% 的请求我们最终都满足了。有时候晚一点,有时候在另一个区域,有时候配置和客户想要的略有不同。但我们真的努力往前靠,尽可能多地去分配。拉古:你手里每一家创业公司都想要更多。马特:没错。所以我们在努力确保这些都能有。但这很难。就像很多人说的,这是一个「好问题」。是的,但它仍然是个问题。我们一直在看——我们最近宣布,未来几年要买两百万块英伟达的 GPU。我们正在落地巨量的容量。拉古:两百万,两百万。马特:是,非常多。而且是未来几年内。谁知道够不够?我完全不知道。但到了某个点,我们同样会被其他部件限制住。可我们确实非常刻意地在给创业公司留容量。我知道不够用是件难受的事,但我们会一直往前推。拉古:你们的资本开支是什么时候跨过——我是说纯粹 AWS 这块——亚马逊是家更大的公司,跨过比如说 10 亿美元、或者一年 100 亿美元,是什么时候?马特:哦,我不知道,我得回去查。那个我不确定。但它过去几年肯定有相当显著的放大。AI 这轮扩建确实把我们的资本开支拉起来了。我会说在过去差不多三四年里,我们的资本开支明显加速了。我不知道我们是什么时候跨过十亿的,但既然现在是 2200 亿,那大概是有一阵子了。我们花资本开支已经花了很久,公司一直很支持给这件事出钱。而且显然 AWS 这门生意本身是好的,我们愿意往里投。拉古:对,当然。马特:我觉得很长一段时间里,我们其实是投在需求前面的。而最让人难受的一件事是,随着 GPU 真正开始放量,很多弹性不幸消失了。希望以后能回来。在我们核心的计算和存储这些上面,弹性还在。所以我们已经投了相当久,而且我们对自己现在投的这笔钱感觉非常好。我有时会被问到很多关于这笔投入你怎么看、你是不是担心泡沫之类的问题。我要说的是:因为我们所处的位置,第一,我们采取的是分散的做法,不是把全部容量都捆在一个客户身上。你去看那些新云或者别的供应商,有时候你会看到一两个客户占到 30%、40%、50%、60%。我们远不是那样,显然。我们最高也就是个位数百分比,通常还更低。所以第一,我们在单一客户上的风险小得多;第二,正因为我们有一整套丰富的服务,AWS 是人们真正来跑生产工作负载的地方。所以今天我们大部分用量其实是核心计算、存储和推理,它们是那个应用的一部分。我认为这些工作负载就是不会消失,因为我们看到企业拿到了正的投资回报。你去跟客户聊,问他们在今天的能力和今天的成本下,你的生意拿到正回报了吗?几乎每一个人都会说:哦,当然。所以你会想,那这就不会消失。不存在一个「他们不再为这件事花钱」的泡沫。你也知道,就像 VC 的模型:每一家十亿美元的创业公司都会成功吗?不会。但这大概就是这场游戏。这件事已经成立五十年了。它们并不一直都是十亿美元的创业公司,数字变了,原则没变。原则是一样的,对吧?拉古:你押十个,一个成了,就把另外十个的钱赚回来,或者不管那个比例是多少。那就是著名的幂律。马特:对,没错。所以你看互联网那会儿也是这样:有过泡沫,一堆互联网公司没活下来,而互联网今天仍然存在。那些有持久生意的公司——谷歌、亚马逊,等等——他们做得挺好的。所以对我们来说,我们对这笔投资和往后的持续投入感觉非常好。拉古:你们对需求有一个别人没有的视角,对吧?因为你看到的是全球、每个细分市场:大企业、大实验室、AI 原生公司,等等。所以如果要有人能最早叫准,那应该是你们。马特:我希望是这样。那是我们的打算。说实话,我们花很多时间在这上面。我们对自己怎么花股东的钱是非常刻意的,我们认为我们做的是很好的投资。我们对于如何有意地投这笔钱有很多好的预判。但,是的,我们非常看多。而且我认为安迪(贾西)已经公开讲过这一点:AWS 的潜力真的大得不得了。未来十年,那个潜力是在的。任何时候你面对一个这么大的机会,你都会想投进去抓它。拉古:当这些数字的规模越来越大——你的规划和流程是不是发生了剧烈变化?我是说,你写的不是十亿美元的支票,你写的是五百亿、两百亿美元这种量级的支票。马特:是也不是。我想,很多时候我们对投资仍然非常看多、身体前倾。但流程上,有很多东西完全变了。你甚至怎么去估 2028 年的需求?而且有些事是现在我们不得不去想、以前从来不用想的。你回到十五年前:如果我们需要更多电力,我们就去问电力公司再给我们几个兆瓦,几十兆瓦。他们会直接给我们,因为十兆瓦不算什么,而对我们继续增长来说已经足够了。现在我们必须自己带电力进来。我们自己带电力。所以我们为电力项目付钱,为可再生项目付钱。过去十年里,我们每年都是最大的可再生能源采购方之一。所以我们定期在上新的太阳能项目、新的核电项目、新的……拉古:你指的是在表后自建(behind the meter),还是跟运营商合作?马特:两种都做。所以是两者兼有。我们上的这些电力项目,很多时候我们会出资本、为这个项目付钱,然后它接进电网,我们再从中拿到额度。拉古:我明白了,好。马特:我们会把这些接进来。有时候我们也会做表后。是个混合。在我们现在这个规模上,你不得不把所有这些东西都想清楚。但这就是那种前瞻二十年的规划:你怎么想电力、怎么想输电、怎么想那笔资本。这些是我们以前从来不需要想的事,因为我们以前从来不需要做这种规划。还有另外一点:以前我们想服务器需求,是按几个季度去想的,我们跟供应商谈。现在我们得按好几年去想,因为体量太大了,我们必须想 26 年要什么、27 年要什么、28 年要什么。但这也正是我们带给客户的价值之一,对吧?这是客户凭自己确实做不到的事。他们不会去做电力规划,不会去规划自己 2028 年的内存用量。他们就是做不到。所以这就是我们带给广泛客户群的真正价值之一:这一整摊事情你不用担心,而我们花了巨大的时间去想它。拉古:对,对。就记录一下,你们大概是几乎所有服务器零部件的最大买家,对吧?马特:是。我知道我们肯定是外面最大的零部件采购方之一。至于所有人,谁知道呢,那要看你用什么口径、怎么去衡量。拉古:我真正想问的是:你认为最严厉的约束会出现在哪里,比如说 27 年、28 年;以及你看到哪里的约束会松开?马特:这挺有意思。我会绕一圈来回答。我记得在本科的时候——那是很久以前了,我从来没想到读的那本书会有用——我们读了《目标》。拉古:哦,当然。马特:结果发现,从来就没有「唯一一个」约束,永远都只是最新的那个约束。所以你必须把它们全都想一遍。
马特:而且你刚顶住一个,马上又冒出另一个,对吧?拉古:那你说,27 年、28 年会出现的那个约束是什么?马特:我其实不认为会有「那一个」。对我们来说,它更像每个月都在变:这个月的问题是,你的电力够不够?而一旦电力不再是约束,可能就是内存,可能是台积电的产能,可能是 HBM,可能是网络部件,也可能是供应链上某个地方出了一点小波动——连接器之类的。到了某个点,所有这些部件你都得想一遍。而且它们出现在哪里也很重要。可能是这样:我们在印尼有大量电力,但在德国不够。所以你得想,你要把容量放在世界上哪个位置——因为事实证明,并不是所有东西都完全可替代。有些是可替代的,有些不是。也许是磁盘驱动器,也许是 SSD。每一个部件我们都在想,我们跟踪和思考的部件有成千上万、甚至几十万个。其中一些我们靠供应商去管,大部分是我们直接管。对,我们有一整个团队在做这件事,他们非常出色,我认为是行业领先的。我们大概十年前就看到这个问题要来了,于是真正开始做的,不只是想「我们要跟踪多少台服务器」,而是把整条供应链想透,往下想四层、五层:哪个部件可能会给我们造成问题,然后确保在那个部件上我们锁定了供应。你记不记得——我不记得是哪一年了,是十多年前——泰国有一次洪水,然后所有人都没有磁盘驱动器了。拉古:那是磁盘驱动器危机。马特:然后又有内存危机。没错。所以我们会把这些全部推演一遍。我们也会想制造上的分散度在哪里,这一类的东西我们都努力理清。我们永远做不到完美,但总会有一个不同的供应约束。拉古:好。显然,围绕数据中心有一大堆范围很广的争论。像我们这样的机构站在什么位置是清楚的,但你觉得,作为一个行业,我们是不是没有做好一件事——就是解释清楚为什么数据中心对美国、对世界是好的?在安迪的团队内部,大家怎么谈怎么应对这件事?马特:你看,我想你会在这件事上听到我们说更多,我同意。我认为我们需要更敢发声、更直言不讳,因为我们确实做了大量真正有益的事,对我们所在的社区也是。我们会花很多心思去想:怎么把可再生能源带到这些数据中心?怎么做到「水正效益」?其实我们的数据中心用水量非常非常小,我们主要用的是自然风冷(free air cooling)。我们会想:怎么成为所在社区的好成员,怎么给我们运营所在的社区带来高薪工作。不是所有数据中心运营商都这么做。外面有一些被详细报道过的例子,那些人在这方面做得不好,他们不太在意监管,觉得规则跟自己无关,或者就是很快地把项目推出来、根本没想这些。而我认为这给整个行业造成了问题,因为大家会被一起归类。所以,你看,我认为——你说得对,我们自认有批评自己的习惯——我们需要更主动地讲我们确实带来的好处,并且想更多办法帮社区理解我们带给他们的是什么,包括他们使用的服务,对吧?如果你去一个社区说,那你是不要用 Netflix 了吗?他们会说:不不不,我还是想用 Netflix。所以对我们来说,去想并且突出我们带来的好处很重要。我最近看到一份报告,我们运营所在的其中一个社区,那个县里每个人一年少交 5000 美元的税,就是因为我们把税基带到了那里。而我们没告诉过他们,他们甚至不知道,对吧?对他们来说这是隐形的。所以我认为我们就是需要把这些好处讲得更清楚。因为我想,如果你告诉这些社区:顺便说一句,要是我们不在,你们的税单会比现在多 5000 美元——他们看那边那栋楼的眼神可能就会不太一样。拉古:对,对。但不是每个人都这么做。不是每个人都会……马特:想必需要更多透明度。我认为数据中心这个圈子里的大部分人,不只是我们,其实都是挺规矩的参与方。只有少数几家不是,我认为就是他们造成了最近的一些怨气。我觉得我们需要做的更好一点的事,是把谁在做合格的企业公民、谁没有,讲清楚。拉古:对。在我们离开硬件这个话题之前,我想聊聊 Trainium,以及你们自研芯片的整段历史。很久以前,我们是你们最早使用 Nitro 的合作伙伴之一。从那之后,Graviton 取得了巨大的进展。那么,当初是什么思路让你们决定「我们要做自己的东西」?后来的进展如何?在规划上你们现在到了哪一步?马特:这其实是个很迷人的故事。我认为它也是一个很好的例子,说明亚马逊 AWS 会怎么创新:我们会随时间迭代,不断把「我们能做什么」想得更大,但是一步一步地把自己证明到那里,而不是——你知道的。举个例子,大概是十三四年前,我们看到整体的资源上有一笔相当可观的虚拟化税。当时我们在想,怎么去……我们的客户告诉我们:我想要裸金属的性能,他们在比较的是一台服务器的全部资源。所以我们做的第一件事,是拿了一张网络卸载卡,把我们的网络虚拟化全部挪到那张卸载卡上,让网络虚拟化逼近裸金属性能。那时候还不完全等于裸金属,但已经更接近了。然后我们为此非常兴奋,说:好,那如果把存储虚拟化也挪出去呢?可当时没有任何一张网络卸载卡能做这件事。后来我们找到一家公司,他们在一张卸载卡上放了一些 ARM 核心,做的是别的用途——我记不清他们原本是干吗的——我们就问:能不能用那些核心去做存储虚拟化和这些其他功能?他们说,也许可以。于是我们和他们反复迭代。这就是 Annapurna 团队。拉古:对,是 Annapurna 团队。马特:我们特别喜欢那个团队。真的很有创新性,非常有使命感,真的想解决问题。非常棒。于是我们收购了他们,然后说:能不能给我们做一张稍微大一点的卡,把网络虚拟化全部卸载掉,基本上给我们一台完全没有虚拟化的裸金属服务器——没有虚拟机虚拟化,一切都通过卡上的 API 来做。因为我们当时的看法是:第一,性能会好得多;第二,资源利用率会更好;还有安全隔离。拉古:安全隔离。马特:安全隔离会好得多。而且我们可以名正言顺地告诉别人:你们跑在那里的任何虚拟机,我们都访问不到。这在过去十年里给我们带来了巨大的好处。坦白说,我们一直领先,别人做这件事做得比较慢,因为这不是一件谁都能泛化去做的事。但……我们做到那一步之后,基本上就说:我们在这里进展很大。既然那张卸载卡上跑着一堆 ARM 核心,那如果把它做成一台服务器呢?我们最早是用 Graviton 做的。那是一款性能很弱、很小的服务器,我们把它推出来。客户很兴奋,说:我很想要一台 ARM 服务器,这太有意思了。于是我们沿着 Graviton 这条路走下去。我们做的一部分事情,是看到 ARM 核心的性能曲线在往上走,看到功耗利用上的那张图,知道那个交点迟早会来——到那时这个架构会在很多场景里变得非常好,只是需要有个人去把生态推动起来、把一些拼图放到位。我们就用 Graviton 做了这件事,而 Graviton 到今天已经是一个大获成功的产品。拉古:你们公开过机队里 Graviton 占多少比例吗?马特:我们每年上架的 Graviton 比任何其他类型都多。所以它非常受欢迎。而且你看,它们便宜 20%、性能还好 20%,在过去五六年里一直是这样。所以这是一个很容易理解的价值主张。我认为我们前 100 大客户里,大概 90% 以上都以某种形式在他们的机队里用了 Graviton。这对我们和对客户都是巨大的胜利。客户降账单最简单的一种办法,就是迁到 Graviton。拉古:对。马特:我们见过有人把整个机队迁过去,服务器数量直接砍半。性能好太多了,很惊人。所以服务器数量减半,每台服务器还更便宜,这是个大胜。然后在大概五六年前,我们说:我们看到 AI 计算在崛起。当时完全没预料到它会变成今天这个样子,但仍然看得出它会是一个很大的变量。于是我们进去做了第一颗芯片 Trainium,现在我们已经把第三代 Trainium 3 推向市场,我看到的结果非常好。所以,我们的产能大概已经卖到明年年底左右了。
马特:我们也在想办法,怎么省出一些容量、让创业公司也能用上,因为我们看到的结果很好。你看,Bedrock 上大部分的流量都跑在 Trainium 上。我们跟 Anthropic、OpenAI 都有很好的协议,让他们在 Trainium 上构建,另外还有一批更小的创业公司。我想现在有六到十二家创业公司在 Trainium 上做东西。拉古:这名字听起来是颗训练芯片。马特:对,我们起名很差。但大家也拿它做推理。拉古:所以在架构上它的长处在哪里?又要往哪里走?马特:这是个好问题。你看,我们自认有自我批评的习惯:我们起名真的很糟,那不是我们的强项。最早我们有一颗专做推理的芯片叫 Inferentia,专做训练的叫 Trainium。后来模型越来越大,而结果是你其实想在这些非常大的系统上跑推理——于是发现,从绝对性能和性价比的角度看,Trainium 现在可能是市面上最好的推理芯片。拉古:是因为内存更好、内存带宽更好?到底是哪里——马特:它的架构跟别人有点不一样,而且便宜得多。所以从性价比和绝对性能两个角度看,Trainium 都很好。拉古:好。马特:所以我们在推理上大量用它。就像我说的,Bedrock 今天大部分推理是它在驱动。但它也是一颗好的训练芯片。我认为我们广大客户群里的很多用量并不在于训练模型,而在于使用模型。所以很多人是在「看不见的地方」用到它,这也是我们对它兴奋的地方。但很多大客户对它在训练集群上也很感兴趣。尤其是到了 Trainium 3 和 Trainium 4——我们已经发布了,Trainium 4 还没上线,但已经宣布了——大家看了那个架构之后会说:对,这才是我所有训练集群的未来。所以我们对于未来相当兴奋,包括它在那种真正大规模训练集群上的走向。所以,它两样都是。拉古:现在让我们回到代理这个话题,但换一个角度:大中型企业。他们现在处在采纳的哪个阶段?你看到他们已经拿到了什么样的收益?从你的视角看,他们的路线图是什么?马特:这是个很好的问题,也是我们花了大量时间去想的。我跟外面的客户聊的时候,他们今天从已经做的事情里拿到了很多价值。我会说,大多数企业建出来的代理还相对简单直接,而且它们大多还不是自主的——还处在有人在环路里的状态。不过顺带说一句,客户今天从这当中仍然拿到了大量价值。所以他们在认真想的是:怎么让这些变成自主的,但是以一种安全的方式。我认为今天有两件事在拖住客户,让他们没法继续往上铺。这已经是一块相当大的生意了,但我认为它有一个巨大的机会,能真正改变外面每一个客户、每一条工作流。第一件就是「怎么去想它」。我们最初看到的是:企业有一条工作流,然后他们说,好,那我让一个代理去做同一条工作流。而我们真正鼓励他们做的是这样去想:不要只是复制——鲍勃做第一步、二、三、四、五,所以代理就去做一、二、三、四、五,最后鲍勃再检查一遍。那不是你真正想要的模型。你要退一步问:如果我想达成一件事,代理能不能用完全不同的方式去做?它可以大规模并行地去做,可以试五十种不同的做法然后走到那里。你怎么帮它走到正确的那个结果,怎么重新想「一台计算机怎么解决问题」而不是「一个人怎么解决问题」。所以其中一件事,就是我们去帮客户理解该怎么想这件事,真正有一块干净的空白板——因为真正的价值不在于复制你今天在做的事,而在于用一张白纸去想:怎么把一个问题的解法彻底换一种方式。我相信你们的很多创业公司也是这么想的。拉古:对,对。马特:怎么帮客户用「白纸」的方式解决问题,而不是复制今天在做的事——这是第一件。现在跑代理机队、跑代理集群(随你怎么叫)已经很常见了。你就要去想这件事。企业并不总是那么前倾——马特:比如说一家保险公司,未必有那么激进,但他们很想弄清楚怎么让自己的审批流程变得更好。所以这是第一点。第二点是:怎么把这些变成完全自主的工作流,以及你怎么真正信任这些代理。我们花了很多时间去想:怎么建出这样的服务,让企业觉得他们的系统是安全的、他们能信任一个代理去做决定,护栏是对的、它在他们的数据上的权限是对的、它不会去删生产系统、它不会犯下悲剧性的错误。我认为现在正是这种紧张感——也许是恰当的紧张感——在拖住企业,让他们没法直接说「好,放开了干吧」。你其实并不想让一个代理乱来,然后不小心把生产数据库删掉,那会相当糟。所以我们正在跟客户一起,积极地把这件事走通:既帮他们做架构,也坦白讲,去发明能帮他们解决这个问题的新技术和新能力。这是我认为我们会持续创新、并且最终会走通的一个领域。我觉得我们有一些很好的想法和一些不错的技术正在酝酿,我认为能真正帮上忙。拉古:那企业在学着做评估体系等等,好让代理待在正轨上吗?马特:他们需要帮助。说实话,评估也好、怎么建立一个不断测试的回路也好、怎么以合理的方式去想目标导向也好、怎么把数据标注到让评估真正能近似你将在生产里做的事也好、怎么在生产里衡量并回测以免看到漂移——所有这些都是企业今天不知道该怎么解的问题。我不确定今天有谁真的把这几个问题解得很好。这就是为什么你会看到那么多 FDE 团队冒出来,AWS 和我们的伙伴都在往前向部署这件事上压上去,去帮忙。这是客户最需要帮助的一个领域。当我们想这件事该怎么运作时,我的观点是:我们要把客户训练到能自己去做这件事,对吧?这不是那种传统的模式——我想做一门人力驱动的生意,永远做下去,让你一遍又一遍地付咨询费。我们对 FDE 应该怎么工作的看法是:我们进到一个准备好自己接手这件事的客户那里,在 45 天里做事,教他们怎么做评估、怎么把数据以标注好的形式组织起来,跟他们并肩工作。然后 45 天结束时我们离开,这个客户已经准备好了、也训练好了。这就是客户告诉我们他们想要的。他们不想在未来五年里被一支外部人力队伍绑住。但他们今天需要帮助。拉古:对,你们在前向部署工程师上投了巨大的资源。马特:对。拉古:那再往前走一步:你的一些业内同行说过,你不能让所有数据都进到那些大型前沿模型里去,企业真正该做的是拿一个开源模型,然后在自己的数据、工作流、术语这些东西上做后训练。你怎么看这件事?你看到客户真的在尝试这么做吗?还是你们怎么想这件事?马特:这很好。第一点我完全同意。客户和企业的数据是他们最宝贵的资产。所以从一开始,这就是我们那样去建 Bedrock 的原因。我们有一个保证:你的数据永远不会离开你的 VPC。如果你跑在 Bedrock 里面,你的数据不会回到模型提供方那里去,他们永远看不到你的提示词,它留在你自己的可信环境里。这就是为什么企业更愿意跑在 Bedrock 之上,也是为什么你会看到那块业务在巨幅增长——成百上千……我是说,每周、每个月我们都看到那块业务在爆发式增长,这就是为什么你会看到 OpenAI 的工作负载在迁到 Bedrock 上,也是为什么你会看到 Anthropic 增长得非常快。无论你用的是开源模型还是闭源的前沿模型,我认为 Bedrock 都是一个很好的解法。顺便说,我们的客户告诉我们——如果你记得三年前的话,我挨了很多骂。拉古:说到糟糕的命名,这个名字倒是好名字。Bedrock 是个好名字。马特:那是个好名字。但当时我们其实因为「太慢」挨了很多骂,因为我们是先把这件事的地基打牢:我们说,我们不打算匆匆忙忙把一个服务推出去,我们真的要想清楚怎么保护客户的数据,建出一个我们知道会在那些使用场景里持久的服务。
马特:如果你还记得,当时我们挨了很多骂,我们说:我们要去建对的东西。而现在,当人们从概念验证走向生产时,绝大多数都落在了 AWS 的 Bedrock 上。很大一个原因就是这个。另一个原因是我们有的那一整套服务:我们既提供开源模型,也提供闭源模型,还围绕它们提供一整套能力。我们把这些积木建好,让你用任何一个你想要的模型来搭代理都更容易——不管那个模型在 Bedrock 里还是在 Bedrock 外,你甚至可以用 Gemini 或别的东西。但我认为这是我们一个差异化的点,也是一件非常值得去想的事,因为让那些数据回到模型提供方那里,我认为是件危险的事。不过说到开源权重模型:我确实认为存在一个让我很兴奋的场景,就是我们正在大幅加强对开源权重模型的支持,努力去建一个好的模型环境。坦白说,我认为今天——而且我认为这是真的——很多客户相信,他们有一些专有数据,如果能把数据混进去,对开源权重模型做些后训练、做些微调,把它蒸馏下来,就能以一个更低的价格拿到一个表现更好的模型。这里面有一堆环节得都能走通。他们得真的有好的评估来证明这件事成立。今天大多数人是在 SageMaker 上做这件事。我认为我们还能做更多来让它更容易。但实际上,你去看人们在哪儿做这件事,今天他们就是在 AWS 的 SageMaker 上做;他们也通过 SageMaker 托管推理。SageMaker 正迎来一次新生,因为——它一直算是一个模型构建平台,对吧?而现在,如果你想想企业在这个世界里做什么,他们做的就是这件事:本质上在构建自己的定制模型。所以 SageMaker 是干这件事的好地方。我认为还有一些东西我们需要继续往上建,让它越来越容易做,也让它更容易在不同开源权重模型之间做测试之类的事情。这是一个还在演化的领域,我认为它非常有意思,也是我们要确保——只要客户有对的数据和专长,真想走这条路——我们手上备齐了所有该有的东西。拉古:围绕 AI 的这一大堆争论、外溢风险之类的说法,还有安全漏洞等等,以及 Hugging Face 那次攻击——企业界那边,CEO 们都在问你什么?马特:有不少。你看,他们主要想问的是——这又绕回这件事——当我部署代理的时候,我怎么信任它会做我想让它做的事?所以我们越来越多地——其实已经有一阵子了——在大举投入去构建这样的能力:让人们能把代理安全地部署进自己的环境,并且把这套控制想清楚。其中一部分是:怎么确保代理拿到的是对的权限?怎么给它对的沙箱?怎么确保有对的那套护栏?你怎么真正有意地去想:你要代理做什么、不做什么?环路里有没有人?所以我们和客户花很多时间一起想:你怎么做安全的代理部署、怎么随时间变得更好、我们还需要去构建哪些能力,来帮人们把代理安全地部署进他们的环境。所以这里面有很多。马特:另一个角度是很多人在担心的:这些非常强大的模型本身,会不会变成攻击性的服务、变成某种 Mythos 级的东西?我的看法是这样:是的,对客户环境来说那是一个真实的风险;但它同时也是一个真实的机会。所以我们最近推出了一个叫 Continuum 的服务,它用这些强大的模型来帮客户加固自己的环境。它会扫过客户的环境,和他们一起找漏洞——我们用这些强大的模型——帮客户找到他们以前没找到过的漏洞,而且最重要的是,帮他们排出优先级,因为我们掌握他们环境的上下文:环境是怎么搭的、权限在哪里、有哪些补偿性控制让某件事更难或者更容易做成。所以 Continuum 在客户那里非常受欢迎。我们对「用 AI 来帮上 AI 驱动的安全」这件事的可能空间非常看多。因为你看,到了某个点,客户需要的安全是机器速度的安全,不是人的速度,不是那种「警报响了,有人进去看一眼」的速度。所以我们在快速跑起来,去帮客户把这个建出来,帮他们保护自己的环境。我对 Continuum 团队在这方面的构建也非常兴奋。拉古:那在 AWS 内部——代理的使用在整体上是个什么状态?马特:嗯,Continuum 基本上就是我们想把内部在做的事对外暴露出来。我们在自己的安全上大量使用 AI。我们在自己的软件开发上大量使用 AI。我们真的用代理——其中一件非常酷的事是,我们在整个业务里都用代理。我们把 Amazon Quick 推给了每一个亚马逊员工。现在我看到 HR 团队在建代理,以前一个团队要花几周才能做完的事,现在一个人几个小时就能做完,用来做团队规划和资源管理。我有财务团队在搭代理去想这件事:他们去把各处的税法抓过来,确保我们在一堆不同的地方都合规。看到以前被软件开发者挡住的那些事,现在业务线上的人自己能解开、能更快地创新,非常酷。所以 Quick 是一个巨大的爆款,像野火一样长起来。我们看到从小创业公司一直到全世界最大的企业都在用它,把它推给自己的全部用户群,去拿到「能访问你全部企业数据、能轻松把代理和能力套上去帮你加速工作」的好处。所以我们在从软件开发到安全、到驱动 HR 的每一件事上都在用它。拉古:对。你们对运营的每一个细节都要度量是出了名的。你在哪里看到最大的收益?马特:你知道答案的——软件开发。那才是真正的答案。不过只是它的各个衍生物。但我要说,软件开发的速度,其实是整个产品开发的速度,不只是写代码。拉古:所以你看到加速了?马特:绝对加速了。我们部署新产品的节奏跟过去完全不一样。我想你可以看到这一点:AWS 一直以发布功能极快闻名,而在过去一年左右,我们看到上一代的加速——因为我们有了所谓的「前沿团队」,他们用代理式开发来思考,而不是传统的开发方式。而且这不是代码补全。它真的是代理优先:代理写所有的代码,你只是在管理一支代理团队、驱动这件事。看到为客户带来创新的节奏变得如此之快,很有意思。而且必须得快,因为这就是问题所在:我们的客户对新能力的胃口几乎是无法满足的。这就是我们该做的事。拉古:那在组织层面,你有没有什么洞见,关于组织应该怎么变、怎么改?马特:我没有,我会这么说。代理管理人,人管理代理。很长一段时间里,人还是会很多。我确实认为组织会变。我还不知道那个神奇的答案。但我们在积极地想这件事。拉古:在内部,你们就是在试各种实验?马特:我们在做实验。我们在想「小组」(pods)这件事。举个例子:在产品组织里,以前会有一个团队长期拥有一块特定的能力,你可能会有十个人在做那件事。而今天,你能创新的速度太快了,所以不必是十个人,可以是三到四个人。他们很快把东西做出来,于是你其实想把他们挪到别的项目和问题上去。所以就要去想:在一个像 AWS 这么大的组织里,你怎么既运营和维护你已经建好的东西,又保持敏捷和灵活、能四处移动。这些是我们正在实验和试的东西。但这很好玩,也让我们的员工更有能力。他们其实很喜欢,因为他们能建得更快、做得更多。但这里面有实打实的功夫。拉古:对。这是个迷人的时代。非常感谢你的时间。这件事我们可以一起聊好几个小时,但谢谢你分享的这些洞见。马特:谢谢你邀请我。也谢谢你。拉古:我们很喜欢你们所有公司都成为我们的客户,我们很喜欢向他们学习,感谢你来这儿。马特:对,我们会继续把他们往你们那儿送。拉古:太好了,谢谢。好的,谢谢。片尾:感谢收听这一期 a16z 播客。如果你喜欢这一期,请点赞、评论、订阅,给我们留个评分或评论,并分享给你的朋友和家人。想听更多单集,请前往 YouTube、Apple Podcasts 和 Spotify。在 X 上关注我们 @a16z,并订阅我们的 Substack:a16z.substack.com。再次感谢收听,我们下一期见。提醒一下,这里的內容仅供信息参考,不应被视为法律、商业、税务或投资建议,也不应被用来评估任何投资或证券,且不是面向任何 a16z 基金的投资者或潜在投资者。请注意,a16z 及其关联方也可能持有本播客中所讨论公司的投资。更多细节,包括我们投资清单的链接,请见 a16z.com/disclosures。
以上为整集逐句译文,共 18605 字。出处:官方整集音频(E1222,56:17)。1
References
- 1
- 2Amazon 官方新闻站:2026 年二季度财报(AWS 同比 +37%、年化 1690 亿美元)
aboutamazon.com
- 3Amazon 官方新闻站:自研芯片业务年化收入运行率超过 250 亿美元
aboutamazon.com
- 4NVIDIA 官方新闻室:AWS 与英伟达将在 2027–2028 年追加部署 200 万块 GPU
nvidianews.nvidia.com
- 5
- 6
- 7
- 8Amazon 官方新闻站:Amazon Quick Suite——已在亚马逊内部大规模试用的代理式应用
aboutamazon.com
- 9a16z 官方作者页 · Raghu Raghuram
a16z.com
- 10Amazon 官方新闻站:认识 AWS CEO Matt Garman 的十件事
aboutamazon.com


Comments