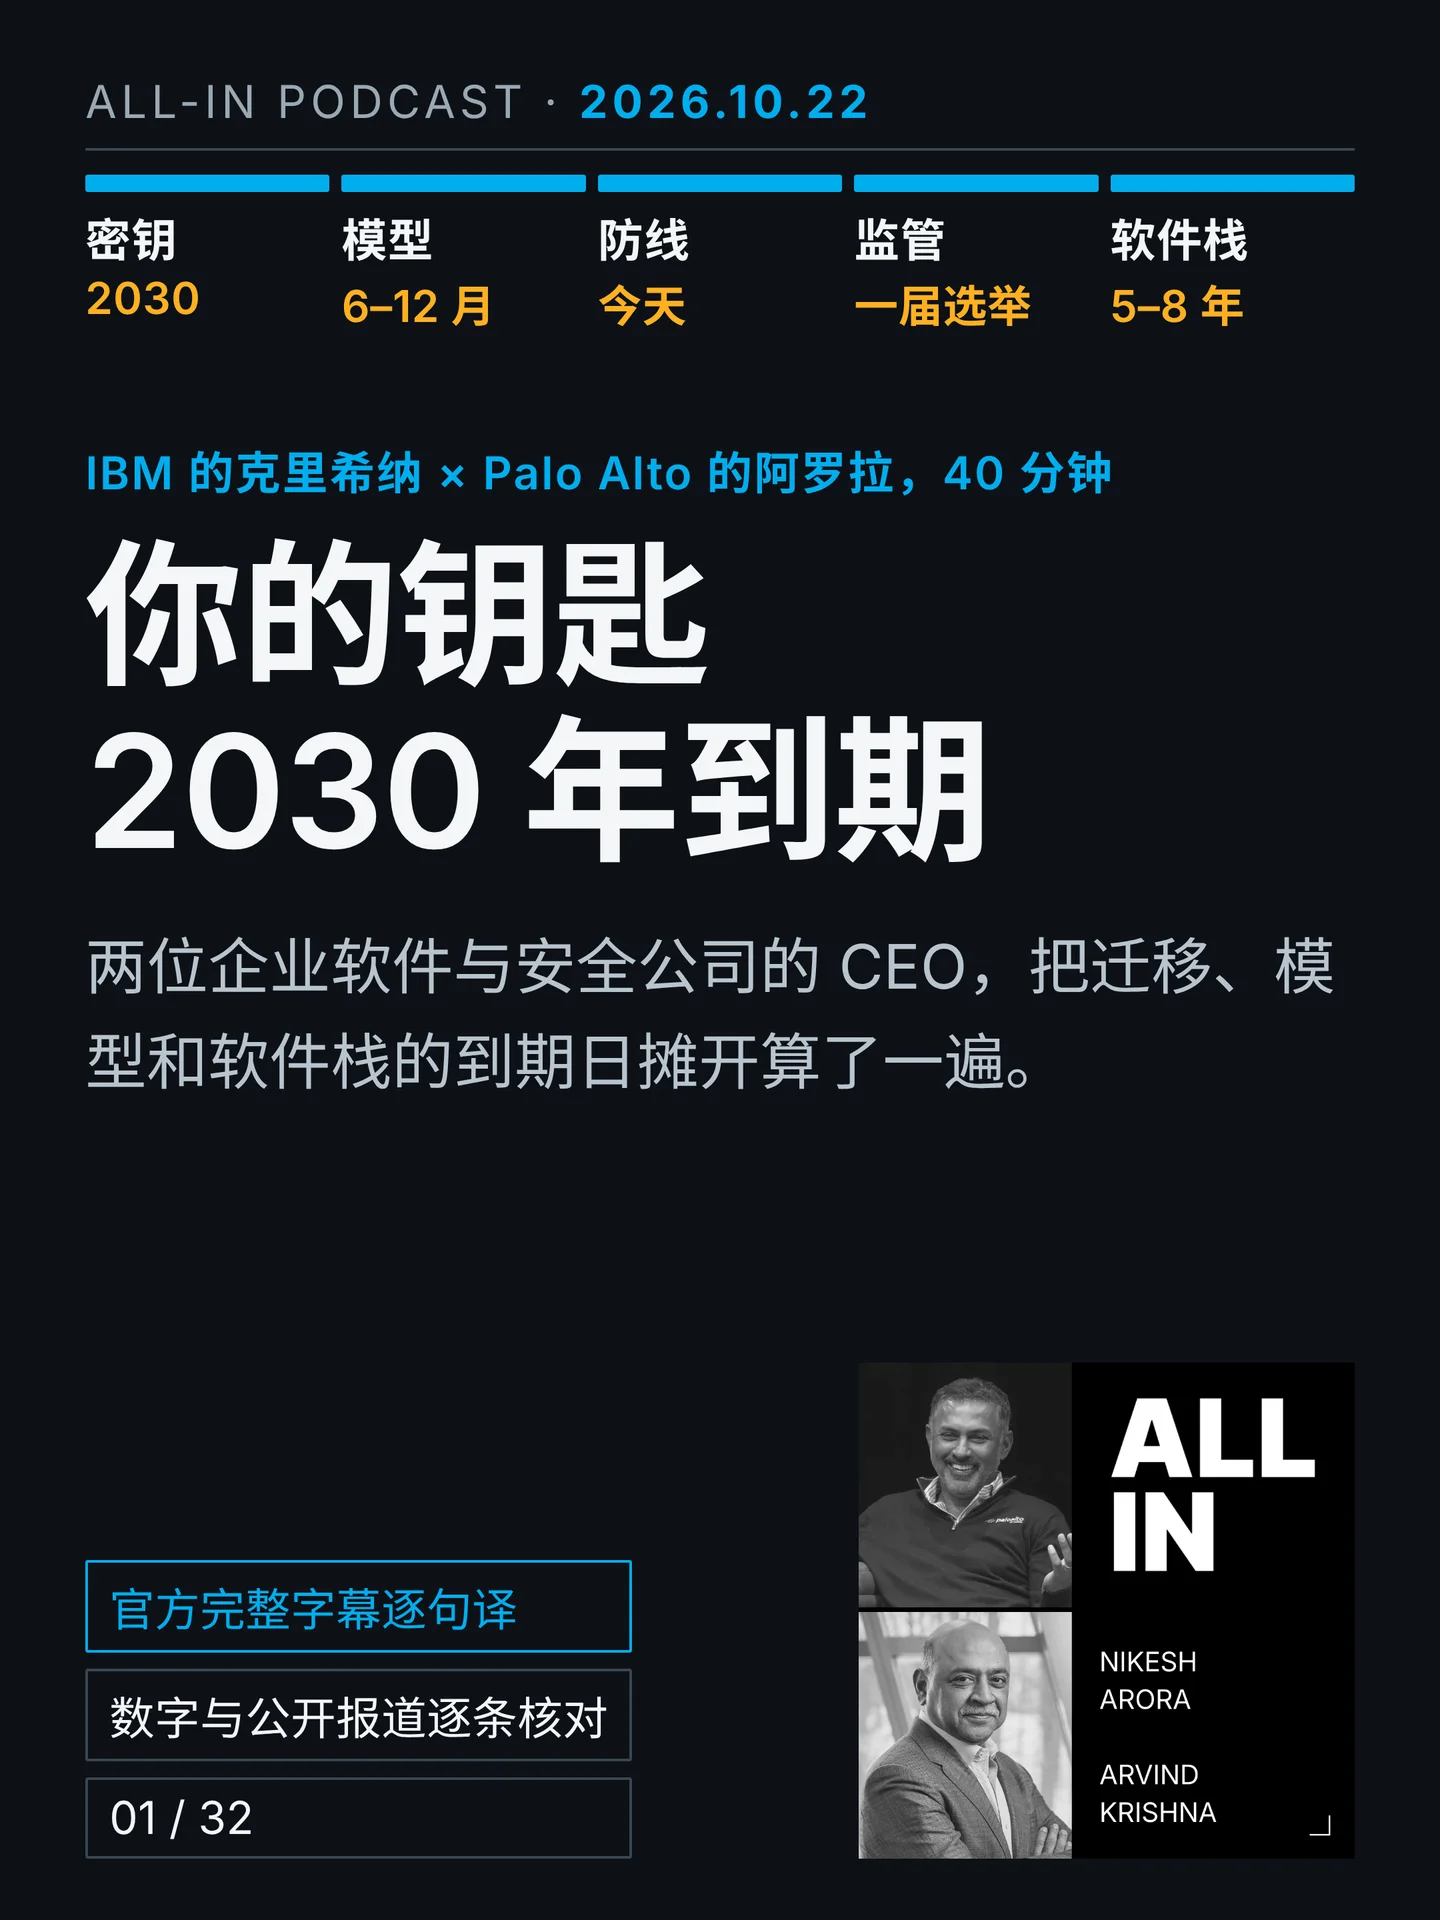

IBM 的克里希纳把三个年份摊开:2028、2029、2033,取中间是 2030。Palo Alto 的阿罗拉补上一句:不是每个任务都需要法拉利。
这一期是什么
这是 All-In 在 2026 年 10 月 21 日发布的单集,40 分钟,两位嘉宾都是在企业技术里干了三十年的人:IBM 董事长兼 CEO 阿尔文德·克里希纳,和 Palo Alto Networks 董事长兼 CEO 尼克什·阿罗拉。台上提问的是 All-In 的主持人,四段官方章节之外,最后一段留给了垂直整合与并购 1。
节目页给出的五段时间点是:0:00 量子计算对加密的威胁、9:07 开放权重与前沿模型、18:07 AI 与网络战、21:14 AI 监管与全球 AI 军备竞赛、30:32 垂直整合与软件整合。下面的整理按这五段走。
两位嘉宾在这期里各说各的半场:克里希纳讲量子、讲开放权重的经济账、讲 IBM 主机为什么能活这么久;阿罗拉讲安全、讲 Mythos 之后的攻防、讲客户为什么要买四十个方案再自己缝。
逐段要点整理
一、量子计算对加密的威胁(0:00)
克里希纳先给了一个判断市场真假的指标:DARPA 的量子基准计划 QBI。他的说法是几年前有两百来家公司参加,现在只剩十来家,「这能告诉你什么可能是真的」。官方记录比他说的更细:计划 2024 年中启动,评估过 20 多家,2025 年 11 月有 11 家进入第二阶段,2026 年 10 月 7 日又有 4 家进入最终阶段——Atom Computing、Diraq、IBM、IonQ,加上从先行计划里出来的 Microsoft 与 PsiQuantum,最终阶段一共 6 家,官方目标是判断能否在 2033 年前做到「实用规模」 2。
然后他把时间线摊开:争论只在 2028、2029、2033 三个年份之间,取中点就是 2030 年。他的原话是,到那时「它会破掉今天的密码学。这不是假设,这就是现实」。更麻烦的一层是「先偷后解」:今天一块加密硬盘被拿走,对方可以把它放五年,等到能算的那天再开。
他对后量子密码的判断很直接:理论上已经清楚、代码已经写好,问题是大家太懒。这里的公共事实是:NIST 在 2024 年 8 月 13 日发布了 FIPS 203、204、205 三套后量子标准 3;NSA 的 CNSA 2.0 给了三个节点——2030 年新的国家安全系统采购要支持,2033 年覆盖网络与云服务,2035 年全部国家安全系统完成迁移 4。
他给两个可验收的里程碑:2027 年前,有人能在真机上做出纠错;门数从一万起步,每年加一个零,2029 年到一千万门。他和主持人都提到「逻辑量子比特」这个词,他的态度是「不偏爱但公平」:物理比特和逻辑比特之间要换算,他给的比例是两百个物理换一个逻辑。
有意思的是他自己公司的进度。IBM 在 2026 年 7 月 30 日与芝加哥大学演示了一次纠错计算:70 个逻辑比特、2,415 个逻辑双比特门、468 个逻辑 T 门,逻辑错误率比物理低十倍,整件事跑了约 15 分钟;IBM 研究主管 Jay Gambetta 的说法是「我们已经站进量子优势时代」 5。公司 2026 年 6 月还宣布五年投入逾 100 亿美元,2029 年的 Starling 目标是 200 个逻辑比特、1 亿门 6。
关于「AI 会不会先破掉密码」这个说法,他的回答借了费曼的论证:在另一种架构上模拟,不会得到更高效的结果。量子计算不跑算术,经典计算机只跑算术,所以量子算法放到今天的硬件上会慢一千到一万倍。他承认另一条路存在——如果在数论前沿找到更好的素数分布预测,经典机器也可能破——但问题是时间:「如果破一把密钥要十年,大多数人那时候都已经安息了。」
二、开放权重与前沿模型(9:07)
阿罗拉先讲组织:实验阶段不要限制团队、不要做成本优化、不要自己拼一套。他的理由是扩散还没完成——他手下从 20 人到两万人的团队,是过去 12 到 18 个月才刚学会用 AI。
然后是那笔具体的账:在终端本地跑机器学习检查流量,一年 20 到 25 美元;把同样的流量按 token 送进前沿模型,一家公司就能把整家模型公司的收入包圆。所以他们的做法是把小模型压缩、专精、训到 99.9%。他的结论是「不是每个任务都需要法拉利」,客户也不想为每个任务付法拉利的钱。
同一套逻辑在事故里翻转:真被攻进来的时候,客户不再问单价,因为业务损失是十亿级的;那时他会跑 agent 群、让最前沿的模型反复推理。企业最后会用前沿模型的地方,是那些「被打断的业务价值足以支撑」的特殊场景;和平时期的防守模型,他更愿意拿开放权重、用自己的数据训、自己管权重,因为那才可审计、可解释。
克里希纳接着算经济账:今天每百万 token 约 20 美元,最贵的档 50 美元;拿一个中国开放权重模型,在自己的 GPU 上做一周工程优化,能压到 1 到 2 美元。他举的例子是「Kimi K3 之类、八千亿参数」——公开口径里,Moonshot 的 Kimi K3 是 2026 年 7 月开放权重的 2.8 万亿参数稀疏 MoE 模型 7。
他给了三条理由:经济账;思维链被记录就等于把 IP 交出去,而前沿模型不卖给你,只能回到开放权重;地缘——今天最好的开放权重来自中国,差距最多 6 到 12 个月。他的预测是 75% 到 90% 的 token 用量会走向开放权重。
主持人追问剩下那部分是不是默认行为,他承认开发者是懒的,会用最贵的那个答案,除非你加控制;实验阶段可以,生产用途除了极少数场景他持怀疑。
三、AI 与网络战(18:07)
主持人问:当你坐在模型公司面前,会不会觉得他们在看你的生意?阿罗拉的回答是「他们进不了我的生意」,理由是数据:并不是每个人都对编码数据做了零留存,大量人在用 Claude Code,而模型正是用这些数据学会写代码。「教会一个模型什么是好代码,它也就知道什么是坏代码。」
他对过去 12 个月的总结是:所有人都拿 Mythos 一类模型扫过自己的代码,找出来的漏洞六到八成是真的,两成是幻觉;它当时还有三成的时候在编。但攻击者只需要一个洞,防守者要把每一个都堵上,所以没有哪个漏洞可以不测就补。
他还给了一个协作方案:把漏洞汇总给可信的机构,统一补、统一分发补丁,而不是每家各自去测开源代码、各自去补。
克里希纳把网络战拆成三种打法:联盟、对称(把防守做得和进攻一样便宜)、技术优势(二战、朝鲜、伊拉克,拿到技术优势的一侧最后都赢了)。他说公司内部大概一半的代码已经由 agent 写,确实比之前好,因为 agent 自己会跑评估;但他也承认,大家只找得到「知道怎么找」的那类缺陷,正确性本身几乎无法验证。
四、AI 监管与全球军备竞赛(21:14)
主持人的问题是一整套:不存在全世界手拉手停下 AI 的世界,那军备竞赛是不是就必然?这套论证能不能赢下那些主张停下来的人?
阿罗拉的答案是没有人会停。他用了一个类比:造飞机的时候 TSA 还不存在,莱特兄弟没在想怎么脱鞋。他的结论落回责任:你造了它、你收了钱,你就得负责;「是 harness 里的 74565 号 agent 写的」这句话不成立。他还说,除非全世界一起唱《Kumbaya》,否则控制它其实做不到——日本不会慢、中国不会慢、印度不会慢;欧洲的例子是把所有可能性都怕一遍,先把监管压上去。
关于监管的动力,克里希纳说得更直:这是被民粹推动的,不是被现实推动的。他从 2022 年数起:参议院闭门听证、公开听证、国会、两届白宫,来回转。他判断五十个州全禁数据中心没有可能,三十个州禁有可能,剩下二十个州会偷着乐。
主持人提到自己上周在华盛顿与一位资深议员的对话:对方说某家最大公司的 CEO 对网络安全已经快疯了;还说四季度可能出现五十州禁数据中心。
关于「有和没有」的分化,阿罗拉说他不担心价格分化,担心算力供给:今天算力很难拿,离震中越远越拿不到;一家欧洲公司意图再好,也可能排不到队。克里希纳把它放回历史:这是劳动与资本的取舍,十七、十八、十九世纪都发生过,七八轮周期里资本密集的那一方都赢了;他补了一句,就业会被替代,但替代之后可能是更好的岗位。
五、垂直整合与软件整合(30:32)
主持人自称垂直整合的粉丝,问 IBM 巅峰时期的故事。克里希纳讲得很具体:六十年代 IBM 一直做到「泥土」——自己找沙、自己做晶圆、自己建厂、自己做芯片,连机柜的金属都自己做;这样避免了 IP 外泄,也把整条栈的利润留在公司里。今天唯一不做的是晶圆制造。「在那些有极其重要优势的领域做垂直整合,非常关键;如果某一层是大宗商品,你就不该待在那儿。」
阿罗拉说现代版本是英伟达:它抱着 Hugging Face,给生态里每个人投钱,确保大家不偏离它那条栈;控制整条栈的好处是可以决定哪一层被商品化,把利润在层与层之间搬。
关于应用层,他的判断是「开放栈对封闭栈」:上下文和记忆没法从推理里切出来,所以 open router 这种只搬推理 token 的层会越来越不成立,应用层最后也会是一条端到端的栈;个人 agent 记住你的一切,你就搬不走。再往外推,是分发之战:未来三个月每家前沿实验室都会对 Muse 这个概念发起全场紧逼,iPhone 上的每个应用都要变成无头的。
最后落到并购。阿罗拉说这八年他一直讲同一件事:客户要买四十个方案再自己缝,这很傻。他举 Fidelity:当年 23 个系统合起来才叫 CRM,今天你买一个现成平台,还嫌它贵;安全会走同一条路。他还提到安全估值最近因为 Mythos 事件变好,会随时间回归理性。安全之外,他说软件的终值很难懂:未来五到八年哪些软件能活下来不清楚,很多公司的产品市场契合正在被打断,而「我对我买的一半套装软件,很清楚在 AI 优先的世界里它该怎么做」,那意味着总有人会去做,SaaS 会有巨大颠覆。
克里希纳接着给出整合的数量级:一家企业平均用 500 到 5,000 家软件供应商,这个数字本身就是攻击面;能不能用一点 AI 能力替掉其中 490 家,只留 5 到 10 个主平台。他相信整合会在六个月到六年之间发生。但他给软件分了层:交互密集的容易被替,要求 10 的负 15 次方可靠性的(零售银行查账、月底关账)很难直接被 AI 生成的软件替掉;要替,得先跑几年数字孪生,而那就没有成本优势了。
口径与核对
人物身份与履历以官方页为准:克里希纳 1962 年生于印度安得拉邦,IIT 坎普尔电气工程本科、伊利诺伊大学厄巴纳-香槟博士,1990 年进 IBM 沃森研究中心,2020 年 4 月任 CEO、2021 年 1 月任董事长,主导 340 亿美元收购 Red Hat 8。阿罗拉 1968 年生于加济阿巴德,IIT(BHU) 本科、Boston College 硕士、Northeastern MBA,1992 年进 Fidelity,2004–2014 年在 Google 任首席商务官,2014–2016 年任 SoftBank 总裁,2018 年起任 Palo Alto Networks CEO 兼董事长 9。
公司数字取自官方财报:Palo Alto Networks 2026 财年四季度(截至 7 月 31 日)收入 34.1 亿美元、同比 +34%,下一代安全 ARR 91 亿美元、同比 +63%,剩余履约义务 212 亿美元;公司给的 FY2030 目标是 200 亿美元 NGS ARR;同一份公告里还宣布收购 Console 10。
三处口径出入要说明。第一,克里希纳说 QBI 现在「只剩 13 家」,DARPA 的公开记录是:已评估 20 多家,最终阶段 6 家。第二,他举例的「Kimi K3、八千亿参数」,公开口径是 2.8 万亿参数的稀疏 MoE。第三,他说 IBM 主机「活了 65 年」,System/360 于 1964 年 4 月发布,到 2026 年是 62 年。
只有节目里说过、没有独立核到的说法,正文照原话保留、不当事实用:在座「一半的 IT 预算买的是不抗量子的基础设施」;终端检测「20 到 25 美元一年」;漏洞「60% 到 80% 是真的」;「企业平均用 500 到 5,000 家软件供应商」;「三十个州可能禁数据中心」;「三个月内每家前沿实验室都会对 Muse 全力出击」。
主持人的名字节目页没有逐个标注,本期是一段多人对谈,逐句译文里统一标为「主持」;两位嘉宾按内容判定,短促的插话可能归属有误。节目里提到的 Mythos 是 Anthropic 在 Project Glasswing 下先给防守方预览的安全模型 11。
逐句全文翻译
以下是整集逐句中文翻译,底稿为官方视频的完整英文字幕 12。只保留中文,保留说话人标签,按官方五段时间点分节,不压缩、不摘要、不删减;口语里的重复与语气词按中文习惯合并,论点、数据与例子一个不少。
一、量子计算对加密的威胁(0:00–9:07)
主持:我知道你们这两天在对话里把 T 开头的那个词用得太多了——token。也许我们可以稍微从 AI 上挪开一点。我想它还是跟 AI 有点关系,但过去这两天有一大串关于密码学的讨论,还有密码学面临的一些风险。我觉得它是从 OpenAI 那批数学结果放出来之后开始的,不过现在更多人在谈那个大的量子计划,以及它会不会把我们带进一个必须开始考虑采用量子密码学的时代。阿尔文德,也许我们可以从你这儿开始,谈谈今天的情况到底站在哪儿。
阿尔文德:好。大卫刚才点到的一点是,DARPA 一直在办一个竞赛,叫 QBI,量子基准计划。几年前有两百来家公司参加,我记得现在只剩大概 13 家。这大概能告诉你什么可能是真的。我说的是「可能」,不是「就是真的」——有一部分是真的。他们的目标是:谁能造出一台真正能用的量子计算机。先把技术路线放在一边。争论在于那一年是 2028、2029 还是 2033;如果你取中间点,我们就叫它 2030 年。到那时,它会破掉今天的密码学。这不是假设,这就是现实。如果这件事会发生,那你该用什么密码学来保护自己?对在座一些人更糟的是:如果你今天有一块加密硬盘被偷走,对方可以把它留五年,到那时候再破。好消息是,后量子密码在理论上已经被理解、是众所周知的、代码也已经写出来了,只是大家太懒,没去做。但我认为醒悟的时刻就是现在。
主持:我们理解的这些方案,是「量子证明」还是「抗量子」?因为它们似乎建立在我们今天对量子计算大概会长成什么样的一种基本理解上。
阿尔文德:是,也不是。它建立在理论层面对量子能做什么的理解上。所以说它们「量子证明」,其严格程度和「今天的密码学不能被今天的经典计算机破掉」是同一档——那其实不是定理级别的证明,更多是建立在计算机科学的复杂性理论之上,而复杂性理论最终又落在一些假设上。所以你看今天的位置,再看 2030 那个中点——
主持:你能不能带我们走一遍那些演化时刻?就是我们必须开始注意、并且说「好,我们该怎么动」的那些节点。
阿尔文德:可以。今天你手上的是玩具级的量子计算机——我叫它们玩具,是因为它们能做某些特定问题,但错误率极高,而且还没有真正扩展的办法。所以第一个问题会是:谁第一个能在一个真正运行的量子计算机上,不是模拟、不是在旁边算,而是做出某种程度的纠错或错误缓解?我预计明年就会有人出来宣称做到了,那时你要让第三方去评估这些宣称是不是真的;你会发现一两家到 2027 年真的做出了进展——不是规模化,但是纠错。
阿尔文德:第二个问题是:你能不能在某种规模上跑这些东西?还不是完整规模。我姑且叫它「门计算」。今天大多数人大概在一万这个量级;如果你拿普通计算机来比,这不算多——你的 iPhone 一分钟就能做几十亿次。
阿尔文德:所以门的竞赛就是:有人从一万起步,能不能每年加一个零?这是我会放的第二个里程碑。把这两步放在一起,如果每年加一个零,那到 2029 年你就可能到一千万门。那很了不起,那能做点让所有人吓一跳的事。
主持:这说的是不是「逻辑量子比特」这个概念——一个经过纠错、真正能运行的量子比特?你们采用「逻辑量子比特」这个说法吗?是不是大家用的都是同一个里程碑、同一个指标?
阿尔文德:我不太喜欢这个词,但我觉得它是个公平的说法,能跟人解释清楚。比如我说我在造一台计算机,它有一万个量子比特,人家说:是啊,但它们全是噪声。你说得对。所以当我开始纠错,某种意义上会降低机器的有效容量。那「逻辑比特」说的就是:这台机器的有效容量是多少——我觉得这是个合理的看法。所以这个词我并不偏爱,因为它不是「我拿了四个东西做成一个单元」就完了;真正被纠错的是整台机器。但物理比特和逻辑比特之间确实有个换算,也许是两百个物理换一个逻辑。
主持:假设你有红队,专门想前沿在哪儿、怎么往前推。如果你开始看到数量级这样复利式地叠上去,你的红队会说,显而易见的蜜罐在哪儿?如果你是个坏人,你会往哪儿打?
尼克什:如果你从「在座每一家的整个 IT 基础设施上几乎都跑着加密密钥」这个角度看,它不是一个东西,是所有东西都在用加密密钥跑,我们这个行业里每一家厂商在两端都有密钥。所以第一件会发生的事是:凡是不抗量子的,都会变得可破。所以我们的看法是,你不能等到 2029 或 2030——因为不会有一天所有人一起走出来说:我们把五万亿美元的 IT 基础设施烧了,一年之内重建成量子安全的。所以你现在就该把 IT 栈换成量子安全、或者说量子证明的基础设施,就是现在。现在已经有一些技术和能力在市场上,你可以先把「后量子就绪」的密钥包在流量外面当过渡。你可以这么做,但如果他说的是 2029、2030,那我们已经晚了。
主持:我们离那儿只剩三年。而且我很确定在座每一家今年都锁定了几亿美元的 IT 支出,我猜其中 50% 买的是不抗量子的基础设施。
主持:有一位资历很深的 AI 研究者说过——我们先把它归到 2029 那一档——他的看法是,今天的 AI 模型可能比量子计算机更早把我们带到那儿。你怎么看?我想这背后是这样一种想法:在数论的前沿,AI 可能开始形成人类今天看不出来的模型和证明,让我们重新思考怎么有效地做代码、做密码。也许这周 OpenAI 那批数学结果就是他说对了的一个早期迹象。既然你刚才往那个方向钻了一点,那也允许我钻一下。
阿尔文德:说到底,那不会成为可能。这可以追到费曼那些人做过的东西:你不能在另一种架构上模拟某件事,还指望得到更高效的结果。
阿尔文德:你把这条当作前提:量子计算机不跑算术,对吧?而所有经典计算机,包括 GPU,跑的都是算术。你能不能让一个 AI 算法发现一个新的量子算法?当然能。它能不能在今天的硬件上高效地跑起来?不能,不可能。所以你需要量子硬件去跑这些东西,才能拿到量子算法带来的那个正向优势;否则它会慢上一千到一万倍。所以,它能不能证明这是个可行的算法?能。它能不能让你拿到那个收益?不太可能。
主持:我认为这个论证是——我知道我们钻进技术里一分钟——只用经典计算,你其实可以走另一条路,一条算术的路。比如,如果你能更好地预测素数的分布,你知道,就是数论前沿那些我们还没真正解决的问题,那我们就可能开始有经典模型去破密码。
阿尔文德:那是有可能的。问题是它们要花多久,因为这才是关键。所以我认为那会变成可能,但如果破一把密钥要十年,大多数人那时候都已经安息了。那不是实用答案。我认为争论会停在这儿,但在事情真的做出来之前,它不会被证明。
二、开放权重与前沿模型(9:07–18:07)
主持:让我把话题挪到正在发生的事上。我很想听听你们两位对下面这个概念的看法:有开源、有闭源、有前沿、有「放慢前沿」,现在还有了至少是开放权重、而且相当够用的替代品。你们对整个谱系的哲学是什么?也给我们一个感觉:未来几年我们该怎么想模型和能力?尼克什,你先来?
尼克什:好。今天早些时候有人说过一句话:在实验阶段,不要限制团队的能力。别急着做成本优化,别急着在这阶段自己拼一套东西。因为我们手下的团队,从 20 人到两万人,都是过去 12 到 18 个月才刚发现 AI 的,它在组织里还没有完全扩散。所以如果你让他们更难用、更难理解,我们要准备好就更慢。所以现在我们的说法是:去找你能找到的最好的模型,用最容易的入口去用,这样你才能验证这些东西到底能做什么——从效率、从收入、从产品开发的角度。这算第一阶段。但在第一阶段里我们发现,不同的赛道有不同的力量在起作用。
尼克什:很多人没意识到:曾经有个时刻,我们以为网络安全会被 AI 模型吃掉,我们的日子到头了,因为 Mythos 会把一切都解决。结果呢?我们在终端上检查所有流量,一年 20 美元。每个终端几百兆的流量,一年 20 到 25 美元,因为机器学习就住在你的终端、你的算力上,我们在 20、30、40 兆的负载上跑它。
尼克什:现在你想把所有这些流量都拿走,用 token 送进 OpenAI,公司里每个员工都送一遍——那听起来像是「收入的声音」,OpenAI 大概能从一家公司身上就赚到它全部的收入。所以那不是模型该怎么用的现实例子。你真正要做的是:拿一个小语言模型,压缩它,让它任务专用,一直训练到 99.9% 的准确率,然后说:我们不用机器学习算法了,我们用生成式 AI 的小语言模型,让它们在末端干这件事。
尼克什:所以我的观点是,我们在搞清楚:什么任务需要什么级别的智能,以及那个级别的智能对那个特定任务的成本是多少。你会突然发现:不是每个任务都需要法拉利。顺便说,客户也不想为每个任务付法拉利的钱。
尼克什:我再说另一面。假设你正在被攻击、正在出事,那个时刻,在座每一位客户都会说:别管用哪个模型,先把攻击停下来——因为他们知道那次入侵的业务损失是十亿级的。那个时刻我可以跑 agent 群,可以做任何防守方想做的事。所以在那时,我可能就想用最新的前沿大模型,说:去好好想,往死里推理,搞清楚怎么止住这次入侵、怎么让它停下来。
尼克什:所以我们发现的是:你会在那些「被打断的业务价值足以支撑」的特殊场景里用前沿模型。你想做药物发现也可以。我认为对企业里绝大多数实用场景,我们最后会训练某种开源模型的某个变体。甚至和平时期,比如我们跑一个防守模型,我们多半会拿一个开放权重模型,用我们自己的专有数据去训、自己去管权重——因为那才给我们可审计性、可解释性,以及一个我们能解释「这是怎么发生的」的开放系统。
阿尔文德:我完全同意,但我想换一个视角,走到完全一样的结论。我们看经济账。今天是每百万 token 20 美元,大概是上一代模型;你要最极端的那一档,是 50 美元。我们可以拿一个中国的开放权重模型,比如 Kimi K3 之类、八千亿参数,如果你用自己的 GPU、做一点优化——我说的是一周左右的工程量——我们能把成本降到每百万 token 一美元到两美元。世界上哪家企业会拒绝一个便宜 10 倍、在这个例子里是便宜 40 倍,而实际上还能干 95% 的活的答案?
阿尔文德:所以第一,经济账很重要。第二,说到底——你刚才谈到思维链,不只是最终输出的 token。如果思维链能被别人抓取、记录、审计,那你实际上是在把自己的 IP 送出去。所以品牌和 IP 会推着人说:我得在自己的环境里跑模型。可你跑不了前沿模型,因为没有人会把它给你。那你就回到开放权重。第三是地缘政治。今天最好的开放权重模型是中国的。顺便说,如果你把它们放进沙箱、自己跑,我认为危险很小;当然,如果你从云上调用它们,那是另一回事。但我很怀疑在未来一两年里,西方不会出现同样强、同样是开放权重的好模型。这些东西的差距最多 6 到 12 个月。所以这三条让我得出结论:我不确定是 75% 还是 90%,但这个区间是我会放的——所有 token 使用量里,会有这么大比例走向开放权重模型,原因是我说的这些,加上尼克什说的那些。
主持:那剩下那部分 token 消耗,是因为你真的需要它,还是因为那是一种默认行为、而人太懒不愿意改?
阿尔文德:好,那我来谈开发者行为。因为我当年就是开发者,我是在开自己年轻时的玩笑:开发者是懒的,他们会用最贵的那个答案,除非你给它加个控制,因为那样最省事。
阿尔文德:所以事情会往那儿走。我会说:实验阶段你允许这样,去证明它行得通;然后我要换上一个更便宜的答案,如果它能让我更快到那儿,大概也没问题。但把它用在生产用途上——除了极少数场景,我对它的价值是怀疑的。
三、AI 与网络战(18:07–21:14)
主持:你们被拉进了那个很小的圈子——Mythos 的预览,作为他们的伙伴。我确定你现在跟 OpenAI 也在做同样的事。当你坐在这些人面前,你心里会不会有一部分在想:他们在看我的生意,然后想「哇,这是门好生意」?你会有这种想法吗?你预期哪些技术边界会被尊重?
主持:我这么问,是因为我们跟另外几位 CEO 聊过,马克·贝尼奥夫大概是最好的例子:我们谈过零数据留存,他在替客户确保「零留存」这件事上非常强硬。有意思的是,所有这些零留存条款里,没有一个模型承诺不生成合成数据——它根本不在里面。你们应该去看看,到处都是退路,到处都是暗门。所以我只是想知道,当你在那个房间里,你在想什么?你走出来会说:这些人进不了我的生意。
尼克什:他们进不了。
尼克什:因为他们进不了我的生意。你想想 Mythos 出来的时候,对吧?我们已经在编码 agent 上花了几十亿美元。结果呢,并不是每个人都对编码数据做了零留存;外面有大量的人在用 Claude Code,他们完全不介意那些数据拿去训模型。所以我们是在用终端用户写代码的数据训这些模型,这些模型写代码越来越强。教会一个模型什么是好代码,它也就知道什么是坏代码。所以 Mythos 做的第一件事,就是搞清楚了坏代码长什么样;你让它对着你的代码跑,它会告诉你哪里是坏的。
尼克什:有意思的是,即使那样,它当时还有 30% 的时候是在编。但对攻击者来说它仍然完美,因为攻击者只需要一个漏洞,不需要十个。而防守方要把每一个漏洞都找出来、都补上。过去 12 个月,在座所有人都走完了这段路:大家拿 Mythos、或者它的某个表亲、或者某些开源模型去扫过,然后发现每一个漏洞都必须被再测一遍、被理解、被搞清楚。我猜在这个房间里举手,大概 60% 到 80% 是真的,20% 是幻觉。
尼克什:从这个角度说,模型在「告诉你漏洞在哪儿」这件事上很棒。但我甚至不认为在座有任何人会举手说:他们会用 Claude Code 去补这个漏洞,而不用再测一遍。
主持:我有个挺随机的问题,但它让我想到一件事。你们是在替公司做防守,而现在这看起来基本上就是战争——你们两位,这就像战争。那么,从战争是怎么打的、现在怎么打里,有没有什么东西可以学,并且真的用来指导这项技术该怎么表现?我不知道这个问题说不说得通。
尼克什:我认为,只要你能「一起做得更好」,就可以协作——阿尔文德在跑一个项目。我们在说:大家都在找漏洞,那为什么不把漏洞汇总起来,一次把防守做出来?而不是在座每一家公司各自去测他们用到的开源代码、各自想怎么补、各自去补。你可以找几个可信的机构:把漏洞给我们,我们统一补,再把补丁分发出去,让大家同时安全。这有点像今天网络安全的工作方式:你在世界某个角落发现一种攻击手法,我们可以把那个手法写成机器学习代码、吃进产品,确保每个客户都能用上。
主持:agent 写出来的代码是无错的吗?
阿尔文德:不是。
主持:不是。好,解释一下。
阿尔文德:先说你的战争问题。尼克什讲的是:你可以有强大的联盟,联盟的力量实际上可以大过攻击者,这是第一种打法。第二种在战争里最有效的是不对称:攻击者往往比防守者便宜,于是防守者钱花光了,某个时刻就认了。或者,你能不能把防守做得一样便宜?那样你就基本处在对称战争里,成功的概率就大得多。第三种,也是所有战争最终被赢下来的方式:当一方拿到技术优势。回到二战、回到朝鲜、回到伊拉克,回到任何一场——只要一方拿到技术优势,往往就赢了。
阿尔文德:所以我们的目标是:我们能不能拿到技术优势。这就是尼克说的:我们能不能找到漏洞?能不能补上?能不能在它们周围划出边界,让对手想找到一条穿过去的路变得极其昂贵。这就是我的回答。
阿尔文德:那 agent 写的代码最终会不会优于人写的?绝对会。我们现在内部大概一半的代码是用 agent 和编码 agent 写的,它比之前写的更好。它更好的原因是 agent 自己也会做评估,基本上确保它找到的每一个问题在出门之前都被修掉了。话虽如此,我们也只是在找「我们知道怎么找」的那些缺陷。
主持:它有办法被真正验证吗?
阿尔文德:它不能被完全验证,因为这件事现在在计算上几乎不可行。我不会指望它变成你刚才说的 2030 年那些东西。这件事上,也许我们能找到办法去验证这些东西的正确性——至少在输入有限的地方。如果输入可以是任何东西,那我认为真的很难。
阿尔文德:这样说通吗?
主持:说得通。
四、AI 监管与全球军备竞赛(21:14–30:32)
主持:我想问一下你们刚才那些点的含义。在我看来很明显:不存在那样一个世界——中国、美国、西方或者一堆国家手拉手说「我们一起停下 AI 研发」。既然这样,军备竞赛就成了必然:要有攻防上的优势,要有算力,要有这一整套为了保住产业、保住经济、保住就业而产生的需求。在那些想让 AI 停下来的人那里,在政治讨论和社会舆论说「AI 必须停、我们必须停」那里,这套论证能赢吗?「一方必然拥有、另一方就必然要防」这一点,会改变对话吗?我也很想听你们讲讲跟那些现在不在台上、但可能上台的党内高层的对话——他们会不会因为这个点而改变看法。
尼克什:我认为非常清楚:没有人会停。每个人都在用疯狂的速度,确保自己拿到更好、更聪明、更快的模型。这挺有意思的。你可以往善意的一面看:世界上没有任何一项技术在诞生时,人们是同时把安全和权力一起造进去的。造飞机的时候,我不认为 TSA 已经存在。莱特兄弟说:太好了,我们有飞机了,我们来研究怎么脱鞋。
主持:让所有人登机前先冒个险。
尼克什:对,把炸药挡在鞋外面。那不是他们当时在想的事。
尼克什:所以不幸的是,我们被展示了这些模型的暗面,而我们在暗面上过度反应了:现在整场对话都在讲 AI 的暗面、讲风险,而不讲 AI 的好处。我认为这里有个叙事问题,但尽管如此,我不认为有人在放慢。
尼克什:我认为最可能的结果——也希望是正确的结果——是:你造了它,你就要为它负责。你造了一个东西然后放出去,你不能放出去之后说:哎呀,我不知道怎么控制它。这个说法不成立。
阿尔文德:对。
尼克什:因为软件是你写的。
主持:是。而且「软件不是你写的、是软件自己写的」这套说法——
主持:因为工程师会说:是我这套 harness 里的 74565 号 agent 写的。那不行,是你写的。
尼克什:好吧,但公司还是写了它。所以那是个产品,而你是家商业企业。对。你拿了经济回报,作为交换给我一样东西。你就必须承担你签下来的那份责任。所以在我看来,就这么简单。而且世界上已经有足够多的监管——也许是太多——去追究那些把东西放到公开市场上、却不承担责任的人。他们不承担责任。
尼克什:但大卫,除非我们相信全世界会一起唱《Kumbaya》、说「我们一起放慢」,而你也说过那不太可能,否则控制它其实是不可能的。既然如此,好吧。你可能在这里放慢一点,那又怎样?日本会放慢吗?中国会放慢吗?印度会放慢吗?没门。他们会说:太好了,你慢下来了,这给了我追上并超过你的机会。所以一项数字技术在实际上是不可能被放慢的,欧洲的例子已经告诉我们了。所以你在那里会害怕所有可能性——我不是说那些危险都是真的——你害怕其中每一种,于是先把监管压上去。我猜那里的科技经济真是非常有活力。
主持:是。我的意思是,你们两位其实都没回答我关于「你们有过什么对话」的问题。那我讲一个我上周在华盛顿的对话。我跟一位国会议员喝酒,级别相当高,对话有两部分。第一,他认为世界上最大的公司之一的那位 CEO 对网络安全彻底慌了,快疯了,不知道该怎么办;他刚跟他吃过饭,以下是他说的一堆话。第二,他认为到四季度我们可能会看到 50 个州一起禁数据中心——这不太可能,但他说 50 是个很大的数字。很大的数字。
主持:这个国家有 50 个州在哪件事上达成过一致吗?
尼克什:没有。
主持:有几件事吧。
主持:那会很了不起。
主持:是啊,把所有人凑到一起。
主持:当所有人都同意一件事的时候,你知道,那件事就不是真的。
主持:但我认为那像个奇迹。而关键在于:这两句话是同一个人说出来的。所以你觉得这件事会怎么收场?我们怎么往前走?
阿尔文德:我试着直接回答你的问题。我们这些人,还有你们团队里其他人,都跟这届政府、上一届政府的不同人谈过。参议院的周期比一届政府更长,国会变得快得多。这个问题从 2022 年就在那儿了:参议院 2022 年开过闭门听证,2023 年开过公开听证,国会开过,两届政府的白宫都开过。他们就在这个问题上来回转。
阿尔文德:关于 AI 和数据中心的监管问题,说得抱歉一点、犬儒一点,是被民粹推动的,不是被任何现实推动的。如果我能多拿几张票,我该不该看起来像在做那些事?政治就是政治。我不会说那不真实——它是真实的。话虽如此,也有足够多的人深切关心长期的经济优势。所以那是一个正在发生的平衡。我认为我们现在的平衡是对的,但我承认,一场选举可以改变我们落在这条平衡线的哪一边。
阿尔文德:关于数据中心,我认为 50 个州全禁没有任何可能。30 个州禁有可能吗?有。到那时剩下那 20 个州会搓着手偷着乐。
主持:如果你从地缘政治的角度看一秒钟,我们似乎正在走向一个「有和没有」的世界。在座各位都是「有」的那一边:你是西方市场的公司,你有幸能和你们这样的人合作。但对世界上随便哪家公司来说,入场费可能高到不划算。那么当这些模型能力这么强、而且实际上几乎免费的时候,会发生什么?实际的表现形式是什么?我确定你们想过该怎么回应。你们怎么看这种「有和没有」的分化?
尼克什:我认为阿尔文说过:你得让技术便宜到每个人都能轻易获得。我认为我们有机会让这件事发生。我不认为它会贵到——只要你能经营一家企业,就应该有可能在预算范围内找到保护自己的办法。所以我不认为我们最后会走到「有和没有」的局面。
尼克什:我认为更大的挑战、也是跟在座各位更相关的,是我担心算力的进展会集中在世界上两个大国,而不会那么均匀地分布到世界其他地方。而且现在算力非常贵、非常难拿——此刻要拿到算力去规模化跑任何东西都很难。挑战会是:你离震中越远,你拿到这些算力的可能性就越低。这不是经济原因,纯粹是供给约束。我认为那是更大的挑战。你可以是一家欧洲公司,意图很好、有动力去创新、优化、跑起来,然后你可能突然发现,因为你离震中太远,你拿到的访问量就是不如美国、或者中国的公司。
阿尔文德:我喜欢看历史,因为它能给我们一些关于这些东西怎么展开的信息。我认为这就是正在发生的、经典的劳动与资本的取舍。十七世纪发生过,十八世纪又发生,十九世纪又发生。在之前七八轮这样的周期里,那些在资本上花得更多、而不是担心劳动的人,往往赢了。所以这次也会这样。尼克什指出的是:这里的两个国家也非常愿意走资本密集的路。
阿尔文德:对,事情没这么简单。他们最终愿意承认:劳动会变得没那么重要。事情就是会这样展开。那些被社会哲学、被左倾哲学缠住的国家——不是「要为劳动创造机会」,而是「每一个现有岗位都必须被保住」——会输。因为,回到尼克什的说法,它已经足够便宜了:某个国家里的人可以用上这个能力,但他脑子里会想:这是不是意味着有人失业、有人被替代?岗位被替代你应该接受,因为它可能带来更好的工作。我认为决定赢家和输家的,就是这套社会哲学。
五、垂直整合与软件整合(30:32–40:00)
主持:在把最后一个问题交给你之前,我还有最后一个问题,给你们两位的。你刚才提到这个,讲得很好。能不能讲讲那个故事——我是垂直整合的巨大粉丝,巨大的粉丝。我认为市场像钟摆:六十年代、七十年代、八十年代曾经是综合企业的世界,那是一种非常有价值的企业形态,在动荡时期它是资本的避风港,因为综合企业是组织的方式;然后到了和平与繁荣时期,人们又把它拆开。我觉得我们正在回到综合企业的世界。你刚才在那边跟我讲了 IBM 巅峰时期的垂直整合。我想让你讲讲,然后尼克,你怎么看垂直整合?
阿尔文德:我和人经常谈 IBM 大型主机——顺便说,在座有几个人用得相当好、而且规模很大——IBM 主机活了 65 年。为什么?它是垂直整合的。我们现在整合得少一点,因为我们没有一直做到「泥土」。六十年代我们一直做到泥土:我们自己找沙子,自己做晶圆,自己建厂,自己做芯片,一直到包住整台机器的每一块金属。这样做避免了任何 IP 外泄,也让我们把整条栈的利润留在公司里。今天我们唯一不做的是真正的晶圆制造;芯片设计、工程、可靠性、绝大部分软件,都在里面。
阿尔文德:这种垂直整合你要做选择:当然,我不会自己造金属,你买金属;厂(fab)也一样,因为规模。但我认为,在那些有极其重要优势的领域做垂直整合——这就回到你们两位刚才讲的基础设施那点——非常关键:要搞清楚你想站在哪儿,而如果某一层是大宗商品,你就不该待在那儿。
主持:对。
尼克什:但你能看到,这件事的现代版本是英伟达。
主持:对。
尼克什:你看黄仁勋在做什么,他就是垂直整合栈的现代版本。他去买了——
主持:他在泥土那一端。
尼克什:他抱着 Hugging Face。他明白前沿模型和其他模型之间会有个平衡。他在给生态里的每一个人投钱,确保大家不偏离他正在造的那条垂直整合的栈。好消息是:如果你控制整条栈,你就能决定哪一部分被商品化。你可以决定在层与层之间搬利润:如果你看到有人在攻击你栈里的某一部分、把那一层的利润池毁掉,你就把利润搬到栈的另一部分。你能看到这种事正在发生。
主持:非常强的市场杠杆。那我把你放到火上烤一下:看今天的应用层,OpenAI 或 Anthropic 最明显的垂直整合策略是什么?而那些可能被整合掉的公司,防守机制又是什么?
尼克什:我认为你已经看到它在发生了。而且我们经常把这场对话讲得太轻:我们一开口就说开放模型、开放权重,其实它根本就是开放栈对封闭栈。我认为在某个时点,「跑一个 open router 之类的东西」这个想法会变得不可能,因为模型越来越大,每个模型都需要更多记忆、更多上下文、更多理解。你现在没法把上下文和记忆从推理里分开;如果你硬要把推理从上下文和记忆里分开,那 open router 就只负责把推理的 token 搬来搬去。
尼克什:所以随着时间推移你会开始看到:做成一条端到端的栈才说得通。它像你刚才聊天时提到的 CPA——按动作收费。一个动作要求你走完从提示到结果的整段逻辑;而记忆会让你更容易,但它也会让摩擦变得太高:你的任务带着全部上下文和记忆,很难从一条栈搬到另一条栈。
尼克什:你会看到这一点。看看个人 agent 这一块正在发生什么:如果你开始用一个 agent 去训练你所有的上下文、所有 API、所有连接,你就造出一道护城河,因为现在我没法每天把它搬到下一条栈、再下一条栈。所以我认为在应用层,他们也会有一条垂直的栈,贯穿软件、推理、记忆、上下文。
主持:按你的逻辑推到底,那每个人都得有自己的。
尼克什:是的。
主持:因为那是正确的事。
尼克什:然后,粗暴的分发能力又会赢——在企业市场是这样,你在消费市场也看到了。粗暴的分发会参与竞争。未来三个月,每一家前沿实验室都会对 Muse 这个概念发起全场紧逼。他们六到九个月前试过一次,没成。
尼克什:现在 Facebook 给大家示范了它能怎么成。我认为几乎人人都会有这个。会有 API。会有一场最大的消费者控制权之战。iPhone 上现存的每一个应用,都必须变成无头的。
主持:也许我们可以就此收尾:从垂直整合走向横向扩张。通过并购横向扩张、做协同、做交叉销售,一直是企业技术公司的常见策略。你们两位显然都做得极好、执行得极好。过去这一年,你们的看法在估值、倍数、资本成本上有什么变化?我们先谈网络安全语境下的并购,再谈网络安全之外的并购。
尼克什:在网络安全这个语境里,过去八年我一直坚持一个观点:客户要买 40 个不同的方案、再自己缝起来,这很傻。我们连自己都不太搞得懂,你以为你搞得懂另外十个厂商的东西、还能把它们缝起来?上帝保佑你。所以我们正尽可能快地,把这个行业里分散的部分拿过来,找到把它们缝在一起的办法,让数据能一起工作。我认为这是一段旅程。
尼克什:如果你想找个类比:我第一份工作在 Fidelity,很多年前,我们有 23 个系统,合起来在今天才叫 CRM。我们有主表,有拼接上去的表,有 23 个不同的应用做 20 件不同的事。今天你去买现成的,然后对着 Salesforce、Microsoft Dynamics、Oracle 的价格皱眉——不管你选哪个。三十年里发生的是:它整合成了一个单一平台。客户不再自己缝方案了,因为这些软件解决方案变得同质:它们都长得像彼此,都大致做同样的事,没有差异化。
尼克什:所以我认为网络安全也会发生同样的事。这就是我们一直在做的:找到各自品类里最好的东西,缝起来,让它们能用,这样客户就不必自己去缝。这就是网络安全那一半的答案。不知道为什么,网络安全最近的估值好得多,因为 AI 的 Mythos 事件——这没问题,随着时间会回归理性,因为这些人都会在安全上花没有上限的钱。
尼克什:安全之外,我认为就回到我刚才跟查马斯聊的那段:软件的终值非常难懂。以我们今天在 AI 上的位置,未来五到八年哪些软件能活下来并不清楚,而且很多公司的产品市场契合正在被打断。我们都知道,如果 AI 被用得好,我们今天的软件在理想状态下应该怎么表现。我对我买的一半套装软件,很清楚我想要什么;如果我有根魔杖能让它做事,我完全知道它在 AI 优先的世界里应该怎么运作——那意味着总有人会去做。所以我认为未来几年 SaaS 领域会有巨大的颠覆。
主持:阿尔文德,你有没有在看什么东西,心里想「嗯,倍数很肥」?
阿尔文德:一年前它非常有吸引力,一个月前就没那么有吸引力了。我们再看接下来几个月会怎么走。但其实我想接着尼克什的想法说:这并不只是安全行业独有的。一家企业平均用 500 到 5,000 家不同的软件供应商。在一个你必须对所有东西做防护的世界里,这就不只是网络威胁的问题——那是一个巨大的攻击面。
阿尔文德:所以你得问自己:我能不能用一点 AI 能力替掉其中 490 家?我是不是该回头只依靠 5 到 10 个主平台?那意味着大规模整合,因为钱是往那儿去的。我相信这会发生。会整合,因为你想把分销成本压住,他们就能把全部东西分销出去;而如果那个软件的价值在下降,你就负担不起每一家都独立分销。我相信这件事会发生,是六个月还是六年,就在这个区间里。
阿尔文德:我也认为软件必须被区分开。有一类软件有大量交互价值,我们已经清楚看到它可以被大量 AI 替代——你举的两个例子都是交互很重的。
主持:对。
阿尔文德:但如果最后落到「我需要你在 10 的负 15 次方上可靠」——
主持:对。
阿尔文德:比如零售银行里查一笔账,或者月底关账,那种数据库查询。我认为那很难被 AI 生成的软件轻易替掉。所以我认为会有一个区分:有些容易,有些难。
主持:你要跑好几年那个数字孪生,才敢切过去。
阿尔文德:对。
主持:而那样做就没有成本优势了。好了各位,非常感谢。阿尔文德·克里希纳,谢谢。
阿尔文德:谢谢。
尼克什:谢谢大家,谢谢你们所有人。
主持:我全押了。
References
- 1All-In 官方单集页
allinchamathjason.libsyn.com
- 2DARPA:四家进入 QBI 最终阶段
darpa.mil
- 3NIST:三套后量子标准获批
csrc.nist.gov
- 4NSA:CNSA 2.0 问答
media.defense.gov
- 5IBM:与芝加哥大学演示量子优势
newsroom.ibm.com
- 6IBM 量子硬件与路线图
ibm.com
- 7Interconnects:Kimi K3 与开放权重的升级
interconnects.ai
- 8IBM 新闻室:Arvind Krishna
newsroom.ibm.com
- 9Palo Alto Networks:管理层页
paloaltonetworks.com
- 10Palo Alto Networks:FY2026 四季度业绩
prnewswire.com
- 11Anthropic:Project Glasswing
anthropic.com
- 12官方视频(完整英文字幕)
youtube.com
Comments