《Support-vector networks》:十亿维的空间里,分界面为什么只由少数几个点写出来
从「数据分不开时最大间隔还留不留」讲起,把 1995 年这篇论文的规范超平面、拉格朗日对偶与 Kuhn-Tucker 条件逐步拆开,说明分界面为何只由少数几个支持向量写出、核怎样把十亿维藏进一次点积,并用 USPS 与 NIST 的三张表读懂 1.1% 这个成绩量的到底是谁。

1995 年 9 月,《Machine Learning》第 20 卷第 3 期登出一篇 25 页的文章,题目是《Support-vector networks》。1
作者是 Corinna Cortes 与 Vladimir Vapnik,两人当时都在 AT&T Labs-Research。2
到 2026 年 10 月,Crossref 为这条记录计到 31,256 次引用。3
论文接的是 1992 年的一项结果:只要训练数据能被一张超平面干净地分开,就能造出一张间隔最大的分界面,而这张分界面只由少数几个训练点决定。4
那份工作只覆盖「分得开」这一种情形。真实数据里总有噪声、离群点与重叠,这条技术在实验室之外用不起来。
这一篇补的就是这一段:数据分不开的时候,最大间隔还留不留、怎么留。
论文给这类机器起的名字是 support-vector network,支持向量网络。第 5 页有个脚注解释命名的用意:解在支持向量上展开,所以构造的复杂度取决于支持向量的个数,与特征空间的维数无关。2
后来的文献多改叫 support vector machine,支持向量机。1998 年 Burges 的教程已经用这个名字。5
下面的事实、公式、三张表与两张正文图,都按这篇论文的排版版读:31 页,公式编号 (1)–(67),表 1–表 3,图 1–图 9。2
两笔旧账:分得开,与分得好
论文从六十年前讲起。Fisher 在 1936 年处理的是一对正态总体:两个协方差矩阵不等时,最优的贝叶斯解是一个二次判别函数。2
两个协方差相等时,这个二次函数退化成线性函数,待估的参数只剩 n 个。2
麻烦出在样本量。观测数小于 n² 那个量级时,估 O(n²) 个参数不可靠,Fisher 因此建议即便协方差不等也退回线性判别。2
1962 年 Rosenblatt 换了一条路:感知机。每个神经元实现一张分隔超平面,整个网络实现一张分段线性的分界面。2
让全部权重一起调整的算法当时还没出现。论文写,那样的算法后来才被发现,解法需要对神经元的数学模型做一处小改动。2
把其余权重固定住,输入向量就被非线性地变换到最后一层单元的特征空间里,在那里构造一个线性决策函数 I(x) = sign(Σ α_i z_i(x))。2
绕一圈回来,决策规则的构造仍然是「在某个空间里画一张超平面」。
这篇论文的机器把这个想法推到极端:先选一个非线性映射,把输入送进高维特征空间 Z,在 Z 里画一张带特殊性质的线性分界面,靠这个性质保证泛化能力。2
两个困难随之出现。概念上的困难是:特征空间维数极高,能分开训练数据的超平面有无数张,哪一张在新样本上靠得住?2
技术上的困难是算不动。四阶或五阶的多项式,在 200 维输入上就要在十亿维的空间里造超平面。2
概念那一半在 1965 年有了答案,论文把功劳记在最优超平面上,标注的文献是 Vapnik 1982 年那本书的附录一。2
关键的一句是:造这张超平面只需用到少量训练数据,也就是支持向量。
由此有一个界:
右边是支持向量个数的期望除以训练样本数,式子里没有出现维数。2
这句话读起来反直觉。一个分类器的错误率期望,可以被「它用了多少训练点来写答案」这个比值压住,跟特征空间有多大无关。
论文顺手给了个量级:在真实问题里这个比值可以低到 0.03,而那张超平面照样在十亿维的空间里泛化。2
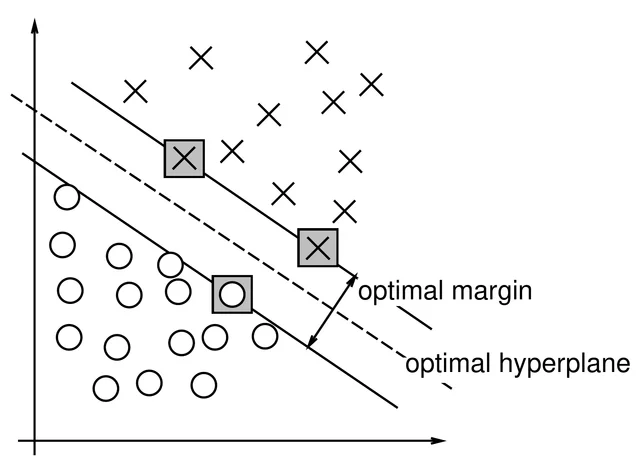
直觉可以这样建:把两类点画在纸上,分界线附近以外的点往外挪几毫米,线不用动;真正决定线往哪边倒的,只有贴着走廊的那几个点。
间隔:把「分对」换成一个能最大化的量
线性可分指的是存在 w 与 b,让每个训练点的 y_i(w·x_i + b) 都取到正的某个值。2
把右边固定成 1 不损失一般性:任意一组满足不等式的 (w, b),整体除以「所有点的 y_i(w·x_i+b) 里的最小值」,右端就变成 1,分界面的位置不变。2
归一之后写成:
右端被定成常数、w 不做归一,这就是「规范超平面」。2
有了规范形式,走廊的宽度才有确定的长度:
两条边界线分别过 w·x + b = 1 与 w·x + b = −1,它们之间的距离只由 w 的长度决定。2
于是最大化间隔就等于最小化 w·w。约束是一批线性不等式,目标是一个二次函数,问题落进二次规划。
走廊越宽,两类之间留出的缓冲越大,新样本掉到对面去的机会越小。这就是「最大间隔」在直觉层面的全部内容。
拉格朗日乘子:为什么答案只由少数几个点写出来
带约束的最小化被写成拉格朗日函数:原始目标减去每个约束乘上它的乘子,乘子非负。2
对 w 求偏导并令它为零,得到:
这一步在算什么:它把「待求的权重向量」换成「训练点的一个加权和」。权重是乘子,标签是正负号。2
对 b 求偏导,得到另一个条件:Σ α_i y_i = 0。它管的是整体的正负配额要平衡。2
把这两式代回拉格朗日函数,w 与 b 都被消掉,只剩乘子:
原来要求的是 n 维的 w,现在要求的是 ℓ 维的 α,ℓ 是样本数。
特征空间是十亿维时,这个换法就是唯一走得通的路径:解的规模由样本数决定,与特征空间多大脱钩。2
矩阵 D 值得多看一眼:它只由 y_i y_j 与两个样本的点积组成,数据在问题里的全部作用就是这些点积。2
约束变成 α 非负、以及 Σ α_i y_i = 0 这一条。
接着是 Kuhn-Tucker 条件。最优点处,每个乘子与它对应的约束满足
这条等式一次说清两件事。乘子非零,则那个点必然正好压在走廊壁上;落在走廊内部的点乘子为零,退出求和。2
「支持向量」这个词到这里有了算术含义:它就是乘子非零的那些点,而权重向量只是它们的线性组合。2
量级也对得上。(5) 式的分子是支持向量数、分母是样本数;支持向量只占少数,这个上界才小得下来。2
论文还给了个不用一次吃下全部数据的解法。把训练数据切块,先用第一块解二次规划,再把解出来的支持向量与下一块里违反约束的点并起来重解,如此推进。2
这个循环里有一个容易漏掉的性质:每加进一批点,目标函数值单调上升,两类之间的间隔单调变窄,直到收敛到全量数据的最优解。2
最后是一个脚注级别的提醒:决策函数唯一,但它在支持向量上的展开不唯一。2
分不开的时候:给越界开个价
数据分不开时,走廊这个概念直接失效。无论画哪张超平面都会切错一些点,间隔可以任意小,目标函数 (15) 的值可以任意大。2
论文先写最直接的想法:给每个点一个非负的越界量 ξ_i,允许它越过走廊壁这么多,目标是把越界总量压到最小。2
σ 取得足够小时,这个和就是在数被错分的点有几个。
但最小化错分个数是 NP 完全问题。为了绕开它,论文取 σ = 1,理由是这是让优化问题有唯一解的最小取值。2
加上价格的版本写成:
F 是单调凸函数且 F(0) = 0,C 是一个常数。第一项管间隔要宽,第二项管越界要少,C 决定两者的换算率。2
论文把 F 落到 u² 这一种具体形式,因为此时问题仍然是二次规划。这一节的公式也只写这一种情形。2
对偶问题随之多出一个标量 δ:
约束是 Σ α_i y_i = 0、δ ≥ 0、以及逐坐标的 0 ≤ α_i ≤ δ。2
上界把 δ 挤到它能取的最小值,也就是这一批乘子里的最大值 α_max。代回去,论文实际求解的是:
与最优超平面的对偶相比,它只多出 α_max²/C 这一项。论文点明了这一项的作用:因为多了它,解对任何数据集都存在,而且唯一。2
目标函数不再是一个二次型——α_max 不是二次项——所以论文把它归到凸规划。实验里的做法是解 (α, δ) 那个多一维的对偶二次规划。2
这里有一处口径要当面说清。教材里常见的写法是 0 ≤ α_i ≤ C,1998 年 Burges 的教程就是这种写法。5
C 到底管什么,论文在第 5.3 节给了回答:它控制决策规则的复杂度与训练错误频率之间的取舍。2
这一节的落点是泛化能力的那个界:
右边第一项是训练错误频率,第二项由 VC 维、样本数与置信水平决定。两项此消彼长:模型容量小,置信项小,训练错误就多。2
最优超平面走的是极端:把第一项压到零,再把第二项压到最小,这就是 Occam 剃刀那一版的结构风险最小化。2
软间隔把这条路打开了:允许第一项不为零,换来对 C 的自由调节,数据分不开时也有解。2
把高维藏进点积里
到这一步,公式都还写在输入空间里。要进特征空间,就把 x 换成 Φ(x),把分界面写成 f(x) = w·Φ(x) + b。2
由前面软间隔的性质,w 可以写成支持向量在特征空间里的线性组合。代回 (31),决策函数只剩点积:
这个式子的意思是:判定一个新样本,只需要它与每个支持向量在特征空间里的点积。2
1992 年那份工作做了一次换序:先比较两个输入向量,再对比较的结果做非线性变换。4
论文把它写成一个等式:
左端要在高维空间里做一次点积,右端只在输入空间里做计算。这就是「点积的卷积」在那篇文章里的字面意思。2
省下来的量级可以算。多项式核
展开后等价于在 C(n+d, d) 维空间里的点积。输入取 256 维、d 取 2,特征空间约 3.3 万维。2
代价停在 256 次乘法加一次乘方,维数并没有真的出现。
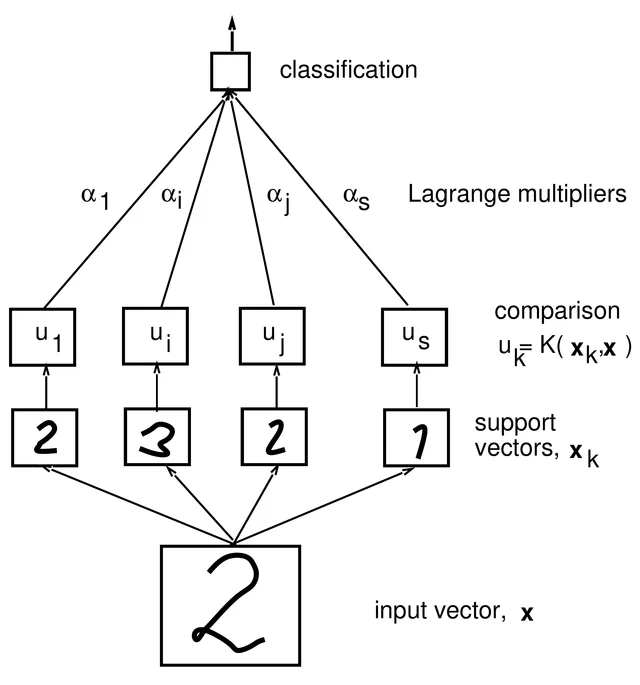
换核就等于换一类分界面。多项式核给 d 次多项式,RBF 核给径向基函数机器,而且连中心点都一起学出来。2
RBF 那一支的前身是 Aizerman 等人的势函数,论文把 K(u, v) = exp(…) 当作它的核。2
核能不能随便选,由 Mercer 定理把关:对称函数只要能展成带非负系数的特征函数级数,就可以当作某个特征空间里的点积。2
于是一个问题变得可回答了:知道问题需要什么样的分界面,就把这份知识写进核。2
三张表和一张图各自在量什么
实验分两类:平面上的人工点集,和手写数字识别。前者用二阶多项式核,图 5 把几组解画了出来。2
数字部分用了两个库。USPS:7300 个训练图、2000 个测试图,分辨率 16×16。2
NIST:60000 个训练图、10000 个测试图,分辨率 28×28,输入 784 维。2
USPS 上做了预处理:居中、去倾斜、平滑,平滑核取标准差 0.75 的高斯。这个数是为了对齐 1992 年那篇的做法。2
NIST 上不做预处理,只造了四阶多项式这一种分类器,理由是基准研究只给了两周。2
十个类别造十个分类器,最终判定取十路输出里最大的那个。2
表 1 是 USPS 上的历史数字汇总,用来给后面的结果找参照:人类 2.5%、CART 17%、C4.5 16%、最好的两层神经网络 6.6%、五层专用结构 LeNet1 5.1%。2
这张表的作用是给出参照系。表头的指标是 raw error,即不设拒识、每个输入都必须给一个答案时的错误率。6
表 2 是阶数扫描,四列分别是阶数、测试错误率、每个分类器的支持向量数、特征空间维数。2
| 多项式阶数 | 测试错误率 | 支持向量数(每类均值) | 特征空间维数 |
|---|---|---|---|
| 1 | 12.0% | 200 | 256 |
| 2 | 4.7% | 127 | ≈ 3.3×10⁴ |
| 3 | 4.4% | 148 | ≈ 1×10⁶ |
| 4 | 4.3% | 165 | ≈ 1×10⁹ |
| 5 | 4.3% | 175 | ≈ 1×10¹² |
| 6 | 4.2% | 185 | ≈ 1×10¹⁴ |
| 7 | 4.3% | 190 | ≈ 1×10¹⁶ |
横着读这张表:维数从 256 涨到 10¹⁶,跨了十几个数量级;错误率从一阶的 12.0% 掉到二阶的 4.7%,之后在 4.2% 与 4.7% 之间几乎不动。2
论文自己的说法是:性能几乎不随空间维数变化,说明没有过拟合。2
支持向量那一列更值得看。七阶的支持向量只比三阶多约 30%,甚至比一阶还少。2
一阶那行的 200 需要拆开。它把支持向量与松弛量大于零的训练点混在一起数,而线性情形下每类平均有 34 个训练点被错分。2
二阶那行的训练错误是另一回事:二阶分类器在训练集上总共只错 4 个点,论文把四张图印成了图 7。2
表 3 是 NIST 上十个分类器的分账,每一类都有自己的支持向量数、训练错误数与测试错误数。2
这里有个最容易踩的坑。十个二分类器的测试错误加起来是 374,而正文给的合并成绩是 1.1%,也就是 10000 个测试点里错了 110 个。2
两个数都对,量的是两件事。374 数的是十场「一对一」判定的错判次数,1.1% 数的是取最大输出之后的最终判定。
论文还顺手留了两个数:训练错误频率平均 0.02%,每类约 12 个;四阶多项式有超过 10⁸ 个自由参数,照样在训练集上出错。2
图 9 是同一个基准上的五根柱:线性分类器 8.4%、k=3 近邻 2.4%、LeNet1 1.7%、LeNet4 1.1%、SVN 1.1%。2
8.4 那根柱子上有个断轴符号,柱高不按比例。这张图要看的是后四根。2
还有一个跨表的坑:表 1 的 LeNet1 是 5.1%(USPS),图 9 的 LeNet1 是 1.7%(NIST)。同一台机器,两个数据集。2
两种赌注在同一张榜上打平
1.1 对 1.1 这个平局值得停一下,因为两边押的东西相反。
这句话是称赞,也是一个提醒。卷积网络把平移、局部性这些先验写进结构,支持向量网络把先验放进核里;NIST 那一次用的四阶多项式核里没有任何图像知识,预处理也没做。2
平局成立的条件写在实验设置里:同一个 NIST 库、同一份 60000/10000 划分、支持向量网络这边不做预处理。2
三年后,卷积网络那一侧在同一份 NIST 测试集上做了一次复算。常规支持向量机的错误率是 1.4%,Schölkopf 的虚拟支持向量版本是 1.0%。6
那一次的 1.1% 也被记了下来,代价写在旁边:每次识别约 1400 万次乘加。简化支持向量的版本同样到 1.1%,计算量降到 65 万次,只比 LeNet-5 贵约 60%。6
同一张图里的卷积网络成绩是:Boosted LeNet-4 0.7%,LeNet-5 0.8%。6
于是这场比较多了第三个维度:准不准之外,还有一次识别要花多少次乘加。
本频道讲 LeNet-5 的那一期把另一半讲完了:局部连接与权重共享把二维结构变成先验,先验让同样的数据更省。6
把两期并排看,这张榜量的是 1994 年的 NIST:六万个训练样本、十类手写数字、没有大数据可用。这三个条件划出了那次平局成立的边界。
二十年后的另一方给出了他们的判断。LeCun、Bengio 与 Hinton 在 2015 年的综述里写,核方法那类通用非线性特征,在离训练样本远的地方泛化不好,所以好特征应该被学出来。8
论文自己没做的与写下的局限
第一条是时间账。论文说造多项式分类器的训练时间不随阶数变、只随支持向量数变,最坏情况也比 LeNet1 快,全文却没有给一个计时数字。2
第二条是可重复性。每个设置只报一次结果,没有重复实验,也没有误差区间;USPS 的测试集只有 2000 个点。2
第三条是选型。核的形式、阶数与 C 的大小都没有系统的选择方法;NIST 上把四阶多项式作为唯一选择,理由是「基于在 USPS 上的经验」。2
第四条是多类。十个一对多分类器加最大输出就够了,论文对别的合并方式一字未提。2
第五条是那个界。(5) 式左边写的是错误率的期望,论文用实测的支持向量数去代替期望值,并写明在所有实验里这个界都成立。2
第六条是理论能承诺的幅度。界给的是一个上限,它说明间隔最大为什么是一个讲得通的容量控制手段,至于这张超平面是否一定比别的更准,界本身不回答。2
论文末尾留了一条改进方向:如果把关于问题的先验写进 K,性能还能提高。2
这句话后来在另一条路上兑现了:先验直接写进网络结构。
后来被换掉的与留下的
把这篇拆成几个可以替换的位置,后面的工作就能一句话定位。
第一格是核。1992 年那篇给了换序,这一篇给了数据分不开也能用的版本,核从此是一个可替换的零件。4
第二格是容量控制的理论。Vapnik 在 1995 年的书里把 VC 维、结构风险最小化与这类学习机器写成一套体系。9
第三格是写法。1998 年 Burges 的教程把它整理成教材形式,箱约束 0 ≤ α_i ≤ C 也是这样固定下来的。5
第四格是求解器。LIBSVM 是这套方法用得最广的开源实现,支持 C-SVC、nu-SVC、回归与一类分类,也支持多类;它给这套机器带来的名字是 C-SVC。10
第五格是它与深度网络的关系。2018 年的神经正切核把这件事接上:无限宽的神经网络在梯度下降下,等价于对某个显式核做核方法。11
核的想法就这样延续下来,身份换了:从造分类器的工具,变成分析网络训练的工具。11
留下的读法有两条。一条是复杂度跟谁走:这篇论文的答案跟着支持向量的个数走,与维数无关。2
另一条是约束乘子只在边界上非零。任何带不等式约束的问题,最优解里总有一批约束是松的,决定答案的只有紧的那几条。2
读完留下的判断维度
一,先问复杂度跟什么走。维数、参数个数、支持向量个数、数据规模,这四个量在不同论文里被当作复杂度的代理;换一个代理,结论就换一套。2
二,再看分界面由几个点决定。答案能写成少数样本的线性组合,就意味着动一个远端样本不动结果;做不到这一点的模型,动一个样本可能全盘变。2
三,看到「打平」先找条件。1.1 对 1.1 的背后是同一个库、同一份划分、一边没做预处理。2
五,界与实测分开记。(5) 式给的是期望的上界,论文拿来对照的却是实测的支持向量数。2
想自己验一遍支持向量的作用,最短的一段是从 (42) 走到 (48):取两类手写数字,解一次那个二次规划,数一数非零的乘子有几个,再看把它们删掉之后分界面会不会动。2
References
- 1
- 2原论文首页的作者署名、单位与页脚联系方式
web.engr.oregonstate.edu
- 3Crossref REST API:DOI 10.1007/BF00994018 的引用计数,2026-10-20 查询
api.crossref.org
- 4
- 5
- 6
- 7
- 8
- 9Vapnik:《The Nature of Statistical Learning Theory》,Springer,1995
link.springer.com
- 10
- 11
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.