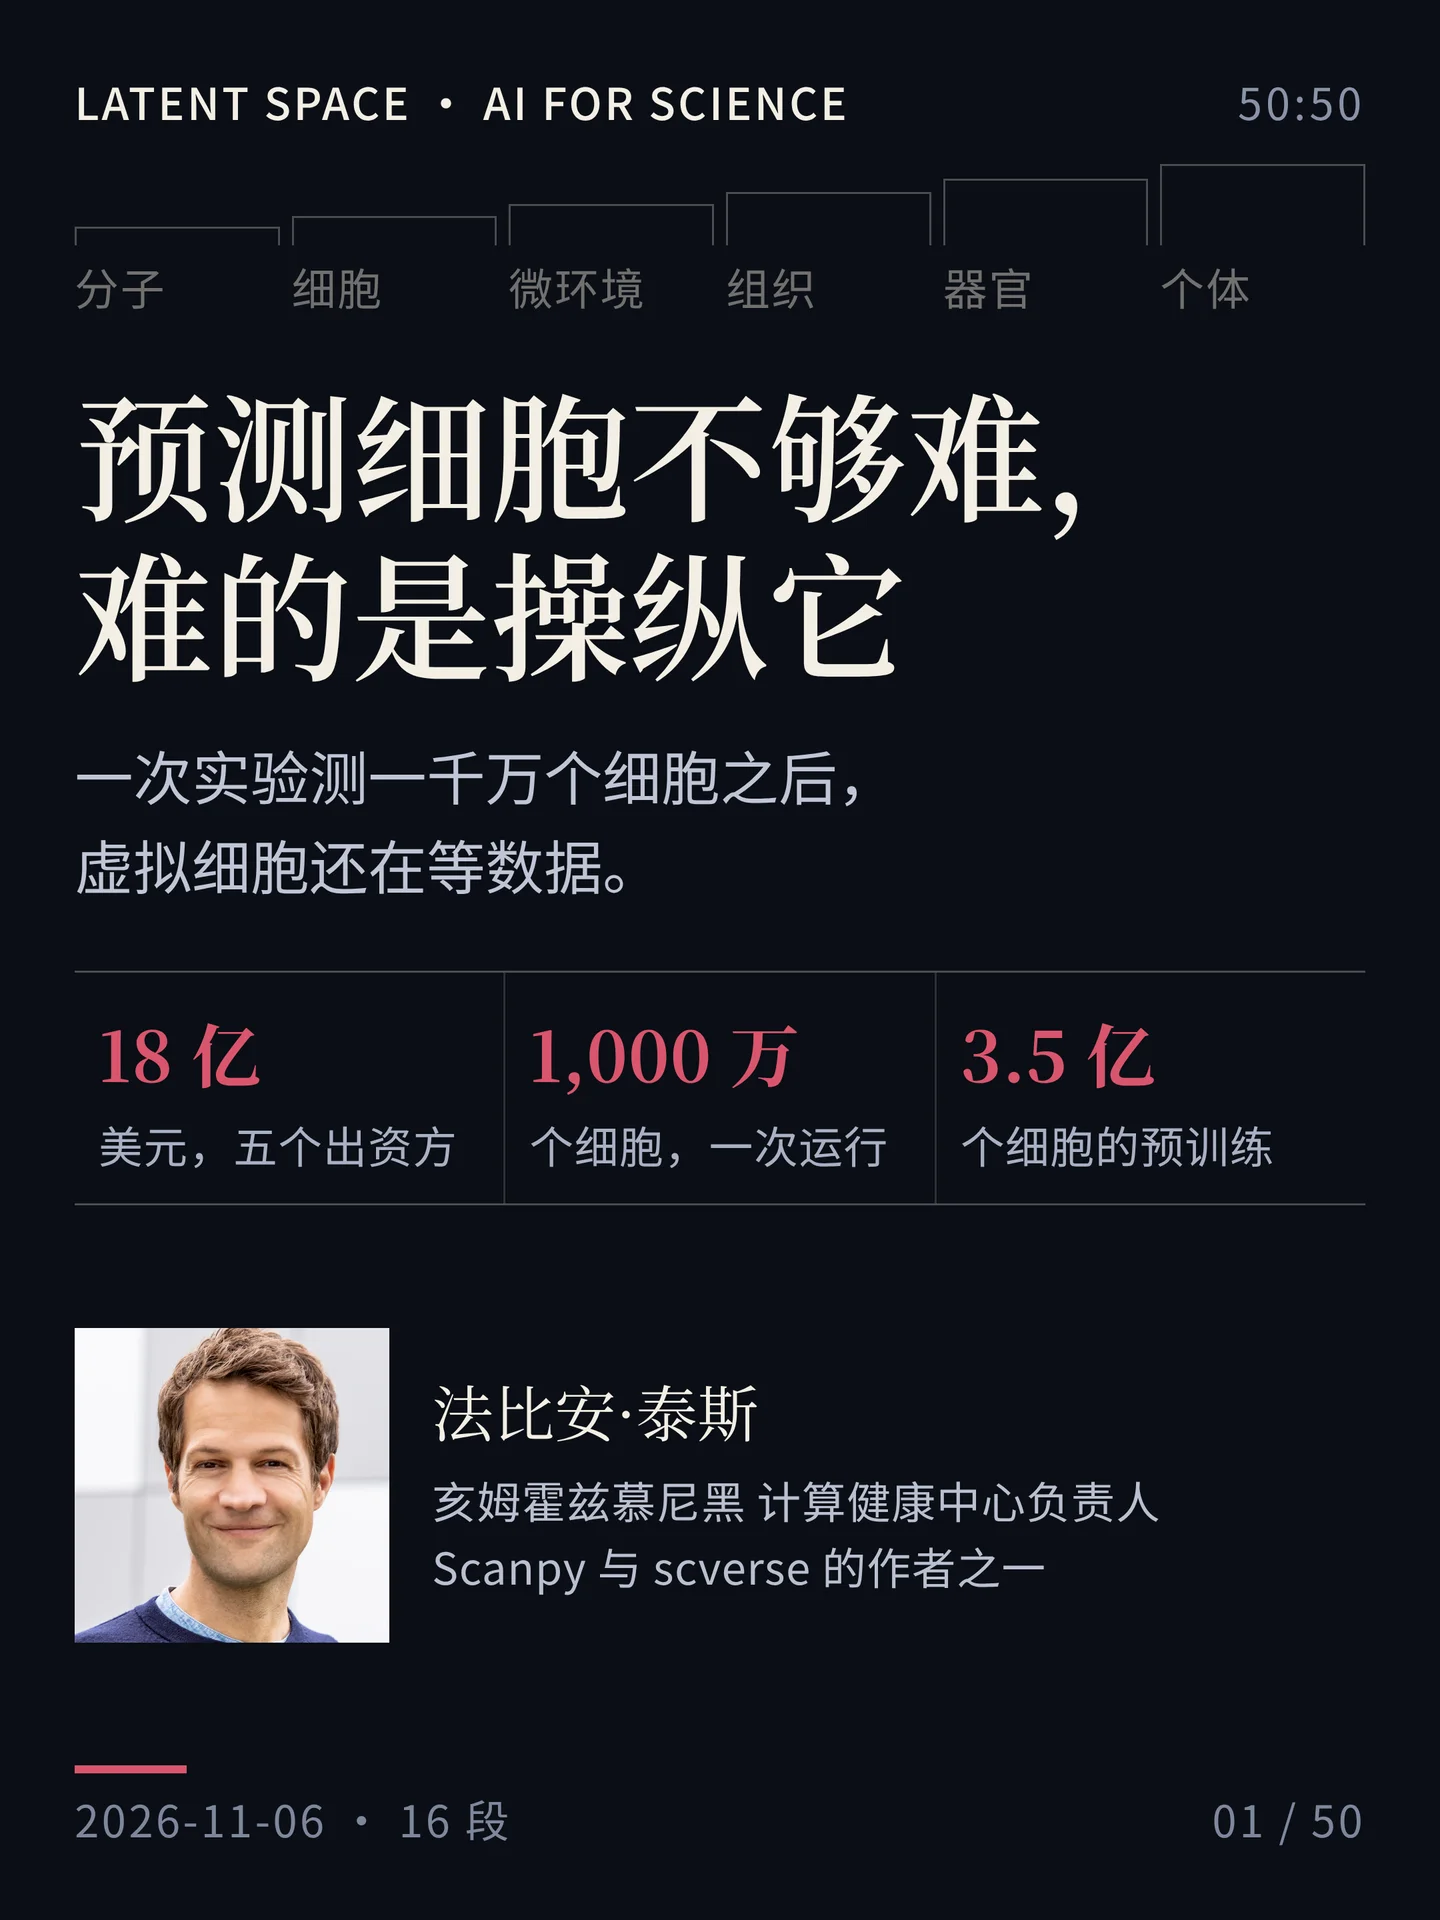

法比安·泰斯管着欧洲最大的健康 AI 研究中心。他说虚拟细胞挨批,不是模型弱,是问题太简单——真正难的是反过来设计实验。
Latent Space 的「AI for Science」分档请来法比安·泰斯(Fabian Theis)。他是亥姆霍兹慕尼黑计算健康中心的负责人、计算生物学研究所所长、慕尼黑工业大学「生物系统数学模型」讲席教授,也是 Helmholtz.AI 的科学主任;几乎所有做单细胞的人都用过的 Scanpy 与 AnnData 出自他的实验室。主持是 RJ Honicky(Mira Omics 首席技术官)和布兰登·安德森(Atomic AI,做 RNA 治疗)。1
要点
一、他把这十年的进展分成三步:画图、预测、操纵
开场那段就是他的结论。这个领域先把人类细胞画成图谱,接着开始做「世界模型」式的预测,而现在可以拿模型去指导下一次实验。他说得很直:从画图走到预测,现在可以真正去操纵实验了。他也承认现实没那么漂亮——大部分论文停在一个模型加一张概念图上,做一点验证,然后开始下一个项目;学到的东西留在人的脑子里,没有变成系统里能积累的东西。
二、这个领域的工具链,一半出自他的实验室
RJ 在开场说,泰斯实验室出论文的速度比他读的速度还快,而且这些工作常常不是在造概念,是在造别人每天要用的工具。他自己把起点说得更朴素:最早从单细胞、从 qPCR 做起,一部分原因不是生物学,而是样本数量——早期只有这个领域能给他成千上万个数据点,机器学习出身的他是被数据量吸引进来的。
三、18 亿美元买的不是模型,是「可测」
RJ 问的是行业问题:结构生物学热得发烫,Anthropic、OpenAI 的生物计划都在做分子设计,虚拟细胞和系统生物学这两年反而被冷落;Biohub 偏偏在这个时候联合美国能源部、NIH、Google DeepMind、Isomorphic 与 Meta 宣布 18 亿美元,要生成并开放多尺度的生物数据。2
钱的构成值得拆开:能源部是五年逾 5 亿美元的新投入,走 Genesis Mission,把国家实验室的算力、X 射线与中子散射、冷冻电镜和自动化实验室接进来;NIH 是把逾 5 亿美元的既有联邦投资统筹起来做标准化;Google DeepMind、Isomorphic Labs 与 Meta 三家合计约 3 亿美元。Biohub 自己此前已有 5 亿美元承诺,其中 4 亿做测量技术,1 亿给外部研究。
他的判断是:这一轮的意义在数据生成,不在算法。药厂在筛细胞时急需「细胞类型上下文」,今天的规模做不到;谁把测量做厚,谁就把门推开。
四、扰动空间第一次不再是稀的
他讲了一段个人史:早年一个实验只有几千个转录组,慢慢到几万、几十万。真正的「下一个量级」出现在 Parse 的 GigaLab——单次运行测一千万个细胞或细胞核。3
过去的问题是取样不对称:细胞侧有几百万个点,扰动侧只有「对照」和「疾病」两格。现在换成几百个细胞系做全敲除、上千种药物一起加,扰动空间才真的变厚。他顺带说,下一步可能会把人类遗传学本身当成扰动。1
五、他在这里停下来补了一段常识
主持请他把话说回起点。人类基因组在每个细胞里几乎一样,那为什么有那么多细胞类型?因为不同细胞从基因组上读出的东西不同:约有 2 万种信使 RNA 被选择性表达,每个细胞得到一个两万维、大部分是零的计数向量。这团点在空间里聚成堆,我们叫它细胞类型;拉成条,我们叫它轨迹。
布兰登贡献了全场最好的比喻:DNA 是食谱,每个细胞是一道菜,转录组做的是反推这道菜用了哪些配料。泰斯笑说自己有几个特别爱吃的孩子,这个比喻他要拿去多用几次。
六、类器官:读数终于值得看了,但没人知道怎么建模
他第一次看到人们把细胞取出来、长成会互相连接的小块组织时非常震动:培养皿里的小脑真的会开始对话,已有工作让它完成计算;心肌类器官会自己跳;结肠和一堆肿瘤系统也能这么养。对难以取到组织的疾病,用皮肤细胞诱导出的类器官几乎是唯一的路。限制也很实在:缺免疫系统、缺喂养手段。
而建模这一层是研究前沿:没有共识,数据也不够——带空间结构的读数和解离后的单细胞,是两种完全不同的东西。
七、细胞类型是人发明的词,邻居不是
这是全场最锋利的一段。他说细胞类型是我们为了理解复杂度贴上去的标签,大自然并不在乎;可一到「微环境」这一层,连对应的词汇都没有,病理学家做的事很多还是定性的。今天的技术做法是把一个位置表示成一堆细胞的分布,他承认这是当下的解法,但觉得可以更细,比如图结构。
顺着这个话题,布兰登把「苦涩教训」搬了出来:一边是去掉归纳偏置、让更大的数据说话;一边是数据稀疏时先验正是统计功效的来源。泰斯的回答很直接:文献反复证明,先验塞得太狠会损失预测力。AlphaFold 是最好的例子——早期版本费了很大力气把旋转等变性写进模型,后来数据一多,模型自己找到了这个对称性,而且更灵活。
他也不打算把「解释」和「预测」混为一谈:医生可能想要一个讲得通的模型,病人只想要最准的那个,这两件事最好分开谈。
八、真正难的任务:猜你邻居在干嘛
虚拟细胞基础模型为什么让人失望?他的回答分两层。
第一层是题目:如果任务只是「在一个细胞系里预测某个 CRISPR 的效果」,那不需要最花哨的模型;如果只是判断细胞类型,逻辑回归就够——他们五六年前写过一篇标题很直白的论文,叫《细胞类型预测不需要深度学习》,前提是在同一个器官内;跨器官才会变难,那时非线性才开始值钱,他后来的 scTab 证明了这一点。
第二层是任务:Nicheformer 提出一个新问题——给你一个细胞的表达状态,猜它邻居的表达。因为细胞一直在互相说话,痕迹会留在彼此身上。这类题才需要更强的非线性,也需要更细的数据。
他顺带说了同行评议的变化:审稿人现在会盯着缩放律,把参数量和细胞数一起加上去,指标到底会不会跟着涨。早期的基础模型论文缺的就是这条曲线。
九、先学状态,再学动作
他的团队把两件事拆开:表征学习负责「细胞在哪」,世界模型负责「施加这个动作之后它会去哪」。他把虚拟细胞定义成一个带动作的函数——不是 F(状态),而是 F(状态, 动作)。
- scConcept:用对比学习做预训练。论文里对照的 Geneformer 只到三千万细胞,而 Hugging Face 上的版本用了 3.5 亿个细胞、最多 1 亿参数,横跨 16 个物种;他说缩放律开始出现了。4
- CellFlow:在学好的潜空间上,用流匹配把细胞沿着动作推前。他说这篇刚被《自然·方法》接收,但它高度依赖潜空间好不好,两个部件必须配对。
跨物种是他顺手提到的一层:3.5 亿个细胞来自 16 个物种,他说这不是团队的核心专长,但至少可以开始问演化的问题。
十、基线、指标与挑战赛:一杯冷水
这是整期的方法论核心,也是他对「虚拟细胞被唱衰」的正面回应。
他说做基线听起来是废话,但一个冲向金罐子的领域常常顾不上它。最难的基线不是线性模型,是「比均值好」——数据噪声大的时候这条线很硬。他把原话转给学生:我知道你想上最花哨的深度学习,但请先把基线做出来。他还讲了一段历史:早期 Perturb-seq 很多分析就是用经典线性模型做伪 bulk;他们的 SCGen 在潜空间里引入线性平移,也总是拿更简单的线性平移做对照。
然后他复盘了 2025 年的 Arc 虚拟细胞挑战赛。那场比赛固定了一套指标,其中一部分并不贴单细胞,可以被钻空子;赛后一批论文指出,简单的线性基线也能赢,甚至常数预测也不差,领域因此冷了一阵。他说这不是坏事,但要分清两件事:有人在钻指标的空子,和题目本身太简单。他们在 Open Problems 联盟里的做法是——除了主办方的指标,参赛者还要提交自己认为该量的东西;而另一条线来自同行论文:很多指标校准得很差,绝大多数基因几乎不变,于是「预测均值」在旧指标下反而拿高分,指标修好之后深度学习就赢得回来。5
他的结论不激烈:把钻空子的解法剔掉,真正拿第一名的还是带非线性的流匹配模型;简单任务基线够用,复杂任务必须非线性。至于「以后会不会有 agent 自动去试各种算法组合」,他说已经在和几个 AutoML 团队合作——那我们剩下的大想法,可能真的只剩怎么定义指标了。
十一、五百人的一个中心,怎么组织
话题从模型转向组织。他一手建起来的计算健康中心,现在有 45 个研究组与教授、500 到 600 人,横跨 DNA 基础模型、蛋白设计、病人队列、影像与遗传,他说这大概是欧洲最大的健康 AI 学术机构。
与大学不同,这里没有本科教学,只有博士生和博士后;但他们与慕尼黑工业大学、慕尼黑大学以及几家医院绑得很紧,因为要的是能进诊所的转化。他也清楚这套体制的另一半:亥姆霍兹拿的是联邦的钱,去做一个很深的问题,代价是灵活性不如美国的风险投资体系。
十二、德国强在从 0 到 1,输在放大
RJ 问德国的初创生态。他给了一个漂亮的区分:欧盟新公司的数量和美国差不多,欧洲掉队的地方是放大——早期钱在,愿意承担大额风险的基金不在本地,所以想拿 A 轮、B 轮的人开始往美国跑。
他顺手点了欧盟的两面:一边是手机漫游和 USB-C 这样的好事,一边是 AI 法案与跨医院取数的麻烦。他点名芬兰的 Fingene 与丹麦的国家队列,说那才是欧洲该学的东西,也提到欧洲健康数据空间要求两年内实现跨境。慕尼黑在他嘴里是另一幅景象:生物与国防的深科技都在爆,是全欧洲风投最集中的地方之一——他在旧金山吃饭,服务员会问一句「你们是在聊 AI 和生物吗」。
十三、虚拟细胞的生意:平台最后都变成做药
他的观察很直接:说「我们做生物基础模型」「我们解码生物学」很好卖,但钱从哪来说不清。他见过太多平台公司在某一刻改口——「我们要做一款药」,因为投资人听得懂的是药,不是平台。他也点了一句当下的焦虑:某天前沿模型自己就能做掉其中一部分。
出路是数据。护城河不是模型,是模型加上别处拿不到的数据;他举的例子是自己参与的癌症类器官扰动图谱——拉多家药厂做联盟,产出扰动数据集,参与方换的是优先使用权。他说这是数据生意的原型,药厂愿意为早期访问付钱。
十四、Y 模型:两个导师,一个 Y
他在慕尼黑数据科学学院推行的一套培养方式:每个学生必须有两个导师,一位管方法,一位管领域;他说 Y 加 Y 等于 H。
具体到日常,学生一周要进两个组会:一个学懂真实的生物问题、听懂临床的语言;另一个把问题变成指标和模型。他形容这套机制的价值:计算的学生会在生物实验室里「吸走」一堆还没被精确表述的问题,然后因为他们是定量的,能把这些问题写成指标、写成模型、写成论文。
八年下来回报是双向的:学生成了那个器官在组里的专家,他也通过学生第一次搞懂了肺和脑。去向很分散——药企、学界、创业、纯 AI;英伟达一个月之内从他这儿挖走了两个人。
十五、闭环:最难的不是模型,是说服人押上时间
主持人问 agentic AI 会不会让湿实验的人自己变成计算的人。他先绕开了「文化」这个难题,讲了更实在的一层:闭环难建,而且不是难在模型——你得说服做实验的人,把几个月的生命押在一个预测上。
分子设计的闭环相对容易,因为赌注小;细胞层面就难,因为一轮实验周期长、成本高,还需要有人真的去养那个奇怪的细胞系。他说目前还没有多少「多轮闭环」的公开例子。
他们的做法是 LabCompass:给定想要的状态,反推出实验条件;与剑桥的血液学实验室合作,跑了三四个闭环,一轮一轮改模型。6 至于机器人,他觉得太早:测定周期还太长,闭环里的机器人现在只会空转。眼下是主动学习,终极愿景是强化学习。
十六、收尾:往别的小学科看一眼
他说这类跨学科的对话对他帮助很大,因为人容易困在自己那个小学科里。这大概是这一期最值得带走的一句:不是「虚拟细胞会赢」,而是「问题该换一个更大的了」。
逐句全文翻译
下面按原始顺序逐句翻译整集对话,只保留中文,保留说话人标签,不压缩、不摘要、不删减。
第 01 段 · 冷开场:从画图到操纵
法比安:我们现在真的可以开始指导实验了。以前我们建这些人类细胞图谱,做的是「画地图」这一面;后来我们谈世界模型、谈预测问题。
法比安:从画图,我们走到了预测。但现在我们可以真正去操纵下一次实验了。不过说实话,论文常常是以某个模型收尾的,对吧?
法比安:也许配一张概念图,再加一点验证。然后通常你就开始下一个项目了。当然你学到了一些东西,但那不像是持续学习那类东西。
法比安:我们做出来一个新东西,叫 LabCompass,它是一个反演生成模型:一旦你有了一个正向的世界模型之类的东西,它能告诉你,为了到达某个状态,你需要做什么。
法比安:显然,最终的愿景是我们想把一切都做成强化学习。我们也想把这个回路也做成强化学习。这听上去有点远,但你知道,我觉得我们正在慢慢靠近。
第 02 段 · 开场:Scanpy 与旧地图
RJ:欢迎来到 Latent Space 的 AI for Science 播客。我是 RJ Honicky,Mira Omics 的首席技术官。和我一起的是我的搭档主持布兰登·安德森,他在 Atomic AI 做 RNA 治疗。
RJ:我怎么强调法比安·泰斯和他的实验室、他的公司对系统生物学、对虚拟细胞这个概念的各种版本做了多大贡献都不为过。
RJ:他实验室出来的论文和模型比我读的速度还快,而这个实验室一直在把我们对「怎么观察细胞、怎么给细胞的行为与相互作用建模」的理解往前推。
RJ:同样重要的是,他的工作常常专注于造出研究人员和科学家每天真的会用的工具。
RJ:大多数计算生物学家大概都在某个时候用过 Scanpy 和 AnnData,而这些工作催生了 scverse,一个非常棒的开源工具集合,吸引了很多很多贡献者。
RJ:当然,法比安是那种荣誉多到你根本列不完的学者,但只说一点就够了:他在亥姆霍兹慕尼黑和相关机构里领导着一大堆 AI 与计算生物学的项目,也参与了很多产业界的努力。
RJ:法比安,很高兴见到你。非常感谢你来参加我们的节目。
法比安:谢谢你们邀请我。我非常期待这次讨论,真的。
RJ:我跟踪你的工作很久了,所以终于请到你上节目、和你聊一聊,是很大的荣幸。我们从当下正在发生的热度开始吧。
RJ:现在结构生物学受到了极大的关注。Anthropic 和 OpenAI 的生物制药计划现在都重点放在设计分子上。
RJ:另一方面,虚拟细胞和系统生物学这两条路线最近确实没有得到那么多关注。也许 Zera 和 Noetic 是很好的反例。
RJ:但 Biohub 刚刚宣布了一个 18 亿美元的合作,和美国能源部、NIH、Meta 以及 Google 一起,去收集并开源多尺度的生物数据,用来开发下一代的虚拟细胞。
RJ:所以我的问题是:基于我们在学术界看到的这些活动,你觉得制药行业是不是即将对虚拟细胞重新燃起兴趣?
法比安:在回答之前我应该先声明一下:我的看法明显是很学术的。每当我跟我那些每天坐在创业公司里的朋友和同事聊,他们对创业公司的了解,就像我对各个研究实验室的概览和一点直觉一样。
法比安:你知道,这就是当下那个火热的大事,这些投资正在发生。我并不真的在那个尺度上掌握情况。
法比安:但话虽如此,比如说你提到的 Biohub 这个计划——顺便说,它也和人类细胞图谱高度耦合,那是真正全球性的联盟,在推动下一层级的数据集生成。
法比安:我确实认为有一大堆理由说明我们会看到这种规模化的扩展:这些模型在生成性上表现良好,而在分子层面的「实验室在回路里」的做法,现在正被输出到上一层,真的开始在细胞层面工作。
法比安:我认为这背后有一堆理由。第一个,也许是最重要的一个,就是你正好点到的:数据生成。
第 03 段 · 18 亿美元:为什么是现在
法比安:虚拟细胞这个概念我们已经有一阵子了。比如我的实验室,我们在 2019 年就开始做扰动预测建模、开始用机器学习,那篇论文当时叫 SCGen。它是一个非线性模型,但本质上是在潜空间里做某种线性变换,效果其实相当可以。
法比安:即使在今天,很多这类「伪线性」的东西仍然做得不错。
法比安:原因是,我认为那些数据集,以及我们建立在它们之上的问题,本身还比较简单。这也是它为什么没有真正起飞。
法比安:所以每当人们谈虚拟细胞——也许你的问题也是这个意思——我觉得你实际问的是:你能不能预测一个细胞在各种扰动下会怎么表现?
法比安:这是一个相当深的问题。如果你真的去想,这也许是计算生物学或系统生物学里的圣杯之一:这个输入输出的系统,也就是一个细胞,它带着记忆,带着它所有的规格,带着不同层级的分子,而不只是 RNA。
法比安:能把这件事描绘出来……而且,「理解」到底意味着什么?这有点像一个元问题。但我认为,当你能够在给定不同输入的情况下预测它的输出行为时,你就算理解、或者至少很好地建模了一个系统。
法比安:所以我认为这是个很好的问题,这也是为什么现在人们常把虚拟细胞等同于扰动预测。我觉得这有点过于简化了,但我认为这类扰动预测模型——也就是你说的虚拟细胞——正在大量起飞。
法比安:创业公司的版图我觉得正在爆炸。我们谈到欧洲很多,但在中国的生态里,也有很多这类额外的努力正在发生。
法比安:我希望这不只是因为大家都往自己的东西里加 AI 而点起来的一把小火,而是因为制药真的迫切需要在自己的筛选里做到「细胞类型上下文相关」,而这件事他们目前在那种规模上还做不到。
RJ:也许你可以展开讲讲这意味着什么——扰动,比如我们最近聊过的 Zera,他们在做扰动筛选。这会解锁什么?然后你认为下一代数据还会额外解锁什么?
法比安:对我来说——如果我讲这些老故事讲得太多了你就打断我——我很久以来一直是受训练的机器学习科学家,做过各种东西,但我很早就从单细胞、从 qPCR 开始。
法比安:如果我说实话,最初并不完全是因为我对生物学感兴趣,而是因为只有那里有高样本量,对吧?因为很早就很清楚:规模化 qPCR 的数量,后来当然是转录组,会变得非常大。我刚开始职业生涯的时候,我们只有几个 RNA,现在我们手上有几千个之类的。那是很早的时候。
法比安:但现在我们进入了一个新的区间,那是一个让人眼界大开的时刻:Parse Bio 有了那个——我想他们叫它 gigalab 之类的东西。
法比安:你知道,现在竞争公司也有类似的。但当他们在一次实验里测了一千万个转录组,我当时觉得那是下一个层级的东西。
法比安:从只是拿更多 PBMC 当对照,到真的对它做点规模化的事;也就是说,这边是细胞空间,那边是扰动空间,而后者过去非常稀缺。
法比安:过去那就是「对照」对「疾病」之类。所以你在扰动空间上的取样点,通常比你在细胞层面的观测数少得多。
法比安:但这现在正在爆炸。现在你有,我不知道,上百个不同的细胞系,你做全扰动,比如全 CRISPR 敲除;或者你有上千种药物的组合加上去,于是这个空间突然变得非常丰富。然后你就可以开始做这些花哨的扰动预测之类的事。这正在发生。
RJ:这个规模发生得简直疯狂。
法比安:我们自己参与的一大堆事情,其实已经超出了细胞系,去做类器官的扰动;如果有时间,我们可以多聊聊那个。因为我相当确信,我们需要走到多细胞系统,才能有真正有意思的读数。
法比安:但我认为每个人都在把这些层级放大,某个时候我们甚至可能会走到把人类遗传学当作扰动。
第 04 段 · 扰动空间在变厚
RJ:你能不能解释一下什么叫扰动?你的意思是什么,给不熟悉的人讲讲。
RJ:其实你介意再往回退一步吗?我们说的「测量转录组」到底是什么意思?你刚提到了基于 PCR 的东西,还有扰动你可以……
法比安:做公开演讲时,我通常会说:人类基因组计划,我们拿到了这个身体的基因组,但它在每个地方几乎都一样,对吧?
法比安:那么,为什么我们有这么多不同的细胞类型?具体发生了什么?
法比安:第一层,我们通常有的第一层是:每个细胞从基因组上读出的东西不一样。这些信使 RNA 之后编码各种下游的蛋白,它们在不同的细胞里被「差异表达」,就像人们说的。
法比安:在人身上,大概就是两万种这类东西的剪接,实际数量多得多。但这是大致量级。
法比安:所以你实际上拥有的是:每个细胞一个两万维的向量,东西不在的时候有很多零,但也有大量数字,也就是这些信使 RNA 的计数。
法比安:因为这些被称为转录本,所以这就叫转录组。对。
法比安:实际上你就有这个两万维的空间,我们常常把它编码到一个更好看的潜空间里,它有一个子流形,一个子空间,真正的细胞云就住在那里。
法比安:如果这团细胞云——每个点就是一个细胞,一个两万维的向量——如果它们聚成堆,我们就把这些东西叫细胞类型。
法比安:如果它们拉成香肠那样,我们就把它们叫轨迹,比如细胞分化:受精卵制造出身体里所有细胞类型之类。
布兰登:所以 DNA 就像一个食谱,或者说一堆基因、一堆食材;然后每个细胞是它自己的一道菜,不同食材的组合。而转录组学就是拿不同的菜去拆解:这道菜里放了什么食材。这个类比是不是很蠢?
法比安:(笑)我有几个特别爱吃的孩子,这个比喻我以后会多用几次。我喜欢它。谢谢你,布兰登。我很喜欢。
RJ:然后扰动就是,你以某种方式扰动了基因组或转录组,让它里面有了不同的转录本。
RJ:通常这是用 CRISPR 敲除做的:你从基因组里移掉一个基因,这显然会让它不表达那个基因。然后你去看因为扰动而产生的表型变化,或者说是物理生物学上的实际变化。这大致对吗?
法比安:对。也许我可以在这里往回退一步,因为我认为 RJ 你完全说对了,但这是比较硬核的那一类扰动。完全敲掉一个基因这种事在演化里也会发生一点,但大多数情况要微妙一些。当然,为了理解这个系统,把零件一个个拿掉是个好主意。
法比安:在正常发育、或者我们处于稳态的时候,发生的事情当然是这些细胞一直在互相说话。它们生活在复杂的多细胞状态里,细胞之间一直在发生各种通讯。
法比安:所以总有东西从外面来,然后对它们做点什么。
法比安:所以对我来说,扰动空间其实就是「发生在细胞上的事情」这个输入空间:可能只是因为它挨着另一个细胞、有信号在发生,或者有梯度、有激素进来,等等。
法比安:这些东西你当然没法随便调高调低。甚至像体外系统里做药物筛选——当你把它们放进培养皿,你可以换不同的培养基条件,而它们的影响非常大。
法比安:对我来说这还有一点像生物驱动的、甚至像炼金术:人们想出来的各种鸡尾酒,把皮肤细胞变成接近胚胎状态的东西,然后你可以造出新细胞去修复身体里的各种问题——比如所谓的山中因子,那是诺奖级别的东西。
法比安:所以拥有一个扰动的空间,也就是「你能对细胞做的事情」的集合,可以是非常丰富的一件事。它可以一直走到基因上的改变,也就是完全敲除,或者更微妙的东西,比如人类遗传学。
法比安:我认为所有这些都要放进一个「我们能对细胞做什么」的大空间里,它会影响细胞状态,而虚拟细胞模型应该把这一切都吃进去,当然也包括它们的组合。也许还有疾病、时间等等,都会影响它。
第 05 段 · 转录组是什么
RJ:这是和类器官这个想法的绝佳连接。你能不能谈谈,类器官是什么?它和扰动空间这个概念怎么连接?除了调整它的背景之外,你对它做什么?
法比安:兄弟,我第一次听说、第一次了解到这个概念的时候——应该说我不是科班生物学家,通常是读一点东西或者跟同事朋友聊才知道。
法比安:当我第一次看到人们能够把细胞从身体里拿出来、从癌细胞里拿出来,然后让它们长成小的多细胞系统,而且它们真的开始连接、开始做事,我印象极其深刻。
法比安:比如现在人们可以取一些细胞放进培养皿,长出小小的迷你大脑,就是一群神经元,真的开始互相连接、互相对话。
法比安:有人已经证明,他们能让盘子里的迷你大脑做计算。同样,人们可以取心肌细胞,长成小小的心脏类器官——我们和几个很棒的伙伴有本地合作——它们真的开始跳动。就像盘子里有一小团会跳的心肌细胞。
法比安:然后当然,一旦你有了这些——就像我说的脑,还有更简单的系统比如结肠,在那里这套做得非常好,还有一堆癌症系统。
法比安:而且,比如说你想研究那些材料很难获得的疾病。假设你想研究某类神经退行性疾病的遗传学,通常很难拿到组织。
法比安:所以你从皮肤取细胞,诱导分化,把它们变成这些小小的脑子,然后你就能在那里研究一些东西。
法比安:所以我认为这种「复制一小块器官」的概念——这也是它们被称为类器官的原因——放在培养皿里,非常迷人。当然有各种限制:常常缺免疫细胞、缺免疫系统,也许还有怎么喂养的问题。有各种问题。
法比安:但它比细胞系强太多了,细胞系只有一种细胞类型。
第 06 段 · 类器官与邻居
RJ:转到建模这一侧,你怎么给这个建模?这大概是研究前沿。
法比安:我不认为人们已经就最优的建模方式达成共识,尤其是因为数据没有大家想要的那么多。
RJ:对,如果我理解得没错,你也参与了大量空间组学、以及 H&E 病理那类的工作。
法比安:病理那边有非常多样本可用,而现在我们越来越多地做一些空间组学。所以我觉得,我们怎么表示空间上相连的数据集、然后在类器官层面把它拆解,人们并不像对解离细胞那样清楚。
法比安:再说得简单一点:如果我们看解离细胞的空间,看这些分组,我们有一个漂亮的比喻,就是我们人类称为「细胞类型」的东西——大自然并不在乎这个。那只是我们给东西贴上分类,但它帮我们理解这种复杂性。
法比安:我不认为我们对细胞的局部微环境有类似的比喻,也许有一点,在 H&E 里也有。每当我回想、每当我看到病理学家做的事,它常常非常定性,也许还没到那个层面。
法比安:所以我认为我们需要为这件事发展出一套分类的语言。也许是计算上的——也许我们不太需要它,但在计算上,我们也得想想怎么处理它。目前我们实际上把它处理成细胞的分布。
法比安:这是目前的解法,但我认为它可以更精细得多,比如图结构之类。
布兰登:那么一方面是苦涩教训:你去掉归纳偏置,最终能得到一个更大的、适用于你问题的数据集,这帮助你得到更准确的模型,因为你的分布更宽,等等。这是一面。
布兰登:但还有一个反向的趋势,也许可以叫「反苦涩教训」,或者说苦涩教训的另一面:当你在数据稀缺的区间,一方面你必须引入大量归纳偏置,才有足够的统计功效做出好的推断。
布兰登:但还有第二面,我认为我们不久前和约翰·普拉特聊时他提到过:你会有预测模型和描述模型。作为科学家,你真正想要的是得到一种简化,一种描述模型,让你能说「好吧,我测试了所有苹果,重力对苹果是这样起作用的,但我把它建模成一个普适概念,这样我们就知道它对行星也成立。」
布兰登:所以我想从你这里了解:有哪些简化——也许是简化,也许是洞见,也许是真正的数学或其他科学模型——正在浮现,能帮我们把所有这些复杂性降下来,让我们真的能从这些巨大的数据集中获得有意义的东西?
第 07 段 · 苦涩教训:数据还是偏置
法比安:对,这非常重要,我认为这是一个相当深的点,它把这个领域分成也许两类人,答案不同:我们到底需要在模型里放多少归纳偏置、多少先验,才能让它更可解释,也可能在分布外更稳健?还是我们在多大程度上只依赖更大的数据,让模型更有表达力?等等。
法比安:在进入哲学之前我必须说清楚:文献已经非常清楚地表明,几十年来,至少在我们最主要的那些数据集上,如果我们把先验的归纳偏置建得太强,可能会损失预测能力。这是有代价的。
法比安:所以现在,假设你是个医生,你只是想要……或者甚至你是病人,你可能得癌也可能没有,你也许想要最好的模型做预测。
法比安:也许如果你在接受治疗,你想要一个稍微差一点、但你更理解它的模型。但至少对预测来说,我认为你想要最好的那个。
法比安:这一点我觉得并不完全清楚。在我们这个领域,在扰动空间这个尺度上,我认为细胞尺度是大的,但扰动空间的尺度——也就是我们对它做的事情——没那么大,我不认为我们已经处在超级数据丰富的区间。
法比安:所以在我们这个例子里,这些混合模型也许仍然是应该走的路。
法比安:但当然,越来越多——我不知道这能不能叫悲哀,但从大规模机器学习得到的诚实教训是:某个时刻,数据会战胜人手工加进模型的概念。
法比安:我常举的一个简单例子是 AlphaFold:最早的模型花了非凡的努力,让分子具有旋转不变性,把它建进学习过程里;只有在后来的版本里,旋转对称性才被模型自己、仅仅靠更多数据找到,而且更灵活。因为你放进去的任何物理约束并不总是那么刚性,如果你让模型自己学,你会得到一些东西。
法比安:所以我认为未来,至少是被更广泛使用的模型里更大的那一部分,会是那些更灵活、非常依赖数据的模型,然后你再事后把解释放上去。
RJ:这也带出了我的问题。你最近写了一篇或合写了一篇论文,讲的是当前这一代虚拟细胞在数据上能获得多少统计功效——也就是在当前这代虚拟细胞模型里,增加数据能带来多少提升。我记得你基本上说过,问题可能出在目标函数或训练方法上,而不一定是数据里没有信息。你能解释一下吗?为什么你觉得信息里有很多没被利用的东西,这会带我们到哪里,我们需要做什么才能走得更远?
法比安:对。我觉得可以说,早期我们有那种很小的、比较受限的预测模型:先学潜空间,然后在上面学扰动。
法比安:然后,当这种真正大规模的基础模型表征出现时,所有人都买这个 hype,可能有点买过头了。
法比安:然后显然,之后就来了所谓的清醒期,对吧?然后有一堆论文出来,基本上在说:嘿,也许更线性的模型也做得不错。
法比安:而实际上我们早期的 SCGen 论文里就已经有一些基准显示,要超过它并不是那么超级简单容易的任务。
法比安:我认为这里面有真相:特别是在当前的数据状态下,对某些事情,比如说你想预测某个细胞系里 CRISPR 的效果,你可能不需要最花哨的模型。
法比安:而如果你想预测细胞类型之类,那基本上逻辑回归就够了。
第 08 段 · 基础模型为什么让人失望
法比安:但如果你想预测更难的东西,比如在我们的 Nicheformer 论文里——那是一个空间组学的基础模型——我们展示了我们引入的一个新任务:你有一个基因表达,你有一个单细胞的潜空间状态,你能不能预测它邻居细胞的基因表达状态?因为它们一直在通讯,或者反过来说也一样,它们一直在互相说话。
法比安:因为它们互相说话,你会在这个细胞里看到那个细胞状态的残余。而这实际上更难做。
法比安:如果你有这些更难的任务,你就需要更强的、更非线性的东西,你尤其需要去找更微妙的数据。
法比安:所以你的问题——你能否找到信息更丰富的东西——我认为很大程度上取决于你最后问的是什么。
法比安:当然,在自监督学习阶段,我认为我们绝对还没有找到最好的表示方式、最好的学习方式。这里大量复制了 NLP 大模型里的做法,比如掩码自编码器。那是典型做法。
法比安:但损失函数的类型、表示的类型,我认为人们还在争论,因为你知道这常常是表格型数据。甚至表格型基础模型现在也在被尝试。现在有很多 JEPA 类型的做法,因为我们有一个地方用了对比学习。所以人们在玩损失,也在玩表示。
法比安:而且我认为现在审稿人——至少我长期以来一直在提倡这个——会非常仔细地看你有没有恰当地展示缩放律。这正是早期基础模型论文缺的东西。人们并没有真正展示你需要这种复杂度才能真正扩大规模。
法比安:但如果你真的能在规模上、跨样本展示出这种缩放行为,那我认为你就能让人们买账。
法比安:当然这些里面归纳偏置不多。所以我确实认为我们很快就会进入这个区间,我们也在几篇论文里看到了。
第 09 段 · 先学状态,再学动作
法比安:比如我们那篇对比学习的论文,我们叫它 scConcept。我们已经展示了相当强的缩放行为。论文里我们做到和 Geneformer 相比大概三千万个细胞。但在 Hugging Face 上我们现在有一个 3.5 亿细胞的模型,参数量大概到 1 亿。所以对我们来说真的走到了大尺度,而且我们已经开始看到漂亮的缩放行为。
RJ:为了明确一下:1 亿参数、你说的 3 亿个细胞左右,你在哪些应用上看到提升?就是 Nicheformer 那类问题——「根据我的转录组,我的环境是什么」?
法比安:嗯,你知道,我们最终想做的当然是更好地做扰动预测,因为那才是现在人们理解的虚拟细胞。
法比安:为此我不会声称纯表征学习就是正确的路。抱歉又要说这种微妙之处,但我认为通常你用这些基础模型学到状态空间,但它们在动作、在扰动下的行为方式,那才是你需要更接近世界模型的方法的地方。
法比安:世界模型现在是个很潮的词。我相信你们在播客里已经聊过。过去一年机器学习会议到处都在讲。
法比安:但实际上,一个像虚拟细胞这样的扰动预测模型,在转录组或其他组学空间里就是一种世界模型,对吧?它不只是一个 F(x) 的模型,而是 F(x, a):状态 X 加上动作 A,然后预测下一个状态 X'。
法比安:为此你可能需要别的组合。我们通常的做法是:用比如 scConcept 学表示,然后为沿着动作的推前放一个生成模型。为此我们用流匹配之类的东西。
法比安:在我们那篇 CellFlow 论文里——它刚被《自然·方法》接收——我们真的展示了这些方法在生成扰动效果上要好得多,但它们非常依赖一个好的潜空间。
法比安:在这个 scConcept 潜空间上,对这 3.5 亿个细胞,我们实际上走进了多物种:现在有 16 个不同的物种,你可以去找相似性。突然你也许能问一些以前问不了的演化问题。
法比安:并不是说我们做得那么好,那不是我们的核心专长,但你知道,你可以开始做这些花哨的跨物种、跨组织的潜空间。
第 10 段 · 基线、指标与挑战赛
布兰登:我对这些不同模型的历史有点好奇。你刚给了我们一个快速版本。社区里有点出名的一件事是「线性模型」这个点。你能不能具体解释一下关键点是什么?因为这属于经典的机器学习里那种「一定要把基线搞明白」的事。
布兰登:你懂,否则你会花很多时间原地打转,自己骗自己。我认为特别是 Arc Institute 办的那个公开竞赛,像一杯冷水泼在所有人脸上。你能不能讲讲这段历史:为什么我们当时觉得这很激动,后来为什么让我们转向?
法比安:这听起来是这么明显的教训,对吧?把基线做对。但在一个冲向虚拟细胞这个金罐子的领域里,人们有时也许对基线没那么小心;而且在留出集等方面有一堆微妙之处,并不总是被完全遵守,这也是为什么会出现那些事。
法比安:最早的一个观察出现在像细胞类型预测这么基础的事情上。没什么花哨的:给你一个新的转录组,告诉我它来自哪个细胞类型,甚至哪个器官。结果即使在今天,一些接近最先进的模型其实就只是逻辑回归。
法比安:所以对这么简单的分类,这其实不算太差。比如有个叫 CellTypist 的东西,做得不错。
法比安:我们大概五六年前有一篇论文,标题很直白:《细胞类型预测不需要深度学习》。这在器官内部是真的。如果你跨器官,突然就微妙一些了,因为细胞类型会在不同器官里重复出现,免疫细胞会根据所在组织有微妙变化。突然你就需要多做一点。
法比安:对我们来说,有一篇论文叫 scTab,是一个表格型基础模型、预测型的模型,我们真的展示了非线性确实在基线之上还有增益。所以那一类是这样的。
法比安:对扰动模型,也就是布兰登你刚问的那类:早期很多分析,特别是 Perturb-seq,都是用经典线性模型在做伪 bulk。后来我们 2019 年的 SCGen 开始引入线性平移,但是在潜空间里,也就是非线性编码的,而且我们总是和更简单的线性平移对比。
法比安:但领域变复杂了,数据集不断冒出来,人们开始问越来越多的扰动类问题。早期有一大堆这类竞赛,比如 MIT 定期办的那个。
法比安:我们定期办 NeurIPS 单细胞数据预测问题的竞赛,有时是整合数据,也有扰动预测,参与度非常高。
法比安:而锦上添花的那一颗,肯定是 Arc 那个竞赛:他们把这个东西不叫扰动预测挑战赛,而叫虚拟细胞挑战赛。听起来酷一点,对吧?参与度非常高。但用的指标是不是稳健,也许,但也许不那么容易。
法比安:其实我们在那个联盟里的解法——很多实验室参与的 Open Problems——是:人们需要额外提交自己的指标。这样才能真正量化那些你以前可能没想到的微妙之处。
法比安:Arc 那个固定了一批指标,而那些指标甚至不是那么单细胞特定的,它们可以被利用。
法比安:所以其实,最终被加冕为冠军的那个模型,本质上是基于流匹配的东西。基于这个想法:人们用这个 flow、这个 cell flow 类型的想法往前推。
法比安:我认为这说明某些非线性在这里是必要的:真正的赢家——如果把钻空子剔掉——实际上是需要一些非线性的。
法比安:而且我认为现在确实看到,单纯的线性或加性模型应付不了更复杂的东西。
法比安:但即使在今天,如果你只有少数几个细胞系、做基因敲除,尤其当效应比较微妙时,这些更复杂的模型有时会过拟合,所以线性基线总是很好。
法比安:所以我总跟我的学生说:伙计们——我是说男孩女孩们——我们总是要做;我知道你想做最花哨的深度学习,但拜托,拜托,把基线做出来。
法比安:比如说药物,基线可以简单到「预测它会向均值变好」。那是最难的基线,甚至不是线性模型,就是比均值好。如果数据里噪声不多,它有时没那么难,而这些东西超级吵。
RJ:我想补充一点:王博(Bo Wang)和他的合作者刚在《自然》上发了一篇论文,讲在那些线性基线打败模型的例子里,指标本身其实是问题所在。所以这明显不只是指标被黑,还在于问错问题就会得到错误答案,或者说指标的选择问题。
法比安:对,我认为这可以讨论。某个时候,我们会让 agent 去尝试你能想到的各种算法组合。实际上我们已经和一些 AutoML 类型的实验室有合作来试这个。
法比安:所以「还剩下什么」听起来有点刺耳,对吧?但我们最大的想法真正投入的地方,其实就是指标的定义,RJ。
第 11 段 · 亥姆霍兹怎么组织
RJ:有一件事我一直很感兴趣:研究界、学术界的经费模式。我认为德国的结构和美国根本不同。你的机构是怎么设置的?相比美国的研究模式,它给你带来什么不同的机会?
法比安:我非常同意,经费模式对灵活性、对你能组建的团队、对你能有的长期愿景都非常重要。
法比安:亥姆霍兹不仅是德国的,我会说也许是欧洲按经费算最大的研究组织。它有几个不同的重点领域,健康是其中一个大的,另外还有材料信息科学、物理等等,本质上是拿联邦的钱去投入一个很深的研究问题。
法比安:我在亥姆霍兹慕尼黑建起了这个计算健康中心,现在大概有 45 个研究组组长和教授,也许 500 到 600 人。所以我认为我们是欧洲最大的做健康 AI 研究的学术机构,这里的人真的在做所有尺度上的工作。
法比安:比如我专注在细胞尺度,但有人在做 DNA 基础模型,有人在蛋白设计上做有意思的东西,有人在做病人队列的表示、遗传学等等。
法比安:现在你可以开始把它们拼在一起,我们的一个大愿景就是交叉起来,走向「虚拟人」等等。
法比安:但话虽如此,关键的一点是:与大学相比——尽管我们都有大学编制,主要是慕尼黑工业大学或慕尼黑大学,有意思的是欧盟排名最靠前的两所——我们在大学里有这些编制,但我们没有本科教学。
法比安:我们基本上只有博士生和博士后,但我们和大学、特别是和医院互动非常多,因为我们想要这种转化性的东西。
法比安:而且越来越多地——也许这是一个有意思的连接——这有点像美国 NIH 那类模式,但是分布在全国各地,而不只是在一个地方。
法比安:也许一个有意思的关联是:政府和德国这边越来越意识到,需要有强得多的转化成分,不只是转化到大学,而是转化到学术界之外的价值创造,显然更多是走向创业公司之类。我认为波士顿的环境一直是个关键例子。
法比安:现在当然湾区更是如此。我最近去拜访,好像是 Genentech 还是同事,我们去一家餐厅,其中一个服务员问我们:嘿,你们是在聊 AI 和生物吗?我也一直很感兴趣。
法比安:所以每个人都在想创业点子之类。我有点觉得这是个好的环境,这也是我们的博士生现在越来越多在做的事,我们也在学习。
法比安:而且在价值创造方面,慕尼黑特别地——至少在欧陆,也许是现在最好的地方——对风投资本,也对深科技,特别是生物和国防领域,真的在爆发。这些事情开始起作用了。
第 12 段 · 德国强在从 0 到 1
布兰登:你说的创业那段我觉得非常吸引人。我听说德国的创业生态有一些问题。和欧洲其他地方比,在那里创办公司很难。现在德国创业公司的竞争格局如何?德国怎样才能更有竞争力?
法比安:我在这件事上有既得利益,因为我大概很快要拿到德国国籍了。(笑)欢迎。你来慕尼黑的话告诉我一声。
法比安:我认为传统上欧洲——但我肯定要说德国——是相当官僚的,流程远没有你在别处预期的那么数字化。我倒不是说美国就是全数字化流程的最好例子,但事情肯定更快。
法比安:问题是,人们现在已经意识到这一点。我认为特别是创业公司的创建与落地,在德国相对欧洲是很有竞争力的。
法比安:它其实是那个主要数字,特别是在一些热点,比如柏林,但慕尼黑特别地——我认为是创业公司数量最多的首都。而且即使在今天,如果你看欧盟,新公司的创建数量和在美国一样多。
法比安:问题在于,欧洲特别是德国掉队的地方是放大那一段。早期的风投、以及非稀释性的钱,这些都有。但当你进入放大阶段,那些愿意承担更大风险的大型风投,我认为存在感远没有那么强。
法比安:我一次又一次看到:如果你想真的拿到更大的支票,比如 A 轮、B 轮,人们开始更多地往美国去。
法比安:但也许我在这里有点简化了,但至少这是我目前的认识,布兰登。你,你在几个本地创业公司的董事会里,或者说参与了几家。从想法到在德国创办一家新公司,需要什么?
法比安:我不知道你有没有听说,欧盟试图监管一大堆东西,这有时可以是个优势。你知道挺酷的,比如在整个欧洲我们都可以用手机;你可能也听说现在所有手机都得用 USB-C 了。这些是挺酷的东西,有一些好的东西在出现。
法比安:但当然,也有些像 AI 法案这样的东西,让事情复杂一点。幸好对研究还没有,但对于跨医院的数据获取等等——我们刚在谈健康深科技——有些系统我认为在欧洲非常棒,我想到芬兰的 Fingene,还有丹麦等等,那种非常详细的、关于人群采样的描述,把医疗记录连接起来,比——美国在让所有系统互相说话这件事上,也跟德国一样乱。
法比安:比如病人到美国不同的州,和德国病人到不同地方一样,很难建立病人的轨迹。
法比安:但有些地方知道怎么做,而且欧盟有一个东西叫欧洲健康数据空间,大概未来两年内这些东西需要跨境打通。你需要开始建立这些健康记录的组合。所以我确实认为愿景正在开始实现,只是速度不够快。
法比安:所以我认为对一个科技创业公司来说,我注意到最大的事情永远是你需要为这件事找到最好的团队。我们有教授和 PI 真的在想这些。
法比安:比如对我那个部门,我说:伙计们,每个 PI、每个组长,我都期望你在未来三年里至少有一家衍生公司。我们看看这怎么运作,对吧?但你得把人往这条轨道上推一点。
法比安:但我认为这现在无论如何都在自下而上地发生,学生们其实在推动这件事。他们确实意识到现在有一大堆机会,特别是随着计算这一侧被推到更前面——我们现在真的可以开始指导实验了。
法比安:我们还没怎么谈到这一点,对吧?但一旦你有了这些扰动世界模型,你其实可以反过来驱动实验。
法比安:所以我确实认为计算类创业公司也可以在数据生成上做得很好,我认为这也会不只变成漂亮的论文——那基本是我们的全部生意——也会变成下一代创业公司。你确实看到有几家冒出来,真的把实验室放进了回路。
第 13 段 · 虚拟细胞的生意
布兰登:你认为这些虚拟细胞相关想法最有前景的商业化领域是哪些?
法比安:有意思。如果你看早期,当然人们总会提到 OpenAI、Anthropic 那些想做的事:他们其实不知道怎么赚钱,有些人可能会说他们现在也不知道,对吧?(笑)
法比安:有几家拿到很强投资的创业公司也说「我们造生物学的基础模型」「我们解码生物学」等等,却没真的说你想拿它做什么。我一次又一次看到,这种平台型的想法超级有吸引力。
法比安:它们符合我们已知的东西。你提到我们建的一些工具和平台,比如 ScanPy、scverse 等等。但把它真的变成钱并不那么显然。
法比安:可能有一些咨询生意,但如果你说你建一个虚拟细胞平台,投资人通常理解的是——在欧洲这个更保守的风投生态里比在美国更如此——你某个时候会开发一款药,然后这就清楚了。
法比安:所以我看到太多这类平台公司某个时刻转向「我们做药」。然后当然,旁边还有我们那个虚拟细胞什么的生意,但我们找到了两款药,现在这个,所以如果我们投很多钱,也许你能算出别的账。
法比安:有几家还在坚持把 AI 生意做大,但它怎么直接变成一个可行的、真正可扩展的商业模式并不清楚,而且这个市场能不能容下很多家也不清楚。
法比安:当然,还有一种焦虑:某个时候 Astra 2.0 可能已经在做其中一部分了。
布兰登:我的意思,我确实认为这其实一直是我的一个论点:直到最近,每一家造模型、造东西的公司,最后都只是去做药,因为那是长期变现的路径,对吧?
布兰登:而如果你要跟药厂落地销售,那非常难;或者找其他有大钱的花钱方。如果你是工具公司,如果你说「我要建一个资产,然后可以把它卖掉」,那对投资人非常有吸引力。是的。
布兰登:但今年我们其实看到了相反的事,对吧?比如结构生物学那边,你有几家:Boltz,还有布兰登会更熟的几家。
布兰登:然后,哦,Chai 是我们聊过的一家,我们还采访了几家在做强化学习环境方向的。
法比安:我很想在结构生物学那边看到和「Structural」一样活跃的动静,也在做 Noetic 那样的事。
法比安:我认为 Noetic 是个好例子,因为他们的数据生成规模也相当好,其中很大一部分是数据获取。
法比安:你知道,我们之前谈过类器官扰动那类事,我们其实和一些药厂合作建立了一个联盟,叫癌症类器官扰动图谱,药厂是真的买单的,因为他们想尽早拿到这些扰动数据集。
法比安:我认为有些交易就是往这些方向走的。所以如果你把数据生成和建模绑在一起,而不只是建模那一块,我认为那就是甜点位置,药厂也会真的买单。
法比安:我看到的越来越多的公司,护城河不只建在虚拟细胞模型上,而是建立在与独特的、特定数据的结合上。这当然也是更多的价值创造。
第 14 段 · Y 模型:两个导师
布兰登:我不知道这是否完全准确,但我读到你好像在什么地方说过,你让你的学生遵循一个你称之为 Y 模型的东西,就是你必须有一个方法和一个湿实验的导师。这听起来特别有意思,也和我们现在的对话特别相关——数据这么重要,大家又这么关注实验工作,而这正是很多公司的护城河。你能谈谈这个吗?
法比安:谢谢提这个。我一直在建、后来变成一件挺大的事的东西,叫慕尼黑数据科学学院。它不只限于生物,我们有很多别的学科。
法比安:在那里我们有一种导师模式:总是需要两位 PI 一起提交一个提案,然后向学生提出,像研究生培养那样,这就是那个 Y。
法比安:所以有一个偏方法的,一个偏领域的,然后是一个导师学生。有时我们在 Y 模型下有两个学生,所以 Y 加 Y 等于 H。你懂吧?(笑)
法比安:但我觉得这个想法哪怕在今天也还是有点琐碎,对吧?但我认为把它这么硬地嵌进去是好的,这样学生就真的——我通常去两个组会。
法比安:一个组会,他们需要真的学习和理解更深的生物学问题,理解医学场景的语言之类。然后他们去计算那个组会。通常他们都是计算、数据科学类的学生,对吧?但然后他们去计算那一边,被推着学方法那一面,从而吸收一大堆问题——那些在生物实验室里还没被精确表述、还不能直接放进一个函数里的问题。
法比安:但因为他们偏方法、他们是定量的,他们能把它变成一个指标或什么,然后变成一个模型、一篇论文。我认为这是一种方式……
法比安:我是说,我们这样做大概八年了,这种学院。真的出了很多论文,我在里面了解到一些我以前完全不知道的系统。
法比安:人们来找我:我们能做点像这样的事吗?然后我就了解到关于肺、关于脑的一些我完全不知道的事。
法比安:然后我说:哦,酷,这数据不错,我觉得我们这类模型能适配,我们围绕它建一个项目。然后这些学生就成了我实验室里那个具体生物学问题的专家,和一个伙伴一起,我们把它往前推。
法比安:而这现在也扩展到了不同的数据类型。早期很多东西只是围绕 RNA,但后来我们去年在《科学》上有一篇很好的单细胞蛋白组学论文;我们一直在扩展到空间观测。有这些额外的模态和你能测的东西,我认为在那个特定领域就会出现有意思的问题,那些测定在那里效果很好。
布兰登:我的意思,这是我天生的倾向:去收集跨领域的东西。我认为它常常能催生非常好的、有意思的想法。
布兰登:再追问一句:你已经做了八年,你看到什么样的长期回报?
法比安:有一件事——我想这也是我们当初能让学生加入的原因:一开始听起来活更多,对吧?你要学两样东西,你要去两个组会等等。
法比安:但我认为一旦——在德国、欧洲,学生通常先读硕士再读博士,对吧?不像美国只读本科。所以他们多读一到两年硕士,然后他们懂一点科学,但不太清楚自己到底对什么感兴趣。
法比安:在这种组合式的培养里,他们可以采样一点,因为在这个研究生院里他们能看到不同的提案,可以采样自己对哪个领域感兴趣,也可以在方法那一侧玩一玩。所以我觉得这挺有吸引力。
法比安:对,我认为通过这种尝试不同东西,我的印象是这让学生变成了很好的数据分析者,同时也是建模的人。
法比安:然后下游,他们去的领域也同样多样。有些人去了生物医学领域的药企,有些人显然留在研究里,有些人更走向创业,有些人去做很纯的 AI 工作。
法比安:英伟达几个月前一个月之内就从我这里招走了两个人,去做的很大程度是计算那一侧,也有一点 NVIDIA 现在在建的生物部分。还有其他类似的大公司。
法比安:所以我认为这给了他们一个有意思的画像。我认为现在去面试时,说「我不只做了这个花哨的模型、在欧洲某篇论文里提升了 2%」,而是「我还有一个真实的、更复杂、更深入的应用,我得帮忙找到用例」,这是个好主意。
第 15 段 · 闭环:从预测到反演
布兰登:在 agentic AI 这股潮流中——我们采访过的几位嘉宾,或者我们有一篇博文都提到——湿实验的科学家基本上开始变成做计算的了。我有点好奇:随着这个演进,随着 agentic AI 基本上让任何科学家都能成为自己的计算人员,你认为这种共同指导策略会怎么演进?你也认为湿实验生物学家和计算团队之间的融合会怎么演进?
布兰登:我能想到,我听过好几位有名的 CEO 说:我们的优势就是计算团队和湿实验团队的融合。所以我很好奇你怎么看这个演进,以及你怎么建立文化去利用这些新技术。
法比安:让我先把文化那部分放一放,因为我觉得那很难回答,但问题很好。我先谈你问的那个很酷的点:这些事情发生的地方,真的走向深度整合。
法比安:我认为我们现在面对的最令人兴奋的前沿之一,也许是一个机会:我们现在真的可以开始指导实验了。
法比安:以前我们建这些人类细胞图谱,我们有画图这一面。然后我们谈世界模型的预测问题。所以从画图,我们走到了预测,但现在我们可以真的去操纵下一次实验。
法比安:这一直就是科学方法:把假设放进回路,然后对它做点什么。但说实话,论文常常以一个模型收尾,也许一张概念图,也许加一点验证。然后通常你就开始下一个项目。
法比安:当然你学到一点,但那不像持续学习那种东西。但现在我认为我们可以越来越多地真的回到回路里。
法比安:这在分子设计、材料设计等地方发生得非常多,实验室在回路里真的在工作。
法比安:虽然一些大药厂把它当作一个总体的大主题来宣传,但真的做多轮「实验—计算模型—再回到实验」整合的例子还不多,不管是一个人做还是两个人做。
法比安:但这种整合很难搭起来,而且难搭起来一次,因为建模——因为一旦你有一个模型,决定下一个最优问题是什么并不简单。
法比安:我们其实今天或明天会在 bioRxiv 上出一个新东西,叫 LabCompass,它是一个反演生成模型:一旦你有一个正向的世界模型之类的东西,它能告诉你为了达到某个状态你需要做什么。
法比安:这对我们来说非常兴奋。我认为这项工作的很大一部分不只是模型,而是和实验人员的合作。
法比安:在这个案例里,是一位来自剑桥大学的好朋友兼同事,他做造血,有一个快速循环系统,我们实际上搭了三、四个实验室在回路里的循环,我们迭代地改进一个模型。
法比安:我认为这是非常难的事。这也进入你的第二个问题,布兰登:你怎么建立一种文化,让你的计算人员、模型或什么预测出某件事之后,你真的能说服实验人员把他们的生命投进去?
法比安:因为这些实验常常要花一些时间,要让他们真的相信,然后真的去测这些后续。有时候如果对象是分子,这会好一点,因为赌注没那么高。
法比安:但如果你说,你需要做这个新的细胞系,你需要加这些很奇怪的东西,你真的想做吗?我们是不是该相信一点自己的直觉?然后就会出现这些折中的方案。
法比安:所以我认为真的把它搭起来远不是小事。那需要文化,也可能是同一个人在做。
法比安:很多人开始抛出机器人等等,但我觉得那有点太早,因为我们在测定上的周期时间还是偏长。
法比安:但我确实认为这会到来,显然最终愿景是我们想把一切都做成强化学习,我们想把这个回路也做成强化学习。这有点远,但我觉得我们在慢慢靠近。目前它更接近主动学习。
法比安:我觉得很像我们聊过的 Lila 那家,那就是他们的核心论点:实验室是 RL 环境的一部分。(笑)
第 16 段 · 收尾:看看别的小学科
RJ:是啊,太好了。法比安,现在对你来说很晚了。非常感谢你从晚上抽出时间来跟我们聊。
RJ:期待看到你的研究——我说你的时候,是指你的实验室、同事,还有你本人。我很期待看到这个进展,并仔细跟踪我们今天谈到的东西。
法比安:谢谢,非常感谢你们,RJ、布兰登,能来很开心。我认为这些连接很重要,就是往你自己那个更小的学科之外看一看,这些讨论对我帮助很大。我真的很享受这次讨论。
References
- 1
- 2
- 3Parse GigaLab: 10M+ Cells in a Single Run
parsebiosciences.com
- 4
- 5
- 6
Comments