《NeRF》:一个场景存进 5 MB 的网络,没拍过的角度为什么也能渲染出来
从「一百张照片要渲染一个没拍过的角度」讲起,拆开 NeRF 的五维函数、体积渲染与位置编码六条式子,讲清每一步在算什么,并用两张原表读懂 PSNR、SSIM、LPIPS 的口径与它赢在哪、输在哪。

2020 年 3 月 19 日,arXiv 上线一篇论文,标题是《NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis》。
署名六人:Ben Mildenhall、Pratul P. Srinivasan、Matthew Tancik,前三人共同一作;另有 Jonathan T. Barron、Ravi Ramamoorthi、Ren Ng。单位是 UC Berkeley、Google Research、UC San Diego。1
arXiv 的会议说明写的是 ECCV 2020 oral。1
到 2026 年 10 月 30 日,OpenAlex 给这条会议记录计到 5,347 次引用。4
论文要解决的问题,先拿一个具体场景说。给一个架子鼓拍一百张照片,相机绕着它转一圈。
然后你挑一个没站过的位置,要一张那个角度的画面。
这件事叫新视角合成(view synthesis)。
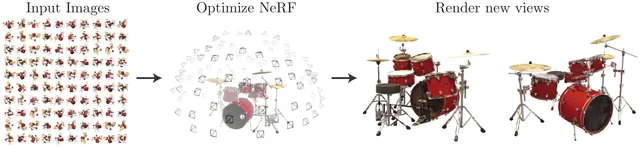
下面的事实、公式、表与图,都按 arXiv v2 这份 25 页的排版版读。5
三条路:格子、表面、分布
相机位姿已知,照片若干,要造出别的角度。三种做法在论文的相关工作里排成一列。
这条路线的账落在存储上。论文算了一笔:LLFF 为一张输入图存一整块体素网格,一个 Realistic Synthetic 场景超过 15 GB。5
LLFF 的好处是快:处理一个小数据集用不到 10 分钟。5
第二种把场景写成隐函数,但只写表面。Scene Representation Networks(SRN)让 MLP 把每个坐标映射成特征向量,再用一个循环网络沿光线一步步走,走到表面收起。8
论文对这支的判语很短:这些模型要真值三维几何,通常来自 ShapeNet 这类合成形状库。5
NeRF 选的是第三种:一条光线配一整个密度分布。
三条路的共同点在于监督只有照片,分歧在于场景用什么量表示。这个分歧决定了钱花在哪。
有一处关系值得停一下。LLFF 的作者里有 Mildenhall、Srinivasan、Ramamoorthi、Ng,跟这篇是同一组人。7
这篇论文替掉的,是这组人自己上一年的方法。
一个场景就是一个函数
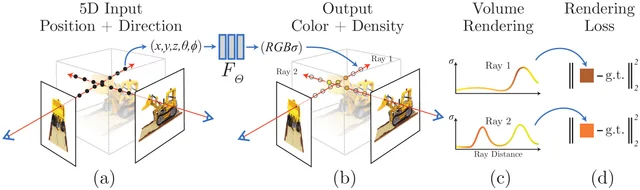
NeRF 把场景写成一个五维函数 。输入是三维位置与二维视线方向,输出是一个颜色和一个体积密度。5
网络结构朴素:八层全连接,每层 256 个通道,激活用 ReLU。5
第五层接了一条跳连,把输入接回去,这是照 DeepSDF 的做法。5
理由是多视角一致性。同一个位置上有没有东西,是两个视角必须共同承认的事实;若密度也随方向变,两个视角就会对“这里有没有物体”给出互相矛盾的答案。5
颜色随方向变就合理了:同一块表面,从不同角度看反光不一样。论文用船的桅杆与水面做例子,展示同一个三维点在不同视角下的颜色分布。5
渲染:沿一条光线积出颜色
渲染一个像素,就是从相机出发穿过它打一条光线,把这条线上的密度与颜色累加起来。论文用的是 Kajiya 与 Von Herzen 1984 年那套经典体积渲染,第 4 节的式 (1):
整条积分的读法是“先到先得”:前面挡得越多,后面能贡献的颜色越少。这正是相机看到的东西被近处物体遮住的机制。
积分要算,只能离散化。但离散的取法有讲究:如果像体素网格那样在固定位置上取样,网络就只会在那几个位置被查询,分辨率从此由格子密度定死。5
论文改用分层采样,式 (2):把 切成 个等宽的区间,每个区间里均匀随机抽一个点。
每个区间只抽一个,位置却每轮都变。训练很多轮之后,网络在这条光线上的查询点几乎铺满全程,分辨率跟着计算预算走,格子的密度不再决定它。5
有了这些采样点,式 (3) 把积分换成求和:
这一串运算处处可导。梯度从像素颜色回到每个 与 ,再回到网络权重 。5
于是监督信号只需要照片本身。论文写得很直白:优化这套表示唯一需要的东西,就是一组相机位姿已知的图像。5
位姿从哪来?合成数据用真值,真实照片用 COLMAP 这类运动恢复结构工具估出来;场景的近远边界也要事先给。5
这条前提在复现时最容易被忽略:输入从来不只是一堆照片,还得有位姿、内参和场景范围。
第一处改进:位置编码,让 MLP 看得见高频
按上面的写法直接训,结果会糊。论文在第 5.1 节点出这个反常:万能逼近定理说这样的网络存在,实测却学不出高频的颜色与几何变化。5
解释来自 Rahaman 等人 2018 年的工作:深度网络偏向先学低频函数,把输入映射到高维再送进去能改善。11
两句话合起来是:网络有能力表示高频,梯度下降却先找到低频的那个解。
补法是式 (4),把每个坐标分量展开成一组不同频率的正余弦:
在算什么?它把一根平滑的坐标尺换成一把带刻度的振荡尺子。网络的第一层就能直接看到“这里的变化有多快”,不必自己从平滑输入里造出高频。
这里有一处同名不同物,读过 Transformer 的人容易串。Transformer 的位置编码给不含顺序概念的架构提供 token 的位置;NeRF 的这个映射把连续坐标抬到高维,让 MLP 拟合高频函数。5
频率开到多大有上限。论文的消融显示 从 10 加到 15 反而更低,理由是 一旦超过输入图像里最高的频率(这批数据里约 1024),再高就无用。5
第二处改进:分层采样与损失
每条光线均匀撒 64 个点很浪费。大片自由空间与被挡住的区域对最终像素没有贡献,却照样被查询。
论文的办法是同时训两个网络,一个粗、一个细。先用粗网络按式 (2)(3) 算一遍,把式 (3) 改写成加权和,式 (5):
这些权重归一化之后,就是沿光线的一条分段常数概率密度。密度高的地方,说明粗网络认为那里真有东西。5
再从这条密度里逆变换采样出 个新点,与原来的点合在一起,让细网络算最终颜色。原本均匀铺开的预算,就这样挪到了有用的位置。
训练损失是式 (6),把粗、细两个输出都拉向真值:
粗网络那一项看着多余,其实必须留着。细网络的采样位置全靠粗网络的权重决定,粗网络若没被训准,密度就成了噪声,重采样也跟着跑偏。5
其余数字:每批 4096 条光线,粗网络 ,细网络再加 ;Adam,学习率从 指数衰减到 。5
时间成本也在这里定下。单个场景要 10 万到 30 万次迭代,一张 NVIDIA V100 跑一到两天。5
渲染同样不便宜。每条光线对网络查询 256 次;一张合成图有 64 万条光线,一张真实图有 76.2 万条,折合每张图 1.5 亿到 2 亿次查询,V100 上约 30 秒一帧。5
两张表怎么读
Table 1 在三个数据集上各比三种指标:PSNR 与 SSIM 越高越好,LPIPS 越低越好。12
第一栏是四个简单的漫反射物体,NeRF 的 PSNR 是 40.15,LLFF 是 34.38,NV 是 29.62,SRN 是 33.20。5
第二栏是带复杂几何与非朗伯材质的八个合成物体,NeRF 31.01,LLFF 24.88,NV 26.05,SRN 22.26。5
第三栏是八个真实场景,用手机前向拍摄,每个场景 20 到 62 张图,留八分之一做测试。NeRF 26.50,LLFF 24.13,SRN 22.84。5
读这张表有五处要留神。
第一处,赢面在哪。在第二栏这种非朗伯、几何复杂的合成数据上,NeRF 比 LLFF 高 6.1 dB,差距最大。
第二处,输面在哪。真实前向场景这一栏,LLFF 的 LPIPS 是 0.212,NeRF 是 0.250,LPIPS 越低越好,LLFF 赢。5
论文自己写了这句:除了一个指标之外全面胜出。5
第三处,NV 在真实场景那一栏是空的,因为它只能重建有界体积内的物体,前面还得单独拍一张没有物体的背景。5
第四处,分辨率不同。SRN 的指标是在 512×512 和 504×376 上算的,其他方法在 800×800 与 1008×752 上算;论文坦白原因是显存。5
拿不同分辨率的 PSNR 直接比,会把差距读歪。
第五处,三个指标都在逐帧比。一张渲染图与对应的真值图比,量不到“换一个视角还对不对”这件事;论文因此让读者去看补充视频。5
Table 2 是消融,八个场景平均。完整模型 31.01。
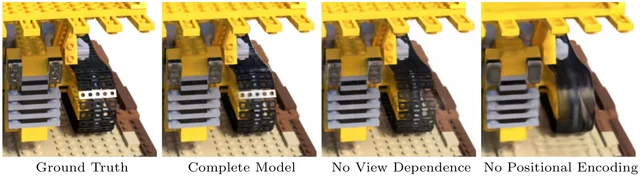
去掉位置编码掉到 28.77,去掉视线方向掉到 27.66,去掉分层采样掉到 30.06,三样全去掉是 26.67。5
按幅度排,方向依赖掉得最多,位置编码次之,分层采样最少。论文正文把移除位置编码与移除方向依赖并列成收益最大的两项,分层采样排在后面;这个排序与表格里的数字相符。5
两处反直觉值得记。频率开到 15 得 30.81,低于开 10 的 31.01,多加的高频没有换来收益。5
输入图减到 25 张,NeRF 得 27.78,仍然高过三个基线各自的 100 张成绩。5
存储那一栏的对比最直观。网络权重 5 MB,LLFF 为一个场景要 15 GB 以上,论文算出的倍数是 3000 倍。5
代价在时间那一栏:同样的对比里,LLFF 不到 10 分钟,这套方法要一到两天。
它自己承认的边界
第一个边界是每场景一训。换一个场景就要重训一个网络,权重之间没有任何共享;论文的实现里,每个场景都是独立的表示。5
第二个边界是时间。一到两天的训练,30 秒一帧的渲染,做成一段可以播放的环绕视频要几千帧。
第三个边界是输入条件。相机位姿、内参、场景的近远范围都要事先知道;真实照片的位姿靠 COLMAP 估,估错了后面全错。5
第四个边界是静态。输入只有位置与方向,场景里动的东西没有一个地方可以放。5
第五个边界论文自己写在第 7 节:体素网格和网格模型能让人推测哪里会失败,把场景编码进网络权重之后,这种推测就做不到了。5
同一节还有一句朴素的判断:渲染与优化的效率上都还有很大空间。5
后来换掉了哪一格
后面几年的工作,大多替换这套流水线里的某一个部件,而且能被指认出来。
Mip-NeRF 换的是采样与渲染的对应关系:一条光线从一个点换成一段锥体,用来压抗锯齿与尺度问题。13
Instant NGP 换的是输入编码:把式 (4) 那组正余弦换成多分辨率哈希表,训练时间从小时级压到分钟级。14
3D Gaussian Splatting 换的是表示本身:场景由一组各向异性高斯承担,渲染走到实时。15
NeRF in the Wild 换的是“场景固定不动”这条假设:给每张照片一个外观嵌入,再把画面里与场景无关的瞬态内容单独建模。16
DreamFusion 换的是监督来源:拿一个二维扩散模型当裁判,不再需要多视角照片。17
换个角度看,这几项替换留下的共同东西是“可微渲染连接图像与三维表示”这一格。表示、编码、采样、监督都能换,这一格一直在。5
读完留下的判断维度
一,先看场景用什么量表示。格子、表面、分布,三种表示把成本压在不同的地方:格子压在存储,表面压在几何假设,分布压在计算。
二,再看两个输出各依赖什么。 只看位置、颜色还看方向,这个不对称是几何与外观的分工,也是多视角一致性被写进结构的地方。5
三,再看梯度从哪来。NeRF 的答案是可微渲染,所以相机位姿从可选条件变成了硬前提。
四,最后看指标能不能横比。分辨率、缺项、逐帧还是跨视角,这三处不核,表就会读错。
想自己验一遍,最短的路径是这样:找一个能绕圈拍的小物体,拍 100 张左右,用 COLMAP 拿位姿;按式 (2)(3)(4) 写渲染,粗网 64 点、细网再加 128 点,降一半分辨率跑五万步。
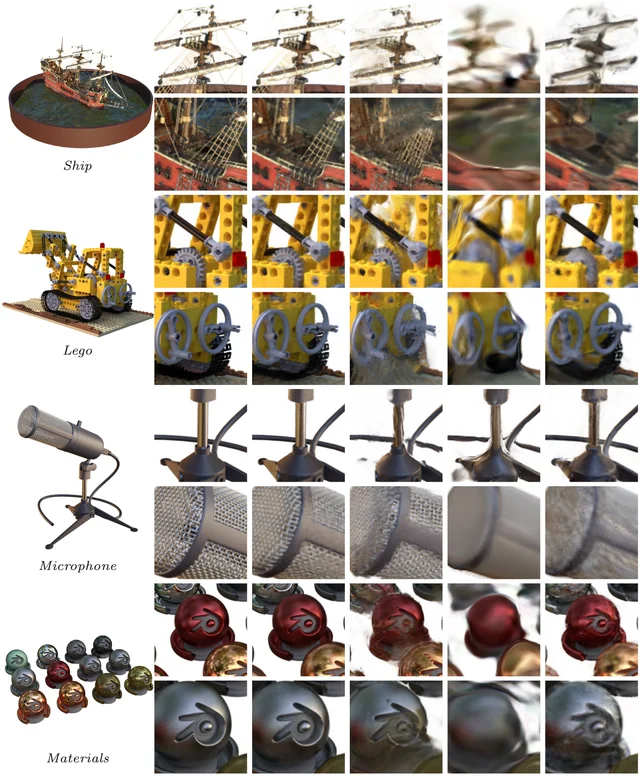
训练起来之后,粗网络给出的权重会往物体所在的那一段集中, 在表面附近陡起来。把一个不带 的版本并排跑,会复现 Figure 4 第四格那种糊,这就是式 (4) 在起作用的直接证据。
References
- 1
- 2
- 3Crossref 记录:LNCS 12349,页码 405–421
api.crossref.org
- 4OpenAlex 作品记录 W3109585842,2026-10-30 查询
openalex.org
- 5原论文 Figure 1 及其图注
arxiv.org
- 6
- 7
- 8
- 9Park 等:DeepSDF,CVPR 2019
doi.org
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17Poole 等:DreamFusion,arXiv:2209.14988
arxiv.org
- 18NeRF 项目页
matthewtancik.com
- 19官方代码 bmild/nerf
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.