一个 minor 版本改了三处线上行为:升级的判断该落在哪一步
这一周 MCP 把规范发布节奏定成半年一发、A2A 用请求头门控新语义,而一个 minor 版本仍在不动代码的情况下改了三处线上行为;文章给出四类变更的判断法,以及升级前后证明没升坏的六个字段。
10 月 28 日凌晨,MCP 规范仓库合入一份流程提案,把下一次正式修订从 2026 年 12 月推到 2027 年 3 月下旬 1。
一天后,同一批维护者把扩展的生命周期写定:Experimental、Beta、Stable、Core 四级,任何扩展「不得跳过 Beta」2。
而在 10 月 24 日凌晨,MCP 的 TypeScript SDK 发了 2.4.0,版本号从 2.3 走到 2.4 3。
版本号只跳了 0.1,却改了三处会直接影响线上返回的地方。三处都没有标成破坏性变更。
10 月 29 日晚上,A2A 仓库打出 v1.1.0-rc:任务的历史字段被换成按代次排序的 timeline,新语义要靠请求头声明才拿得到 4。
把这几件事放在一起,这一周的升级问题就落到两个动作上:判断一次变更会不会改到自己的线上行为,以及证明它没改坏。
稳定性的承诺搬进了规范文本,按半年一次的节奏给出。
而你装的包不在这个节奏上。
打开 changelog 该看哪几类句子,升级之后拿什么证明没升坏,是这一周真正要回答的两件事。
规范层:第一次给出可以写进排期的日期
SEP-3398 把 MCP 规范的发布节奏定在每年 3 月与 9 月的最后一个周二 1。
两次发布之间隔 6 个月,而每个版本自己要走 8 个月的周期:2 个月规划,6 个月评审与稳定。两个周期在时间上重叠。
soft freeze 落在发布前 2.5 个月,范围在这一刻冻结为「已经 Final 且合入的提案」;SDK 进入 beta 在发布前 1.5 个月;hard freeze 在发布前 1 个月 1。
原本排在 2026 年 12 月的修订因此移到 2027 年 3 月下旬,之后按固定节奏走 1。
没有走完的提案顺延到下一周期,发布日期不动。对要提提案的团队,soft freeze 就是硬截止。
SEP-3392 处理的是扩展。它把扩展分成 Experimental、Beta、Stable、Core 四级,并规定扩展不得跳过 Beta,除非核心维护者投票豁免 2。
处于 Stable 的扩展,协议行为只在新一版核心规范发布时才可变。阶段推进在仓库里表现为目录搬迁:从 experimental 目录搬进 beta、stable,最后归档,这也是唯一需要核心维护者批准的仓库改动。
规范仓库随表列出了各扩展的位置:MCP Tasks 在 Beta、目标 Core;Skills over MCP 在 Beta、终点未定;OAuth 客户端凭据、企业托管授权与 MCP Apps 已在 Stable 2。
两个提案都没有改动任何线上字段,改的是「什么时候会变」这件事本身。
A2A 的做法不同:它给了客户端一个开关。
任务新增
generation 字段,创建时为 1,此后每次状态变更必须恰好加一。新的事件类型只推送给在请求头里带
A2A-Version: 1.1 的客户端。1.0 客户端不改一行代码仍然能跑,只是拿不到 generation 这道代次校验 5。要拿新语义,客户端得在请求头声明版本,并实现 generation 缺口检测与收到 409 后的重新拉取。
这条设计把升级变成了逐请求的选择,可以先放一部分流量过去。
实现层:不改代码也会变的几类条目
规范层给的是日期,实现层给的是当天就会发生的变化。
它们散在十几个仓库里,版本号都不大。门控那一类已经在 A2A 一节出现过,这里补上另外三类。
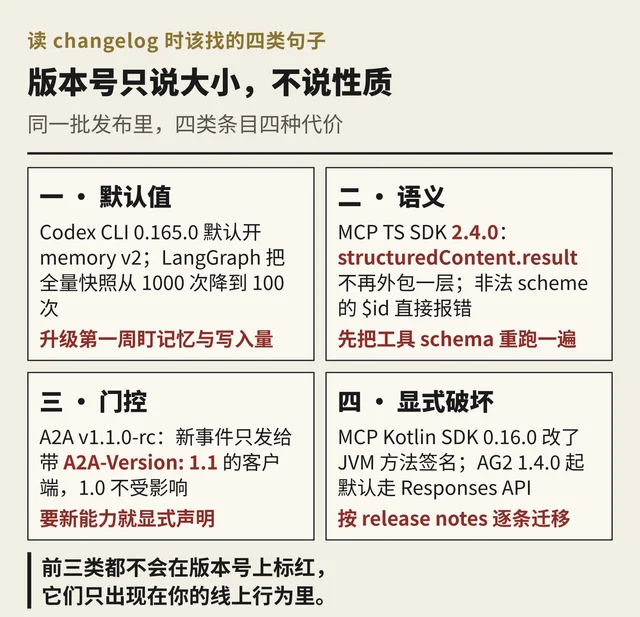
自制示意图,按本周实际发布的 release notes 归纳。四类里,前三类都不会在版本号上标出来:默认值、语义与门控只出现在线上行为里,只有第四类会在编译或启动时报错。
第一类,默认值。 Codex CLI 0.165.0 对新配置默认开启 memory v2,并支持把别的 agent 的记忆导入进来 6。
升级之后,跨会话记忆默认就在,不用再手动打开。
LangGraph 1.2.18 把 DeltaChannel 的全量快照间隔从 1000 次更新改成 100 次 7。
读长线程更快,写入与存储更多。要保留旧行为,得显式传
snapshot_frequency=1000。PydanticAI 2.63.0 把 CodeMode 的默认值改成动态工具目录:被揭示的工具以追加方式进入,不再重写已经缓存的 prompt 8。
工具目录因此成了运行期状态,复现与评测要按 run 记录它。
Google ADK 2.13.0 把遥测默认切到 OpenTelemetry 的 GenAI v2 schema,并移除了
call_llm 这个 span 9。按旧 span 名写的看板与告警,升级当天会断。
AG2 在 1.2.2 的发布说明里写明,1.4.0 起
OpenAIConfig 默认走 Responses API;要保留 Chat Completions,得改用另一个配置类 10。同一批改动还修了 token 统计:Anthropic 的 continuation token、Gemini 的 thinking token 现在计入。同一份负载的账单报表会出现台阶。
第二类,语义。 回到 2.4.0 的那三处。MCP 的协议版本按日期命名,当前正式版是 2026-07-28,更早的还有 2025-11-25 与 2025-06-18。
工具输出 schema 以
$ref 指向自身 $defs 时,2025 版协议连接上不再多包一层 { result: … };原来读 structuredContent.result 的客户端会直接读到内层对象 3。Registry 也动了两处语义。1.8.5 把 publisher 的 P-384 签名补齐到定宽,此前存下过的不完整元数据要重发一次 11。
1.8.6 要求搜索词至少 3 个 Unicode 字符,更短的请求返回 422 12。
客户端若把用户输入直接拼成搜索查询,就会把 422 当成网络错误反复重试。
三个已发布版本的示例一起改了。照抄旧示例的服务端,会让调用它的客户端读不到 audience、priority 这些字段。
第三类,显式破坏。 这类最好处理,release notes 自己会写 Breaking Changes 小节。破坏性却不一定发生在编译期。
MCP Kotlin SDK 0.16.0 给 Streamable HTTP 加了会话空闲过期:默认 30 分钟,过期后 session id 返回 404;并发会话上限默认 10000,超出返回 503 14。
同一版本改了 JVM 方法签名,按旧版编译的代码必须重编译。会话过期这一条要到运行期才显形:客户端收不到编译错误,只会在空闲半小时后拿到 404。
Mastra 1.80.0 把
queryTraceThreads() 的 model 与 provider 参数去掉,分页上限降到 100;@mastra/code-sdk 默认不再注册内置 subagents 15。依赖这些默认行为的插件,升级时会停在启动阶段。
平台层:旋钮被收走,代价写在限制页
比默认值更彻底的一层,是平台把 agent 循环与沙箱整个接过去。
10 月 29 日凌晨,微软在 Foundry Agent Service 里公开预览 Copilot harness(承载 agent 循环、决定它怎么调工具的那层执行外壳),托管 agent loop 与沙箱,文件读写、shell、Web、子代理四项能力默认开启 16。
同一篇公告宣布 hosted agents 的长任务抗中断转 GA:Copilot harness 是预览,hosted agents 正式可用 16。
代价写在同一套文档的限制页里:agent 定义不能指定
temperature、top_p、tool_choice;请求不能设置 max_output_tokens、max_tool_calls、context_management、service_tier;函数工具不支持 strict: true;Foundry Memory 不支持;BYOM 不支持 17。价格也跟着来了:harness 运行到 2026 年 12 月 1 日之前免费,之后沙箱按每 vCPU 小时 $0.0994、每 GiB 小时 $0.0118 计费,模型推理与外部工具另算 16。
AWS 这一周改的是调用方式。
10 月 28 日,Bedrock AgentCore CLI 升到 1.0 并 GA,命令从「先建项目」改成可以直接操作 runtime、harness、memory、gateway 这些资源 18。
10 月 29 日,Step Functions 的状态机可以作为 MCP 工具挂进 AgentCore Gateway:agent 决定何时运行、传什么输入,状态机按定义好的顺序执行每一步 19。
这条改动把「必须每次同序执行」的流程从 agent 的自由编排里摘了出来。代价是流程改动要走状态机发布,改提示词不再能让流程变形。
10 月 24 日凌晨,Bedrock 的 Web Search 加了域名过滤与位置控制:请求里可以给最多 100 个允许域名,或最多 100 个封禁域名,只在已经支持该功能的四个区域可用 20。
Google 在 10 月 27 日放出 Gemini API CLI 的 beta,一个无状态的命令行客户端,明确写给「有 shell 权限的编码 agent」用,文档里点名 Antigravity、Claude Code、Codex、Cursor 21。
它把媒体命令的输出落在磁盘上,标准输出只回路径,避免二进制数据挤进上下文;沙箱则由被调用的托管 agent 一侧提供 21。
Anthropic 这一周没有 agent 平台级发布,动的是两个边界:Messages 与 Token Counting 的请求体上限从 32MB 提到 128MB,仅限第一方 API;用量与成本分析 API 进入 beta 22。
OpenAI 在 10 月 26 日发布 GPT-6.1 Terra,1.05M 上下文、$1 输入 / $5 输出每百万 token,工具调用只在 Responses API 上提供 23。
要用它的 computer use,调用栈就得先迁到 Responses。
托管换来的东西很具体:不用自己写循环、不用自己管沙箱。被拿走的还有调优旋钮与迁移路径;能力清单也搬了家,从发布博客挪进了限制页。
升级前后:一次分数要六个字段才复现
到这里还剩一个问题:升完以后,怎么证明没升坏。
本周的测量材料给出的答案不太客气:你手里那个分数,缺了六个字段就复现不出来。
第一个字段是模型与努力档位。Artificial Analysis 在 10 月 27 日把 Intelligence Index 升到 v5 24。
v5 里同一模型的低档与满档差距被放到前台:Claude Opus 5.5 从低档 35 分到满档 58 分,成本差 10 倍;Claude Sonnet 5.5 的低档与满档相差 29 分 24。
第二个字段是外壳,也就是上面说的 harness。10 月 25 日,Vals AI 用统一 harness 复跑了 Terminal-Bench-Science 的 70 道科研任务 25。
所有模型都用 mini-swe-agent 这一套外壳,每模型单次运行、按 pass@1 计;GPT-6 Astra 拿到 62.86% 25。
官方榜用的是每个模型自带的 agent:Claude Opus 5 配 Claude Code 是 30.0%,GPT-5.6 Sol 配 Codex 是 22.4% 26。
两套口径跑的是同一批 70 题,榜首也不同:统一外壳那边是 GPT-6 Astra 的 62.86%,自带外壳那边是 Claude Opus 5 的 30.0%,相差 32.86 个百分点。
两个数字之间同时换了模型与外壳,Vals 因此在方法页写明,他们的数字不能与官方榜直接比较 25。
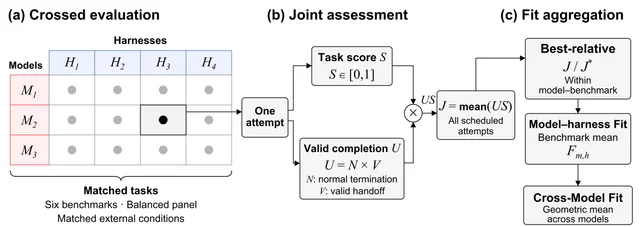
上海人工智能实验室的一篇预印本给出了这类差距的结构:111 个评测设定、52,168 条轨迹,平衡面板是 3 个模型 × 4 套外壳 × 6 个基准,共 72 个配置 27。
它把「任务得分」与「有效完成率」相乘再取均值。同一个模型换一套外壳,名次会变,两个口径给出的排序也会不同 27。
第三个字段是题目从哪来。v5 里有 60% 的权重来自私有题集或隐藏答案 24。
这一版还把权重压到了 agent 任务上:Terminal-Bench 4.0、Terminal-Bench-Science、AA-Briefcase、FrontierCode 2.0 四项占 55% 的权重,却占去输出 token 中位数的约 90% 24。
榜单的第二天就换了主人:10 月 28 日,Gemini 4 Carbon 以 59 分登顶,同时标明尚未公开可用 28。
第四个字段是跑几次。Vals 复跑 Terminal-Bench 4.0 的做法是每题跑满三遍,取三次运行级分数的均值,误差棒报三次运行的标准误 29。
单跑出来的数落在三跑均值旁边,两边的波动范围没法互相换算。
第五个字段是怎么计价。同一组删轨迹实验,在平摊定价下 42 组配置里有 26 组成本下降;换成按缓存命中计价的模型,42 组里没有一组下降 30。
第六个字段是你的任务集。榜单那批题不是你的题。
六个字段合起来,才是一次可比较的测量。
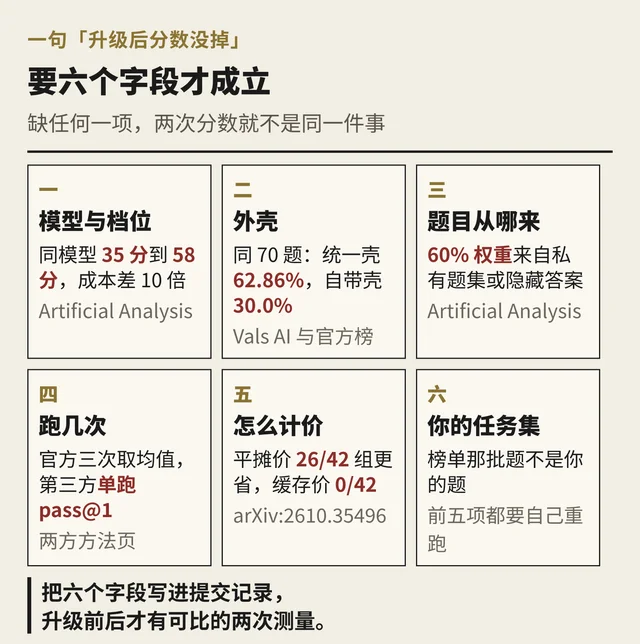
自制示意图。每个字段配一条本周出现的证据;第六项意味着前五项都要在自己的任务集上重跑一遍。
通过率看不见的四项
分数之外,本周有几份材料把「通过了」这句话拆开了。
第一项是越权执行。Concordat 把工具的可用性写成接口状态:每轮只把当前状态允许的工具交给模型,越界调用在产生副作用前抛异常 31。
在 τ-bench 的航空域 50 个任务上,标准 agent 用 gpt-4.1 时有 13 个任务做了未经确认的写操作,占 26%;换成 Claude Haiku 5.5,三次运行共 128 次 task-run,其中 29 次出现越权写,三次分别是 13、9、7 次。两边的分母不同,一个是 50 个任务,一个是 128 次运行 31。
更值得注意的是基准的反应:Haiku 首次施压运行的 13 个违规任务里,有 8 个仍然拿到满分,因为数据库末态符合预期 31。
第二项是半路断裂。Oracle AI 的一篇论文对每条工具调用序列逐前缀检查可执行性,再算轨迹可执行率 32。
BFCL-v3 配 Llama-4 Maverick 的 200 个 episode 里,只有 10 个全程可执行,而这 10 个全部成功;出现前缀断裂的 190 个里,有 138 个仍然成功 32。
终局成功率因此把大量「断过又接上」的轨迹算成了能力。
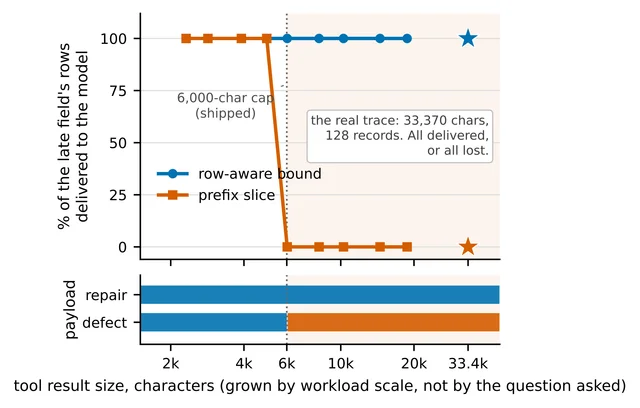
第三项是工具输出在到达模型前就被截断。Brock 大学等机构的一篇短文统计了 720 次运行、11,189 条工具结果,其中 3,827 条被切,每一条都变成破损 JSON 33。
同一批结果里,一个字段只在 742 次调用中的 4.7% 到达模型,紧挨着它的另一个字段到达 99.3% 33。
作者还查了七个主流框架的当前版本,两个通用裁剪器同样按位置切片 33。
第四项是重启。一篇分析容器化部署的论文从 LangGraph 与容器平台的文档出发,推出 14 条运维契约,覆盖 433 个已部署的开源 agent 系统 34。
其中 265 个系统需要持久状态,166 个守住了契约;剩下 99 个(37.4%)在普通重启后丢掉会话、暂停中的运行或记忆 34。
还有一项反向结果值得记。卢森堡大学等机构把真实的 MCP 工具故障注入到三个 agent 栈里,10 分制的任务完成分从 8.08 掉到 3.23,跌幅 60%;120B 模型与 20B 模型的完成率分别是 91.1% 与 95.6%,把模型做大买不到容错 35。
成熟度分层
| 维度 | 本周现状 | 建议落点 | 动作窗口 | 判断 |
|---|---|---|---|---|
| 协议发布节奏 | 半年一发,扩展分四级,soft freeze 2.5 个月 1 | 把 2027 年 3 月下旬当作下一个基线,把 soft freeze 当作提提案的截止 | 现在 | 已落地:可以写进排期 |
| 变更的标注方式 | minor 版本里改三处线上行为,无破坏性标注 3 | 按默认值、语义、门控、显式破坏四类读 release | 现在 | 快速扩张:各仓库自定 |
| 托管外壳 | Copilot harness 预览,旋钮被收走;12-01 起沙箱计价 16 | 迁移前把限制页读成需求清单,按会话数重算成本 | 12 月 1 日前 | 快速扩张:能力与限制同时到 |
| 榜单口径 | 60% 权重来自私有题集,agent 类占 55% 权重与约 90% token 24 | 抄分数时连 harness、档位、成本一起抄 | 现在 | 已落地:在评测机构一侧 |
| 自己复现分数 | 同一批 70 题,统一外壳 62.86%、自带外壳 30.0%,32.86 个百分点的差里有模型也有口径 25 | 六个字段写进提交记录 | 现在 | 容易被高估:拿榜单当基线 |
| 通过率 | 26% 任务有未确认写操作;190 个断裂轨迹里 138 个仍成功 3132 | 回归集补到达率、首错深度、重启保留、越权计数 | 现在 | 容易被高估:通过不等于按流程做完 |
下周就能做的四件事
- 按四类句子扫一遍你依赖的仓库。 默认值、语义、门控、显式破坏,四类各自对应一种动作;版本号只说明作者认为的兼容性 3。
- 把默认值变化做成一次 diff。 升级前跑一遍工具目录、遥测 span 名与快照频率,和升级后对比;这三项本周都变过 79。
- 在提交记录里固定六个字段。 模型与档位、外壳、题目来源、运行次数、计价口径、任务集;缺一项,两次分数就不是同一件事 2425。
- 回归集补四个数。 字段到达率、首错深度(第一个不可执行的调用出现在第几步)、重启后状态保留、未确认写操作次数;这四项在通过率上看不见 31323334。
未来 6–12 个月
最近的日期是 2026 年 12 月 1 日:Foundry 的 harness 从那天起按沙箱计费,长驻型 agent 的成本模型要重算 16。
再往后是 2027 年 3 月下旬,MCP 的下一次正式修订 1。
A2A 的 1.1 还在候选阶段,history 字段要到 2.0 才移除,中间这段时间两套字段会并存 5。
在这两个日期之前,有三件事会先发生。
第一,私有题集会变成榜单默认。AA 把 60% 的权重移到私有题集,用未公开的题目挡住训练数据污染 24。
第二,分数会带上档位与成本一起报。v5 已经按「每个 Index 任务的美元成本」列出前十名,$0.96 与 $13.04 在同一张表里 24。
第三,托管外壳会继续收走旋钮,而限制页会成为选型的主要阅读材料 17。
结论
回到开头那两件事:规范把下一次修订排到了 2027 年 3 月,SDK 在同一周用 2.4.0 改了三处线上行为。
这两件事指向同一个位置:稳定性的承诺写在规范里,行为的变化发生在实现里。
升级的判断落在两个时间点上。
提案的判断落在 soft freeze 之前:范围在那一天冻结,赶不上就顺延到半年后。
上线前的判断落在部署之前:按四类句子读一遍 release,按六个字段记一次分数,再给回归集补四个数。
这两步做完,版本号从此只是标签。
References
- 1SEP-3398: Release Cycle Updates
github.com
- 2SEP-3392: Extension Lifecycle
github.com
- 3@modelcontextprotocol/core v2.4.0
github.com
- 4A2A v1.1.0-rc
github.com
- 5A2A Specification v1.1.0-rc
github.com
- 6openai/codex rust-v0.165.0
github.com
- 7langchain-ai/langgraph 1.2.18
github.com
- 8pydantic-ai v2.63.0
github.com
- 9google/adk-python v2.13.0
github.com
- 10ag2ai/ag2 v1.2.2
github.com
- 11MCP Registry v1.8.5
github.com
- 12MCP Registry v1.8.6
github.com
- 13
- 14kotlin-sdk 0.16.0
github.com
- 15@mastra/core 1.80.0
github.com
- 16Microsoft Copilot harness in Foundry Agent Service
devblogs.microsoft.com
- 17Foundry Agent Service limits and quotas
learn.microsoft.com
- 18Amazon Bedrock AgentCore CLI version 1.0
aws.amazon.com
- 19Step Functions workflows now available as AI agent tools
aws.amazon.com
- 20Web Search on Amazon Bedrock adds domain filtering
aws.amazon.com
- 21Gemini API release notes
ai.google.dev
- 22Claude Platform release notes
platform.claude.com
- 23GPT-6.1 Terra
platform.openai.com
- 24Announcing Artificial Analysis Intelligence Index v5
artificialanalysis.ai
- 25
- 26Terminal-Bench-Science 0.1
tbench.ai
- 27When Agents Fail: Model or Harness
arxiv.org
- 28Gemini 4 Carbon is the new #1
artificialanalysis.ai
- 29
- 30The Hidden Costs of Forgetting
arxiv.org
- 31
- 32Prefix Executability
arxiv.org
- 33Context Is a Pipeline, Not a Window
arxiv.org
- 34Built to Remember, Shipped to Forget
arxiv.org
- 35

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.