《PPO》:一次采样更新十轮,裁剪后的目标函数管住了什么
从策略梯度「采完就丢」的浪费出发,拆解 PPO 的概率比、裁剪代理目标与自适应 KL 惩罚,讲清 min 与 clip 为什么构成悲观下界、梯度在哪些区间归零,并用 MuJoCo 与 Atari 的原始表格读懂它的数据效率、口径与边界。

2017 年 7 月 20 日,John Schulman、Filip Wolski、Prafulla Dhariwal、Alec Radford 与 Oleg Klimov 把《Proximal Policy Optimization Algorithms》挂上 arXiv,编号 arXiv:1707.06347,五位作者当时都在 OpenAI;论文在同年 8 月 28 日修订过一次,也就是现在通用的 v2。这项工作没有对应的会议或期刊版本,引用它应当写成 arXiv 预印本。1
强化学习里最贵的一步往往不是算梯度,而是采数据。论文在 MuJoCo 上每个任务跑 100 万步,在 Atari 上每个游戏跑 1000 万步,也就是 4000 万帧。2 每一步都要把当前策略放进环境里执行一次动作、领到回报、再推进状态。如果一批数据到手只用一次就丢掉,这笔采集开销一点也没有被摊薄。
标准策略梯度的做法正是这样:采一批数据,算一次梯度,更新一次参数,然后把这批数据扔掉,重新采样。论文要解决的问题就落在这里——同一批数据能不能多用几轮。作者的答案是能,前提是把策略更新的幅度限制住;而他们实现这个限制的办法,是在目标函数里给概率比加一道裁剪,允许一次采样之后做多轮小批量更新。1
有两个数字可以先记住。裁剪区间由超参数 控制,论文默认取 0.2;在 MuJoCo 那组基准实验里,一次采样之后更新 10 轮,每轮用 64 个样本的小批量。2
一次梯度更新之后就丢数据,浪费出在哪
策略梯度方法做的事情是估计一个梯度,再把它插进随机梯度上升。最常用的估计量长这样:2
是策略在状态 下选到动作 的概率, 是它的参数; 是优势函数的估计,衡量动作 比这个状态下动作的平均水平好多少。两者相乘之后,正优势的动作会被提高概率,负优势的动作会被压低。
实际写代码时不需要手写这个梯度。构造一个目标函数,让它的梯度正好等于式 (1),然后交给自动微分:
表示在一批有限的采样上取经验平均。这个记号在后面每一处都会出现,它是理解 PPO 的起点:所有目标函数都是在同一批已经采到的数据上算出来的平均值,而策略参数 是唯一在变的东西。
既然目标函数只是个平均值,顺手对它多跑几步优化,看起来是免费的。论文直接否掉了这个想法:对 用同一批轨迹做多步优化"缺乏正当理由",并且经验上常常导致破坏性的大更新,效果与完全不加限制相当甚至更差。2
原因在于优势项的时效。 是在旧策略 下采到的估计:它说"这个动作比平均水平好",而这句话只在旧策略把数据采出来的那个分布下有确切含义。更新几步之后策略已经变了,同一批数据还拿着旧账本要求提高或压低各个动作的概率,方向可能已经不对。第 6.1 节把这件事做成了实测:不加任何限制的变体,在 7 个连续控制任务上的平均归一化分数是 −0.39,也就是比随机策略还差。2
上一版解法:把更新关进信赖域
在 PPO 之前,同一批作者给过另一个答案。信赖域策略优化(Trust Region Policy Optimization,TRPO)把目标写成概率比乘以优势,同时把新旧策略之间的平均 KL 散度约束在一个阈值 之内:2
TRPO 的摘要把它的收益写在第一句:这是一个"带单调改进保证"的迭代过程,尽管实现里做了若干近似,实测中它"倾向于给出单调改进,且几乎不需要调超参"。3 "单调改进"这四个字是 TRPO 全部重量的来源:它保证每一步更新之后策略的真实表现不会变差,而不是只在代理目标上不变差。
代价落在实现上。论文列出三条:需要共轭梯度算法;要对目标做线性近似、对约束做二次近似;以及它"与带噪声的结构(比如 dropout)不兼容,也不兼容策略与价值函数之间的参数共享"。2
值得注意的是,作者的措辞里还留了一条线索:TRPO 背后的理论其实建议用惩罚项而不是硬约束,也就是直接优化下面这个无约束目标:
论文解释说,之所以退回硬约束,是因为很难找到一个对各个问题都表现良好的单一系数 ,甚至同一个问题在训练的不同阶段都难。2 这句话为后面两条路都埋了伏笔:PPO 一方面要用一阶方法达到 TRPO 的效果,另一方面也没有把惩罚项丢掉。
核心改动:把约束换成对概率比的裁剪
先给一个记号。定义概率比
它是新策略与旧策略在同一个状态—动作对上给出概率的比值,因此 恰好表示"策略还没动"。这个量很好用:一个标量就描述了这一步更新把某个动作的概率改了多少倍。
TRPO 的目标可以改写成它的形式,论文称其为 ——上标来自保守策略迭代(conservative policy iteration),这个概念最早由 Kakade 与 Langford 在 2002 年提出,不是本文的发明:2
问题也在这里:只要不限制 能走多远,最大化 就会把策略推向过大的更新。PPO 给出的改法是把比值本身裁掉,再和原值取小:
这个式子在算什么,分两种符号看最清楚。
优势为正()时,这是一个好动作,目标希望提高它被选中的概率。比值 从 0 一路升到 的过程中,两项相等, 随 线性上升;一旦 越过 ,第二项被固定成 ,而它比不断变大的第一项小, 取它,于是 变成一条水平线——再提高这个动作的概率,目标不再增加,也就没有梯度。
优势为负()时,这是一个坏动作,目标希望压低它。 低于 时,第二项被固定成 ,而它比第一项大(两个数都负,绝对值更小的那个更大), 取它, 是水平线;越过 之后两项相等, 随 线性下降。
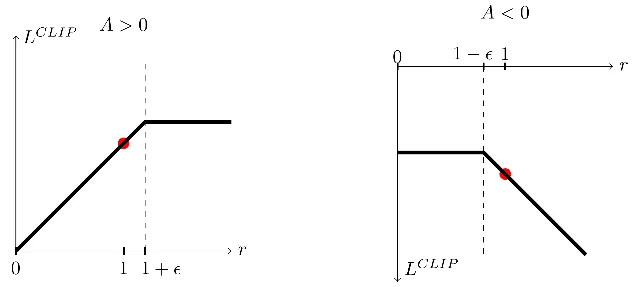
论文对 的用意有一句很干净的概括:这样做之后,"我们只在比值的变化会改善目标时忽略它,在它使目标变差时把它计入"。2 换句话说, 是 的一个悲观估计(下界):往好的方向多走的部分不计入收益,往坏的方向滑落的代价完整保留。
梯度在区间外归零这件事,正是"限制更新幅度"的实现方式。约束不是加在参数空间上的一堵墙,而是把奖励信号关掉——某个样本的比值一旦走出 ,它对参数就没有拉力了。这也回答了开头那个问题:同一批数据为什么敢用多轮?因为每一轮之后,越走越远的那些样本会逐个失去梯度,这批数据能够提供的总拉力被自动收窄,而不是像朴素策略梯度那样,一路把策略推到一个已经没有数据支持的地方。
论文还补了一句技术上的必要条件:在 附近做一阶展开时, 与 是相等的,两者只在参数离开 之后才分道扬镳——所以这一步改动没有破坏策略梯度原有的正确性。2
第二条机制与完整算法
裁剪并不是论文里唯一的答案,第 4 节还给了自适应 KL 惩罚这一条路。它直接优化前面那个式 (5) 的惩罚形式:
不同之处在于 不再是一个拍定的常数,而是每次更新后按实测的 KL 散度 自动调整:如果 小于目标值 的 1/1.5 倍,就把 减半;如果 大于 的 1.5 倍,就把 翻倍。论文自己承认 1.5 与 2 这两个数是启发式选的,但算法对它们并不敏感。2
作者把它写进来,是因为它是一条重要的对照基线,并且明确报告了结果:在这组实验里,KL 惩罚变体的表现不如裁剪目标。这句话的证据在 Table 1,稍后一起读。
把三部分合起来就是 PPO 实际使用时的目标函数:
第一项是裁剪后的策略目标, 是价值函数的平方误差 ,用来把状态价值学准; 是熵奖励,、 是两项的系数。如果网络结构上策略与价值函数共享参数,这三项就必须写在一个损失里一起优化。2
式 (1) 里的优势 也要有一个可算的估计量。论文用的是截断版广义优势估计(Generalized Advantage Estimation,GAE):
是时序差分误差:这一步拿到的回报加上打折后的下一步价值估计,再减去本步的价值估计,衡量本步比预期好多少; 是折扣因子, 控制把这些误差往前累加多长时间。这里出现了一个记号冲突:式 (12) 中的 是第 步的环境回报,与前面表示概率比的 不是同一个量,原文两处都写成 ,读的时候按上下文区分。24
有了这些,算法本身只有五行:2
- 个并行 actor 各自在环境里跑 个时间步,收集数据;
- 在这 个样本上算出优势估计 ;
- 对代理目标 做小批量优化,跑 轮(epoch),小批量大小 ;
- 把 ,回到第一步。
第 4 步是理解"轮"的关键:只有 被刷新之后,概率比的分母才跟着动,同一个样本的 才重新从 1 算起。一次采样之后的那 轮更新,全部发生在 固定不动的前提下。
MuJoCo 基准上这套配置是:地平线 ,Adam 学习率 ,10 轮,小批量 64,,。2
实验怎么读:一个归一化分数、两个 Atari 口径
先看裁剪值该取多少。第 6.1 节用 7 个仿真机器人任务做了一次变体比较——HalfCheetah、Hopper、InvertedDoublePendulum、InvertedPendulum、Reacher、Swimmer、Walker2d,每个跑 100 万步,各用 3 个随机种子;评分取最后 100 集的总回报,再按"随机策略记 0 分、最好结果记 1 分"平移缩放,21 次运行平均成一个标量。2
| 算法与设置 | 平均归一化分数 |
|---|---|
| 不裁剪、不加惩罚 | −0.39 |
| 裁剪, | 0.76 |
| 裁剪, | 0.82 |
| 裁剪, | 0.70 |
| 自适应 KL, | 0.68 |
| 自适应 KL, | 0.74 |
| 自适应 KL, | 0.71 |
| 固定 KL, | 0.62 |
| 固定 KL, | 0.71 |
| 固定 KL, | 0.72 |
| 固定 KL, | 0.69 |
原论文 Table 1。分数是 7 个 MuJoCo 环境、3 个随机种子共 21 次运行归一化后的平均,这里按原文补全为 0.3 与 10 两档固定 KL 的设置。2
这张表要连着三件事一起读。第一,它是作者为自己的每个变体分别搜索超参数之后的比较,每个变体给的都是它自己最好的一档,所以这一列数字代表的是"各自调好之后谁更强",而不是"随手一设谁更强"。第二,最上面那一行的负分不是因为"不裁剪"会平均地差一点,而是因为它在 HalfCheetah 这个环境上比随机策略还差;论文专门点出了这一点,一个任务崩掉就把 21 次运行的平均值拉到了零以下。第三,"平均归一化分数"没有物理单位,0 和 1 是人为锚点,跨论文、跨基准都不可比。
裁剪组内部也值得看一眼:、0.2、0.3 分别是 0.76、0.82、0.70。0.2 最好,但三档差距不大,这说明算法对裁剪值不算特别敏感,也说明这个"最好"是在这一个基准、这一轮超参搜索里得出的,不能当成普适常数。
与其它算法的对照在 Figure 3:同样的 7 个 MuJoCo 环境、同样 100 万步,对手是 TRPO、交叉熵方法(CEM)、带自适应步长的朴素策略梯度、A2C,以及加了信赖域的 A2C。论文的结论是 PPO 在"几乎所有"连续控制环境上优于这些方法。2 "几乎所有"是论文自己的措辞,不是全部;而且 Figure 3 给的是学习曲线,没有报告多次运行的方差。
Atari 上的比较换了一套口径,也更值得小心。论文拿 PPO 与 A2C、ACER 对比,用两个不同的指标各自判定每个游戏谁赢:一个是整个训练期的平均每集回报(偏向"学得快"),一个是训练最后 100 集的平均回报(偏向"最终性能")。胜负数按三个随机种子的指标平均后判定。2
| 评分指标 | A2C | ACER | PPO | 平局 |
|---|---|---|---|---|
| 整个训练期的平均每集回报 | 1 | 18 | 30 | 0 |
| 最后 100 集的平均每集回报 | 1 | 28 | 19 | 1 |
原论文 Table 2。每格是胜出的游戏局数,覆盖 49 款 Atari 游戏。两个指标测的是不同的东西,同一次训练会给出两行不同的胜负。2
两行合起来读,结论比"PPO 在 Atari 上更强"要细:按学得快算,PPO 大幅领先;按最终性能算,ACER 反而赢更多局。摘要里的说法与这两行是对得上的——"在 Atari 上,它的样本复杂度显著好于 A2C,与 ACER 相当,但简单得多"。2 ACER 是一条带经验回放、截断重要性采样与随机对决网络的路线,PPO 没有这些部件,胜负计数的差别要在"简单得多"这句话的背景里看。
附录 Table 6 把 49 款游戏的最终平均分逐一列出。挑几个看量级:ACER 在 Zaxxon 上是 29.0,PPO 是 5008.7,而 A2C 只有 16.3;反过来在 Gopher 上,ACER 是 37802.3,PPO 是 2929.9。2 单款游戏之间差三个数量级是这些基准的常态,这也是为什么论文用胜负局数而不是平均分会更容易读懂。
最后看一下训练配置本身。同一套算法在三个域上用的是三套不同的数:2
| 超参数 | MuJoCo 基准 | Roboschool | Atari |
|---|---|---|---|
| 地平线 | 2048 | 512 | 128 |
| Adam 学习率 | 按目标 KL 调整 | ||
| 轮数 | 10 | 15 | 3 |
| 小批量 | 64 | 4096 | |
| / | 0.99 / 0.95 | 0.99 / 0.95 | 0.99 / 0.95 |
| 并行 actor 数 | — | 32(行走)/ 128(追逐) | 8 |
| 裁剪值 | 0.2 | — |
原论文附录 Table 3、Table 4、Table 5 的三套配置合并。Atari 一列的 在学习过程中从 1 线性退火到 0,所以学习率与裁剪值都随训练衰减;表中"—"表示原表未列该项。
三套配置里 与 是唯一保持一致的。地平线从 2048 缩到 128,轮数从 10 降到 3,说明"一次采样更新几轮"是随任务调整的,不是固定值。
还有一处口径缺口值得单独说:摘要里把"样本复杂度、简单性、墙钟时间的良好平衡"作为结论之一,但论文的实验只报告时间步与游戏帧,全文没有任何墙钟时间或运行成本的测量。1 所以"平衡"的前两项有数据支撑,第三项在这篇论文里没有对应证据。
局限:哪几条不能从这篇推出来
第一处,也是最重要的一处:PPO 没有继承 TRPO 的理论保证。TRPO 的单调改进来自一个可以把性能下界写出来的代理目标,而那个下界用的是状态上的最大 KL,不是平均 KL。PPO 第 3 节论证的是 是 的下界——这是一个逐点不等式,说的是目标函数之间的大小关系,不是策略性能的下界。全文没有定理、没有引理、没有证明,只有第 2.2 节一句"达到 TRPO 数据效率"作为目标陈述。2 裁剪让更新幅度受限是一个经验上成立的设计,不是一个被证明的性质。
第二处,裁剪值的最优证据面很窄。 来自 Table 1 那一个基准、那一轮超参搜索;论文在同一节里还提到他们试过在对数空间裁剪,结果并不更好。2 到一个新任务上,0.2 是起点而不是结论。
第三处,Atari 上并没有全面胜出。按最终性能度量,ACER 赢了 28 局,PPO 赢了 19 局;这一条必须和"简单得多"一起读,否则会读成 PPO 全面领先。
第四处,"简单"说的是算法相对 TRPO 的机制简单,不是"不用调参"。前面那张三套配置的表就是反例:同一套算法换域要换一套数,其中 Atari 一族还要让学习率与裁剪值随训练退火。
第五处,收益的来源本身在两年后受到了挑战。这一点留给下一节。
影响与延伸阅读:同一个"别走太远",四种实现
把这篇论文放回它自己的线里,位置很清楚:GAE 解决了优势怎么估得更稳,TRPO 解决了更新幅度怎么限制,PPO 改的是后者的实现方式。三个问题里,PPO 只动了第三个。
真正的张力出现在 2020 年。Engstrom 等人在 ICLR 2020 的《Implementation Matters in Deep Policy Gradients: A Case Study on PPO and TRPO》里,把 PPO 实现里的代码级优化——那些在论文算法描述里只算附属细节的改动——逐项拆开做对照,摘要给出的两条结论是:这些优化"对 PPO 相对 TRPO 的累积回报增益负主要责任",并且"从根本上改变了强化学习方法的行为方式"。5 这篇工作没有否定裁剪,但它把问题换了个问法:当我们说"PPO 比 TRPO 好"时,好的是算法描述里那行裁剪,还是工程实现里的那些细节?对读论文的人来说,这是一条极有价值的方法论提醒——论文写的算法与代码里跑的算法,可能不是同一个东西。
另一条线提供了不同的答案。同样是连续控制,软演员—评论家(Soft Actor-Critic,SAC)走的是离策略路线:用经验回放反复利用历史数据,同时把最大熵写进目标,让 actor 在完成任务的前提下尽量保持随机。它的摘要把动机说得直白——当时的深度强化学习方法普遍受困于"极高的样本复杂度和脆弱的收敛性质",而 SAC 报告在多个连续控制基准上超过此前的在策略与离策略方法,并且"在不同随机种子之间表现非常接近"。6 把 PPO 与 SAC 并排放,看到的是对同一个"样本效率"问题的两种答案:PPO 把一批新数据用多轮,SAC 把旧数据存下来反复用。
而让 PPO 在今天仍然被频繁提起的,是第三条线——语言模型的人类偏好对齐。Ziegler 等在 2019 年的《Fine-Tuning Language Models from Human Preferences》里用 PPO 微调语言模型:训练配置写明每轮四个 PPO epoch,,并对 KL 项设了系数 。7 到 2022 年的 InstructGPT,这套流程被写成三步:监督微调、训练奖励模型、再用 PPO 针对奖励模型优化策略;同时在每个 token 上加入一项相对监督微调模型的 KL 惩罚,用以缓解对奖励的过度优化。8
这条线里最值得回味的一点是:实践最终把论文里互替的两条机制同时用上了——裁剪管住单步更新幅度,KL 惩罚管住策略别漂离参考模型太远。第 4 节里那个"表现不如裁剪"的自适应惩罚项,在语言模型上换了个身份回来了。
读完留下的四个判断维度
一,先问一批数据用了几次。 PPO 的全部设计都指向一件事:把采集成本摊到多轮更新上。读任何在策略算法时,先找这个数字,再看为了多轮付出的是什么——PPO 付出的是一步裁剪与一个不再有证明的目标。
二,把"下界"的适用范围问清楚。 是目标函数之间的不等式,不是性能保证。看到论文说某个目标是"悲观估计"或"下界",去确认它下界的是谁:是策略表现,还是另一个代理目标。
三,理论保证和工程实现要分开记账。 TRPO 换来的是单调改进的证明,代价是二阶近似和结构上的不兼容;PPO 换来的是可实现的简单,代价是证明。而 Engstrom 等人的对照又提醒,实测收益未必全部来自算法描述的那一部分。
四,胜负计数要连指标一起读。 Atari 上 30 比 18 与 19 比 28 出自同一次训练、同一份数据,只因为问的问题不同——是学得快,还是最终打得好。表格里的数字本身不构成结论,指标规定了结论的形状。
References
- 1
- 2原论文第 6.1 节与第 6.4 节给出的训练步数
arxiv.org
- 3
- 4广义优势估计原论文摘要页
arxiv.org
- 5
- 6
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.