《CLIP》:分类器从一句话里长出来,零样本如何追平 ResNet-50
从「每多一个概念就要多一批标注数据」这笔账出发,拆解 CLIP 把监督换成图像旁边那段文字的批内对比目标,讲清零样本分类器的权重怎样由类别名现场生成,并用 27 个数据集的胜负分布、鲁棒性对照与数据重叠检查读懂 76.2 这个成绩量的是什么。

2021 年 2 月 26 日,《Learning Transferable Visual Models From Natural Language Supervision》投到 arXiv,同一年发表在 ICML 上,收录于 PMLR 139:8748-8763。12
论文署名 12 人,全部来自 OpenAI,Alec Radford 与 Jong Wook Kim 是共同第一作者,Ilya Sutskever 也在其中。3
论文给出的模型叫 CLIP,全称是 Contrastive Language-Image Pre-training,对比式语言—图像预训练。3
除非另作说明,论文报告的成绩都属于 ViT-L/14@336px:一个视觉 Transformer,先按 224 像素训练,再用 336 像素多训一轮。3
下面的事实、公式、表格与两张正文图都按 arXiv v1 这版 PDF 读。3
标签这一步欠下的账
当时的视觉系统只做一件事:把图像分到一组事先定好的类别里。3
这个限制的代价落在数据上。想让模型认识一个新的视觉概念,就得为它准备一批带标注的图;ImageNet 用 128 万张标注图换 1000 个类别。3
三条现成的路线都在这个代价上做过让步。
第一条是人工精标的小数据集。MS-COCO 与 Visual Genome 质量高,各自却只有约 10 万张训练图,以现代规模算很小。3
第二条是弱标签的大数据。Mahajan 等人在 35 亿张 Instagram 图上预测与 ImageNet 有关的 hashtag。
这些模型微调到 ImageNet 时,把当时的成绩提高了 5 个点以上。3
第三条是 JFT-300M 这类内部数据集。Kolesnikov 等人与 Dosovitskiy 等人用它预训练,在迁移基准上大幅提高。
这条路的代价是监督被设计并限制在 1000 类与 18291 类这两个词表里。3
论文接着点出这两类做法的另一处代价:它们都用静态 softmax 分类器输出预测,缺少动态输出的机制,零样本能力因此被卡住。3
直接学自然语言这条路并不新。Joulin 等人把图注里的词当成多标签任务,Li 等人进一步预测短语 n-gram,并据此做零样本分类。
这些工作都停在概念验证上。Li 等人的零样本 ImageNet 只有 11.5%,低于当时最好模型的 88.4%。
这个数字也低于经典视觉方法约 50% 的水平。3
差距的一部分在规模。Instagram 那一类工作按加速器年计,训练了数百万到数十亿张图。
VirTex、ICMLM、ConVIRT 按加速器日计,训练量在 10 万到 20 万张图之间。3
这篇论文要补的就是这一段:先把数据做到 4 亿对,再找一个跑得动这个规模的目标。
监督的载体从标签换成句子
论文把训练信号定义成图像旁边的那段原文,形式各异的句子、评论和标签都在里面。3
现成的图文数据集都不够用,作者于是自建了一个。
构造方式是先列 50 万条查询,再按查询去网上取图文对。每条查询最多取 2 万对,让各类别的数量大致均衡。3
最终得到 4 亿对(图像,文本),名字叫 WIT,取自 WebImageText,总词量与训练 GPT-2 用的 WebText 相当。3
对照 YFCC100M 就能看出为什么要自建。那份数据集有 1 亿张图,元数据却稀疏。
按「标题或描述是英文自然语言」过滤之后,它只剩 1500 万张,与 ImageNet 同量级。3
数据有了,接下来决定用什么目标。作者先试了图像描述生成:用图像 CNN 配一个文本 transformer,从零开始预测图注的原文。3
这条路跑得很吃力。一个 6300 万参数的文本 transformer 已经用掉比它的 ResNet-50 图像编码器多一倍的算力,零样本识别 ImageNet 类别的速度却比一个简单得多的基线慢 3 倍——那个基线只预测图注的词袋编码。3
难处在于预测原文本身:与一张图同时出现的描述、评论和相关文字形态太多,逐词还原是件吃力的事。3
作者换掉了任务:只判断一段文字整体上与哪张图配对,放弃还原它的每个词。同样的词袋基线,换掉预测目标之后,零样本迁移效率又快了 4 倍。3
换上去的就是对比目标。一个批里有 N 对(图像,文本),模型要在 N×N 种配对里判断哪 N 种真的发生过。3
具体算法有四步,论文用一段 Numpy 风格伪代码写全了。3
第一步,两个编码器各算一次特征:图像走图像编码器,文本走文本编码器。第二步,两边各自乘一个线性投影矩阵,再沿特征维做 L2 归一,落到同一个嵌入空间。3
第三步,算相似度矩阵并缩放:
第四步,沿行与列各做一次交叉熵,取平均:
顺着这一步读,批的大小就有了新含义:批里的每一段文字都是其余所有图像的负样本。像一次全班点名,每张图既要说对自己那段描述,还要排除班上其他所有描述。
论文用的批是 32768。3
与损失配套的简化有四处:投影只用一层线性变换,不加非线性;数据增强只有随机方形裁剪;温度直接当可学习变量训练;两个编码器都从零开始,不用 ImageNet 权重初始化。3
图像编码器有两种,论文都训了。一种是 ResNet,从 ResNet-50 一路放大到约 64 倍算力的 RN50x64;另一种是 ViT,按 Dosovitskiy 等人的实现,只多加了 patch 与位置嵌入之后的一层 LayerNorm。37
文本编码器是一个 6300 万参数的 transformer:12 层、宽 512、8 个注意力头,BPE 词表 49152(把词拆成常见子词的一种表示法),最长序列截到 76。3
一共 8 个模型(5 个 ResNet 加 3 个 ViT),训 32 轮,优化器是 Adam 配解耦权重衰减与余弦调度。3
算力账也写在正文里:最大的 ResNet 用 592 张 V100 训了 18 天,最大的 ViT 用 256 张 V100 训了 12 天。3
分类器是从文字里读出来的
到这里模型只学会了一件事:判断一张图和一段文字配不配。零样本分类直接拿这件事来用。3
做法是:把目标数据集所有类别的名字当作候选文本,算出图像嵌入与每条类别文本嵌入的余弦相似度,除以温度,再过一个 softmax,取概率最大的那一对。3
论文给出了这个预测层的正式身份:它就是一个多项式逻辑回归分类器,输入 L2 归一、权重 L2 归一、没有偏置、带温度缩放。3
于是分类器的权重来自类别名的文字本身:文字过一遍文本编码器,权重就生成了;换一组类别名,权重跟着换。3
论文顺着这个读法又走了一步:文本编码器相当于一个超网络(hypernetwork),它按描述生成线性分类器的权重。3
再往前推一步,每个批都可以看成一个数据集:每类一个样本,一共 32768 类,类别由自然语言定义。预训练的每一步都在优化这个随机生成的代理数据集上的表现。3
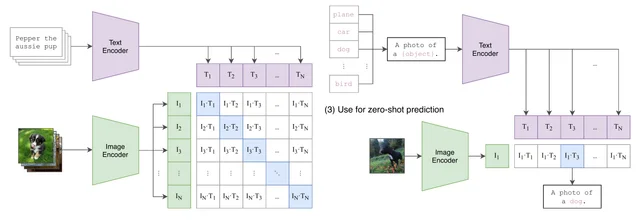
还有个术语要当场说清。计算机视觉里的 zero-shot 一般指「泛化到没见过的类别」,这篇论文用的是一个更宽的含义:泛化到没见过的数据集。3
分辨这一点有用:后面的成绩表量的是「换一个数据集还能不能分对」,量的是它自己那个含义。3
提示词是方法的一部分
零样本分类的输入只有类别名,而类别名通常是数据集顺手给的,并没有为这种用法设计过。3
麻烦出在两处。一处是多义词:只给一个词,文本编码器无从确定该取哪个词义。ImageNet 里同时存在两种「crane」(起重机与鹤),Oxford-IIIT Pets 里的 boxer 指的是狗的一个品种。3
另一处是分布差:预训练数据里配图的文字通常是一整句描述,单个词很少见。3
补法是加一层模板。论文给的默认写法是「A photo of a {label}.」,单这一句就让 ImageNet 的准确率涨了 1.3%。3
按数据集定制还能再涨。宠物加「a type of pet」,食物加「a type of food」,飞机加「a type of aircraft」。
OCR 类数据集把要识别的文字放进引号,卫星图写成「a satellite photo of a {label}.」。3
集成是另一半。作者把「A photo of a big {label}」这类不同上下文的分类器合起来,而且是在嵌入空间里平均,这样只需缓存一份平均后的文本嵌入。3
在 ImageNet 上他们集成了 80 条提示,再涨 3.5%;两项合起来,ImageNet 上接近 5 个点,36 个数据集上平均也接近 5 个点。3
论文给这笔账的定位是:相当于基线方法多花 4 倍算力买到的提升,而集成的成本在多次预测上平摊之后接近于零。3
成绩单要先看分母
同一次实验里,它的 top-5 达到 95%,与 Inception-V4 相当。作者把这一步的意义写成「离灵活、实用的零样本分类器近了一步」。3
对照的另一头是 Visual N-Grams(Li 等,2017):零样本 ImageNet 11.5%。换到 aYahoo 与 SUN 两个数据集上,CLIP 分别是 98.4% 对 72.4%、58.5% 对 23.0%。3
论文同时声明了这次对照不对等的地方:训练数据大 10 倍、单次前向的视觉算力接近 100 倍、训练总算力很可能超过 1000 倍,所以它只用来给 CLIP 的成绩定位。3
把单点结论放回分布里,图景会变。在 27 个数据集上,零样本 CLIP 与「ResNet-50 特征上的全监督逻辑回归」相比是 16 胜 11 负。3
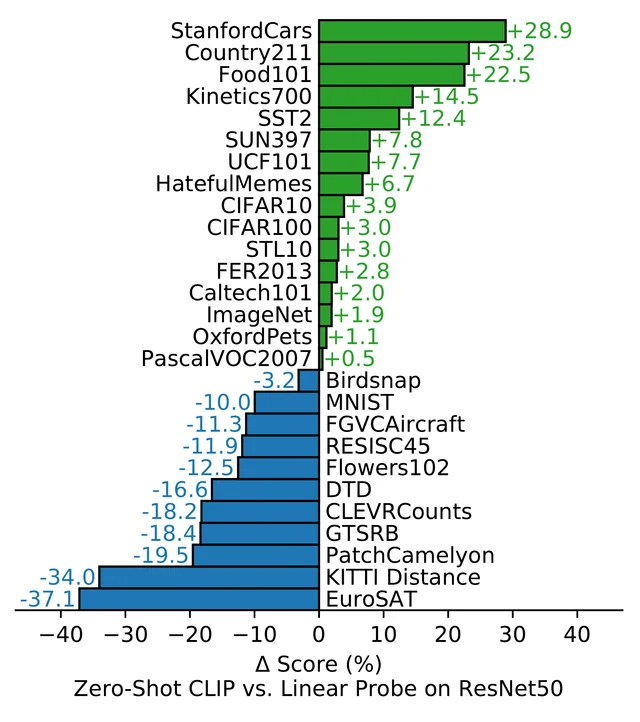
这里有个容易读错的地方:零样本这一档的对照基线,本身已经远低于当时的最好模型。3
真正说明特征质量的是另一侧。把线性分类器接在 CLIP 的特征上,27 个数据集里有 21 个超过当时最好的公开 ImageNet 模型 Noisy Student EfficientNet-L2。3
CLIP 的两种图像编码器之间也存在效率差:视觉 Transformer 比同门的 ResNet 大约省 3 倍算力。3
两条合起来才是完整的判断。零样本这一档的成绩与一个较弱的基线持平,它换来的是「不用为每个任务重训」这个接口;而它的特征本身,在当时的公开模型里是拿得出手的。
与少样本对照,这个接口省下的是哪一步就更清楚。零样本 CLIP 匹配同一特征空间上 4-shot 线性分类器的平均表现,在 ImageNet 上匹配 16-shot。3
换个算法量同一件事:要让线性分类器追上零样本,每类平均需要 20.8 个标注样本,中位数是 5.4 个。3
人类对照给出的参照更直接。在 Oxford-IIIT Pets 上,没有见过样本时人的准确率是 54%,看过每类一个样本之后升到 76%。3
同一个 76.2 可以是两种模型
论文接着做了一件更值得学的事:把「在 ImageNet 上一样准」的模型放到别的分布上看。3
对照选得干净:一边是零样本 CLIP,一边是同样在 ImageNet 验证集上拿到 76.2 的 ResNet-101。3
结果按数据集排开。ImageNetV2 是 70.1 对 64.3,ImageNet-R 是 88.9 对 37.7,ObjectNet 是 72.3 对 32.6。
ImageNet Sketch 是 60.2 对 25.2,ImageNet-A 是 77.1 对 2.7。3
论文给出的说法是,零样本 CLIP 把这类「鲁棒性缺口」最多收窄了 75%。3
反过来的实验说明这种鲁棒性来自哪里。为了 ImageNet 去做监督适配,ImageNet 准确率涨 9.2%,平均鲁棒性反而略降。3
作者的判断因此分成两层:零样本评测更能代表模型的能力;而一个只看 ImageNet 的分数,会把两类很不一样的模型读成同一个。3
最后是污染这一关。预训练语料来自全网,测试集的内容可能就在里面。3
做法是先用重复检测器把每个评测集切成「重叠」与「干净」两个子集,再比较两者的零样本准确率差。3
量出来的重叠并不大:35 个数据集里 9 个完全没测到重叠,中位重叠 2.2%、均值 3.2%。3
对成绩的影响更小:整体准确率的变化大多在 0.1% 以内,最大的一次估计提升是 Birdsnap 的 0.6%,而重叠率最高的 Country211(21.5%)只涨了 0.2%。3
作者也写下了这套方法的限度:检测器的召回无法在 4 亿样本上穷尽核对,而重叠子集与干净子集的分布本身可能不同。
Kinetics-700 的「重叠」里很多是全黑转场帧,这解释了那里 20% 的落差。3
论文自己写下的局限
第一条关于上限。零样本这一档的对照基线远低于当时的 SOTA,作者估计要让零样本 CLIP 达到整体 SOTA,还需要大约 1000 倍的算力。
论文写明这在当前硬件上不可行。3
第二条关于任务类型。它在细粒度分类上表现差,比如区分汽车型号、花的种类、飞机型号;在计数这类更抽象的任务上也差。
对预训练数据里不太可能出现的新任务,比如估计到最近一辆车的距离,它给出的答案接近随机。作者的原话是:确信仍有许多任务上它的零样本表现接近随机。3
第三条是 MNIST 这个例子,最值得细看。CLIP 在手写数字上零样本 88%,而一个对原始像素做逻辑回归的基线就能超过它。
作者去查原因,发现预训练数据里几乎没有与 MNIST 相似的图。3
由此得出的判断比成绩本身重要。作者写道,CLIP 走的是另一条路:把数据做得又大又杂,期望一切都落在分布内。
他称这是一个天真的假设,而 MNIST 说明它很容易被推翻。至于深度学习脆弱的泛化,这一篇把它留在了原地。3
第四条关于数据效率。这一篇换掉的是监督来源,模型自身的样本效率与之前的方法处在同一水平;论文把这一条列为局限。3
这个量级可以算一下:32 轮训练一共看过 128 亿张图,按每秒一张的速率过一遍需要 405 年。3
第五条关于评测方法本身。开发过程中作者反复使用完整验证集来指导选型,论文自己指出这已经超出了真正零样本场景能拿到的东西。
主要结果用的那 27 个数据集,也是他们承认「与 CLIP 的能力共同适配过」的一个集合。3
第六条关于语言接口的边界。零样本分类器的输出必须落在给定的候选概念里,图像描述模型则能生成新的句子。
作者把「把对比目标与生成目标联合训练」列为一个值得试的方向。3
第七条是偏见。预训练数据未经筛选,模型会学入社会偏见。论文第 7 节用 FairFace 等做了量化探查,也讨论了「自己造一个分类器」这个能力会如何放大偏见与监控方面的风险。3
论文公开的是代码与预训练权重。9
后来被换掉的是哪几格
把这篇拆成几个可以替换的位置,后面几年的工作就都能一句话定位。
第一格是监督信号的来源。ALIGN 把这一格换成 10 亿级、未经清洗的 alt-text 图文对,说明语料里的噪声可以用规模来补。10
第二格是数据与复现条件。OpenCLIP 与 LAION 把这条线搬到公开数据与开源代码上,训到 20 亿图文对,并指出训练分布本身会改变规模律的形状。11
第三格是损失与批量的关系。SigLIP 把批内 softmax 换成逐对的 sigmoid 损失,归一化的范围从此只由一对样本决定。
论文报告用 4 块 TPUv4 两天训出的模型在 ImageNet 零样本上达到 84.5%;批量涨到 100 万之后收益迅速变小,32k 已经够用。12
第四格是这套表示的用途。unCLIP(DALL·E 2)把 CLIP 的图像嵌入当成生成的接口:先由文本生成一个 CLIP 图像嵌入,再让解码器按这个嵌入生成图像。13
第五格是能力边界被检验的方式。Winoground 用「两张图、两句话,两句话用词完全相同只是顺序不同」的任务考组合理解,当时的一批视觉语言模型都不比随机好多少。14
这五篇各自换掉的是同一篇论文里的一个位置,把它们串成一条趋势线会丢掉这个结构。
ViT 在这里从「怎么把图像读成一串词」变成了一个可选的图像编码器。7
读完留下的判断维度
一,先问监督信号的载体。是事先定好的类别表,还是可以自由书写的自然语言;这一格决定了模型能不能接住一个新概念。3
二,再问更新的边界在哪里。微调改的是参数,提示改的是输入;这一篇把修改全部留在输入一侧。3
三,同一个精度数字要问它在别的分布上是什么样。76.2 对 76.2 的等式背后,ImageNet-A 上是 77.1 对 2.7。3
四,看到「追平」这类结论,先确认对照的基线与集合。这一篇的基线是 ResNet-50 特征上的逻辑回归,集合是作者自己组装的 27 个数据集,两点论文都写明了。3
代码与权重已经放出来,这套读法可以自己跑一遍:换一组类别名,看那组分类器的权重跟着文字变。9
References
- 1
- 2
- 3原论文首页的作者名单与 equal contribution 脚注
arxiv.org
- 4
- 5
- 6
- 7
- 8
- 9OpenAI 官方代码与预训练权重:CLIP
github.com
- 10
- 11
- 12
- 13
- 14
- 15
- 16
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.